Support technique
 Documentation
 Connexion
 Nous contacter



Accédez directement au résumé généré par l'IA de cet article de blog 


Principaux enseignements
- Le « slopsquatting » consiste, pour un pirate, à enregistrer le nom d'un paquet inventé par un outil d'IA et à attendre que quelqu'un l'installe.
- Cela fonctionne parce que les hallucinations se répètent : dans l'étude USENIX, 43 % d'entre elles sont réapparues lors des dix rediffusions.
- Un référentiel qui rejette tout ce qui ne figure pas dans un catalogue approuvé empêche tout simplement la résolution d'un nom inventé.
- Les agents de codage qui installent eux-mêmes leurs dépendances suppriment le dernier contrôle humain.
Un membre de votre équipe colle un extrait de code Python provenant d'un assistant IA, exécute la commande pip install qui l'accompagnait, et le terminal affiche les lignes sans signaler d'erreur. L'importation fonctionne. Le « slopsquatting » désigne le phénomène qui se produit lorsque ce nom de paquet ne renvoyait vers rien jusqu'à ce qu'un attaquant s'en empare. Le modèle l'a inventé, quelqu'un l'a enregistré en premier, et l'installation lui a fourni un point d'ancrage.
Ce guide explique ce qu'est le « slopsquatting », comment se déroule la chaîne d'attaque, ce que révèlent réellement les études sur la fréquence de ce phénomène, et quelles mesures de défense s'avèrent efficaces avant que l'attaque n'atteigne un véritable pipeline.
Qu'est-ce que le « slopsquatting » ?
Le « slopsquatting » est une attaque de la chaîne logistique logicielle dans laquelle un attaquant enregistre un nom de paquet susceptible de provoquer des « hallucinations » chez les grands modèles linguistiques, puis publie du code malveillant sous ce nom. Le développeur l'installe parce que son assistant IA lui a indiqué qu'il existait. Il s'agit là d'une « hallucination de paquet » : le modèle recommande une dépendance qui ne figure pas dans le registre qu'il vient de vous indiquer.
Ce terme a été inventé par Seth Larson, développeur en résidence spécialisé dans la sécurité à la Python Software Foundation, puis popularisé par Andrew Nesbitt, qui dirige la plateforme de données open source Ecosyste.ms. Il associe le concept d’« AI slop » à celui de « typosquatting ».
Personne n'a fait de faute de frappe ici. La commande d'installation était correcte, le nom était orthographié exactement comme l'avait indiqué le modèle, et la certitude qui sous-tendait cette opération provenait d'un système qui n'avait jamais vérifié la conformité du nom par rapport au registre à partir duquel il formulait sa recommandation.
« Slopsquatting » vs « Typosquatting »
Le « typosquatting » tire parti des erreurs humaines. demandes au lieu de requests. Ou python3-dateutil, mis en ligne sur PyPI en 2019 pour faire concurrence à python-dateutil et supprimé quelques jours plus tard dès qu’on s’est aperçu qu’il intégrait un deuxième paquet qui récupérait des clés SSH et GPG. Le « slopsquatting » exploite les erreurs des machines, et il s’avère que ces erreurs sont bien plus organisées qu’on ne le pense.
| Typosquatting | Slopsquatting | |
| Qu'est-ce qui déclenche l'installation ? | Une faute de frappe ou un nom mal retenu ? | Une IA recommande un prénom qui ne figure pas dans le registre prévu |
| Échelle observée dans une étude | Regroupés autour d'une poignée de cibles de grande valeur | 205 474 noms hallucinatoires uniques recensés |
| Prévisibilité | L'attaquant devine les fautes d'orthographe probables | L'attaquant récupère des noms en interrogeant des modèles |
| Similitude avec des noms réels | En général, il suffit d'une petite retouche pour que ça ressemble à la réalité | 13,4 % des « hallucinations » Python se situent à une distance d'édition de 1 à 2 par rapport au module réel le plus proche ; 48,6 % se situent à six modifications ou plus de celui-ci |
| Qui est exposé ? | Les développeurs et les flux de travail automatisés permettant de corriger une erreur de nom | Toute personne acceptant des listes de dépendances générées par l'IA, y compris les agents |
De nombreux noms inventés n'ont absolument rien à voir avec un module existant. Seuls 13,4 % des noms Python inventés se situaient à un ou deux caractères du nom existant le plus proche, tandis que 48,6 % en étaient distants de six modifications ou plus. Il s'agit davantage d'inventions qui semblent plausibles que de noms presque identiques, ce qui explique pourquoi les vérifications de distance d'édition et de similarité des noms en laissent passer tant.
Ces noms reviennent également. Les chercheurs de l'USENIX ont sélectionné 500 prompts ayant généré des hallucinations et ont relancé chacun d’entre eux dix fois. 43 % des noms issus d’hallucinations sont apparus lors des dix essais, et 58 % sont apparus plus d’une fois. Un attaquant n’a pas besoin de deviner. C’est cette récurrence qui constitue la véritable différence par rapport au typosquatting classique, où l’attaquant prédit les fautes de frappe humaines plutôt que de mesurer ce qu’un modèle invente de manière fiable.
Comment fonctionne une attaque de type « slopsquatting » ?
Quatre étapes, dont aucune n’est techniquement complexe, ce qui explique en partie pourquoi les paquets générés par l’IA constituent un mécanisme de diffusion si efficace. Une tentative réussie correspond à MITRE ATT&CK T1195.001, « Compromission des dépendances logicielles et des outils de développement », ce qui signifie qu’elle s’inscrit dans un modèle de menace que vous connaissez déjà, plutôt que de se présenter comme un cas à part, quelque chose d’exotique.
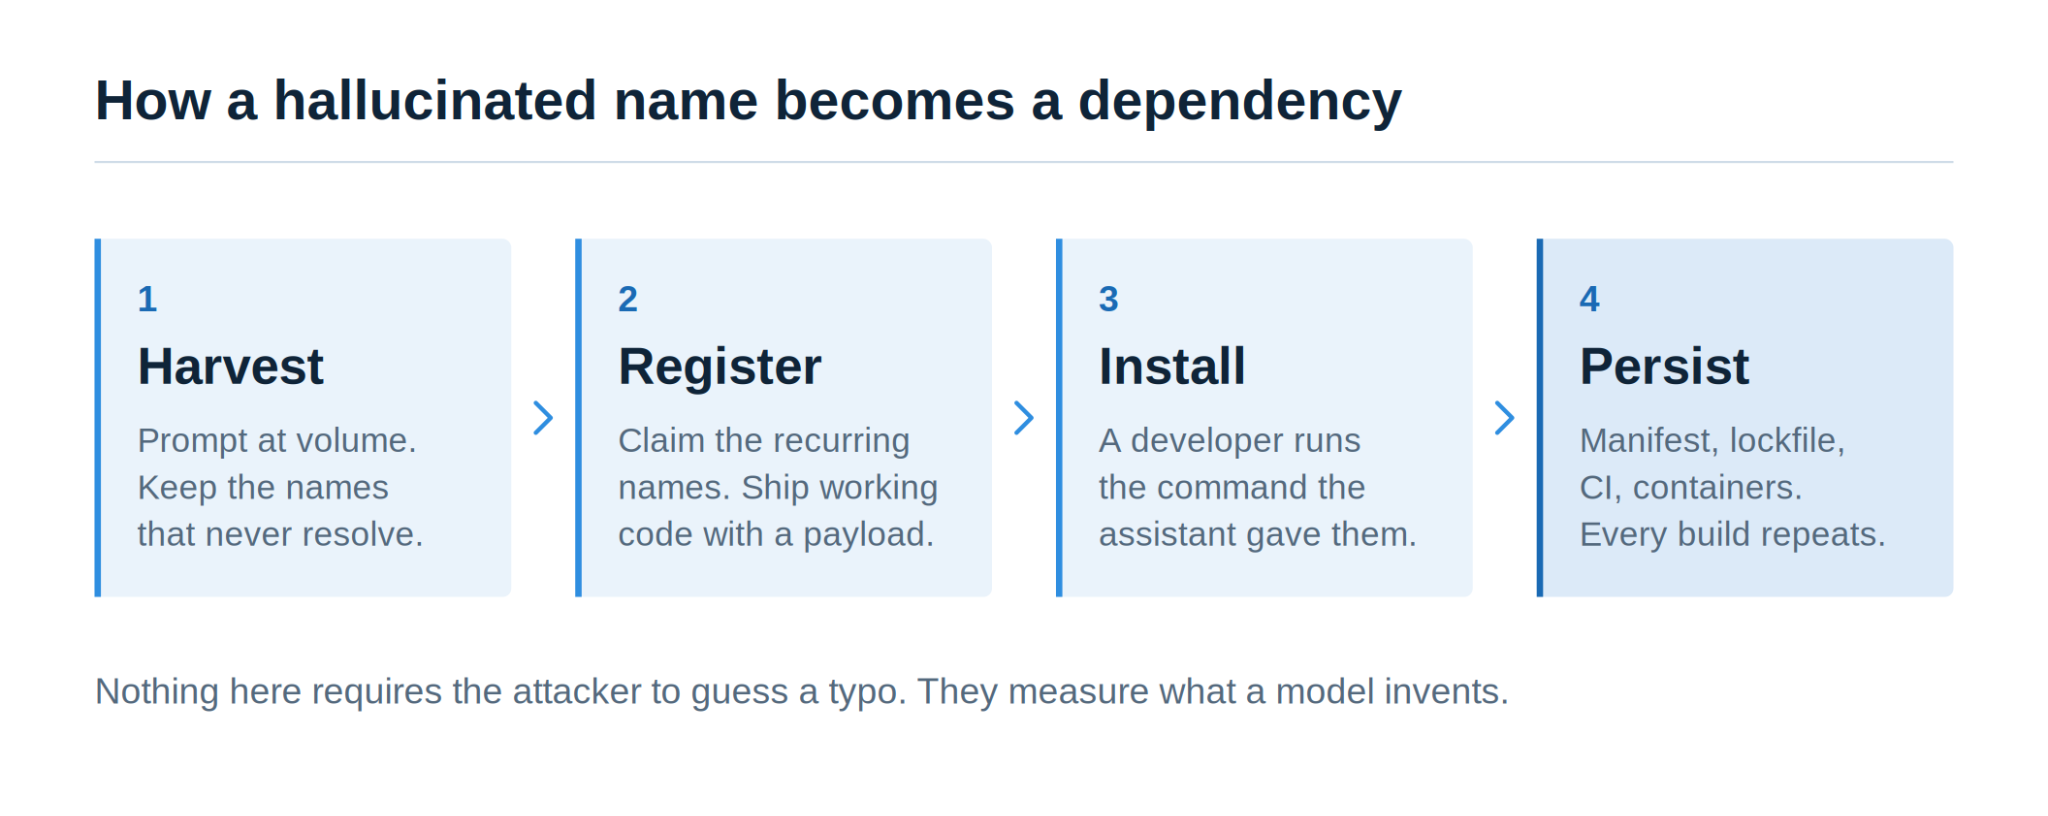
1. Récolter les hallucinations
L'attaquant exécute en masse des requêtes de génération de code, recueille tous les noms de paquets figurant dans la sortie et vérifie chacun d'entre eux sur PyPI ou npm. Les noms qui ne peuvent être résolus sont ajoutés à la liste. Ceux qui restent irrésolubles, même après plusieurs exécutions successives du même modèle, sont placés en tête de liste.
Il y a un résultat qui mérite qu'on s'y attarde. Dans l'étude USENIX, les noms issus d'hallucinations étaient bien plus souvent spécifiques à un seul modèle qu'ils n'étaient communs à plusieurs modèles : 81 % des noms uniques provenaient d'un seul et même modèle parmi les 16 testés. La récurrence et les chevauchements varient selon les modèles ; il est donc plus judicieux d'évaluer les assistants que votre propre équipe utilise réellement plutôt que de partir du principe qu'une liste noire commune suffit à vous protéger.
Les mesures à l'échelle de la recherche ne sont pas bon marché, mais elles ne doivent pas nécessairement l'être. L'équipe USENIX a généré 576 000 exemples de code répartis sur 16 modèles afin de couvrir deux langages et un large éventail de prompts. Le volume nécessaire pour tester un framework, un SDK cloud ou un cas d’utilisation à caractère interne constitue un problème différent et bien moins important.
Le choix du modèle jouait un rôle déterminant dans les modèles testés par l'étude début 2024, où les modèles open source présentaient un taux d'erreurs de 21,7 % en moyenne, contre 5,2 % pour les modèles commerciaux. Un prépublication de 2026 appliquant la même méthodologie à cinq modèles de pointe plus récents a révélé des taux globaux se situant entre 4,62 % et 6,10 %. N’ayant pas encore fait l’objet d’une évaluation par les pairs, il convient de considérer ces résultats comme un premier indicateur plutôt que comme une tendance avérée. Les noms inventés n’ont quant à eux pas disparu.
Conseil d'initié : Les suffixes plausibles tels que -utils, -helpers, -clientet -sdk peuvent donner à un nom inventé une apparence crédible au premier coup d’œil. Considérez une convention de nommage qui semble sensée comme une invitation à vérifier, jamais comme une preuve que le paquet existe réellement.
2. Enregistrer le nom et lui donner vie
L'attaquant enregistre les meilleurs noms et publie un projet qui fonctionne. Un code fonctionnel qui fait à peu près ce que son nom laisse entendre, un fichier README, une licence qui se lit normalement.
La charge utile se trouve dans le chemin d'installation ou dans une fonction d'importation que personne n'utilise souvent. Il peut s'agir d'un hook d'installation qui effectue une requête sortante lors de son exécution, ou d'un code qui se comporte d'une certaine manière sur un ordinateur portable et d'une autre manière sur un système disposant d'identifiants et d'un accès réseau intéressants. Une fonctionnalité d'apparence inoffensive permet de gagner du temps précisément parce que la fonction d'importation attendue semble fonctionner.
Les chiffres de téléchargement en disent plus long que n'importe quelle hypothèse. Lasso Security a enregistré un paquet vide sous le nom fantaisiste de huggingface-cli et a recensé plus de 30 000 téléchargements en trois mois, y compris dans un dépôt de recherche d’Alibaba dont le fichier README conseillait aux utilisateurs de l’installer. Une preuve de concept inoffensive, ne contenant absolument aucune charge utile, s’est tout de même retrouvée référencée dans de véritables artefacts de développement.
3. Un développeur l'installe sur la plateforme de l'IA
L'installation en elle-même n'a rien de particulier. Quelqu'un demande à un assistant comment faire quelque chose, obtient un code qui semble fonctionner, puis exécute la commande fournie avec.
pip install NOM_DU_PAQUET
En l'absence de contrôles du registre ou d'alertes au niveau des points d'extrémité, aucun avertissement ne se déclenche. Le paquet est résolu, installé, puis importé. Si le développeur effectue une vérification, c'est pour s'assurer que l'importation fonctionne, ce qui est le cas.
La confiance accordée au modèle se transpose ici. Le nom d’un paquet figurant au sein d’un code par ailleurs correct bénéficie de la crédibilité de ce code, et au sein d’une équipe au rythme soutenu, une nouvelle dépendance introduite dans le cadre d’une modification par ailleurs courante retient moins l’attention que la logique qui l’entoure, à moins que la révision ne mette explicitement en évidence l’ajout de dépendances. Une personne doit tout de même lire la suggestion et choisir de l’exécuter. Lorsqu’un agent est autorisé à installer des dépendances et qu’aucun contrôle d’approbation ne s’y oppose, personne ne la lit du tout.
4. Il persiste d'une version à l'autre et dans l'environnement de CI
Une fois que le nom figure dans le fichier fichier requirements.txt ou package.json, ce n’est plus une décision, mais une infrastructure. Les builds qui s’installent à partir de ce manifeste l’intègrent. Les nouvelles images de conteneurs l’intègrent. Chaque environnement qui résout cette dépendance en hérite, des ordinateurs portables aux runners d’intégration continue, en passant par les systèmes de build contenant les jetons de déploiement et les identifiants du registre.
La propagation transitive aggrave encore la situation. Si le paquet compromis est intégré en tant que dépendance d'une bibliothèque interne, il se retrouve dans des services dont les responsables n'ont jamais eu connaissance de la suggestion initiale. À ce stade, la question qui se pose lors de l'audit n'est plus de savoir qui l'a installé, mais où il a fini par aboutir.
À partir de là, les conséquences sont celles que l'on observe habituellement lorsqu'une dépendance est compromise : vol d'identifiants, minage de cryptomonnaies, trafic sortant inattendu ou compromission plus large de tout ce qui est accessible depuis l'environnement de compilation, y compris les hôtes Linux.
Attention : Les fichiers de verrouillage identifient le paquet malveillant aussi fidèlement qu'un paquet légitime. Un fichier de verrouillage garantit la reproductibilité ; il ne donne aucune indication sur ce qui a été verrouillé. Il reproduira la compromission sur chaque hôte qui effectue l'installation à partir de celui-ci, jusqu'à ce que la dépendance et son entrée dans le fichier de verrouillage soient délibérément supprimées.
Ce que révèlent les études
Ces chiffres proviennent de « We Have a Package for You ! Une analyse complète des "hallucinations de paquets" générées par les grands modèles de langage (LLM) générateurs de code », présenté lors de la conférence USENIX Security 2025. Il s’agit de l’étude à grande échelle que tous les acteurs du domaine finissent par citer, et chaque chiffre du tableau ci-dessous provient directement de cette étude, et non d’un résumé de seconde main.
| Conclusion | Figure |
| Recommandations farfelues concernant les colis | 440 445 sur 2,23 millions (19,7 %) |
| Noms fantaisistes uniques observés | 205,474 |
| Taux d'hallucination des modèles open source | 21.7% |
| Taux d'hallucinations des modèles commerciaux | 5.2% |
| Des hallucinations se sont reproduites dans les 10 rediffusions | 43% |
| Des hallucinations qui ne se sont jamais reproduites | 39% |
| Les « hallucinations » Python sont considérées comme des paquets npm | 8.7% |
Trois éléments sont ici plus importants que le pourcentage indiqué dans le titre.
La récurrence est le facteur clé de l’attaque. 43 % des noms issus d’hallucinations sont réapparus lors des dix rediffusions et 58 % sont réapparus plus d’une fois, ce qui place la grande majorité d’entre eux hors de la fourchette du bruit ponctuel. C’est cette répétabilité qui fait que l’exploitation de ces données vaut la peine pour un attaquant.
C'est le chiffre concernant les écosystèmes croisés qui pose problème. 8,7 % des noms Python inventés de toutes pièces correspondaient à des paquets npm valides ; ainsi, un développeur qui vérifie si un nom existe quelque part obtient un feu vert qui ne veut rien dire. Le fait qu'un paquet existe dans un autre registre ne prouve pas qu'il s'agisse de la dépendance que vous avez demandée.
La répartition par langage évolue. Parmi les modèles de la période 2024 de l’étude USENIX, JavaScript présentait un taux d’hallucinations de 21,3 %, contre 15,8 % pour Python. Le préprint de 2026 indiquait que cette relation s’était inversée pour ses cinq modèles les plus récents. Considérez cela comme une caractéristique du modèle que vous avez sous les yeux plutôt que comme une caractéristique du langage.
Pourquoi les agents IA font monter les enjeux
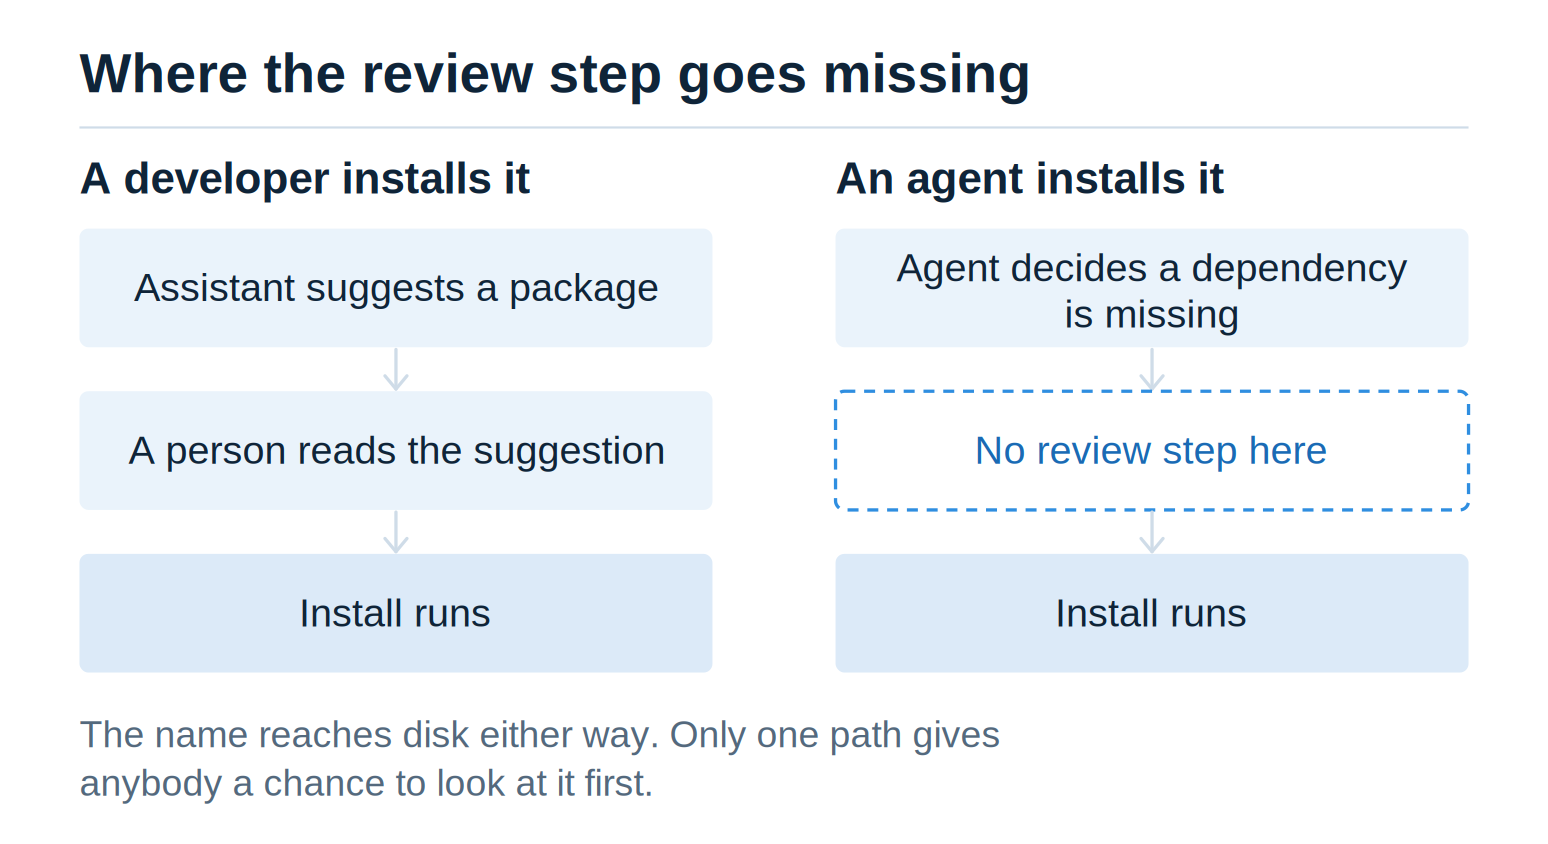
L'étape 3 ci-dessus part du principe que quelqu'un lit une suggestion de code générée par l'IA avant de l'exécuter. Les outils agentiques permettent de supprimer cette hypothèse. Un agent qui détecte une erreur, identifie une dépendance manquante et l'installe a bouclé la boucle ; ainsi, sans aperçu, sans vérification de conformité ni étape d'approbation, le nom du paquet est enregistré sur le disque avant que quiconque ne le voie.
Les tests effectués par les éditeurs indiquent que les outils s’améliorent sans pour autant résoudre le problème. Les recherches de Trend Micro sur le slopsquatting a révélé que les agents de codage dotés d’un raisonnement par chaîne de pensée et d’une recherche Web en temps réel réduisaient de près de moitié les taux d’hallucinations lors de son évaluation, les configurations effectuant une validation en temps réel produisant le moins de dépendances fantômes de toutes. Des noms ont tout de même réussi à passer. Trend Micro attribue les erreurs résiduelles au comblement des lacunes contextuelles, à l’imitation de la forme superficielle et à l’emprunt de noms entre écosystèmes, où l’agent assemble quelque chose qui respecte les conventions des paquets réels sans correspondre à aucun d’entre eux.
Une réduction de 50 % est significative. Ce n'est pas un élément de contrôle que l'on peut simplement transmettre à un auditeur.
Il y a ensuite le « vibe coding », qui désigne ici le fait d’accepter rapidement du code généré par l’IA sans vérifier de manière indépendante ses dépendances ni leur comportement lors de l’installation. La valeur par défaut la plus sûre est justement l’inverse. Toute dépendance tierce suggérée par l’IA reste non vérifiée jusqu’à ce qu’une source autre que le modèle confirme le paquet et la version. Si l’on ajoute à cette lacune des agents qui s’installent de manière autonome, le point de contrôle de vérification cesse d’exister.
Comment se prémunir contre le « slopsquatting »
Aucun contrôle pris isolément ne permet de détecter cela. La vérification permet de repérer les cas évidents, le « pinning » limite l’ampleur des répercussions, une liste blanche obligatoire restreint les possibilités de résolution, tandis que la politique d’analyse et de révision garantit le bon fonctionnement des trois premiers. Il faut les appliquer conjointement.
Si vos builds proviennent directement de registres publics, c’est la liste blanche de la mesure de défense n° 3 qui change la donne. Si vous exploitez déjà un miroir interne, vérifiez d’abord s’il applique une liste blanche ou s’il se contente de mettre en cache tout ce qui lui est transmis, car un cache sans restriction laisse cette vulnérabilité pratiquement inchangée.
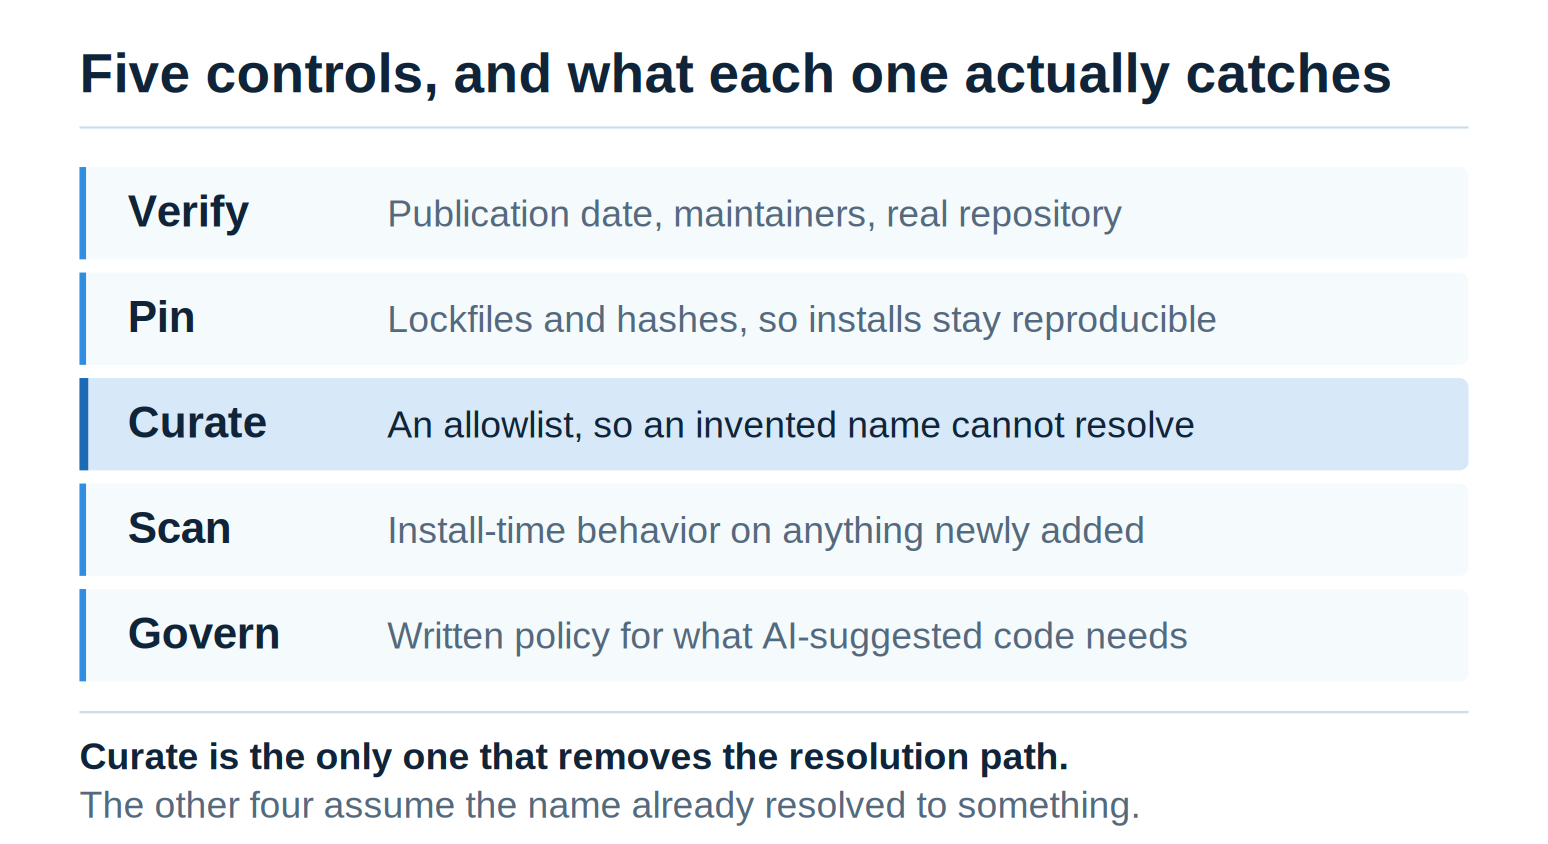
1. Vérifier que le colis existe et qu'il y a un historique associé
Avant d'ajouter un paquet suggéré par l'IA à un manifeste, vérifiez la date de sa première publication, qui en assure la maintenance, si le dépôt associé est réel et actif, et si l'artefact présent dans le registre correspond bien à cette source. Les informations relatives à la publication et au responsable de la maintenance proviennent directement des métadonnées du registre, sans qu'il soit nécessaire d'installer quoi que ce soit ni d'exécuter le code du paquet.
curl -s https://pypi.org/pypi/PACKAGE_NAME/json
npm view NOM_DU_PAQUET date_de_création responsables
L'adoption fait l'objet d'une recherche distincte. Le point de terminaison JSON de PyPI renvoie la valeur -1 dans ses champs de téléchargement ; vous devrez donc extraire cette information de pypistats ou de l'ensemble de données BigQuery si le volume de téléchargements fait partie de votre graphique. L'authenticité du référentiel et la correspondance entre la source et l'artefact doivent également faire l'objet d'une vérification distincte ; un lien vers un registre ne prouve en soi rien quant à l'identité du propriétaire de ce vers quoi il renvoie.
Définissez des critères basés sur des règles plutôt que sur l'instinct. L'âge, l'adoption, l'identité du responsable de maintenance, la correspondance vérifiée entre le code source et l'artefact. Ces quatre critères permettront de détecter les incohérences évidentes avant qu'une dépendance n'entre dans le graphe ; toutefois, un paquet malveillant bien conçu peut tout de même les contourner tous. Il s'agit de signaux d'alerte, et non d'une garantie de sécurité.
2. Fixer les dépendances à l'aide de fichiers de verrouillage et de hachages
Les fichiers de verrouillage garantissent la reproductibilité. Les hachages garantissent l'intégrité : à condition que le hachage ait été obtenu et protégé selon un processus auquel vous faites confiance, ils confirment que l'artefact que vous avez installé est bien celui que vous avez approuvé.
pip install –require-hashes -r requirements.txt
Le mode de vérification par hachage est du tout ou rien. Chaque exigence et chaque dépendance transitive doivent être fixées à l’aide de == et comporter un hachage, sinon l’installation échoue d’emblée ; prévoyez donc que la première passe soit fastidieuse. Ce que le verrouillage ne fait pas, c’est vous garantir que ce que vous avez verrouillé a toujours été sûr. Les données du registre npm sont immuables ; ainsi, un nom et une version donnés ne peuvent pas être republiés, même après une suppression. Le risque réel est d’approuver et de verrouiller le mauvais paquet dès le premier jour ; c’est pourquoi le verrouillage doit intervenir après la vérification, et non à la place de celle-ci.
L'exécution des scripts lors de l'installation constitue un levier distinct, et npm l'a déjà activé. Actuellement, npm bloque par défaut les scripts d'installation des dépendances, en ignorant les scripts de cycle de vie pour tout élément ne disposant pas d'une entrée correspondante dans allowScripts et en répertoriant à la fin de l’installation les éléments ignorés. npm install-scripts approve et npm install-scripts deny gérer cette liste, en associant les autorisations à la version que vous avez effectivement vérifiée.
npm ci –ignore-scripts
Dans les anciennes versions de npm, ce drapeau correspond à la version « brute » de ce même concept, sans la liste blanche. Dans tous les cas, cela ne concerne que la phase d’installation. Le code exécuté lors de l’importation, de la compilation ou de l’exécution n’est pas affecté.
3. Ne puiser que dans une source sélectionnée avec soin
La mesure structurelle la plus efficace consiste à modifier la destination vers laquelle un nom peut être résolu. Un référentiel qui rejette tout ce qui ne figure pas dans un catalogue approuvé échoue lors de la résolution d'un nom inventé, ce qui représente le maillon le moins coûteux de toute la chaîne en cas d'échec.
Cette propriété provient de la liste blanche, et non du référentiel géré. De nombreux registres privés proposent des versions validées pour les paquets qu’ils couvrent et redirigent tout le reste depuis la source, ce qui laisse l’exposition d’origine intacte pour chaque nom ne figurant pas dans l’ensemble couvert. Cela vaut la peine de vérifier avant de supposer qu’un miroir a cessé ses activités.
SecureChain de TuxCare est conçu pour l’ensemble des langages pris en charge. Il couvre six écosystèmes : JavaScript, Python, Java, Go, Rust et PHP, tous disponibles à partir d’un même catalogue soigneusement sélectionné. Le calendrier de déploiement varie légèrement selon les écosystèmes et certains d’entre eux peuvent encore être en phase de pré-lancement. N’hésitez donc pas à envoyer un e-mail à [email protected] si vous souhaitez connaître l’état d’avancement d’une pile spécifique.
Les paquets sont recompilés à partir du code source dans des environnements sécurisés et isolés, analysés à la recherche de logiciels malveillants connus et de modèles de code suspects, puis mis à jour conformément au SLA dès la publication des CVE, avec une provenance certifiée SLSA de niveau 3 ainsi que des données SBOM et VEX disponibles. Orientez votre gestionnaire de paquets ou de référentiels vers le registre TuxCare : le fichier de verrouillage régénéré enregistrera alors les URL et les sommes de contrôle de TuxCare plutôt que les archives tar publiques. Selon la documentation de TuxCare, ce registre fournit les versions SecureChain lorsqu’elles existent et, dans le cas contraire, les paquets publics en amont via le même point de terminaison ; la garantie contre le « slopsquatting » provient donc de la liste blanche que vous appliquez en plus de cela, et non du simple changement de registre.
4. Analyser et surveiller le comportement des nouvelles dépendances
L'analyse des signatures et de la réputation est particulièrement efficace contre les menaces qui ont déjà été identifiées. Un paquet malveillant récemment enregistré n'a pas encore été intégré à ces bases de données, ce qui correspond exactement à la fenêtre d'opportunité exploitée par le « slopsquatting ».
Les contrôles comportementaux comblent cette lacune. Accès réseau inattendu pendant l'installation, code source obscurci ou minifié dans un paquet qui devrait être en clair, lecture d'identifiants et de variables d'environnement, écritures en dehors du répertoire du paquet. De nombreux paquets légitimes effectuent une ou deux de ces opérations, en particulier les compilations de modules natifs ; il s'agit donc de les mettre en évidence pour qu'ils soient examinés plutôt que de les bloquer automatiquement.
Analysez les modifications apportées aux dépendances dans l'environnement de CI avant leur intégration, et prévoyez également une nouvelle analyse programmée. La première permet de détecter ce que vous ajoutez ; la seconde permet de repérer les paquets qui fonctionnaient correctement lors de leur intégration, mais qui ne fonctionnent plus trois semaines plus tard.
Conseil d'expert : Comparez le manifeste des dépendances dans chaque pull request et exigez une validation explicite des ajouts, indépendamment de la révision du code. C'est en séparant les modifications des dépendances des modifications générales du code que la révision de la chaîne d'approvisionnement devient suffisamment visible pour qu'on puisse insister sur son importance.
5. Rédiger une politique de révision pour le code généré par l'IA
Les outils ne permettent pas de combler une lacune dans un processus. Définissez par écrit la marche à suivre lorsqu'un outil d'IA propose une dépendance.
Une politique efficace consiste à considérer tout paquet suggéré par l’IA comme non fiable jusqu’à ce qu’une personne l’ait soumis aux vérifications prévues dans la mesure de protection n° 1, et à approuver les nouvelles dépendances en précisant leur nom et leur version, plutôt que sur la base d’une compilation réussie. Les agents ne disposent pas d’un accès en écriture non contrôlé aux manifestes de dépendances ; les ajouts et les changements de version sont soumis à une procédure d’approbation. La liste des sources approuvées est appliquée au niveau du gestionnaire de paquets ou de la couche de politique du référentiel, de sorte qu’un non-respect de la politique se traduit par un échec de la compilation plutôt que par un problème de confiance.
En quoi TuxCare SecureChain modifie-t-il ce que vous installez ?
La méthode « slopsquatting » fonctionne parce qu’une commande d’installation résoudra sans sourciller un nom que personne n’a vérifié. SecureChain modifie ce que vous obtenez lors de la résolution d’un nom. Les paquets du catalogue sont recompilés à partir de sources vérifiées et soumis à un filtrage visant à détecter les logiciels malveillants connus et les comportements suspects avant d’être mis à disposition pour l’installation ; ils continuent par ailleurs à être corrigés même après que les responsables en amont ont cessé leur activité, ce qui résout le problème des dépendances compromises, qui va de pair avec celui des noms fantômes.
Appliquez une liste blanche au niveau supérieur, de sorte que la compilation ne puisse pas aller au-delà de ce répertoire, et qu'un nom inventé n'ait absolument rien à partir de quoi s'installer, qu'un attaquant ait ou non eu le temps de s'y introduire avant.
Découvrez comment cette solution s'intègre à votre infrastructure sur la page SecureChain pour les logiciels libres, ou posez-nous une question concernant votre environnement spécifique.
FAQ
À l'heure où nous écrivons ces lignes, aucun cas documenté publiquement ne permet de retracer clairement le parcours d'une hallucination de modèle spécifique jusqu'à une compromission confirmée au sein d'une organisation identifiée. Les paquets malveillants utilisant des noms « slopsquattés » sont toutefois bien documentés, le cas le plus flagrant étant la campagne PhantomRaven. Selon des rapports citant Koi Security, la première vague sur npm, en octobre 2025, comptait 126 paquets et plus de 86 000 téléchargements ; Endor Labs a ensuite identifié 88 autres paquets répartis sur trois vagues jusqu’en février 2026, dont plusieurs imitaient des plugins Babel, des outils GraphQL et des préréglages ESLint. L’attribution de ces paquets est contestée. Ces paquets auraient été présentés comme un exercice de recherche en sécurité, une interprétation que Endor Labs a rejetée après avoir découvert des activités de collecte d’identifiants et une infrastructure de commande et de contrôle active.
Parfois. Comparez la date de publication du paquet avec celle à laquelle votre assistant vous l'a suggéré, puis examinez le dépôt, l'historique des responsables et l'historique des versions. Un paquet récemment publié sans projet en amont vérifiable mérite une attention particulière. L'ancienneté en soi ne prouve rien, car les assistants dotés d'outils de recherche sur le Web et d'outils de gestion de registres peuvent légitimement recommander un paquet publié la semaine dernière.
Uniquement si ce système applique une liste blanche et que vos builds passent effectivement par celle-ci. Un cache « pull-through », qui récupère à la demande tout nom sollicité auprès de la source en amont, reproduit la même vulnérabilité, avec un saut supplémentaire entre vous et l'attaquant.
Un peu. Lors du test d’autodétection de l’USENIX, trois des quatre modèles invités à revérifier leurs propres résultats ont identifié les noms « hallucinés » avec une précision supérieure à 75 %. Il s’agit là d’un modèle vérifiant sa propre mémoire dans des conditions contrôlées, sans recourir à un registre de référence. L’association de l’assistant à des outils de recherche et de validation en temps réel s’est avérée plus efficace lors de l’évaluation de Trend Micro, réduisant de moitié environ les taux d’hallucinations, car la vérification provient finalement de l’extérieur du modèle à l’origine de l’erreur.
Il n'y a pas de réponse définitive. L'étude USENIX de 2025 a attribué à JavaScript un score supérieur à celui de Python (21,3 % contre 15,8 %), tandis que le pré-publication de 2026 a fait état d'une tendance inverse pour ses cinq modèles les plus récents. L'exposition dépend davantage du modèle, de l'ensemble de prompts et du flux de travail que du langage lui-même.