Suporte Técnico
 Documentação
 Entrar
 Entre em contato conosco



Vá direto para um resumo gerado por IA desta postagem do blog 


Principais conclusões
- O “slopsquatting” é quando um invasor registra o nome de um pacote criado por uma ferramenta de IA e espera que alguém o instale.
- Isso funciona porque as alucinações se repetem, e 43% delas reapareceram em todas as dez repetições do estudo da USENIX.
- Um repositório que rejeita qualquer elemento que não conste de um catálogo aprovado impede que um nome inventado seja resolvido.
- Agentes de codificação que instalam dependências por conta própria eliminam a última etapa de verificação humana.
Alguém da sua equipe cola um trecho de código Python de um assistente de IA e executa o comando linha `pip install` que veio junto, e o terminal passa pela linha sem apresentar erros. A importação funciona. Slopsquatting é o que acontece quando o nome desse pacote não apontava para nada até que um invasor o reivindicou. O modelo o inventou, alguém o registrou primeiro, e a instalação deu a ele um ponto de apoio.
Este guia explica o que significa “slopsquatting”, como funciona a cadeia de ataque, o que as pesquisas realmente revelam sobre a frequência com que isso ocorre e quais medidas de defesa se mostram eficazes antes que o ataque chegue a um pipeline real.
O que é o “slopsquatting”?
O “slopsquatting” é um ataque à cadeia de suprimentos de software no qual um invasor registra um nome de pacote que grandes modelos de linguagem tendem a “alucinar” e, em seguida, publica código malicioso sob esse nome. O desenvolvedor o instala porque seu assistente de IA disse que ele existia. Isso é uma “alucinação de pacote”: o modelo recomenda uma dependência que não está no registro para o qual ele acabou de indicar.
O termo foi cunhado por Seth Larson, desenvolvedor residente de segurança na Python Software Foundation, e popularizado por Andrew Nesbitt, que dirige a plataforma de dados de código aberto Ecosyste.ms. Ele une o conceito de “AI slop” ao “typosquatting”.
Ninguém digitou nada errado aqui. O comando de instalação estava correto, o nome estava escrito exatamente como constava no modelo, e a confiança nisso vinha de um sistema que nunca verificou o nome em relação ao registro a partir do qual estava fazendo a recomendação.
Slopsquatting x Typosquatting
O typosquatting se aproveita do erro humano. solicitações em vez de requests. Ou python3-dateutil, publicado no PyPI em 2019 para competir com python-dateutil e removido dias depois, quando alguém percebeu que ele incluía um segundo pacote que coletava chaves SSH e GPG. O Slopsquatting se aproveita de erros de sistema, e esses erros acabam sendo muito mais organizados do que se imagina.
| Typosquatting | Slopsquatting | |
| O que aciona a instalação | Erro humano ou nome lembrado incorretamente | Uma IA sugere um nome que não consta no registro pretendido |
| Escala observada em um estudo | Agrupados em torno de um punhado de alvos de alto valor | 205.474 nomes alucinados únicos observados |
| Previsibilidade | O invasor adivinha possíveis erros ortográficos | O invasor obtém nomes por meio de instruções aos modelos |
| Semelhança com nomes reais | Geralmente, basta uma pequena edição para chegar ao resultado final | 13,4% das “alucinações” do Python estão dentro de uma distância de edição de 1 a 2 do pacote real mais próximo; 48,6% estão a seis edições ou mais de distância |
| Quem está em risco | Desenvolvedores e fluxos de trabalho automatizados que corrigem um nome incorreto | Qualquer pessoa que aceite listas de dependências geradas por IA, incluindo agentes |
Muitos nomes inventados não se aproximam nem um pouco de um pacote real. Apenas 13,4% dos nomes inventados em Python ficaram a um ou dois caracteres do nome existente mais próximo, enquanto 48,6% estavam a seis edições ou mais de distância. Trata-se de invenções que soam plausíveis, e não de casos em que faltou pouco para serem parecidos, e é por isso que as verificações de distância de edição e de similaridade de nomes deixam passar tantos deles.
Os nomes também se repetem. Os pesquisadores da USENIX selecionaram 500 prompts que haviam gerado alucinações e executaram cada um deles dez vezes. 43% dos nomes alucinados apareceram em todas as dez execuções, e 58% apareceram mais de uma vez. Um invasor não precisa adivinhar. Essa recorrência é o que realmente diferencia essa técnica do typosquatting clássico, em que o invasor tenta prever como as pessoas digitam errado, em vez de avaliar o que um modelo inventa de forma confiável.
Como funciona um ataque do tipo “slopsquatting”
Quatro etapas, nenhuma delas tecnicamente complexa, o que explica em parte por que os pacotes gerados por IA são um mecanismo de entrega tão eficiente. Uma tentativa bem-sucedida corresponde a MITRE ATT&CK T1195.001, Comprometimento de dependências de software e ferramentas de desenvolvimento, portanto, ela se enquadra dentro de um modelo de ameaças que você já possui, em vez de ficar à margem como algo exótico.
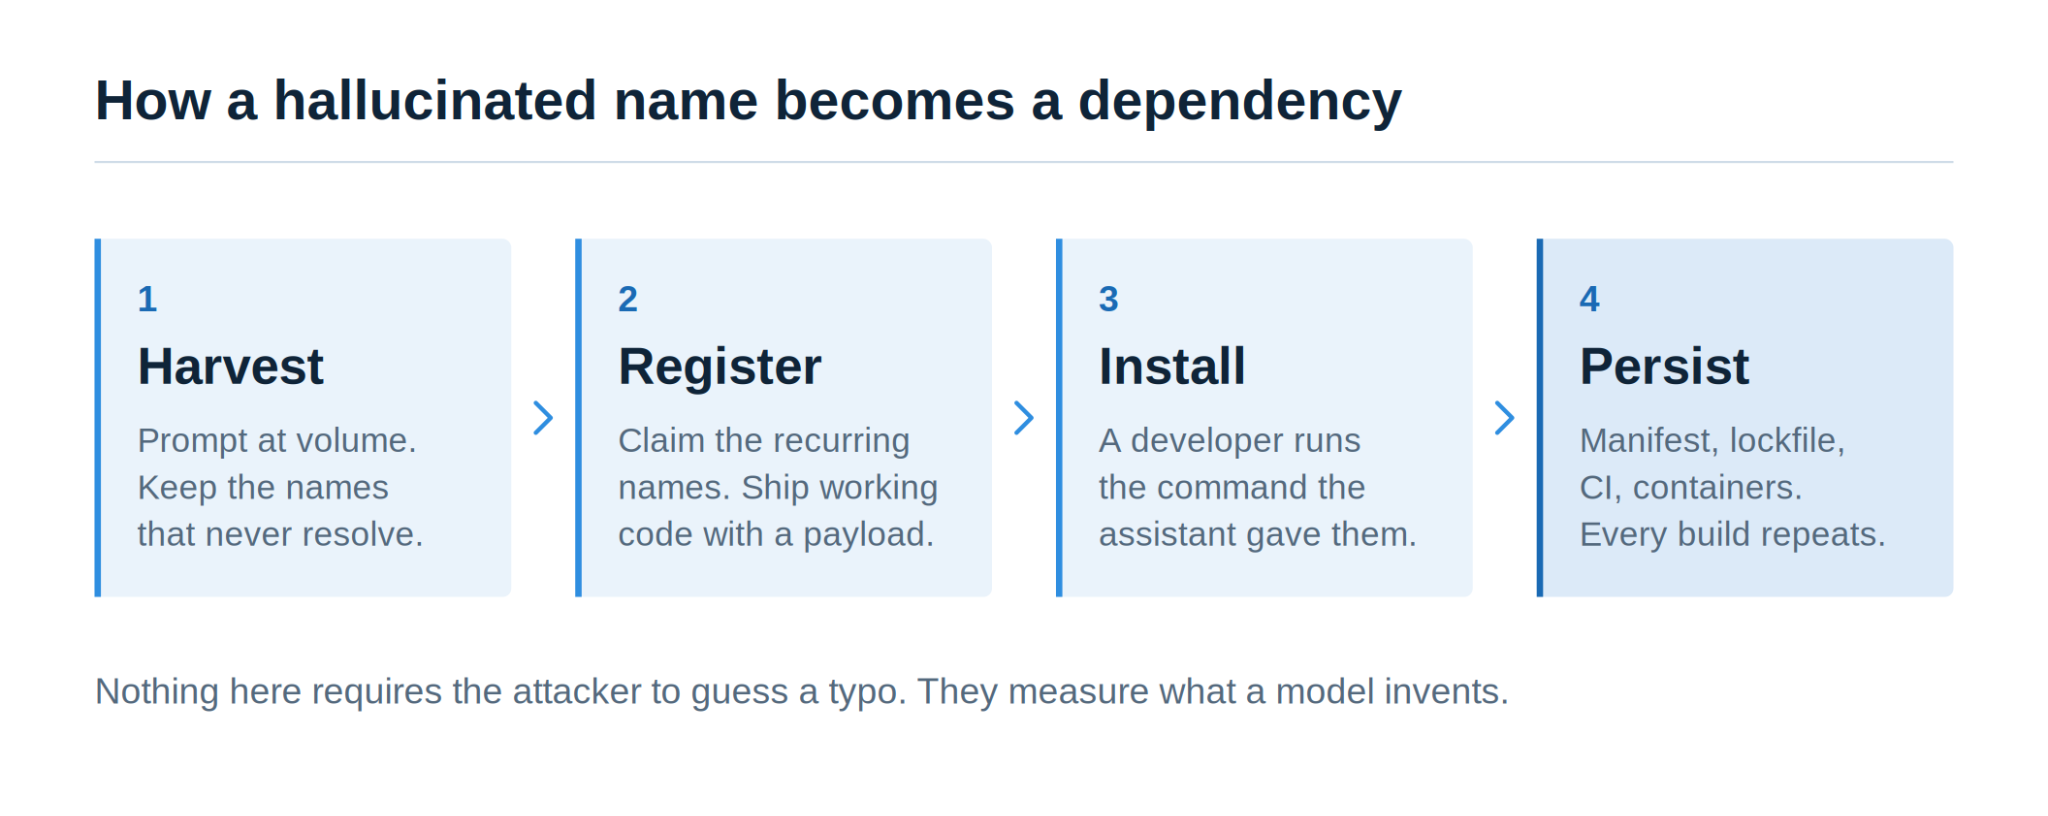
1. Colher as alucinações
O invasor executa comandos de geração de código em grande escala, coleta todos os nomes de pacotes na saída e verifica cada um deles no PyPI ou no npm. Os nomes que não são identificados são adicionados à lista. Os nomes que continuam sem ser identificados, mesmo após repetidas execuções do mesmo modelo, são colocados no topo da lista.
Há uma constatação que merece uma reflexão mais aprofundada. No estudo da USENIX, os nomes alucinados eram, com muito mais frequência, específicos a um único modelo do que comuns a vários modelos: 81% dos nomes exclusivos provinham de exatamente um dos 16 modelos testados. A recorrência e a sobreposição variam de acordo com o modelo; portanto, o mais sensato é avaliar os assistentes que sua própria equipe realmente utiliza, em vez de presumir que uma lista negra comum seja suficiente.
A medição em escala de pesquisa não é barata, mas não precisa ser. A equipe da USENIX gerou 576.000 amostras de código em 16 modelos para abranger duas linguagens e um amplo conjunto de prompts. O volume necessário para testar uma estrutura, um SDK de nuvem ou um caso de uso de caráter interno é um problema diferente e muito menor.
A escolha do modelo teve grande importância nos modelos testados pelo estudo no início de 2024, quando os modelos de código aberto apresentaram uma taxa média de alucinações de 21,7%, contra 5,2% dos modelos comerciais. Um preprint de 2026, que aplicou a mesma metodologia a cinco modelos de ponta mais recentes, constatou taxas gerais variando entre 4,62% e 6,10%. Como ainda não passou por revisão por pares, considere-o um sinal inicial, e não uma tendência consolidada. Os nomes inventados continuam em uso, independentemente do resultado.
Dica de quem entende do assunto: Sufixos plausíveis, como -utils, -helpers, -client e -sdk podem fazer com que um nome inventado pareça confiável à primeira vista. Trate uma convenção de nomenclatura que pareça sensata como um motivo para verificar, nunca como prova de que um pacote é real.
2. Registre o nome e dê vida a ele
O invasor registra os melhores nomes e publica algo que funcione. Um código funcional que faça mais ou menos o que o nome sugere, um arquivo README e uma licença com um texto compreensível.
A carga maliciosa fica no caminho de instalação ou em uma importação que quase ninguém acessa. Um gancho de instalação que faz uma solicitação de saída quando é executado, ou código que se comporta de uma maneira em um laptop e de outra em algum lugar com credenciais e acesso à rede que valem a pena. Funcionalidades que parecem inofensivas ganham tempo justamente porque a importação esperada parece funcionar.
Os números de downloads ilustram isso melhor do que qualquer hipótese. A Lasso Security registrou um pacote vazio com o nome fantasioso huggingface-cli e registrou mais de 30 mil downloads ao longo de três meses, incluindo um repositório de pesquisa do Alibaba cujo arquivo README orientava as pessoas a instalá-lo. Uma prova de conceito inofensiva, sem nenhum código malicioso, acabou sendo referenciada em artefatos reais de desenvolvimento.
3. Um desenvolvedor instala o programa conforme a orientação da IA
A instalação em si não tem nada de especial. Alguém pergunta a um assistente como fazer algo, recebe um código que parece funcionar e executa o comando que veio junto com ele.
pip install NOME_DO_PACOTE
Na ausência de controles de registro ou alertas de ponto final, nenhum aviso é acionado. O pacote é resolvido, instalado e importado. Se o desenvolvedor verificar alguma coisa, ele verificará se a importação funciona, o que de fato acontece.
A confiança no modelo se aplica aqui. O nome de um pacote inserido em um código que, fora isso, está correto, aproveita a credibilidade desse código; e, em uma equipe que trabalha em ritmo acelerado, uma nova dependência introduzida em uma alteração que, fora isso, seria rotineira, recebe menos atenção do que a lógica ao seu redor, a menos que a revisão identifique explicitamente as adições de dependências. Ainda é preciso que alguém leia a sugestão e decida executá-la. Quando um agente tem permissão para instalar dependências e não há nenhum processo de aprovação no caminho, ninguém lê nada.
4. Ele persiste nas compilações e na integração contínua (CI)
Assim que o nome estiver no arquivo requirements.txt ou package.json, ele deixa de ser uma decisão e passa a ser parte da infraestrutura. As compilações que fazem a instalação a partir desse manifesto o buscam. Novas imagens de contêiner o incorporam. Todos os ambientes que resolvem a dependência a herdam, desde laptops até executores de CI e sistemas de compilação que contêm tokens de implantação e credenciais de registro.
A propagação transitiva agrava ainda mais a situação. Se o pacote comprometido for incluído como dependência de uma biblioteca interna, ele chega a serviços cujos mantenedores nunca viram a sugestão original. Nesse ponto, a questão da auditoria já não é mais quem instalou isso, mas sim onde ele acabou indo parar.
A partir daí, os resultados são os típicos de qualquer dependência comprometida: roubo de credenciais, mineração de criptomoedas, tráfego de saída inesperado ou um comprometimento mais amplo de tudo o que o ambiente de compilação puder acessar, incluindo hosts Linux.
Atenção: Os arquivos de bloqueio identificam o pacote malicioso com a mesma precisão que um pacote legítimo. Um arquivo de bloqueio garante a reprodutibilidade; ele não revela nada sobre o que foi bloqueado. Ele reproduzirá a vulnerabilidade em todos os hosts que fizerem a instalação a partir dele até que a dependência e sua entrada no arquivo de bloqueio sejam removidas deliberadamente.
O que as pesquisas mostram
Esses números são provenientes de “We Have a Package for You! Uma Análise Abrangente das Alucinações de Pacotes por LLMs Geradores de Código”, apresentado na USENIX Security 2025. Trata-se do estudo em grande escala que todos os demais profissionais da área acabam citando, e cada dado da tabela abaixo remete diretamente a ele, e não a um resumo de segunda mão.
| Conclusão | Figura |
| Recomendações de pacotes alucinadas | 440.445 de 2,23 milhões (19,7%) |
| Nomes alucinatórios únicos observados | 205,474 |
| Taxa de alucinação do modelo de código aberto | 21.7% |
| Taxa de alucinações do modelo comercial | 5.2% |
| As alucinações se repetiram em todas as 10 reprises | 43% |
| Alucinações que nunca se repetiram | 39% |
| Alucinações em Python válidas como pacotes do npm | 8.7% |
Há três aspectos aqui que são mais importantes do que a porcentagem apresentada na manchete.
A recorrência é o fator que possibilita o ataque. 43% dos nomes alucinados reapareceram em todas as dez repetições e 58% reapareceram mais de uma vez, o que coloca a maior parte deles fora do âmbito do ruído pontual. É a repetibilidade que faz com que a coleta valha o tempo do invasor.
O número referente a outros ecossistemas é o que confunde as pessoas. 8,7% dos nomes de Python gerados aleatoriamente eram pacotes válidos do npm; portanto, um desenvolvedor que verifica se um nome existe em algum lugar recebe um sinal verde que não significa nada. O fato de existir em outro registro não é prova de que se trate da dependência solicitada.
A divisão entre as linguagens muda. Nos modelos da era de 2024 analisados no estudo da USENIX, o JavaScript apresentou alucinações em 21,3%, contra 15,8% do Python. O pré-impresso de 2026 relatou que essa relação se inverteu nos cinco modelos mais recentes. Considere isso como uma característica do modelo em questão, e não da linguagem.
Por que os agentes de IA aumentam os riscos
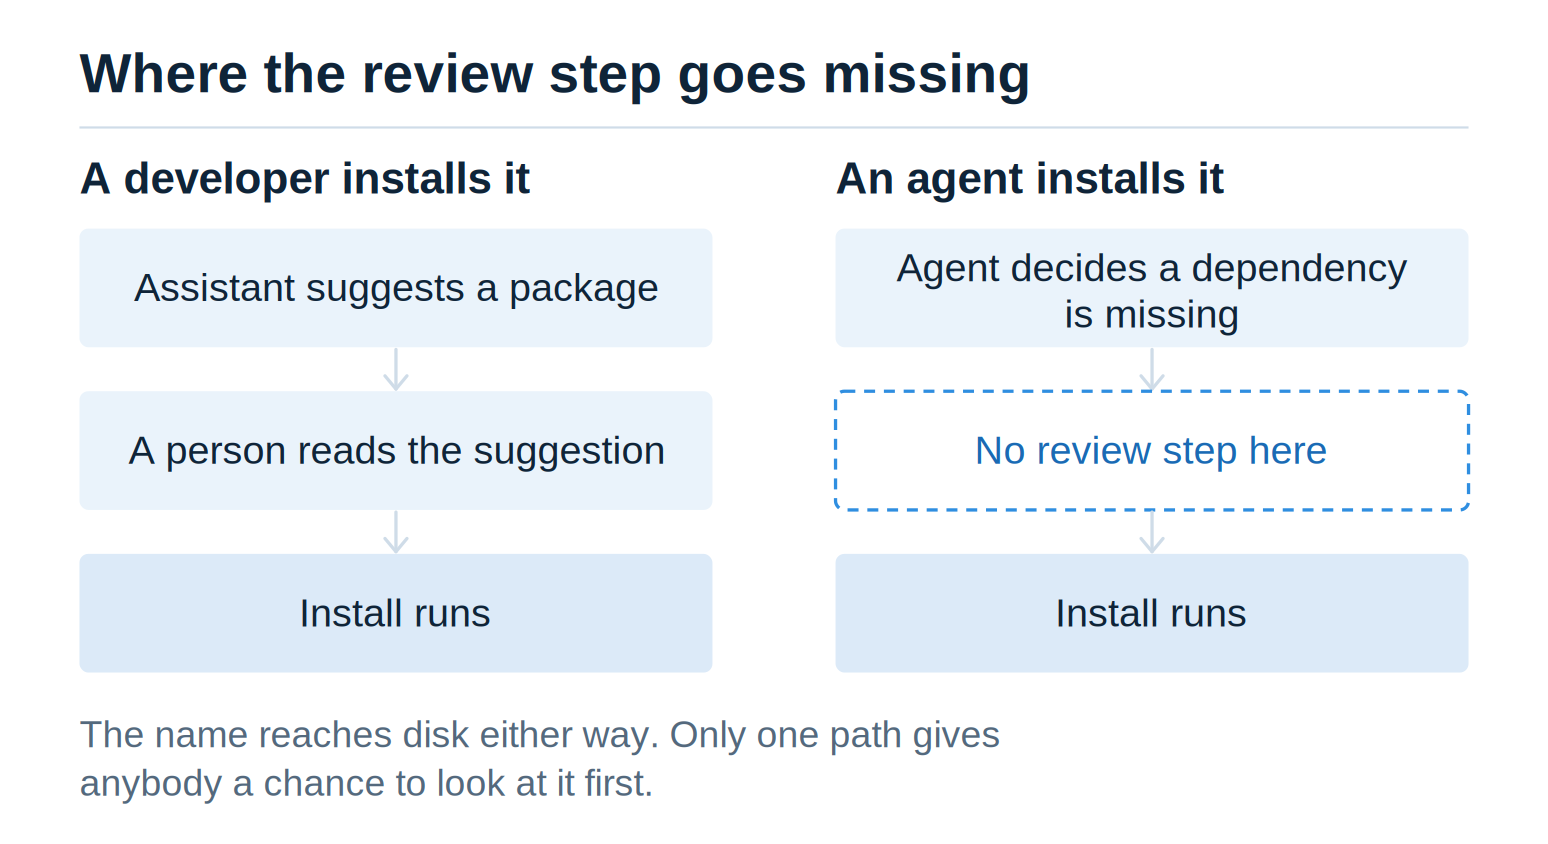
O Passo 3 acima pressupõe que alguém leia uma sugestão de código gerada por IA antes de executá-la. As ferramentas baseadas em agentes podem eliminar essa suposição. Um agente que detecta um erro, identifica que falta uma dependência e a instala fecha o ciclo; e, sem uma visualização prévia, uma verificação de política ou uma etapa de aprovação, o nome do pacote chega ao disco antes que alguém o veja.
Testes realizados pelos fornecedores indicam que as ferramentas estão melhorando, mas sem resolver o problema. A pesquisa da Trend Micro sobre slopsquatting revelou que agentes de codificação com raciocínio em cadeia de pensamento e pesquisa em tempo real na web reduziram as taxas de alucinação em cerca de metade em sua avaliação, sendo que as configurações que realizavam validação em tempo real produziram o menor número de dependências fantasmas entre todas. No entanto, alguns nomes ainda passaram. A Trend Micro atribui os erros residuais ao preenchimento de lacunas de contexto, à imitação superficial de formas e ao empréstimo de nomes entre ecossistemas, em que o agente monta algo que segue as convenções de pacotes reais sem corresponder a nenhum deles.
Uma redução de 50% é significativa. Não é um controle que se possa simplesmente entregar a um auditor.
Além disso, há a “codificação por intuição”, que, neste contexto, significa aceitar rapidamente o código gerado por IA sem revisar de forma independente suas dependências ou o que elas fazem durante a instalação. O padrão mais seguro é exatamente o oposto. Qualquer dependência de terceiros sugerida pela IA permanece sem verificação até que algo além do modelo confirme o pacote e a versão. Junte essa lacuna a agentes que se instalam sozinhos e o ponto de verificação deixa de existir.
Como se defender contra o slopsquatting
Nenhum controle isolado detecta isso. A verificação detecta os casos óbvios, o pinning limita o alcance do impacto, uma lista de permissões obrigatória fecha a brecha de resolução, e a política de varredura e revisão garante que os três primeiros sejam cumpridos. Execute-os em conjunto.
Se suas compilações são resolvidas diretamente a partir de registros públicos, a lista de permissões da defesa 3 é o que muda a natureza do problema. Se você já opera um espelho interno, verifique primeiro se ele aplica uma lista de permissões ou simplesmente armazena em cache tudo o que recebe, pois um cache de repasse irrestrito mantém essa vulnerabilidade praticamente na mesma situação.
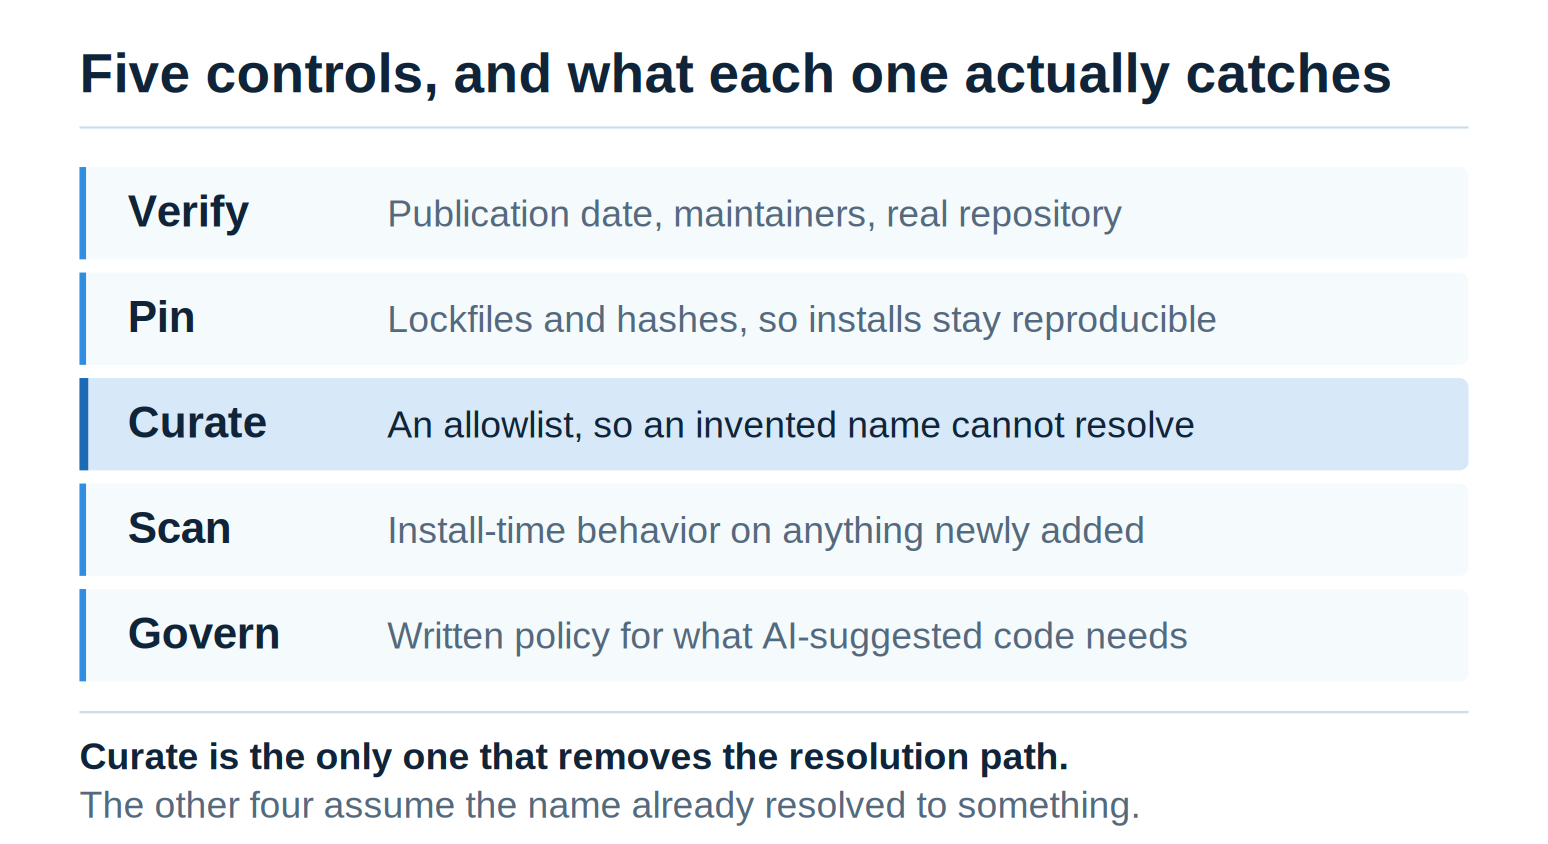
1. Verifique se o pacote existe e se possui histórico
Antes que um pacote sugerido pela IA seja incluído em um manifesto, verifique quando ele foi publicado pela primeira vez, quem o mantém, se o repositório associado é real e ativo e se o artefato no registro corresponde a essa fonte. Os dados de publicação e do mantenedor vêm diretamente dos metadados do registro, sem a necessidade de instalar nada ou executar o código do pacote.
curl -s https://pypi.org/pypi/PACKAGE_NAME/json
npm view NOME_DO_PACOTE time.created maintainers
A adoção é uma consulta separada. O endpoint JSON do PyPI retorna -1 nos campos de download; portanto, obtenha esses dados do pypistats ou do conjunto de dados do BigQuery se o volume de downloads fizer parte do seu gráfico. A autenticidade do repositório e a correspondência entre código-fonte e artefato também precisam de verificação própria; um link para o registro, por si só, não prova nada sobre quem é o proprietário do que ele aponta.
Estabeleça esses critérios como política, e não como instinto. Idade, adoção, identidade do mantenedor e correspondência verificada entre código-fonte e artefato. Esses quatro critérios revelarão inconsistências óbvias antes que uma dependência entre no gráfico; no entanto, um pacote malicioso bem elaborado ainda pode passar por todos eles. Eles são sinais para revisão, não prova de segurança.
2. Fixar dependências com arquivos de bloqueio e hashes
Os arquivos de bloqueio garantem a reprodutibilidade. Os hashes garantem a integridade: desde que o hash tenha sido obtido e protegido por meio de um processo no qual você confia, eles confirmam que o artefato que você instalou é o mesmo que você aprovou.
pip install –require-hashes -r requirements.txt
O modo de verificação de hash é do tipo “tudo ou nada”. Todos os requisitos e todas as dependências transitivas devem ser fixados com == e conter um hash; caso contrário, a instalação falha imediatamente. Portanto, esteja preparado para que a primeira tentativa seja uma tarefa trabalhosa. O que a fixação não faz é garantir que o que você fixou já tenha sido seguro. Os dados do registro do npm são imutáveis; assim, um determinado nome e versão não podem ser republicados, mesmo após uma retirada de publicação. O risco realista é aprovar e congelar o pacote errado logo no primeiro dia, e é por isso que a fixação deve ocorrer após a verificação, e não em vez dela.
A execução de scripts durante a instalação é uma alavanca à parte, e o npm já a acionou. Atualmente, o npm bloqueia scripts de instalação de dependências por padrão, ignorando scripts de ciclo de vida para qualquer item que não tenha uma entrada correspondente em allowScripts e listando o que foi ignorado no final da instalação. Aprovação de scripts de instalação do npm e npm install-scripts deny manter essa lista, com as aprovações vinculadas à versão que você realmente revisou.
npm ci –ignore-scripts
Nas versões mais antigas do npm, essa opção é a versão mais simples da mesma ideia, sem a lista de permissões. De qualquer forma, ela abrange apenas o momento da instalação. O código executado na importação, na compilação ou em tempo de execução não é afetado.
3. Obtenha informações apenas de fontes selecionadas
A medida estrutural mais eficaz é alterar para onde um nome pode ser resolvido. Um repositório que rejeita qualquer elemento fora de um catálogo aprovado falha na resolução de um nome inventado, o que representa o ponto mais econômico de toda a cadeia para ocorrer uma falha.
Essa propriedade vem da lista de permissões, e não do repositório que está sendo mantido. Muitos registros privados oferecem compilações verificadas para os pacotes que abrangem e repassam todo o restante do upstream, o que mantém a exposição original intacta para todos os nomes fora do conjunto coberto. Vale a pena verificar isso antes de presumir que um espelho tenha encerrado suas atividades.
O SecureChain da TuxCare foi desenvolvido para o conjunto coberto. Ele abrange seis ecossistemas — JavaScript, Python, Java, Go, Rust e PHP —, todos disponibilizados a partir do mesmo catálogo selecionado. O cronograma de lançamento varia um pouco de acordo com o ecossistema, e um ou mais deles ainda podem estar em fase de pré-lançamento; portanto, envie um e-mail para [email protected] se precisar saber o status atual de uma pilha específica.
Os pacotes são recompilados a partir do código-fonte em ambientes fortificados e isolados, analisados quanto à presença de malware conhecido e padrões de código suspeitos, e atualizados de acordo com o SLA à medida que novos CVEs são divulgados, com proveniência SLSA Nível 3 e dados SBOM e VEX disponíveis. Direcione seu gerenciador de pacotes ou repositório para o registro da TuxCare, e o arquivo de bloqueio regenerado registrará URLs e checksums da TuxCare em vez de arquivos tar públicos. De acordo com a própria documentação da TuxCare, esse registro fornece compilações do SecureChain quando elas existem e pacotes públicos de upstream para os demais por meio do mesmo endpoint; portanto, a garantia contra slopsquatting vem da lista de permissões que você aplica sobre ele, e não apenas da troca de registro.
4. Analisar e acompanhar o comportamento das novas dependências
A verificação de assinaturas e reputação funciona melhor contra ameaças que já foram identificadas. Um pacote malicioso recém-registrado ainda não foi incluído nessas bases de dados, e é exatamente nessa brecha que o slopsquatting atua.
As verificações comportamentais preenchem essa lacuna. Acesso inesperado à rede durante a instalação, código-fonte ofuscado ou minificado em um pacote que deveria estar em formato simples, leitura de credenciais e variáveis de ambiente, gravações fora do diretório do pacote. Muitos pacotes legítimos realizam uma ou duas dessas ações, especialmente as compilações de módulos nativos; portanto, o objetivo é identificá-las para análise, em vez de bloqueá-las automaticamente.
Verifique as alterações nas dependências na integração contínua (CI) antes que elas sejam incorporadas e mantenha também uma nova verificação programada em execução. A primeira verifica o que você está adicionando; a segunda identifica o pacote que estava funcionando corretamente quando foi incluído, mas deixou de funcionar três semanas depois.
Dica de especialista: Faça o diff do manifesto de dependências em cada pull request e exija aprovação explícita para adições, separadamente da revisão de código. Separar as alterações nas dependências das alterações gerais no código é o que torna a revisão da cadeia de suprimentos visível o suficiente para que se insista nela.
5. Elabore uma política de revisão para códigos gerados por IA
As ferramentas não resolvem uma lacuna no processo. Defina, por escrito, o que acontecerá quando uma ferramenta de IA sugerir uma dependência.
Uma política viável trata qualquer pacote sugerido pela IA como não confiável até que uma pessoa o submeta às verificações da defesa 1 e aprove novas dependências por nome e versão, em vez de basear-se apenas no resultado positivo da compilação. Os agentes não têm acesso de gravação sem revisão aos manifestos de dependências; adições e alterações de versão passam por um processo de aprovação. A lista de fontes aprovadas é aplicada no gerenciador de pacotes ou na camada de políticas do repositório, de modo que uma falha na política se manifesta como uma falha na compilação, em vez de como um problema de confiança.
O que o TuxCare SecureChain altera em relação ao que você instala
O “slopsquatting” funciona porque um comando de instalação resolve sem problemas um nome que ninguém verificou. O SecureChain altera o resultado dessa resolução. Os pacotes do catálogo são recompilados a partir de código-fonte verificado e analisados em busca de malware conhecido e padrões suspeitos antes de serem disponibilizados para instalação; além disso, continuam recebendo correções mesmo depois que os mantenedores originais deixam o projeto, o que resolve o problema das dependências comprometidas, que está intimamente ligado ao problema dos nomes fantasiosos.
Aplique uma lista de permissões como primeira medida, de modo que a compilação não possa ir além desse catálogo, e um nome inventado não tenha de onde instalar nada, independentemente de um invasor ter chegado lá primeiro ou não.
Veja como ele se encaixa na sua pilha de tecnologias na página do SecureChain para OSSou faça uma pergunta sobre seu ambiente específico.
Perguntas frequentes
Até o momento da redação deste artigo, não há nenhum caso documentado publicamente que se estenda de forma clara desde um modelo específico de alucinação até um comprometimento confirmado em uma organização identificada. No entanto, pacotes maliciosos que utilizam nomes obtidos por meio de “slopsquatting” estão bem documentados, sendo a campanha PhantomRaven o exemplo mais evidente. Relatórios citando a Koi Security indicam que a primeira onda no npm, em outubro de 2025, envolveu 126 pacotes e mais de 86.000 downloads, com a Endor Labs rastreando posteriormente mais 88 pacotes em três ondas até fevereiro de 2026, vários deles imitando plug-ins do Babel, ferramentas do GraphQL e predefinições do ESLint. A autoria é contestada. Alegou-se que os pacotes fossem um exercício de pesquisa de segurança, caracterização que a Endor Labs rejeitou após encontrar coleta de credenciais e uma infraestrutura ativa de comando e controle.
Às vezes. Compare a data de publicação do pacote com a data em que seu assistente o sugeriu e, em seguida, verifique o repositório, o histórico do mantenedor e o histórico de versões. Um pacote recém-publicado sem um projeto upstream verificável merece uma análise cuidadosa. A idade, por si só, não prova nada, pois assistentes que utilizam ferramentas de pesquisa na web e de registro podem, legitimamente, recomendar algo publicado na semana passada.
Somente se ele aplicar uma lista de permissões e se suas compilações forem de fato resolvidas por meio dela. Um cache pull-through que busca qualquer nome solicitado do servidor upstream sob demanda reproduz a mesma exposição, com um salto adicional entre você e o invasor.
Um pouco. No teste de autodetecção da USENIX, três dos quatro modelos solicitados a rever sua própria saída identificaram nomes alucinados com precisão superior a 75%. Trata-se do modelo auditando sua própria memória em condições controladas, sem comparar nada com um registro. A combinação do assistente com ferramentas de pesquisa e validação em tempo real teve um desempenho melhor na avaliação da Trend Micro, reduzindo as taxas de alucinação pela metade, aproximadamente, pois a verificação, por fim, vem de fora do modelo que cometeu o erro.
Não há uma resposta definitiva. O estudo da USENIX de 2025 indicou que o JavaScript apresentou desempenho superior ao Python, com 21,3% contra 15,8%, enquanto o pré-impresso de 2026 relatou o contrário em seus cinco modelos mais recentes. A exposição depende mais do modelo, do conjunto de prompts e do fluxo de trabalho do que da linguagem em si.