Suporte Técnico
 Documentação
 Entrar
 Entre em contato conosco


Vá direto para um resumo gerado por IA desta postagem do blog 


Principais conclusões
- Uma exploração de dia zero é um código de ataque funcional para uma vulnerabilidade para a qual ainda não há correção disponível ao público.
- A exploração pode começar antes mesmo de existir uma correção, muitas vezes antes que alguém fora do grupo do invasor tenha conhecimento disso.
- Softwares em fim de vida útil podem apresentar novas falhas sem que haja qualquer correção prevista pelo desenvolvedor original.
- O que você controla é a rapidez com que uma correção chega à sua frota, assim que ela estiver disponível.
Seu scanner não detectou nenhum problema. Seu ciclo de atualizações está em dia. Nada disso adianta quando uma vulnerabilidade já está sendo explorada e nenhuma distribuição lançou ainda um pacote corrigido.
Trata-se de uma exploração de dia zero: um código de ataque para uma vulnerabilidade para a qual ainda não há correção disponível ao público. Às vezes, esse código permanece em sigilo por meses. Outras vezes, a exploração é publicada no GitHub no mesmo dia, que foi o que aconteceu quando o Dirty Frag atingiu as distribuições Linux em maio de 2026. De qualquer forma, a exploração é apenas o primeiro passo. Grande parte do custo final para você depende de quanto tempo essa janela de exposição permanece aberta depois disso.
Vulnerabilidade de dia zero x Exploração x Ataque
Uma vulnerabilidade é a falha. Uma exploração é o código que funciona. Um ataque é esse código direcionado a um alvo real. É possível mitigar o problema bem antes dessa última etapa, e a aplicação de patch se torna possível assim que uma correção estiver disponível. Após o início da exploração, a detecção e a contenção são o que lhe dão tempo.
| Termo | O que é isso | Você consegue colocar isso em prática? |
| Vulnerabilidade de dia zero | A falha no código, que pode ser conhecida em âmbito privado, mas ainda não foi divulgada publicamente nem corrigida | Nem sempre. Até que a falha seja identificada, não há nada específico para corrigir; depois disso, pode ser possível adotar medidas de mitigação enquanto se desenvolve uma correção. |
| Vulnerabilidade de dia zero | Código funcional que explora essa falha de maneira confiável | Em parte. Medidas de mitigação, listas de bloqueio de módulos e fortalecimento de segurança podem impedir o funcionamento dessa técnica. |
| Ataque de dia zero | Uma campanha ativa que utiliza essa vulnerabilidade contra alvos reais | Sim. A detecção e a contenção entram em vigor imediatamente, e a aplicação da correção ocorre assim que ela for lançada. |
Uma falha pode permanecer no kernel por anos sem que ninguém registre um relatório de incidente. A vulnerabilidade esteve presente o tempo todo, mesmo que o grau de risco prático que ela representava dependesse da possibilidade de alguém ter acesso a ela. O que uma exploração funcional altera são as chances de esse risco se concretizar. Uma vez que a falha ou a exploração sejam conhecidas, as etapas da resposta passam a ser processos que podem ser cronometrados, medidos e reduzidos.
Tipos de explorações de dia zero
As vulnerabilidades de dia zero não estão distribuídas uniformemente pela sua pilha, e a maneira mais útil de classificá-las é de acordo com o local onde ocorrem. Em seu relatório Veja o que você nos fez corrigir, o Google Threat Intelligence Group (GTIG) contabilizou 90 vulnerabilidades zero-day exploradas na prática durante 2025, um aumento em relação às 78 registradas em 2024, mas ainda abaixo das 100 registradas em 2023. Os sistemas operacionais foram a categoria de produto mais explorada, representando 44% do total, ou 39 falhas. Softwares e dispositivos corporativos, considerados como um grupo em vez de uma única categoria, totalizaram 43 falhas, ou 48%, o que o GTIG relata como o maior índice em ambos os aspectos desde que começou a acompanhar esses dados.
Os ataques direcionados a navegadores seguiram o caminho oposto e caíram para níveis historicamente baixos. Por outro lado, os ataques à infraestrutura corporativa e aos dispositivos de borda permaneceram elevados, impulsionados pelo fato de que a maioria desses dispositivos não conta com cobertura padrão de EDR.
Vulnerabilidades no sistema operacional e no kernel
Os sistemas operacionais foram a maior categoria isolada nos dados de 2025 do GTIG, abrangendo computadores de mesa, dispositivos móveis e servidores, e as falhas no kernel do Linux mostram o quão amplo é o alcance do impacto. Um ataque bem-sucedido nessa camada pode comprometer as barreiras entre aplicativos, contêineres e locatários, além de expor as credenciais mantidas pelo host.
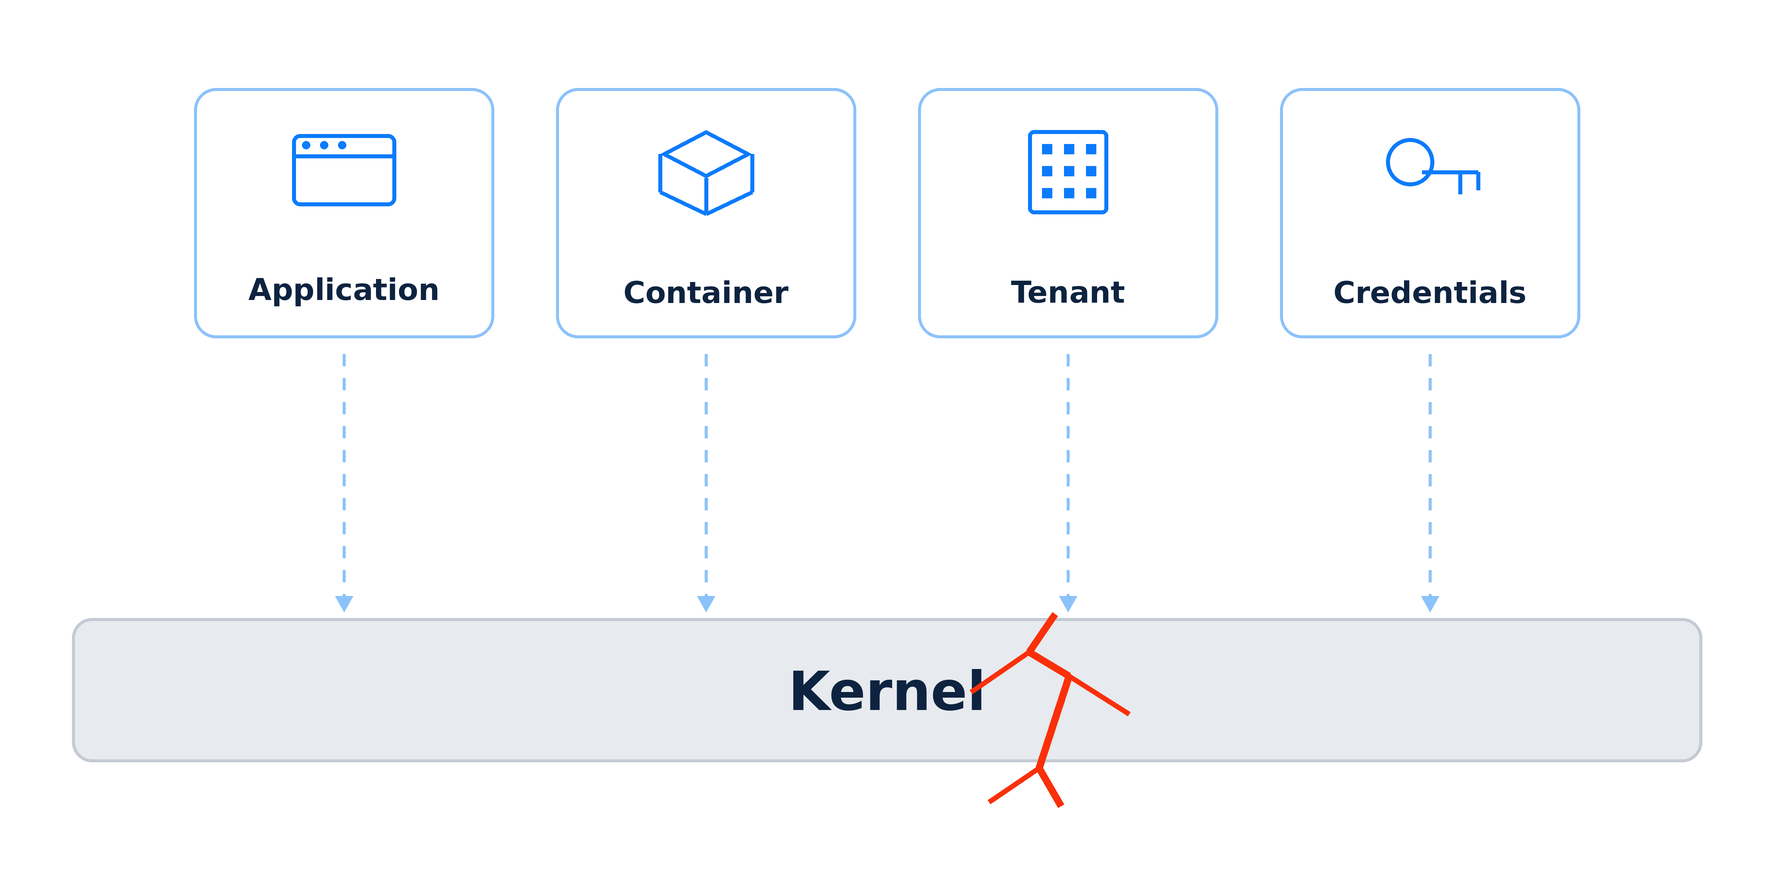
As falhas de escalonamento de privilégios do kernel do Linux de 2026 são um bom exemplo disso. Falha na cópia (CVE-2026-31431, CVSS 7,8) estava presente no módulo algif_aead da API de criptografia do kernel desde uma otimização in-place realizada em 2017. Um usuário local sem privilégios poderia reescrever a cópia no cache de página em memória de um binário setuid, como o su, quatro bytes controlados por vez, sem condição de corrida e sem a necessidade de adivinhar deslocamentos específicos por distribuição. Nada mudava no disco, portanto, o monitoramento de integridade de arquivos não tinha nada a relatar.
Dirty Frag surgiu uma semana depois, combinando o CVE-2026-43284 nos módulos IPsec ESP com o CVE-2026-43500 no rxrpc. Trata-se de duas rotas independentes para a mesma gravação no cache de páginas, e não de uma cadeia; a exploração pública tenta qualquer uma das duas que o host permitir, de modo que fechar um caminho não fecha o outro.
A TuxCare lançou patches em tempo real para o “Copy Fail” após validar o conjunto completo de correções do upstream em relação à exploração publicada; em seguida, lançou patches “Dirty Frag” em até 24 horas após a divulgação de 7 de maio. Quando a exploração é pública e a correção exige uma reinicialização em mil hosts, a reinicialização pode se tornar o gargalo da implantação. Preencher essa lacuna específica é o que KernelCare se destina a fazer.
Você sabia?: Em setembro de 2026, o catálogo de vulnerabilidades exploradas conhecidas da CISA contava com 31 entradas relacionadas a falhas no kernel do Linux. Na mesma época, um rastreador público registrou mais de 6.500 CVEs do kernel do Linux publicados durante 2026. Ambos os números variam constantemente, portanto, verifique-os antes de citá-los em qualquer lugar.
Vulnerabilidades em dispositivos de borda corporativa e aparelhos especializados
Firewalls, concentradores de VPN, dispositivos de transferência de arquivos e plataformas de virtualização estão entre os alvos de ataques “zero-day” de maior valor nas empresas, e a razão para isso é estrutural. Eles estão localizados na borda da rede, possuem credenciais privilegiadas e, na maioria das vezes, não contam com cobertura padrão de EDR para terminais.
Análise de fornecedores da GTIG para 2025 coloca as grandes empresas de tecnologia no topo, com os fornecedores de segurança logo atrás, e destaca a Cisco e a Fortinet como alvos constantes nas áreas de rede e segurança, ao lado da Ivanti e da VMware, onde o foco está no acesso a VPNs e virtualização. Outros 20 fornecedores foram atingidos por exatamente um ataque zero-day cada, o que mostra o alcance que os invasores estão dispostos a abranger. A GTIG também relatou que grupos de espionagem patrocinados por governos continuaram a priorizar dispositivos de borda e equipamentos de segurança, com pouco mais da metade das explorações de zero-day atribuídas a esses grupos voltadas para esse tipo de infraestrutura.
O padrão se repete: execução remota de código antes da autenticação, roubo de credenciais ou chaves e persistência que perdura após a aplicação do patch. Os invasores do ToolShell extraíram chaves de máquina do ASP.NET dos servidores do SharePoint, o que lhes permitiu falsificar cargas válidas muito tempo depois que o servidor foi atualizado. A aplicação do patch corrigiu a vulnerabilidade, mas qualquer pessoa que já possuísse essas chaves manteve acesso ao sistema até que elas fossem substituídas. Se o inventário dos seus dispositivos estiver em uma planilha trimestral, essa planilha é o ponto de exposição.
Vulnerabilidades em aplicativos e na cadeia de suprimentos
A terceira categoria é o código que você não escreveu e, muitas vezes, nem instalou conscientemente. O Log4Shell é o caso de referência: uma falha crítica no Log4j, uma biblioteca de registro de logs enterrada em vários níveis da árvore de dependências de milhares de aplicativos Java. Em uma configuração vulnerável, bastava uma string JNDI controlada pelo invasor — por exemplo, uma fornecida por meio de um cabeçalho HTTP registrado — para atingir um caminho de chamada vulnerável do Log4j.
Falhas nas dependências são mais difíceis de resolver, pois não é possível corrigir o que não se consegue identificar. As equipes passaram semanas após o Log4Shell apenas elaborando o inventário, e muitas falhas ainda estão sendo descobertas exposições ocultas ao Log4j, anos depois. A confusão de dependências é um caso à parte, um ataque à cadeia de suprimentos que insere um pacote malicioso em vez de encontrar um bug em um pacote legítimo, mas se aproveita exatamente do mesmo ponto cego.
A verificação de pacotes antes que eles cheguem à compilação não identificará de forma confiável uma falha que ainda não foi descoberta em uma dependência que, de resto, é legítima. O que ela consegue detectar são pacotes maliciosos e aqueles que utilizam typosquatting, além de fornecer o inventário de dependências que, de outra forma, você teria que montar no meio de um incidente. Essa é a lacuna que o SecureChain da TuxCare foi desenvolvido para preencher no âmbito do código aberto.
Exemplos notáveis de explorações de dia zero de 2021 a 2026
A lista abaixo abrange desde um servidor de e-mail até uma biblioteca de registro, passando por uma ferramenta de transferência gerenciada de arquivos, uma plataforma de colaboração e o próprio kernel. As vulnerabilidades de dia zero não se limitam a uma única camada da pilha.
| Ano | Vulnerabilidade / CVE | Meta | Por que isso foi considerado um “zero-day” |
| 2021 | ProxyLogon / CVE-2021-26855 | Microsoft Exchange local | A exploração em massa começou antes do lançamento do patch fora da versão oficial |
| 2021 | Log4Shell / CVE-2021-44228 | Apache Log4j 2 | A exploração foi observada dias antes da divulgação pública e da correção |
| 2023 | MOVEit / CVE-2023-34362 | Progress MOVEit Transfer | O Cl0p extraiu dados antes mesmo de o alerta ter sido divulgado |
| 2025 | ToolShell / CVE-2025-53770 | SharePoint Server local | Vulnerabilidade CVSS 9,8 (RCE) vem sendo explorada desde 18 de julho, antes do lançamento da correção de emergência |
| 2026 | Dirty Frag / CVE-2026-43284, CVE-2026-43500 | Kernel do Linux (ESP, rxrpc) | A vulnerabilidade foi divulgada publicamente antes que qualquer distribuidora lançasse uma correção |
Duas delas têm uma história por trás mais complicada. A pesquisa por trás do ToolShell começou como uma demonstração no Pwn2Own Berlin, em maio de 2025, combinando as vulnerabilidades CVE-2025-49704 e CVE-2025-49706, e a Microsoft corrigiu ambas naquele mês de julho. A vulnerabilidade na tabela não é essa.
A vulnerabilidade CVE-2025-53770 representa uma forma de contornar a correção lançada em julho e já estava sendo explorada quando a Microsoft lhe atribuiu o número de referência. O caso “Dirty Frag” estava sob um acordo de divulgação coordenada até que alguém violou o embargo e forçou a publicação antecipada. Em nenhum dos dois casos foi necessária uma origem de pesquisa maliciosa. O que importava era que a exploração era possível antes que os defensores tivessem uma correção completa.
Por que as explorações de dia zero são tão perigosas
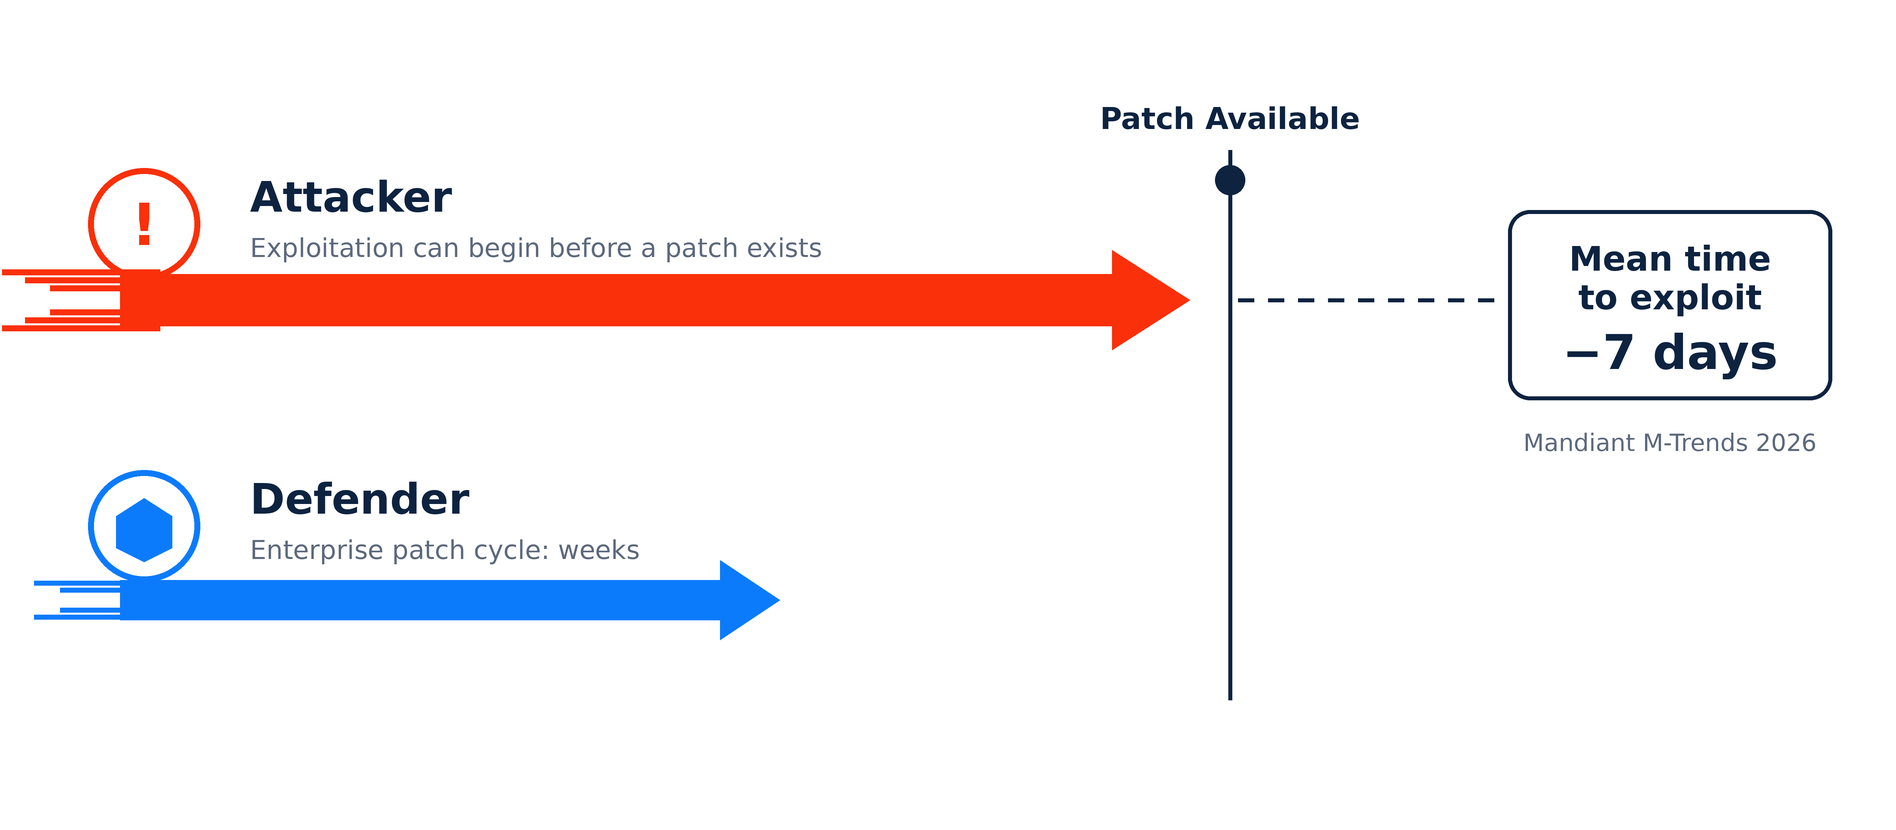
Uma vulnerabilidade de dia zero é perigosa não tanto por ser desconhecida, mas devido à disparidade de velocidade. Os invasores podem agir em questão de horas. A correção por parte das empresas, limitada por testes, controle de mudanças e janelas de manutenção, geralmente leva dias ou semanas. O relatório M-Trends 2026 da Mandiant estima o tempo médio para explorar uma nova vulnerabilidade em menos sete dias, o que significa que a exploração agora geralmente começa antes mesmo que exista um patch. A própria linha de tendência da Mandiant apresentava esse mesmo número em 63 dias entre 2018 e 2019.
1. Não há patch disponível quando você precisa dele
A maioria processos de gerenciamento de vulnerabilidades partem do princípio de que há uma correção do fornecedor disponível. Durante o período que antecede a disponibilização de uma correção para uma vulnerabilidade de dia zero, você recorre a controles compensatórios: desativar um recurso, restringir a exposição à rede, alterar a configuração ou, no Linux, colocar um módulo do kernel na lista de bloqueio e tornar os perfis seccomp mais restritivos. Essas medidas reduzem a exposição, mas algumas delas também limitam funcionalidades legítimas; por isso, precisam ser testadas antes de serem implementadas em toda a frota. Para o Dirty Frag, a solução alternativa do CERT/CC consistiu em colocar esp4, esp6 e rxrpc na lista de bloqueio, descarregá-los e esvaziar o cache de páginas. Isso também prejudica o funcionamento do IPsec e do AFS, portanto, nunca foi uma solução totalmente livre de restrições.
Imagine uma equipe que administra uma plataforma Kubernetes com 300 nós recebendo esse aviso no meio da semana, com um exploit público já anexado. Colocar os módulos na lista de bloqueio significa, primeiro, comprovar que nada na frota precisa do IPsec, e essa comprovação leva mais tempo do que um invasor precisa para atacar um host ao qual já tenha acesso.
2. A detecção baseada em assinaturas parte em desvantagem
Tanto os antivírus baseados em assinaturas quanto a verificação baseada em CVE dependem de elementos que já foram identificados e catalogados por alguém. Um vírus “zero-day” totalmente novo ainda não possui uma assinatura específica de CVE nem uma verificação de scanner associada a ele.
A detecção comportamental cobre parte dessa lacuna e está muito melhor do que há cinco anos. Ela também apresenta ruído, e as falhas do kernel de 2026 mostraram onde estão os limites. O “Copy Fail” afetou apenas o cache de páginas na memória; assim, o arquivo no disco permaneceu idêntico em termos de bytes, e o monitoramento de integridade do arquivo não registrou nada. Uma reinicialização recarregou a página limpa e eliminou esse artefato específico.
O problema com o scanner vem somar-se a tudo isso. As equipes estão sobrecarregadas com falsos positivos de backports identificados incorretamente deixam de analisar minuciosamente os resultados da varredura — e é exatamente nesse momento que uma falha real acaba sendo descartada como ruído.
3. Sistemas em fim de vida útil podem deixar vulnerabilidades “zero-day” sem correção por tempo indeterminado
Em um sistema com suporte, um “zero-day” é um período que geralmente se encerra assim que uma correção ou uma solução viável é disponibilizada. Em um versão em fim de vida , não há mais nada vindo do desenvolvedor original para essa versão, portanto a janela permanece aberta até que você encontre outra maneira de fechá-la.
Isso se transforma em uma dívida de segurança , em vez de um incidente isolado. Cada falha recém-divulgada que afeta essa versão, seja ela de dia zero ou não, acrescenta mais um item sem correção, e esses itens se acumulam.
As equipes continuam utilizando sistemas operacionais em fim de vida útil (EOL) por motivos concretos: pilhas de aplicativos certificadas, restrições de hardware e ciclos de validação medidos em trimestres. O Suporte de Ciclo de Vida Ilimitado da TuxCare foi criado para essa situação, fornecendo patches de segurança para sistemas e softwares em fim de vida (EOL) cobertos, enquanto a migração ocorre de acordo com um cronograma definido pela própria empresa. Trata-se de um problema diferente de uma vulnerabilidade “zero-day”, em que uma correção é esperada, mas ainda não foi lançada. Em um parque de equipamentos envelhecido, os dois fatores se agravam mutuamente.
Como se proteger contra explorações de dia zero
Não é possível realizar uma verificação CVE para algo que ainda não foi identificado, portanto, não baseie todo o plano nisso. Dois objetivos têm maior peso nessa questão: reduzir o tempo entre a disponibilidade de uma correção e sua implementação, e limitar o alcance de uma exploração uma vez que ela ocorra. A detecção, a resposta a incidentes e o controle de acesso continuam sendo importantes, mas é nessas duas áreas que a maioria das equipes tem maior margem de manobra.
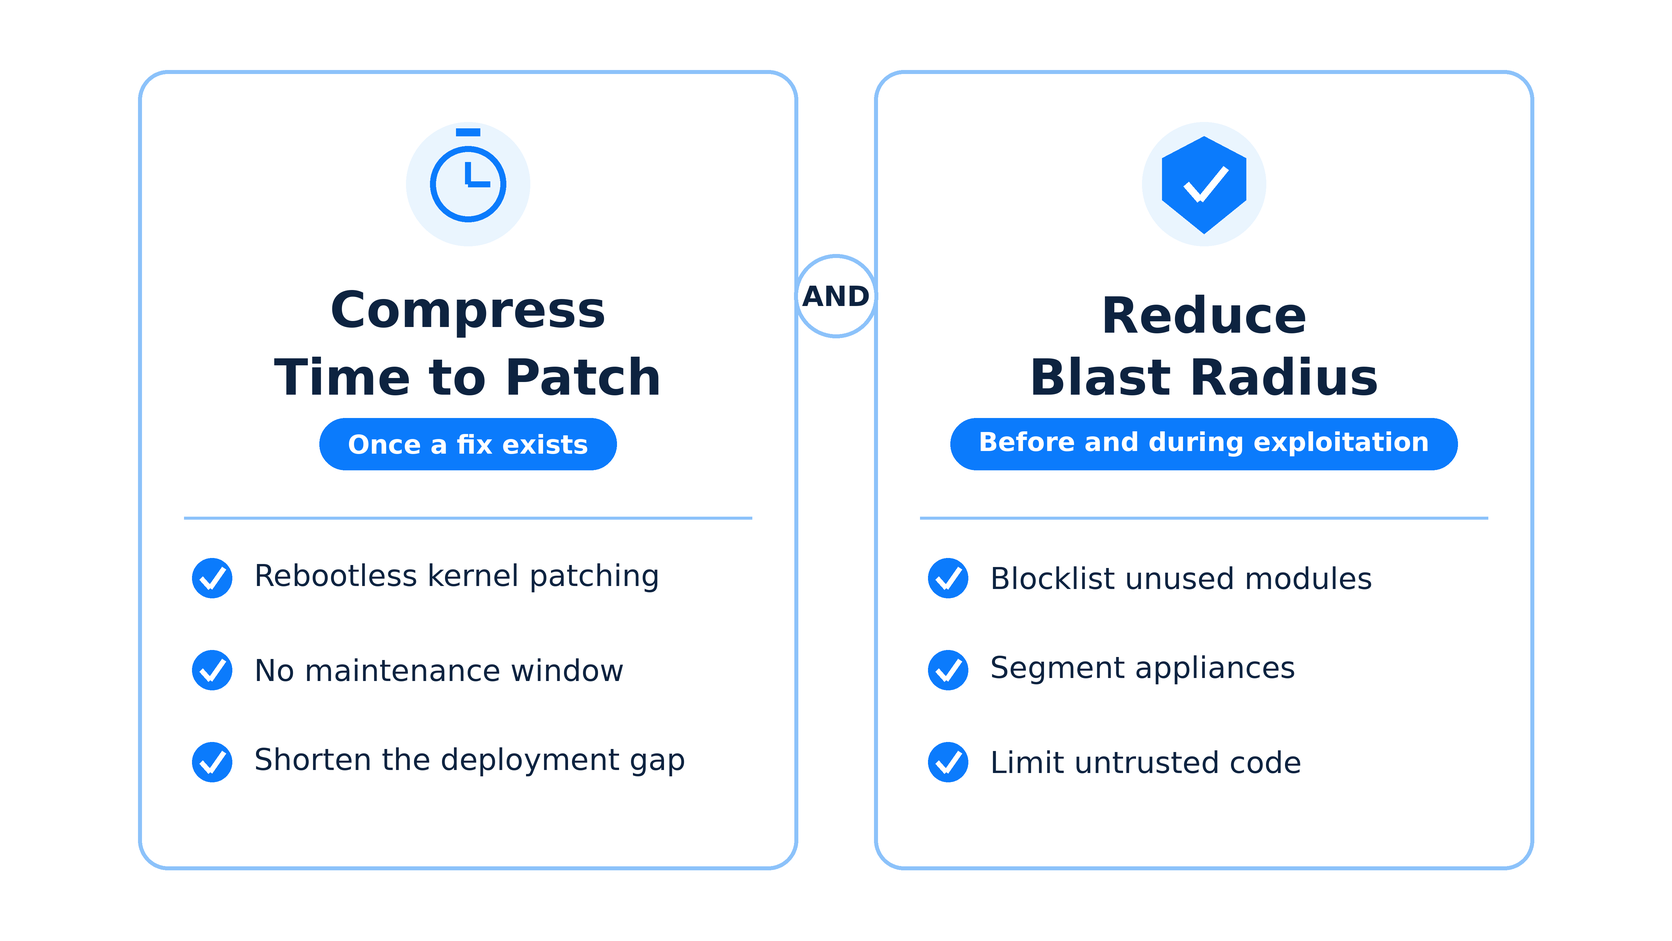
Reduzir o tempo necessário para aplicar a correção assim que ela estiver disponível
Você não controla quando o fornecedor faz o envio. O que você controla é a janela de implantação posterior e, para muitas organizações, é nessa janela — e não na correção em si — que as semanas se esgotam.
Aplicação de patches sem reinicialização elimina a restrição na camada do kernel. Se sua frota puder suportar reinicializações no decorrer de um dia, a aplicação de patches convencional pode ser perfeitamente adequada. Se uma reinicialização do kernel significar uma janela de alteração de três semanas, a aplicação de patches sem reinicialização pode reduzir drasticamente esse intervalo de implantação sem que você tenha que aceitar três semanas de exposição nesse meio tempo.
Reduza o raio de explosão antes que seja necessário
Decisões de mitigação tomadas sob pressão são más decisões. Tome-as com antecedência.
Isso significa colocar na lista de bloqueio módulos do kernel que nada em sua frota utiliza, de modo que o caminho seja fechado antes mesmo de ser divulgado. Significa aplicar perfis seccomp em cargas de trabalho não confiáveis, executores de CI e nós multilocatários. O perfil padrão do Docker nega o comando “unshare”, o que bloqueia a configuração do namespace de usuário e de rede necessária para a exploração publicada do xfrm/ESP Dirty Frag, e testes no EKS, GKE e Talos revelaram que o RuntimeDefault é suficiente para bloquear essa rota em um kernel que, de outra forma, seria vulnerável. Os mesmos testes constataram que o seccomp desativado não é equivalente ao RuntimeDefault no EKS ou no GKE, e pods rodando sem perfil foram explorados até a raiz do contêiner; portanto, isso só ajuda quando o RuntimeDefault é efetivamente aplicado, e não apenas presumido. Vale saber que o mesmo controle não surtiu efeito no caso do Copy Fail, em que o AF_ALG permaneceu acessível mesmo sob a segurança de pod Restrita. E isso significa manter códigos não confiáveis longe de hosts que armazenam credenciais de produção e, em seguida, segmentar os dispositivos para que um concentrador de VPN comprometido não consiga acessar a camada de banco de dados.
Tanto o “Copy Fail” quanto o “Dirty Frag” exigem a execução de código local. Em qualquer lugar onde um invasor consiga obter isso — CI compartilhada, farms de compilação de contêineres, Kubernetes multilocatário ou qualquer host acessível após a obtenção de um ponto de apoio inicial — é onde se concentra o risco.
Saiba o que você realmente executa e o que está realmente atualizado
A velocidade de resposta depende da precisão do inventário. Uma equipe que tenha uma visão em tempo real de quais hosts executam kernels afetados consegue aplicar as correções nesses hosts mais rapidamente, o que é fundamental quando a vulnerabilidade já se tornou pública. Uma equipe que não tenha essa visão passa o tempo durante o incidente elaborando uma planilha.
Há dois aspectos importantes aqui. Primeiro, um inventário preciso dos ativos e das versões, incluindo contêineres e dispositivos. Segundo, a verificação de patches que reflita o sistema em execução, em vez dos metadados dos pacotes — e é nesse ponto que os scanners que inferem o status a partir de sequências de versão tendem a interpretar erroneamente as correções retroativas e aquelas que não exigem reinicialização.
Realize o exercício de simulação de exposição antes que seja necessário. Use uma terça-feira normal e um CVE fictício para verificar quanto tempo leva para identificar quais hosts foram afetados e se os problemas já foram corrigidos. As lacunas no inventário costumam ser as primeiras a aparecer.
As melhores ferramentas para proteção contra explorações de dia zero
Nenhuma dessas soluções pode garantir a identificação de uma falha desconhecida antes que a exploração comece. O que elas fazem é reduzir o tempo disponível após a exploração e permitir que você comprove em que estado você realmente se encontra.
1. TuxCare
O TuxCare aborda três aspectos diferentes do problema dos vulnerabilidades de dia zero, e isso é uma escolha deliberada, e não resultado de uma proliferação de produtos, pois as invasões não respeitam os limites entre o kernel, o espaço do usuário e o software de origem já abandonado.
KernelCare aplica patches no kernel do Linux em execução, sem necessidade de reinicialização e sem janela de manutenção, em uma ampla gama das principais distribuições corporativas, o que é importante em ambientes com múltiplas plataformas, onde o uso de ferramentas específicas para cada sistema operacional implica contratos separados e lacunas distintas. O LibCare estende essa mesma abordagem a bibliotecas do espaço do usuário, como glibc e OpenSSL. Suporte de ciclo de vida ilimitado fornece patches de segurança para sistemas operacionais, ambientes de execução, bibliotecas e frameworks em fim de vida (EOL) cobertos por meio do gerenciamento padrão de pacotes, muito tempo depois que o desenvolvimento original é encerrado.
2. Catálogo de vulnerabilidades exploradas conhecidas da CISA
Gratuito, confiável e a maneira mais rápida de distinguir o que é “teoricamente explorável” do que “já está sendo usado contra as pessoas neste momento”. O Catálogo KEV lista CVEs com exploração confirmada em ambiente real, e as agências do Poder Executivo Civil Federal recebem prazos vinculativos para correção para cada entrada.
Use-o como um filtro de triagem. Um CVE que chega ao KEV passa para o início da fila, independentemente de sua pontuação CVSS. O problema é o tempo, pois o KEV é um indicador defasado e uma vulnerabilidade de dia zero já está sendo explorada muito antes de aparecer lá. O “Copy Fail” foi adicionado em 1º de maio, dois dias após a divulgação, e a exploração pública já estava disponível há esses mesmos dois dias. Ele continua sendo um dos sinais públicos mais fortes para priorizar explorações confirmadas.
3. EDR comportamental e detecção em tempo de execução
Ferramentas de endpoint e de tempo de execução que monitoram o comportamento, em vez de assinaturas, podem detectar explorações mesmo sem uma detecção específica para vulnerabilidades, e esse é justamente o objetivo delas. Ferramentas de tempo de execução como o Falco, ou sua própria eBPF , podem sinalizar os padrões de chamadas de sistema dos quais as explorações se valem, como as sequências de “empréstimo de página” baseadas em splice que o código publicado do Dirty Frag utilizou para alcançar sua primitiva de gravação no cache de páginas.
Duas ressalvas. Detecção não é sinônimo de prevenção; portanto, um alerta ainda precisa de alguém acordado para agir a respeito. Além disso, muitos aparelhos e dispositivos de rede simplesmente não conseguem executar um agente, o que explica em parte por que o GTIG registrou 14 vulnerabilidades zero-day em dispositivos de borda em 2025 e observou que esse número provavelmente subestima a verdadeira magnitude do problema.
Proteja seus sistemas contra explorações de dia zero com a TuxCare
As vulnerabilidades de dia zero não vão desaparecer. A possibilidade de que a exploração comece antes que uma correção esteja disponível é uma característica permanente do uso de software, e isso voltará a acontecer sem aviso prévio.
O que você pode controlar é por quanto tempo a janela permanece aberta. A aplicação de patches no kernel sem reinicialização elimina a necessidade de uma janela de manutenção. O suporte estendido restaura um caminho de aplicação de patches para sistemas em fim de vida útil (EOL) cobertos pelo suporte. A verificação precisa dos patches indica quais hosts estão realmente corrigidos, em vez de apenas parecerem estar.
Se você opera o Linux em grande escala e a aplicação de patches no kernel ainda depende de um cronograma de reinicialização, resolva essa lacuna primeiro. O KernelCare foi desenvolvido exatamente para isso.
Perguntas frequentes
A vulnerabilidade é a falha subjacente. A exploração é o código ou a técnica que utiliza essa falha para produzir um efeito indesejado. Uma falha continua sendo uma falha, independentemente de alguém ter criado uma exploração para ela. A exploração é o que permite que um invasor realmente a utilize contra um sistema em execução.
Não existe um cronograma único. Algumas vulnerabilidades de dia zero são exploradas discretamente por meses, e o código nunca chega a ser divulgado. Outras ganham um código de prova de conceito poucas horas ou dias após a divulgação. O Dirty Frag foi do tipo rápido, com um exploit funcional publicado em 7 de maio de 2026, antes mesmo que as distribuições lançassem kernels corrigidos.
Às vezes, embora não seja por reconhecer a própria vulnerabilidade. Os antivírus baseados em assinaturas comparam arquivos e cargas úteis com indicadores maliciosos conhecidos; assim, podem detectar uma carga útil já conhecida que seja entregue por meio de uma falha totalmente nova, mesmo sem saber nada sobre essa falha. As ferramentas comportamentais e de tempo de execução são mais eficazes na detecção de novas atividades de exploração, e a maioria delas emite um alerta em vez de bloquear, a menos que você as configure para isso.
Um ataque de dia zero utiliza uma falha de dia zero contra um alvo real; por definição, isso ocorre antes que uma correção esteja disponível ao público e, muitas vezes, antes que a vulnerabilidade seja amplamente conhecida.
Sim. A GTIG constatou que os sistemas operacionais representaram 44% das vulnerabilidades de dia zero rastreadas por ela em 2025, constituindo a maior categoria de produto isolada; e, em agosto de 2026, o catálogo KEV da CISA contava com 31 entradas relacionadas ao kernel do Linux.
Do ponto de vista do fornecedor original, elas podem permanecer sem correções por tempo indeterminado, pois as correções de segurança do desenvolvedor original geralmente são interrompidas assim que uma versão atinge o fim do ciclo de vida (EOL). O suporte estendido de terceiros é uma forma de continuar recebendo correções de segurança após o término do suporte oficial.