
 Soporte técnico
 Documentación
 Inicio de sesión
 Contáctenos



Ir directamente al resumen generado por IA de esta entrada del blog 


Principales conclusiones
- NIST SP 800-40, revisión 4 considera la aplicación de parches como un mantenimiento preventivo, un coste habitual de la actividad empresarial.
- En las flotas de Linux que permanecen siempre en funcionamiento, los reinicios de Windows pueden retrasar la aplicación de los parches mucho tiempo después de que la solución esté lista.
- La resolución BOD 26-04 de la CISA sustituyó los plazos fijos de la KEV por niveles basados en la exposición, la situación de la KEV, el grado de automatización y el impacto.
- Los sistemas que han llegado al final de su ciclo de vida siguen necesitando parches, y el soporte ampliado los cubre hasta que realices la migración según tu calendario.
El parche lleva listo dos semanas. Todo el mundo está de acuerdo en que hay que implementarlo. Pero la comisión de cambios no se reunirá de nuevo hasta el jueves, la única ventana de mantenimiento autorizada es el tercer sábado, y el clúster que realmente necesita la corrección es precisamente el que no puede quedar fuera de servicio.
Este artículo analiza el ciclo de vida de los parches que establece el NIST para la gestión de parches en las empresas, las diferencias entre los parches estándar y los de emergencia, en qué aspectos falla el enfoque tradicional y qué herramientas reducen realmente el tiempo medio de aplicación de parches (MTTP).
¿Qué es la gestión de parches en la empresa?
La gestión de parches en la empresa es el proceso de identificar, priorizar, obtener, instalar y verificar parches, actualizaciones y mejoras en todos los sistemas que utiliza una organización. Esa definición procede de la norma NIST SP 800-40, revisión 4, que enmarca la aplicación de parches como un mantenimiento preventivo y un coste habitual de la actividad empresarial, en lugar de una tarea de seguridad a la que se recurre cuando el ritmo de trabajo se ralentiza.
La palabra «empresa» cobra todo su sentido en este contexto. Aplicar un parche a un ordenador portátil es una tarea. Aplicar parches a 8.000 sistemas mixtos de Linux y Windows repartidos en cuatro centros de datos, tres nubes y una planta de producción es un problema de planificación, y por eso la guía del NIST se centra en la planificación en lugar de en las herramientas. Su título completo comienza, literalmente, con «Guía para la planificación de la gestión de parches en la empresa».
También resulta útil diferenciar la gestión de parches de algunas prácticas que la gente suele agrupar con ella:
| Práctica | Pregunta a la que responde | Salida |
| Gestión de parches | ¿Está instalada la corrección y sigue instalada? | Parches implementados y verificados |
| Gestión de vulnerabilidades | ¿Qué es lo que se ha revelado, hasta qué punto y qué hacemos al respecto? | Decisiones sobre riesgos, cola de medidas correctivas |
| Gestión de la configuración | ¿Se encuentra el sistema en su estado aprobado? | Líneas de referencia obligatorias, alertas de desviación |
| Gestión de dispositivos finales | ¿Qué hay en el dispositivo y quién lo controla? | Inventario, políticas y suministro de software |
Hay otras tres palabras que se utilizan indistintamente, y conviene diferenciarlas bien. Un «parche» corrige un problema en un software que ya está instalado; una «actualización» lo lleva a una versión más reciente; y una «actualización mayor» suele suponer un salto más importante a una nueva versión. La diferencia es importante a la hora de decidir si una corrección requiere una prueba rápida, un periodo de mantenimiento o un plan de migración completo.
Etapas clave del ciclo de vida de la gestión de parches en la empresa
El NIST divide el ciclo de vida de los parches en tres fases generales: conocer la vulnerabilidad, planificar la respuesta y, a continuación, ejecutar dicha respuesta mediante la preparación, la implementación, la verificación y la supervisión de la corrección. Para un equipo de gestión de parches eficaz, esto suele traducirse en cinco etapas prácticas.
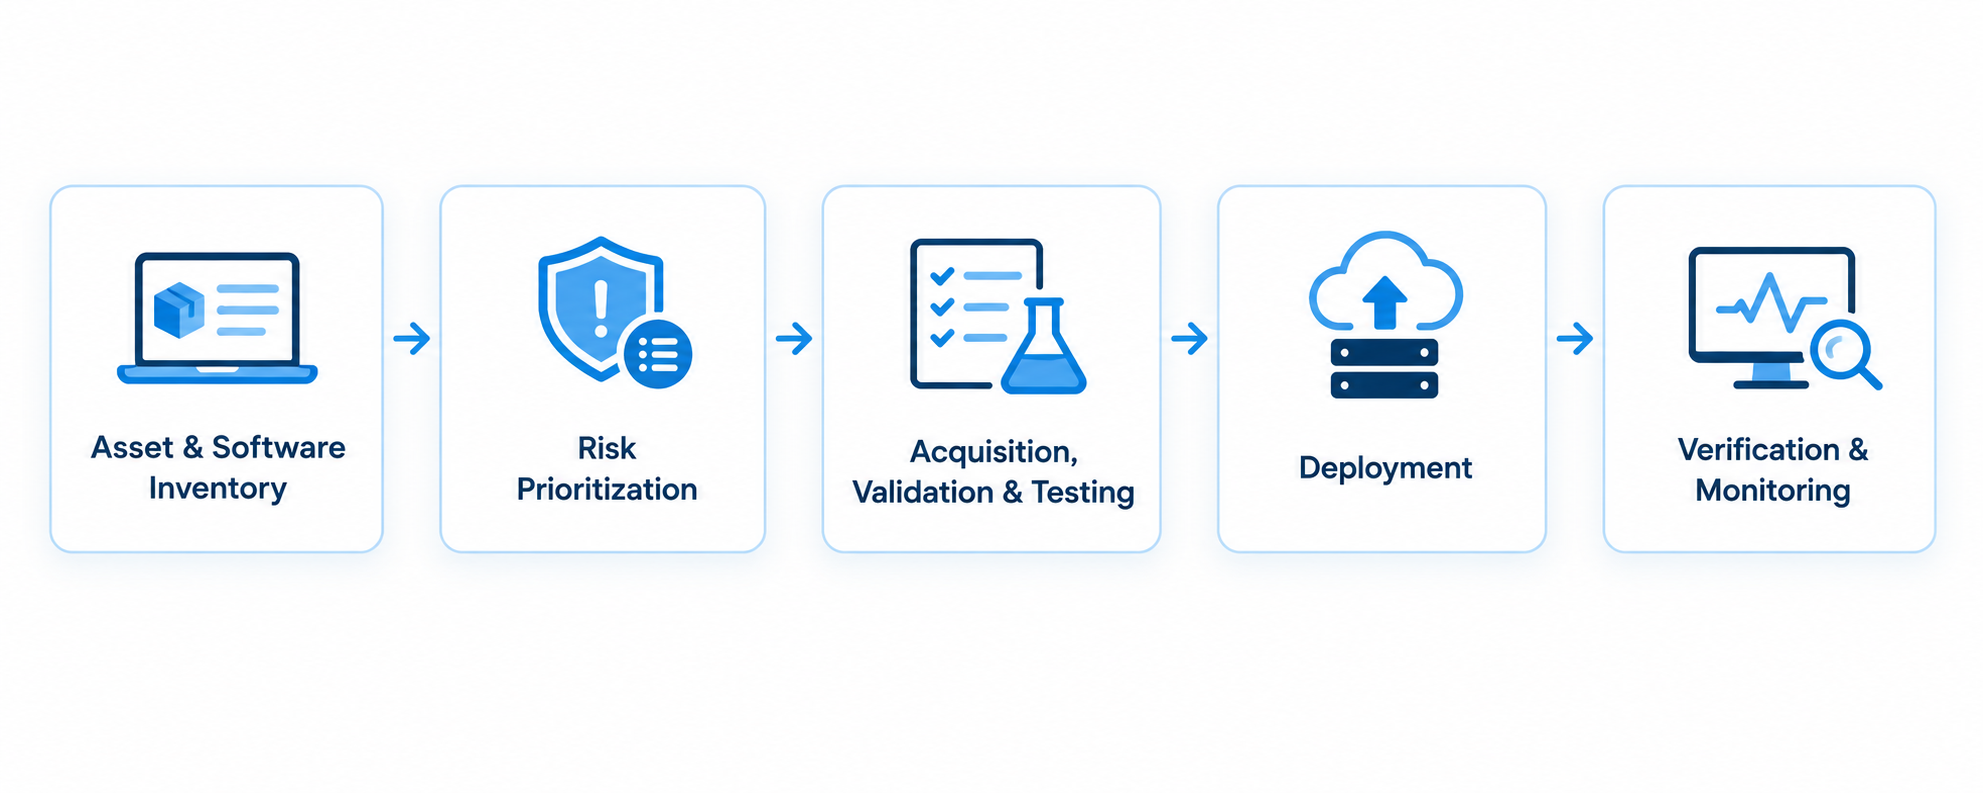
1. Inventario de activos y software
No se puede aplicar un parche a lo que no se ha detectado. El NIST recomienda realizar inventarios que lleguen hasta los paquetes y las bibliotecas que ejecuta cada activo, mucho más allá de una simple lista de nombres de host. También afirma que debería abandonarse la vieja costumbre de actualizar los inventarios mensualmente o trimestralmente mediante un análisis de vulnerabilidades, y los contenedores y los grupos de autoescalado demuestran por qué. Estos cambian con demasiada rapidez para una instantánea periódica, por lo que la detección debe automatizarse y ser prácticamente continua.
2. Priorización de riesgos
A puntuación CVSS por sí sola no indica qué hay que corregir primero. Una puntuación de 9,8 en un sistema al que nada puede acceder tiene menos importancia que una puntuación más baja que se esté explotando activamente en un sistema expuesto a Internet. El catálogo de vulnerabilidades explotadas conocidas de la CISA es una de las fuentes gratuitas más útiles para detectar vulnerabilidades que se sabe que están siendo explotadas en la red, ya que la CISA solo añade un CVE cuando tiene pruebas de que se está explotando activamente. Consúltalo antes de ordenar una cola basándote únicamente en la gravedad.
3. Adquisición, validación y pruebas
El trabajo preparatorio del NIST se resume en obtener el parche, confirmar que es auténtico y que no ha sido manipulado, probarlo y programar su instalación. La validación es el paso que resulta más fácil pasar por alto. Un parche descargado de un servidor espejo comprometido o manipulado durante la transmisión puede parecer perfectamente legítimo, por lo que las comprobaciones de firma y suma de comprobación deberían ejecutarse automáticamente antes de instalar nada.
Atención: Aplazar la instalación de parches rutinarios dificulta la aplicación de parches de emergencia más adelante. El NIST señala que los nuevos parches suelen depender de que se hayan instalado primero otros más antiguos, por lo que un sistema que lleve tres ciclos de retraso puede tener que ponerse al día antes de que se pueda aplicar siquiera una corrección urgente.
4. Implementación
Implántalo primero en un grupo reducido, luego en círculos más amplios y, por último, en todo el sistema. El NIST sugiere mantener esa fase de prueba incluso en situaciones de emergencia, aunque reduciéndola a un intervalo de entre unos minutos y unas horas. A menudo es aquí donde las cosas se ralentizan. Las correcciones del núcleo suelen requerir un reinicio, y las bibliotecas compartidas actualizadas necesitan que se reinicien los procesos que las utilizan; cualquiera de estas dos situaciones implica abrir un ticket, programar una franja horaria y que alguien lo coordine.
5. Verificación y seguimiento
Verificar significa comprobar que el parche se ha instalado realmente y que ha surtido efecto. Supervisar significa comprobar que sigue ahí el mes que viene, ya que reconstruir a partir de una imagen obsoleta o revertir a una instantánea antigua puede hacer que la vulnerabilidad reaparezca sin que nos demos cuenta. Se trata de dos tareas diferentes y, entre ambas, aportan gran parte de las pruebas que un auditor solicitará.
Procedimientos de aplicación de parches estándar frente a procedimientos de emergencia
Tanto el NIST como la CISA parten de la misma idea básica: no todas las vulnerabilidades requieren la misma urgencia. La guía del NIST establece cuatro escenarios de respuesta ante riesgos (aplicación rutinaria de parches, aplicación de parches de emergencia, mitigación de emergencia y activos para los que no hay parches disponibles) y recomienda que cada activo se asigne a un grupo de mantenimiento con su propio plan para cada uno de ellos.
Aplicación de parches estándar
La aplicación rutinaria de parches se lleva a cabo según un calendario establecido para cada tipo de activo, con pruebas, aprobación y un plazo fijo incorporados. El NIST recomienda agrupar los activos en función de sus necesidades reales, como el tiempo de inactividad que pueden tolerar, los controles de seguridad con los que ya cuentan y la gravedad que tendría una violación de la seguridad. Las frecuencias que se indican a continuación son ejemplos, no una norma. El NIST deja el calendario concreto totalmente en manos de la organización, y el suyo debería basarse en el nivel de exposición, las recomendaciones del proveedor y el nivel de riesgo que esté dispuesto a asumir.
| Clase de activos | Ejemplo de cadencia | Tolerancia a las interrupciones del servicio | Profundidad de ensayo |
| Servidores web y de aplicaciones conectados a Internet | Cada 7-14 días | Paradas progresivas, prácticamente nulas | Pruebas automatizadas de humo y regresión |
| Servidores de aplicaciones internos | Mensualmente | Intervalo de tiempo previsto | Regresión sobre componentes compartidos |
| Bases de datos y clústeres con estado | De mensual a trimestral | Ventana de tiempo estricta, se requiere conmutación por error | Regresión completa |
| Portátiles para usuarios finales | Semanal o mensual | Tolerante | Solo anillo piloto |
| OT y dispositivos integrados | Dependiente del proveedor, a menudo anual | Muy limitada | Certificación de proveedores |
| Sistemas EOL con soporte ampliado | Frecuencia de lanzamiento de parches por parte de los proveedores | Varía | Adaptaciones hacia versiones anteriores probadas por el proveedor |
La aplicación rutinaria de parches suele fallar de forma silenciosa en los activos que nunca encajan perfectamente en una ventana de actualización. Las actualizaciones del núcleo en los sistemas que funcionan las 24 horas del día se van posponiendo ciclo tras ciclo, hasta que omitirlas se convierte en la política no oficial. La aplicación de parches al núcleo sin reinicio elude ese problema en lugar de sortearlo, razón por la cual resulta una opción tan habitual para Red Hat Enterprise Linux y otras flotas que están siempre en funcionamiento.
Parches de emergencia
La aplicación de parches de emergencia no es un proceso diferente. Las directrices del NIST recomiendan utilizar el mismo enfoque general que para la aplicación rutinaria de parches, pero con un calendario mucho más agresivo, incluyendo el grupo «canario».
Los factores que desencadenan la activación del modo de emergencia deben establecerse por escrito en la política con antelación. Entre los más habituales se encuentran la inclusión de una vulnerabilidad en la lista KEV de la CISA, la explotación confirmada en el entorno real, un sistema conectado a Internet con un exploit que pueda automatizarse o un incidente activo. Errores del núcleo, problemas de Apachey fallos de OpenSSL son ejemplos clásicos de lo que acaba en esta vía.
Cambios introducidos en 2026: Según la BOD 22-01, las agencias civiles federales disponían, por defecto, de dos semanas para solucionar cualquier problema incluido en la lista KEV, o de seis meses si el identificador CVE se había asignado antes de 2021. Esto cambió el 10 de junio de 2026, cuando la CISA la sustituyó por la la Directiva BOD 26-04. En lugar de un plazo único y fijo, la nueva directiva tiene en cuenta cuatro factores: si el activo está expuesto públicamente, si el CVE figura en la lista KEV, si un atacante podría automatizar el exploit y cuánto control le otorga al atacante un exploit exitoso, lo que la CISA denomina «impacto técnico». Las combinaciones más arriesgadas disponen de tres días, y las combinaciones KEV de mayor riesgo también requieren una evaluación forense para comprobar si el sistema ya se ha visto comprometido. Otras combinaciones tienen un plazo de 14 o 60 días, y los casos que no cumplen ninguno de los criterios pueden esperar a la próxima actualización programada. La directiva completa enumera las 16 combinaciones.
Si aún no hay ningún parche disponible, el NIST también cuenta con un plan específico para ese caso: medidas de mitigación de emergencia, que permiten ganar tiempo hasta que se publique una solución definitiva.
En los sistemas que funcionan de forma ininterrumpida, la autorización para reiniciar es uno de los puntos en los que la aplicación de parches de emergencia puede ralentizarse, incluso después de que se haya encontrado y probado la solución. Un error del núcleo en una base de datos en clúster puede suponer desviar el tráfico de los nodos afectados, realizar una conmutación por error, reiniciar y confirmar que todo vuelve a funcionar correctamente. Esa secuencia suele requerir una autorización que va más allá de lo que cubre el proceso habitual de cambios de emergencia. Resulta útil preaprobar ventanas de reinicio de emergencia para cada grupo de sistemas. Cuando sea posible, la aplicación de parches sin reinicio elimina por completo la necesidad de reiniciar para las correcciones del núcleo y las bibliotecas.
Por qué la gestión tradicional de parches no es suficiente para las empresas
La gestión tradicional de parches partía de la base de que se podía desconectar un sistema de la red siempre que fuera necesario. Los entornos empresariales no funcionan así, y eso hace que sigan surgiendo tres problemas.
1. La ventana de mantenimiento nunca tiene suficiente espacio
Imagina una aseguradora regional que gestiona 1.200 servidores RHEL y que solo dispone de un margen de tiempo exacto de cuatro horas al mes para realizar estas tareas. Las actualizaciones del kernel, los parches de las bases de datos, el firmware y las nuevas versiones de las aplicaciones compiten por esas mismas cuatro horas, y todo lo que no se pueda realizar en ese tiempo tendrá que esperar otros 30 días. Pon tus propias cifras y la pregunta sigue siendo la misma: ¿qué se va a dejar para más adelante este mes?
El Informe DBIR de Verizon de 2026 reveló que el tiempo medio para resolver por completo las vulnerabilidades críticas aumentó a 43 días, frente a los 32 del año anterior. Verizon considera que una vulnerabilidad es crítica cuando figura en la lista KEV de la CISA, y solo el 26 % de ellas se corrigieron por completo, lo que supone un descenso respecto al 38 %. El volumen explica en parte esta situación, ya que la organización media tenía un 50 % más de vulnerabilidades que parchear que el año anterior. La capacidad explica la otra mitad. En muchos casos, el parche ya existe, y lo difícil es encontrar tiempo para probarlo, implementarlo y verificarlo.
2. Hay programas que dejan de recibir actualizaciones
Una vez que una distribución o un entorno de ejecución llega al final de su ciclo de vida, el proveedor deja de publicar parches de seguridad, aunque sigan apareciendo nuevos CVE. El NIST lo dice sin rodeos: es posible que nunca se publique un parche porque el software se encuentra al final de su ciclo de vida. Cualquiera que siga utilizando CentOS 7 sabe perfectamente en qué consiste eso, al igual que cualquiera que utilice RHEL 7 sin un contrato de soporte ampliado. El escáner sigue señalando los mismos CVE cada mes, y la columna de correcciones permanece vacía.
Las opciones habituales son migrar desde la versión antigua o pagar por un servicio de soporte ampliado que te permita seguir recibiendo parches a través de tu gestor de paquetes habitual mientras planificas la migración según tu propio calendario.
3. Los equipos establecen prioridades con información incompleta
Muchos equipos siguen ordenando su lista de tareas pendientes según la puntuación CVSS que aparece en el informe del escáner, y esa cifra no indica en absoluto si realmente se está aprovechando una vulnerabilidad, si el software ya ha llegado al final de su ciclo de vida o incluso si el código vulnerable sigue cargado en la memoria. Si se ordena únicamente en función de eso, se acaba teniendo una lista de miles de elementos clasificados según una cifra que no refleja el riesgo real.
El informe «M-Trends 2026» de Mandiant reveló que los exploits fueron el vector de infección inicial más habitual por sexto año consecutivo, siendo responsables del 32 % de las intrusiones. Mandiant también estimó que el tiempo medio hasta el exploit era de siete días negativos, lo que significa que la explotación suele producirse incluso antes de que se publique un parche. Una cola basada en un contexto más rico, como el estado de la explotación, la exposición y lo que realmente se está ejecutando, se convierte en algo sobre lo que se puede actuar.
Estos tres problemas se alimentan entre sí. Una mala gestión de la cola de prioridades hace que se trabaje primero en lo que no se debe. La reducida ventana de mantenimiento solo tiene capacidad para una fracción de esa cola ya de por sí defectuosa. Y los problemas detectados en los sistemas al final de su vida útil se quedan ahí mes tras mes, porque el proveedor no ofrece parches para solucionarlos. La lista de tareas pendientes crece y, dado que los nuevos parches suelen depender de otros anteriores, la ventana del mes siguiente cuesta más que la de este mes. Es fácil comprender cómo incluso un equipo con suficiente personal acaba teniendo tiempos de corrección que se miden en semanas.
Mejores prácticas para la gestión de parches en las empresas modernas
La mayor parte de lo que viene a continuación trata sobre cómo cambiar el orden de las tareas que ya estás realizando, y cada cambio se centra en uno de los cuellos de botella mencionados anteriormente. El primero suele implicar la incorporación de herramientas, ya que aplicar parches a un sistema en funcionamiento sin reiniciarlo no es algo que se pueda lograr únicamente con un cambio en los procesos.
1. Sacar el reinicio de la ruta crítica
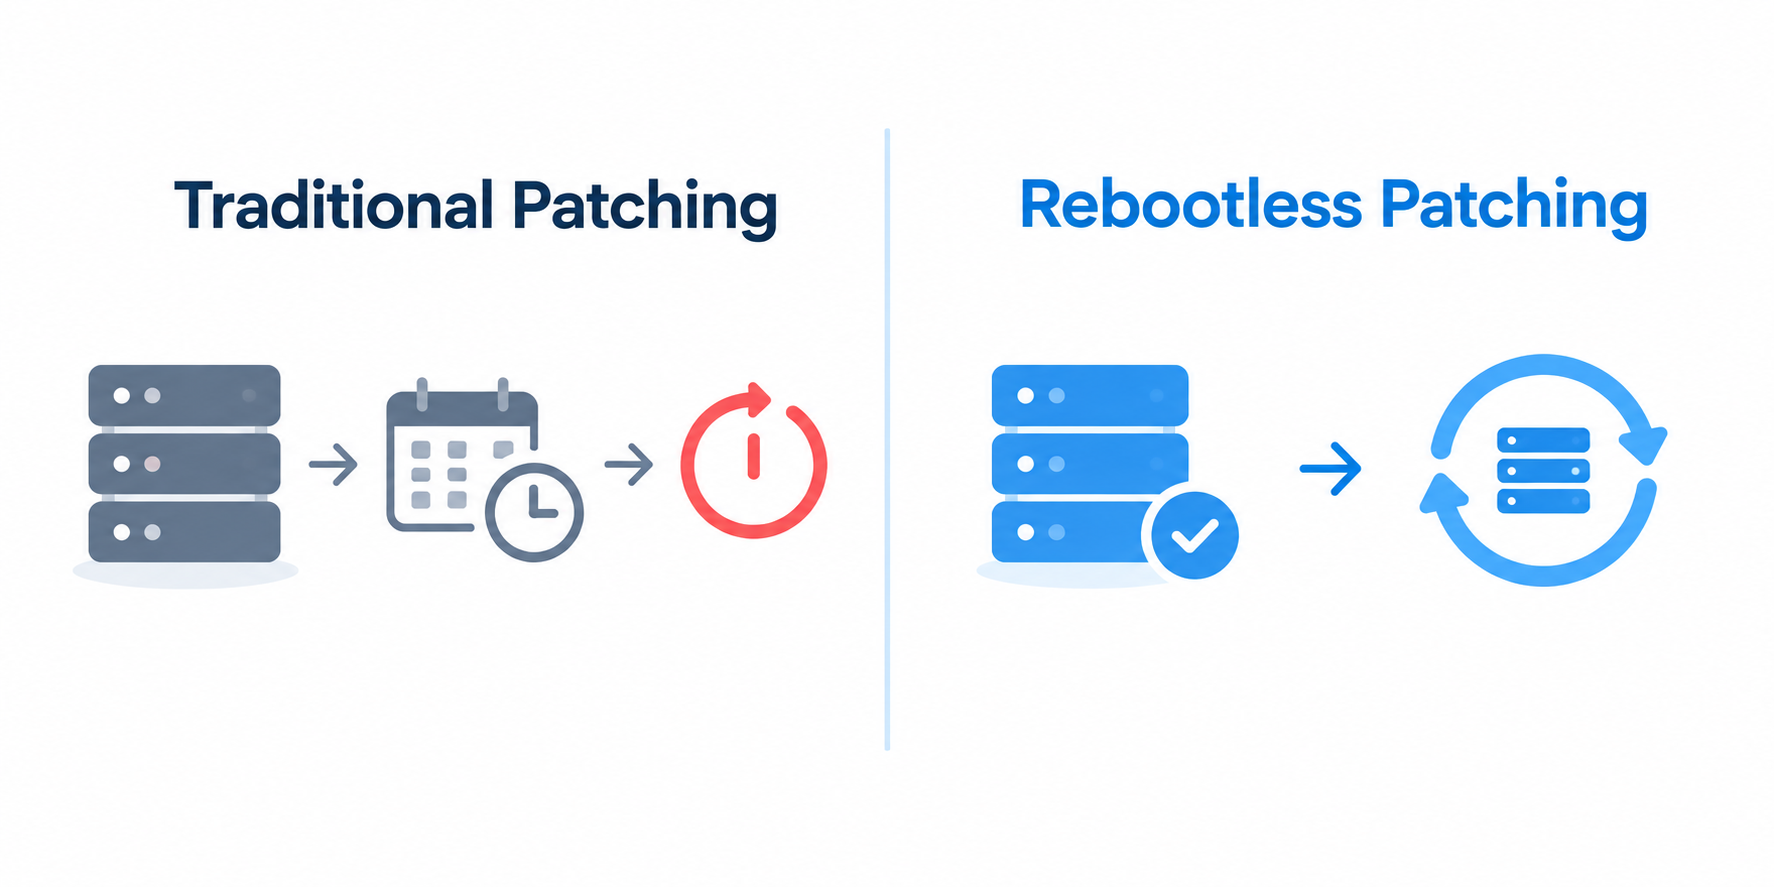
En el caso de las correcciones del núcleo y las bibliotecas, una de las medidas más importantes que se pueden tomar para acelerar la aplicación de parches es romper el vínculo entre la aplicación de la corrección y la programación del tiempo de inactividad necesario para ello. La aplicación de parches sin reinicio (también denominada «aplicación de parches en vivo») aplica el código corregido directamente al núcleo en ejecución o al código de la biblioteca afectada en memoria, de modo que la corrección puede entrar en funcionamiento en cuestión de minutos, en lugar de tener que esperar a la próxima ventana de mantenimiento del sábado.
KernelCare de TuxCare se encarga de esto para las vulnerabilidades (CVE) del núcleo en más de 70 versiones de distribuciones de Linux, y LibCare hace lo mismo con glibc y OpenSSL sin necesidad de reiniciar los servicios que dependen de ellos. Si tu entorno utiliza más de una distribución, esa amplitud es importante. Los servicios de aplicación de parches en tiempo real de los propios proveedores suelen estar vinculados a su propia distribución, por lo que un entorno mixto puede acabar teniendo que utilizar una herramienta diferente para cada una.
En la práctica: OCLC gestiona unos diez mil sistemas, en su mayoría RHEL, con un puñado de máquinas CentOS. Tras pasar a la aplicación de parches sin reinicio, OCLC informó de que había reducido de 73 a cero las interrupciones del servicio relacionadas con la aplicación de parches al año, recortando en un 72 % las horas dedicadas a la aplicación de parches CVE y reduciendo su ventana de exposición de 115 días a 12.
Antes de programar cualquier reinicio, conviene comprobar si realmente es necesario. En los sistemas de la familia RHEL, esta orden indica si las actualizaciones instaladas, como un nuevo kernel o glibc, requieren un reinicio completo:
necesita-reiniciarse -r
Debian y Ubuntu indican lo mismo con un /run/reboot-required . Hay un inconveniente: ninguna de estas comprobaciones tiene en cuenta los parches en tiempo real, por lo que un servidor al que KernelCare ya haya aplicado un parche puede seguir marcándose como susceptible de reinicio. Una vez que sabes qué es lo que realmente necesita un reinicio, es en el resto del flujo de trabajo donde la automatización da sus frutos.
2. Automatizar todo el ciclo de vida
Muchos equipos automatizan la parte en la que se aplica el parche y dejan que el inventario, la validación y la verificación se realicen de forma manual. Esto significa que la única parte automatizada del proceso suele basarse en información desactualizada procedente de las partes que no están automatizadas. La detección, la validación de la firma, la implementación de pruebas y la comprobación de que el parche se ha aplicado correctamente deben formar parte del mismo proceso.
3. Aplicar parches en la nube y en las instalaciones bajo una misma política
Aplicar dos políticas de parches diferentes para la nube y los entornos locales suele generar dos conjuntos distintos de pruebas, lo que complica las auditorías más de lo necesario. Los grupos de autoescalado suelen ser un punto ciego en este sentido. Una instancia creada a partir de una imagen de hace dos meses puede carecer de dos meses de parches de seguridad en el momento en que se inicia, por lo que se necesita tanto una imagen base actualizada como una aplicación continua de parches en tiempo de ejecución para subsanar esa deficiencia. La solución consiste en definir grupos de mantenimiento que abarquen ambos entornos y someterlos a las mismas reglas de priorización, requisitos de verificación y presentación de informes.
Soluciones de gestión de parches para empresas de TuxCare
Todo lo expuesto anteriormente sobre los cuellos de botella y las mejores prácticas apunta a la misma conclusión: los mayores beneficios se obtienen eliminando las limitaciones, no adaptando la planificación a ellas. La línea de productos de TuxCare se basa en esa idea, y cada uno de sus componentes cubre una carencia diferente de las mencionadas en las secciones anteriores.
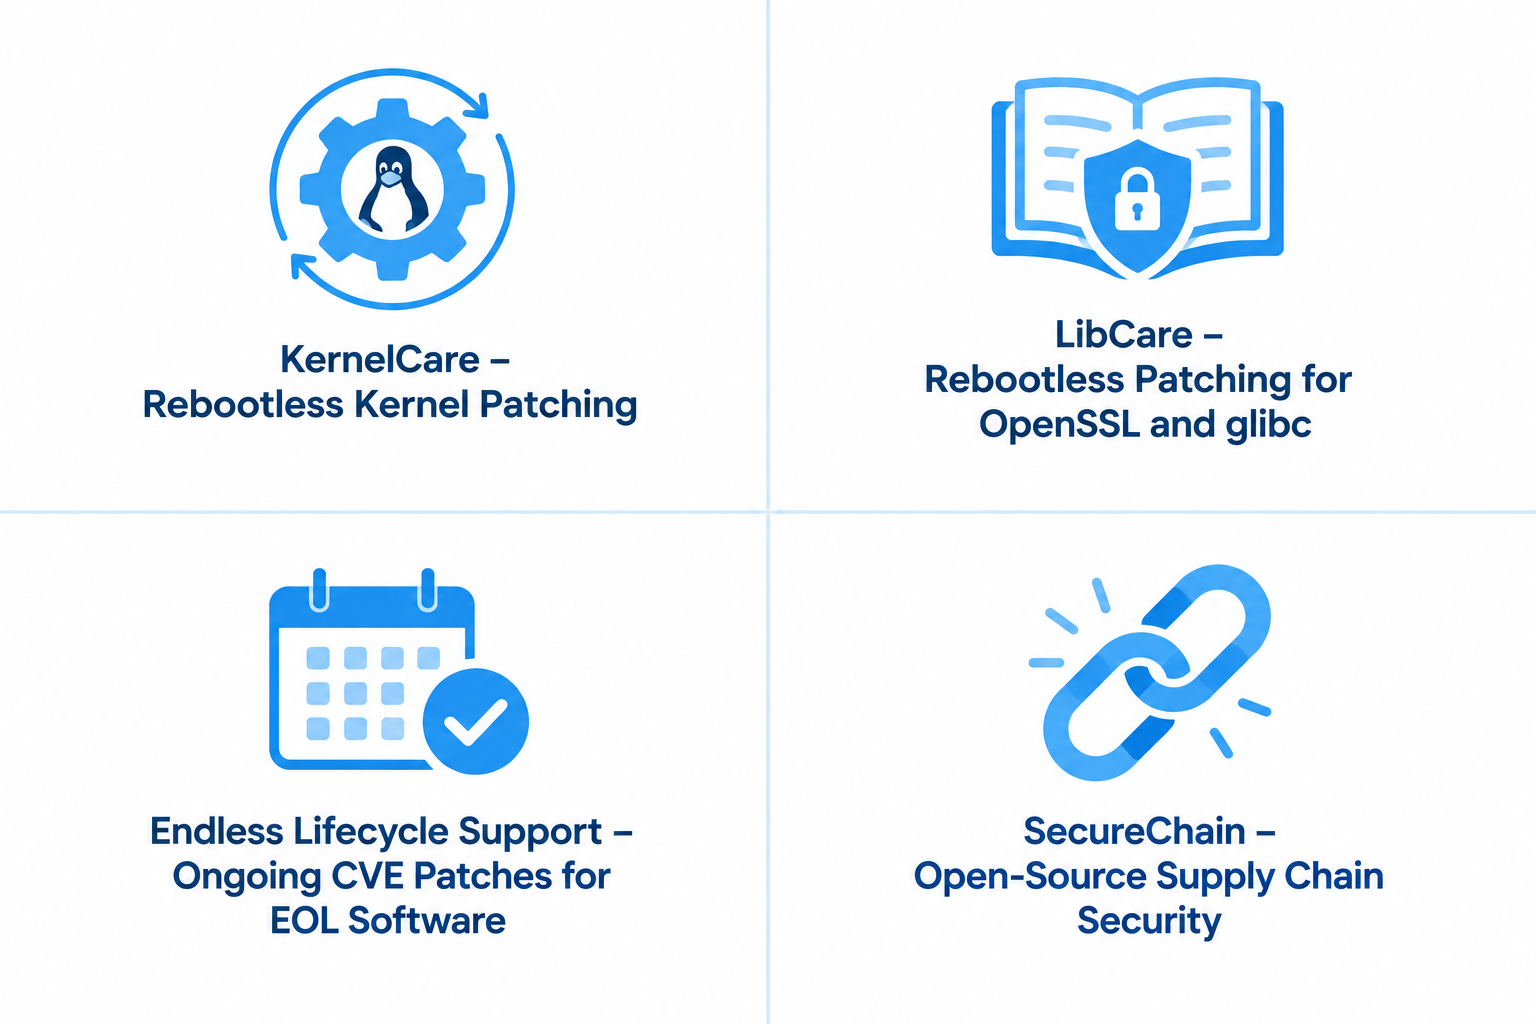
KernelCare resuelve directamente el cuello de botella de la implementación. Automatiza la aplicación de parches de seguridad del kernel en sistemas en funcionamiento sin necesidad de reiniciar, cubriendo más de 70 versiones de distribución en RHEL, CentOS, Ubuntu, Debian, Oracle Linux, Amazon Linux, CloudLinux y otras, todo ello con un único agente. Esto resulta fundamental para cargas de trabajo que funcionan las 24 horas del día, los 7 días de la semana, y para bases de datos en clúster, en cualquier entorno en el que obtener la autorización para reiniciar lleve más tiempo que aplicar el propio parche. No está diseñado para equipos Windows ni para software de terceros para Windows, por lo que la mayoría de los entornos mixtos lo combinan con una herramienta independiente para esa parte del parque informático.
LibCare amplía este mismo concepto a las bibliotecas compartidas. Aplica parches a glibc y OpenSSL dentro de los procesos en ejecución sin necesidad de reiniciar los componentes que dependen de ellos, lo que permite cubrir el mismo tipo de brecha de reinicio para el código del espacio de usuario que KernelCare cubre a nivel del núcleo.
Soporte para todo el ciclo de vida resuelve el cuello de botella de la adquisición. Una vez que una distribución o un entorno de ejecución llega al final de su vida útil, ya no hay parches del proveedor que se puedan adquirir. ELS garantiza que sigan llegando parches de seguridad para las versiones de código abierto que han llegado al final de su vida útil en toda la pila, incluidos los sistemas operativos Linux, los entornos de ejecución de lenguajes, las bibliotecas y las aplicaciones, de modo que un equipo no tenga que elegir entre un sistema sin parches y una migración apresurada.
SecureChain actúa en una fase más temprana, centrándose en las dependencias de código abierto que incorpora un código fuente, en lugar de en el sistema operativo subyacente. Sustituye los registros públicos por un repositorio seleccionado cuidadosamente en el que los paquetes se vuelven a compilar desde el código fuente, se analizan en busca de malware y se parchean según un acuerdo de nivel de servicio (SLA) a medida que surgen nuevas vulnerabilidades CVE, tanto en JavaScript como en Python, Java, Go, Rust y PHP. Se trata de un riesgo de la cadena de suministro que los parches a nivel del sistema operativo nunca abordan.
En conjunto, estos cuatro productos subsanan las deficiencias que se han analizado en este artículo. Hasta la fecha, TuxCare ha corregido más de 14 000 vulnerabilidades en software de código abierto.
Empieza por el horario
Gran parte de lo que dificulta la aplicación de parches a gran escala tiene que ver con aspectos operativos más que técnicos. La solución está lista. La ventana de mantenimiento, no. Una vez que se elimina el reinicio de la ruta crítica, se mantienen actualizados los sistemas al final de su vida útil en lugar de dejarlos desprotegidos y se establece un orden de prioridad en función de lo que realmente se está explotando, el resto del proceso resulta mucho más manejable.
TuxCare diseña cada una de sus herramientas con el objetivo de resolver un aspecto concreto de ese problema de programación, en lugar de pedirte que apliques parches más rápido con el mismo flujo de trabajo que ya tienes.
Si aún estás tratando de averiguar cuál es la mayor carencia de tu propio programa, nuestra guía sobre gestión de parches en Linux es un buen punto de partida. Si ya lo sabes y solo quieres un presupuesto adaptado a tu entorno, consulta nuestra página de precios.
Preguntas frecuentes
La norma NIST SP 800-40, revisión 4, es la guía de referencia. Abarca el ámbito de aplicación, los cuatro escenarios de respuesta ante riesgos y cómo agrupar los activos en planes de mantenimiento. Combínala con el catálogo KEV de la CISA y la BOD 26-04 para decidir qué priorizar, y con la norma NIST SP 1800-31 para obtener orientación sobre la implementación.
La gestión de vulnerabilidades abarca el panorama general: detectar qué elementos están expuestos y determinar qué medidas tomar al respecto. La gestión de parches es una forma concreta de abordar esta cuestión, consistente en aplicar una corrección y confirmar que se ha aplicado correctamente.
Depende de la combinación de factores de riesgo, no solo de la inclusión en la lista KEV. La directiva BOD 26-04 de la CISA tiene en cuenta la exposición, el estado en la lista KEV, si un atacante puede automatizar el exploit y el grado de control que este le otorga. Las combinaciones de mayor riesgo tienen un plazo de tres días; otras, de 14 o 60; y los hallazgos que no cumplan ninguno de los criterios pueden esperar a una actualización programada. La directiva solo se aplica a los organismos civiles federales, aunque la CISA lleva tiempo instando a las empresas privadas a que también den prioridad a las entradas del KEV.
Entre las opciones se incluyen la migración a una versión compatible, la sustitución del software o recurrir a un proveedor externo de soporte ampliado. TuxCare, por ejemplo, sigue proporcionando correcciones de seguridad para distribuciones, entornos de ejecución, bibliotecas y aplicaciones que han llegado al final de su ciclo de vida a través de tu gestor de paquetes habitual, de modo que el sistema permanece actualizado y dispones de pruebas de auditoría que presentar mientras planificas la migración propiamente dicha.
En el caso de los núcleos y las bibliotecas compartidas compatibles, normalmente sí. La aplicación de parches sin reinicio aplica la corrección directamente al sistema en funcionamiento, por lo que las actualizaciones compatibles del núcleo y los parches para bibliotecas como glibc u OpenSSL se aplican sin necesidad de reiniciar. Otras actualizaciones de aplicaciones, servicios y firmware pueden seguir requiriendo el reinicio de un proceso, un servicio o de todo el sistema.
Proporciona la información que suelen solicitar los evaluadores: qué hay en tu entorno, qué tiene parches y qué no, cuánto tiempo tardan en aplicarse las correcciones y un registro de todo lo que hayas pospuesto deliberadamente. El programa NIST SP 800-40r4 se ajusta bien a las categorías del Marco de Ciberseguridad y a los controles de la norma SP 800-53 (la norma NIST SP 1800-31 vincula su solución de ejemplo a ambos), de modo que las pruebas se corresponden con lo que los auditores ya están comprobando.