
 Suporte Técnico
 Documentação
 Entrar
 Entre em contato conosco



Vá direto para um resumo gerado por IA desta postagem do blog 


Principais conclusões
- NIST SP 800-40, Revisão 4 considera a aplicação de patches como manutenção preventiva, um custo padrão da atividade empresarial.
- Em parques de servidores Linux que permanecem sempre ligados, as janelas de reinicialização podem atrasar a aplicação de patches muito tempo depois que a correção já está pronta.
- A Resolução 26-04 do Conselho de Administração da CISA substituiu os prazos fixos para a KEV por níveis baseados na exposição, no status da KEV, na automação e no impacto.
- Os sistemas em fim de vida útil ainda precisam de correções, e o suporte estendido as cobre até que você faça a migração de acordo com seu cronograma.
A correção já está pronta há duas semanas. Todos concordam que ela precisa ser implementada. Mas o comitê de mudanças só se reunirá novamente na quinta-feira, a única janela de manutenção aprovada é o terceiro sábado, e o cluster que realmente precisa da correção é justamente aquele que não pode ficar fora do ar.
Este artigo aborda o ciclo de vida das atualizações definido pelo NIST para o gerenciamento de atualizações corporativas, a diferença entre atualizações padrão e de emergência, onde a abordagem tradicional apresenta falhas e quais ferramentas realmente reduzem o tempo médio para aplicação de atualizações (MTTP).
O que é o gerenciamento de patches corporativo
O gerenciamento de patches corporativo é o processo de identificar, priorizar, adquirir, instalar e verificar patches, atualizações e upgrades em todos os sistemas operacionais de uma organização. Essa definição é proveniente de NIST SP 800-40 Revisão 4, que enquadra a aplicação de patches como manutenção preventiva e um custo padrão dos negócios, em vez de uma tarefa de segurança que só se realiza quando o ritmo de trabalho diminui.
A palavra “empresa” tem um peso real nesse contexto. Aplicar uma correção em um laptop é uma tarefa. Aplicar correções em 8.000 sistemas mistos de Linux e Windows distribuídos por quatro centros de dados, três nuvens e um chão de fábrica é um problema de planejamento, e é por isso que o guia do NIST se concentra no planejamento, em vez de nas ferramentas. Seu título completo começa, literalmente, com “Guia para o Planejamento do Gerenciamento de Correções em Empresas”.
Isso também ajuda a diferenciar o gerenciamento de patches de algumas práticas que as pessoas costumam associar a ele:
| Prática | Pergunta à qual responde | Saída |
| Gerenciamento de patches | A correção já foi instalada e ainda está instalada? | Patches implantados e verificados |
| Gerenciamento de vulnerabilidades | O que está exposto, qual é a gravidade da situação e o que podemos fazer a respeito? | Decisões sobre riscos, fila de correções |
| Gerenciamento de configuração | O sistema está em seu estado aprovado? | Linhas de base obrigatórias, alertas de desvio |
| Gerenciamento de terminais | O que há no dispositivo e quem o controla? | Inventário, políticas, entrega de software |
Mais três termos são usados de forma intercambiável, e vale a pena diferenciá-los. Um patch corrige um problema em um software já instalado, uma atualização o leva para uma versão mais recente e um upgrade geralmente representa um salto maior para uma nova versão. A diferença é importante na hora de decidir se uma correção requer um teste rápido, uma janela de manutenção ou um plano completo de migração.
Principais etapas do ciclo de vida do gerenciamento de patches corporativo
O NIST divide o ciclo de vida da aplicação de patches em três fases gerais: tomar conhecimento da vulnerabilidade, planejar a resposta e, em seguida, executar essa resposta por meio da preparação, implantação, verificação e monitoramento da correção. Para uma equipe de patches em atividade, isso geralmente se traduz em cinco etapas práticas.
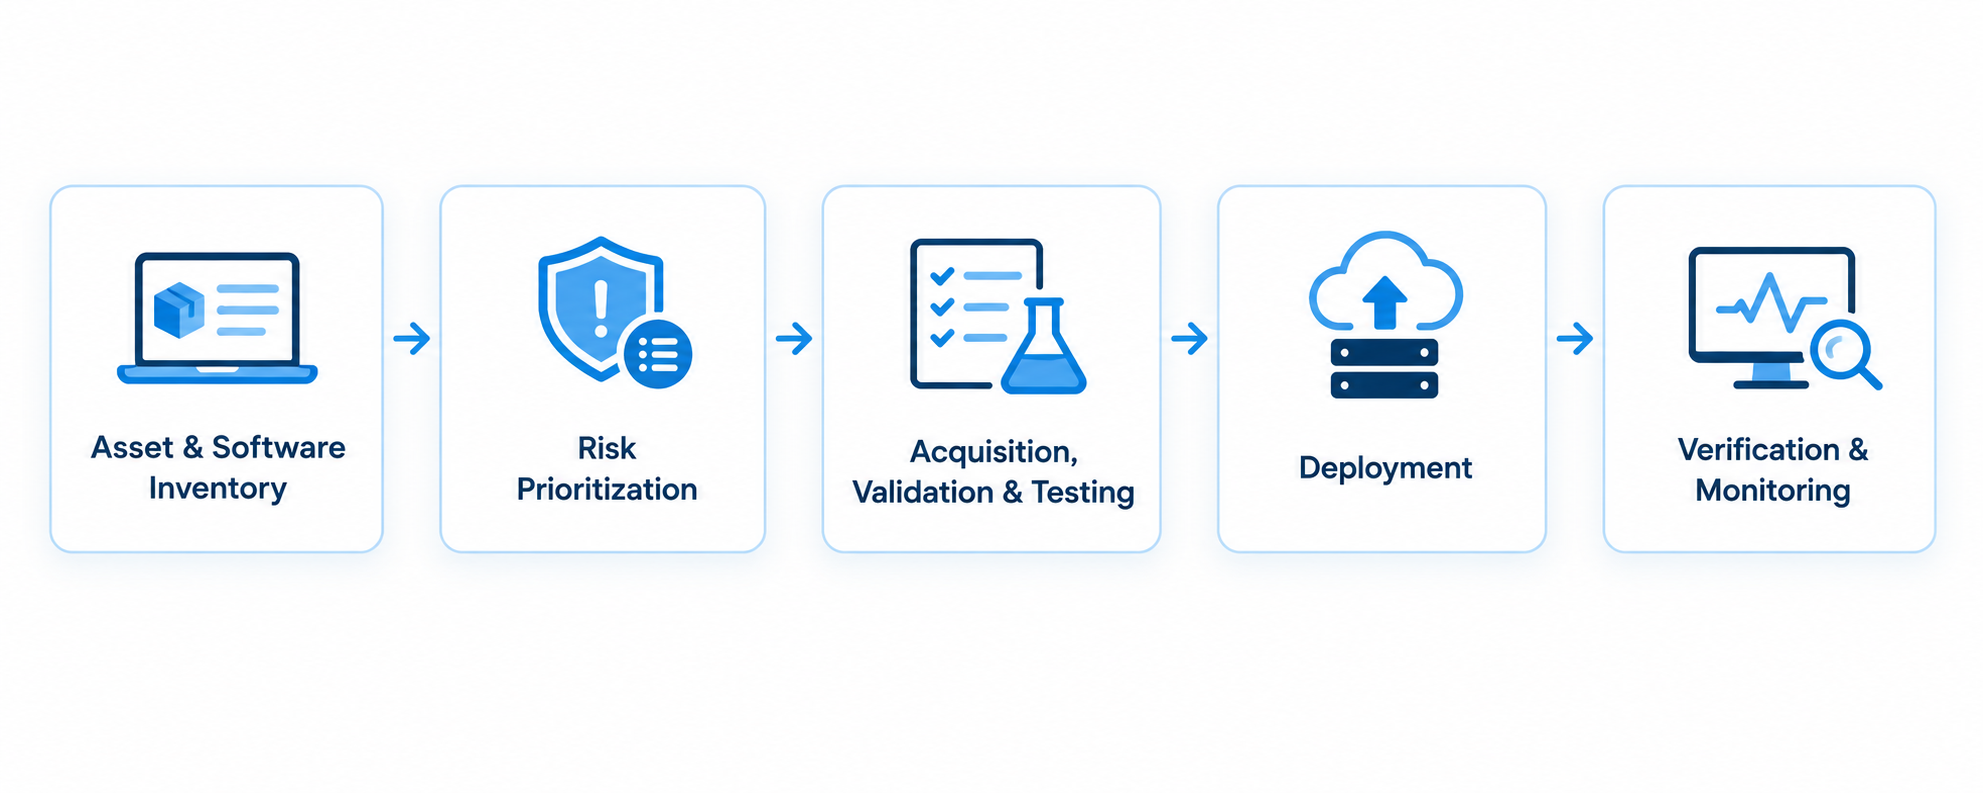
1. Inventário de ativos e softwares
Não é possível corrigir o que ainda não foi identificado. O NIST recomenda que os inventários abranjam até mesmo os pacotes e bibliotecas executados por cada ativo, indo muito além de uma simples lista de nomes de host. O órgão também afirma que o antigo hábito de atualizar os inventários mensalmente ou trimestralmente por meio de uma varredura de vulnerabilidades deve ser abandonado, e os contêineres e grupos de autoescalonamento mostram o motivo. Eles mudam com uma rapidez muito grande para que um instantâneo periódico seja suficiente; portanto, a detecção precisa ser automatizada e praticamente contínua.
2. Priorização de riscos
A pontuação CVSS por si só não indica o que deve ser corrigido primeiro. Uma pontuação de 9,8 em um sistema inacessível é menos preocupante do que uma pontuação mais baixa que esteja sendo ativamente explorada em um sistema exposto à internet. O catálogo de Vulnerabilidades Exploradas Conhecidas da CISA é uma das fontes gratuitas mais úteis para vulnerabilidades conhecidas por estarem sendo exploradas na prática, já que a CISA só adiciona um CVE quando há evidências de exploração ativa. Verifique-o antes de ordenar uma fila apenas por gravidade.
3. Aquisição, validação e testes
O trabalho preparatório do NIST resume-se a obter o patch, confirmar se ele é genuíno e não foi adulterado, testá-lo e agendar sua instalação. A validação é a etapa que é mais fácil de ignorar. Um patch baixado de um servidor espelho comprometido ou adulterado durante a transmissão pode parecer perfeitamente legítimo; portanto, as verificações de assinatura e de checksum devem ser executadas automaticamente antes que qualquer coisa seja instalada.
Atenção: Adiar a aplicação de patches de rotina torna mais difícil a aplicação de patches de emergência posteriormente. O NIST destaca que novos patches geralmente dependem da instalação prévia de patches mais antigos; portanto, um sistema que esteja três ciclos atrasado talvez precise se atualizar antes mesmo que uma correção urgente possa ser aplicada.
4. Implantação
Implemente-o primeiro em um pequeno grupo, depois em círculos mais amplos e, por fim, para todos. O NIST sugere manter essa etapa de teste, mesmo em emergências, apenas reduzindo-a para um intervalo entre alguns minutos e algumas horas. É nesse ponto que as coisas costumam ficar mais lentas. Correções no kernel tradicionalmente exigem uma reinicialização; bibliotecas compartilhadas atualizadas exigem que os processos que as utilizam sejam reiniciados; e qualquer uma dessas situações implica em um ticket, um horário agendado e alguém para coordenar o processo.
5. Verificação e monitoramento
Verificar significa conferir se o patch foi realmente instalado e entrou em vigor. Monitorar significa verificar se ele ainda estará presente no mês que vem, já que a reconstrução a partir de uma imagem desatualizada ou a reversão para um snapshot antigo podem, sem que se perceba, trazer a vulnerabilidade de volta. Essas são duas tarefas distintas e, juntas, geram grande parte das evidências que um auditor solicitará.
Procedimentos padrão versus procedimentos de correção de emergência
Tanto o NIST quanto a CISA partem da mesma ideia básica: nem toda vulnerabilidade requer a mesma urgência. O guia do NIST apresenta quatro cenários de resposta a riscos (aplicação de patches de rotina, aplicação de patches de emergência, mitigação de emergência e ativos não corrigíveis) e recomenda que cada ativo seja atribuído a um grupo de manutenção com um plano específico para cada um.
Aplicação de remendos padrão
A aplicação rotineira de patches ocorre de acordo com um cronograma definido para cada tipo de ativo, incluindo testes, aprovação e um intervalo de tempo fixo. A recomendação do NIST é agrupar os ativos de acordo com suas necessidades reais, como o tempo de inatividade que podem tolerar, quais controles de segurança já os protegem e a gravidade de uma possível violação. As frequências abaixo são exemplos, não uma norma. O NIST deixa o cronograma real inteiramente a cargo da organização, e o seu deve levar em conta a exposição, as orientações do fornecedor e o nível de risco que você está disposto a assumir.
| Classe de ativos | Exemplo de cadência | Tolerância a interrupções | Profundidade do teste |
| Servidores de aplicativos e sites conectados à Internet | A cada 7 a 14 dias | Implementação gradual, com tempo de inatividade quase nulo | Testes automatizados de fumaça e regressão |
| Servidores de aplicativos internos | Mensal | Janela programada | Regressão sobre componentes compartilhados |
| Bancos de dados e clusters com estado | Mensalmente a trimestralmente | Janela de tempo restrita, é necessário failover | Regressão completa |
| Laptops para usuários finais | Semanalmente a mensalmente | Tolerante | Apenas anel piloto |
| OT e dispositivos embarcados | Dependente do fornecedor, geralmente anual | Muito limitado | Certificação de fornecedores |
| Sistemas EOL sob suporte estendido | Frequência de lançamento de patches pelos fornecedores | Varia | Backports testados pelo fornecedor |
A aplicação rotineira de patches tende a falhar discretamente nos ativos que nunca se encaixam perfeitamente em uma janela de atualização. As atualizações do kernel em sistemas que funcionam 24 horas por dia são adiadas ciclo após ciclo, até que ignorá-las se torne a política não oficial. A aplicação de patches no kernel sem reinicialização contorna esse problema em vez de tentar contorná-lo, e é por isso que é uma solução tão comum para o Red Hat Enterprise Linux e outras infraestruturas que ficam sempre em operação.
Correções de emergência
A aplicação de patches de emergência não é um processo diferente. A orientação do NIST é utilizar a mesma abordagem geral da aplicação rotineira de patches, mas com um cronograma muito mais rigoroso, incluindo o grupo canário.
Os fatores que desencadeiam a ativação do modo de emergência devem ser definidos antecipadamente em uma política. Entre os mais comuns estão: uma vulnerabilidade incluída na lista KEV da CISA; a confirmação de exploração em ambiente real; um sistema conectado à Internet com uma exploração que possa ser automatizada; ou um incidente ativo. Bugs no kernel, problemas no Apachee falhas no OpenSSL são exemplos clássicos do que acaba entrando nessa trilha.
O que mudou em 2026: De acordo com a BOD 22-01, as agências civis federais tinham um prazo padrão de duas semanas para corrigir qualquer item da lista KEV, ou seis meses se o ID CVE tivesse sido atribuído antes de 2021. Isso mudou em 10 de junho de 2026, quando a CISA substituiu essa norma pela BOD 26-04. Em vez de um prazo único e fixo, a nova diretiva leva em consideração quatro fatores: se o ativo está exposto publicamente, se o CVE consta na lista KEV, se um invasor poderia automatizar a exploração e quanto controle uma exploração bem-sucedida concede ao invasor — o que a CISA denomina “impacto técnico”. As combinações de maior risco têm prazo de três dias, e as combinações KEV de risco mais elevado também exigem uma triagem forense para verificar se o sistema já foi comprometido. Outras combinações têm prazo de 14 ou 60 dias, e os casos que não atendem a nenhum dos critérios podem aguardar a próxima atualização programada. A diretiva completa detalha todas as 16 combinações.
Se ainda não houver um patch disponível, o NIST também tem um plano específico para essa situação: medidas de mitigação de emergência, que permitem ganhar tempo até que uma correção definitiva seja lançada.
Em sistemas que ficam sempre em operação, a aprovação da reinicialização é um ponto em que a aplicação de patches de emergência pode ficar paralisada, mesmo depois que a correção já tenha sido encontrada e testada. Um bug no kernel de um banco de dados em cluster pode significar desviar o tráfego dos nós afetados, realizar o failover, reiniciar e confirmar que tudo está funcionando corretamente novamente. Essa sequência frequentemente requer aprovação além do que o processo normal de alterações de emergência abrange. A aprovação prévia de janelas de reinicialização de emergência para cada grupo de sistemas ajuda. Nos casos em que for compatível, a aplicação de patches sem reinicialização elimina completamente a necessidade de reinicialização para correções no kernel e nas bibliotecas.
Por que o gerenciamento tradicional de patches não atende às necessidades das empresas
O gerenciamento tradicional de patches partia do princípio de que era possível colocar um sistema fora de operação sempre que necessário. Os ambientes corporativos não funcionam assim, e, por causa disso, três problemas continuam surgindo.
1. A janela de manutenção nunca tem espaço suficiente
Imagine uma seguradora regional que opera 1.200 servidores RHEL e dispõe de exatamente uma janela de quatro horas por mês para realizar essas tarefas. Atualizações do kernel, patches de banco de dados, firmware e novas versões de aplicativos disputam essas mesmas quatro horas, e o que não for realizado terá que esperar mais 30 dias. Substitua esses números pelos seus e a pergunta continua a mesma: o que será deixado de lado este mês?
O Relatório DBIR 2026 da Verizon revelou que o tempo médio para resolver totalmente vulnerabilidades críticas subiu para 43 dias, ante 32 no ano anterior. A Verizon classifica uma vulnerabilidade como crítica quando ela consta da lista KEV da CISA, e apenas 26% delas foram totalmente corrigidas, uma queda em relação aos 38% anteriores. O volume explica parte disso, já que, em média, as organizações tiveram 50% mais vulnerabilidades para corrigir do que no ano anterior. A capacidade é a outra metade. Em muitos casos, o patch já existe, e a parte difícil é encontrar tempo para testá-lo, implantá-lo e verificá-lo.
2. Alguns softwares simplesmente deixam de receber atualizações
Quando uma distribuição ou ambiente de execução chega ao fim da vida útil, as correções de segurança do fornecedor são interrompidas, mesmo que novos CVEs continuem surgindo. O NIST é bem direto: um patch pode nunca ser lançado porque o software está no fim da vida útil. Qualquer pessoa que ainda esteja executando o CentOS 7 sabe exatamente como isso funciona, assim como quem usa o RHEL 7 sem um contrato de suporte estendido. O scanner continua sinalizando os mesmos CVEs todos os meses, e a coluna de correções simplesmente permanece vazia.
As opções habituais são migrar da versão antiga ou pagar por um suporte estendido, que garante que os patches continuem sendo fornecidos por meio do seu gerenciador de pacotes normal enquanto você planeja a migração de acordo com seu próprio cronograma.
3. As equipes estão estabelecendo prioridades com informações incompletas
Muitas equipes ainda organizam sua fila com base na pontuação CVSS de um relatório de varredura — e esse número não indica se algo está realmente sendo explorado, se o software já chegou ao fim de sua vida útil ou mesmo se o código vulnerável ainda está carregado na memória. Se você organizar a fila apenas com base nisso, acabará com uma fila de milhares de itens classificados por um número que não reflete o risco real.
O relatório M-Trends 2026 da Mandiant constatou que as explorações foram o vetor de infecção inicial mais comum pelo sexto ano consecutivo, sendo responsáveis por 32% das invasões. A Mandiant também estimou o tempo médio até a exploração em sete dias negativos, o que significa que a exploração ocorre rotineiramente antes mesmo do lançamento de um patch. Uma fila baseada em um contexto mais rico, como o status da exploração, a exposição e o que realmente está em execução, transforma-se em algo sobre o qual você pode agir.
Esses três problemas se alimentam mutuamente. Uma fila de priorização mal definida faz com que as tarefas erradas sejam realizadas primeiro. A curta janela de manutenção só tem espaço para uma fração dessa fila já falha. E as falhas identificadas em sistemas em fim de vida ficam paradas mês após mês, porque não há nada do fornecedor para corrigi-las. O acúmulo de tarefas cresce e, como os novos patches geralmente dependem dos anteriores, a janela do mês seguinte custa mais do que a deste mês. É fácil perceber como até mesmo uma equipe bem dotada de pessoal acaba tendo tempos de correção medidos em semanas.
Melhores práticas para o gerenciamento de patches em empresas modernas
A maior parte do que se segue trata de mudar a forma como você organiza o trabalho que já está realizando, e cada mudança visa resolver um dos gargalos mencionados acima. A primeira, geralmente, implica na adição de ferramentas, já que aplicar correções em um sistema em execução sem reinicialização não é algo que uma mudança no processo possa resolver por si só.
1. Retirar a reinicialização do caminho crítico
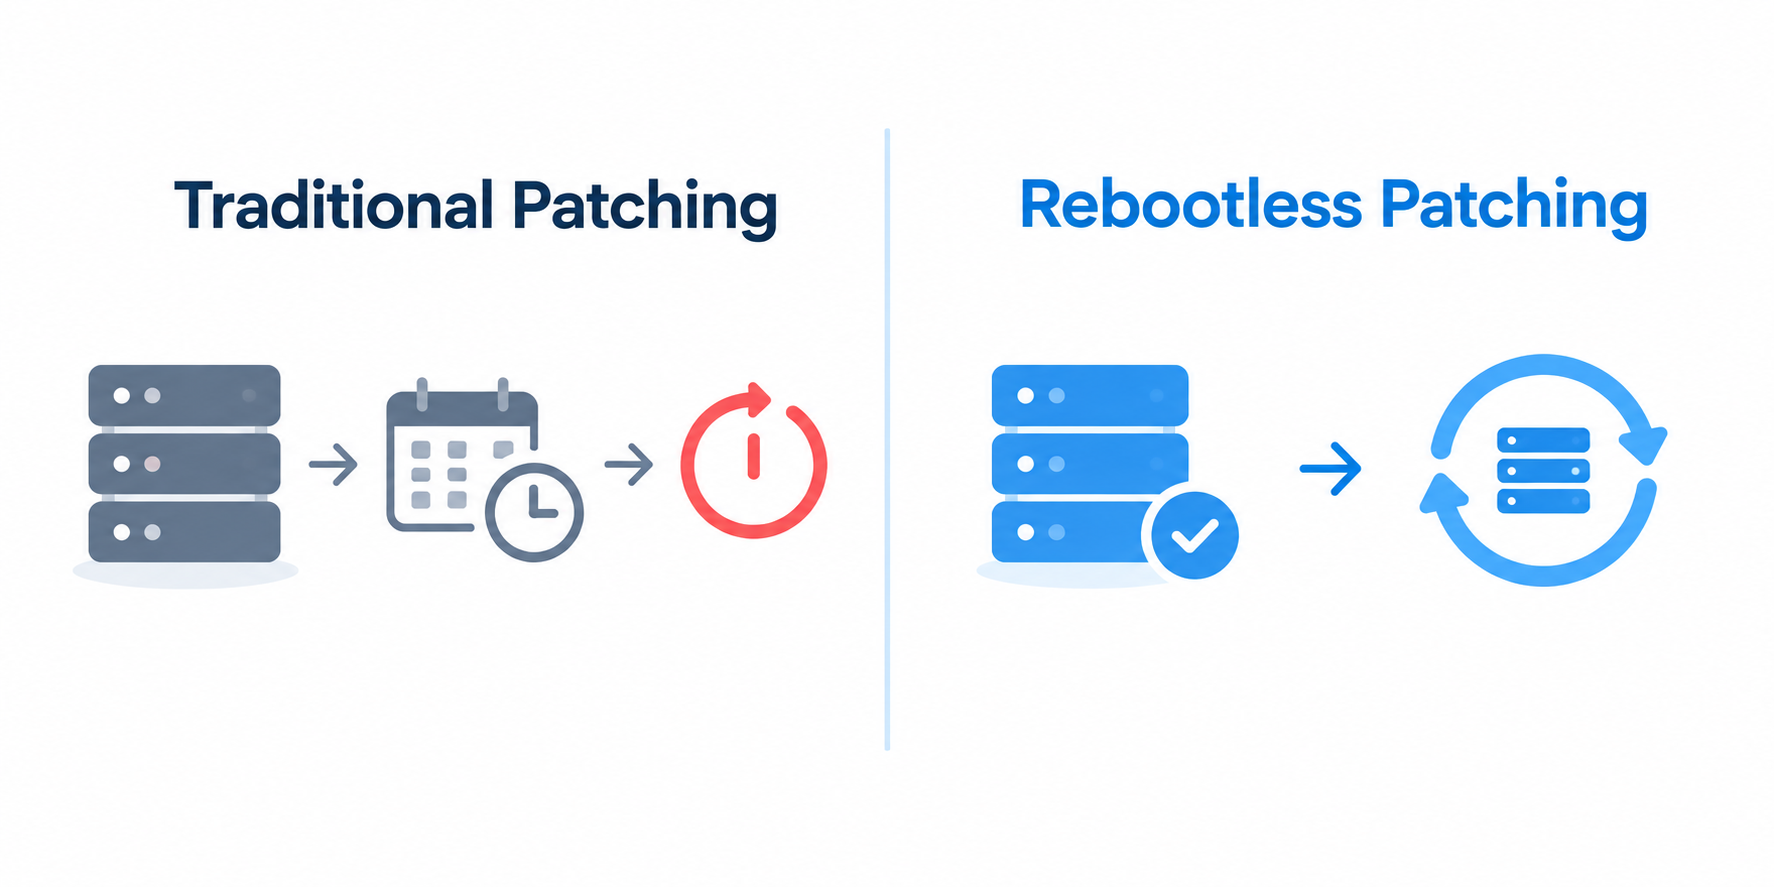
No caso de correções no kernel e nas bibliotecas, uma das medidas mais importantes que você pode tomar para acelerar a aplicação de patches é romper a ligação entre a aplicação da correção e o agendamento de um período de inatividade para isso. A aplicação de patches sem reinicialização (também chamada de “live patching”) aplica o código corrigido diretamente ao kernel em execução ou ao código da biblioteca afetada na memória, de modo que a correção pode entrar em operação em questão de minutos, em vez de ter que esperar pela próxima janela de manutenção no sábado.
O KernelCare da TuxCare faz isso para CVEs do kernel em mais de 70 versões de distribuições Linux, e o LibCare faz o mesmo para a glibc e o OpenSSL sem reiniciar os serviços que dependem deles. Se sua infraestrutura utiliza mais de uma distribuição, essa abrangência é importante. Os serviços de correção dinâmica dos próprios fornecedores geralmente estão vinculados à sua própria distribuição; portanto, um ambiente misto pode acabar precisando utilizar uma ferramenta diferente para cada uma delas.
Na prática: A OCLC opera cerca de dez mil sistemas, em sua maioria RHEL, com algumas máquinas CentOS. Após migrar para a aplicação de patches sem reinicialização, a OCLC informou que passou de 73 interrupções por ano relacionadas à aplicação de patches para zero, reduzindo em 72% o tempo gasto na aplicação de patches para vulnerabilidades CVE e diminuindo sua janela de exposição de 115 dias para 12.
Antes de agendar qualquer reinicialização, vale a pena verificar se ela é realmente necessária. Em sistemas da família RHEL, este comando informa se as atualizações instaladas, como um novo kernel ou glibc, exigem uma reinicialização completa:
precisa-ser-reiniciado -r
O Debian e o Ubuntu indicam a mesma coisa com um /run/reboot-required . Mas há um porém: nenhuma dessas verificações leva em conta patches em tempo real, então um host que já tenha recebido um patch do KernelCare ainda pode ser sinalizado para reinicialização. Depois de saber o que realmente precisa ser reiniciado, é no restante do fluxo de trabalho que a automação faz a diferença.
2. Automatizar todo o ciclo de vida
Muitas equipes automatizam a etapa em que o patch é efetivamente implantado e mantêm o inventário, a validação e a verificação como etapas manuais. Isso significa que a única parte automatizada do processo muitas vezes opera com informações desatualizadas provenientes das etapas que não são automatizadas. A descoberta, a validação da assinatura, a implantação canária e a verificação de que o patch realmente entrou em vigor devem fazer parte do mesmo pipeline.
3. Aplicar correções na nuvem e no ambiente local sob a mesma política
A aplicação de duas políticas diferentes de atualização para ambientes na nuvem e locais tende a gerar dois conjuntos distintos de evidências, o que torna as auditorias mais complexas do que deveriam ser. Os grupos de autoescala são um ponto cego comum nesse contexto. Uma instância inicializada a partir de uma imagem com dois meses de idade pode estar sem as correções de segurança dos últimos dois meses no momento em que é inicializada; portanto, é necessário ter tanto uma imagem base atualizada quanto a aplicação contínua de correções em tempo de execução para preencher essa lacuna. A solução é definir grupos de manutenção que abranjam ambos os ambientes e submetê-los às mesmas regras de priorização, requisitos de verificação e relatórios.
Soluções empresariais de gerenciamento de patches da TuxCare
Tudo o que foi abordado nos gargalos e nas melhores práticas acima aponta para a mesma conclusão: os maiores ganhos vêm da remoção das restrições, e não do planejamento em função delas. A linha de produtos da TuxCare foi desenvolvida com base nessa ideia, e cada produto preenche uma lacuna diferente das mencionadas nas seções acima.
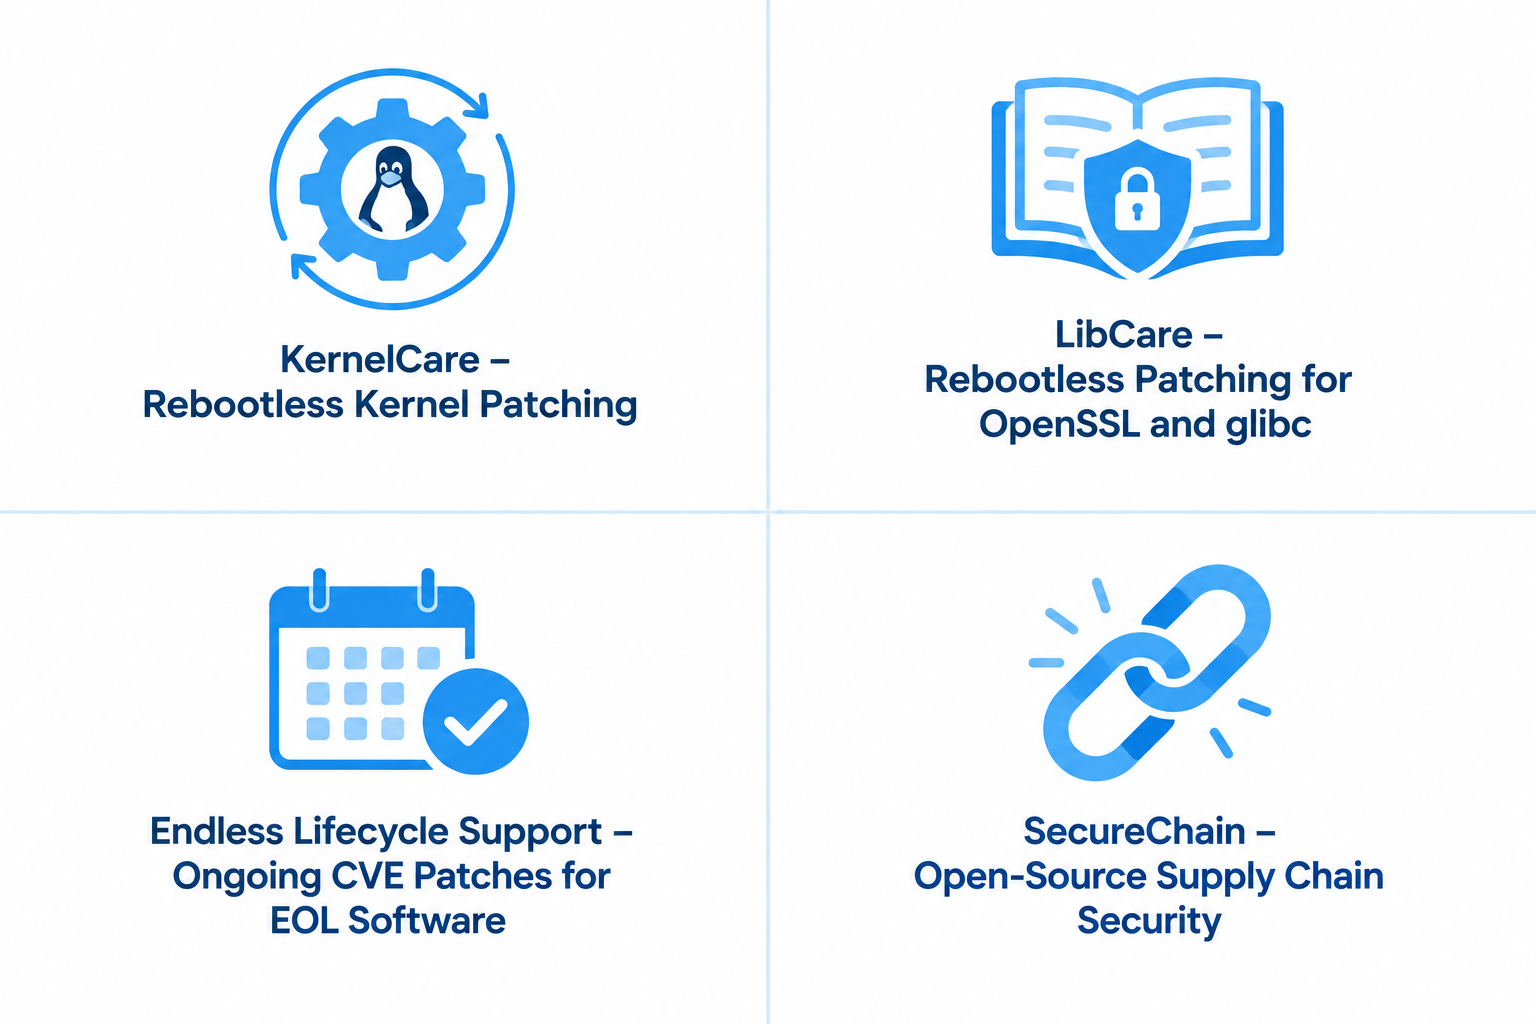
KernelCare lida diretamente com o gargalo da implantação. Ele automatiza a implantação de patches de segurança do kernel em sistemas em execução sem a necessidade de reinicialização, abrangendo mais de 70 versões de distribuição, incluindo RHEL, CentOS, Ubuntu, Debian, Oracle Linux, Amazon Linux, CloudLinux e outras, tudo por meio de um único agente. Isso é fundamental para cargas de trabalho 24 horas por dia, 7 dias por semana, e bancos de dados em cluster, em qualquer lugar onde a aprovação da reinicialização demore mais do que a aplicação do próprio patch. Ele não foi desenvolvido para máquinas Windows nem para softwares de terceiros para Windows; portanto, a maioria dos ambientes mistos o combina com uma ferramenta separada para essa parte da infraestrutura.
LibCare estende essa mesma ideia às bibliotecas compartilhadas. Ele aplica patches na glibc e no OpenSSL dentro de processos em execução, sem reiniciar os componentes que dependem deles, preenchendo a mesma lacuna de reinicialização para o código do espaço do usuário que o KernelCare preenche no nível do kernel.
Suporte contínuo ao ciclo de vida resolve o gargalo da aquisição. Quando uma distribuição ou ambiente de execução chega ao fim da vida útil, não há mais patches do fornecedor disponíveis para aquisição. O ELS garante o fornecimento contínuo de patches de segurança para versões em fim de vida útil de software de código aberto em toda a pilha, incluindo sistemas operacionais Linux, ambientes de execução de linguagens, bibliotecas e aplicativos, de modo que a equipe não precise escolher entre um sistema sem patches e uma migração apressada.
SecureChain atua em um estágio mais inicial, nas dependências de código aberto que uma base de código utiliza, em vez de no sistema operacional subjacente. Ele substitui os registros públicos por um repositório selecionado, no qual os pacotes são recompilados a partir do código-fonte, verificados quanto à presença de malware e corrigidos sob um SLA à medida que novos CVEs surgem, abrangendo JavaScript, Python, Java, Go, Rust e PHP. Esse é um risco da cadeia de suprimentos que as correções no nível do sistema operacional nunca abordam.
Juntos, esses quatro produtos preenchem as lacunas abordadas neste artigo. Até o momento, a TuxCare já corrigiu mais de 14.000 vulnerabilidades em softwares de código aberto.
Comece pela programação
Muito do que torna a aplicação de patches difícil em grande escala é de natureza operacional, e não técnica. A correção já está pronta. A janela de manutenção, não. Quando você retira a reinicialização do caminho crítico, mantém os sistemas em fim de vida (EOL) atualizados em vez de expostos e prioriza com base no que realmente está sendo explorado, o restante do processo se torna muito mais gerenciável.
A TuxCare desenvolve cada uma de suas ferramentas com o objetivo de resolver uma parte específica desse problema de agendamento, em vez de pedir que você aplique patches mais rapidamente usando o mesmo fluxo de trabalho que já possui.
Se você ainda está tentando descobrir onde está a maior lacuna no seu próprio programa, nosso guia sobre gerenciamento de patches no Linux é um bom ponto de partida. Se você já sabe e quer apenas um orçamento adaptado ao seu ambiente, consulte nossa página de preços.
Perguntas frequentes
A norma NIST SP 800-40, Revisão 4, é o guia a ser utilizado como base. Ela abrange o escopo, os quatro cenários de resposta a riscos e como agrupar ativos em planos de manutenção. Combine-a com o catálogo KEV da CISA e a diretriz BOD 26-04 para decidir o que priorizar, e com a norma NIST SP 1800-31 para obter orientações de implementação.
O gerenciamento de vulnerabilidades é o panorama geral: identificar o que está exposto e determinar o que fazer a respeito. O gerenciamento de patches é uma forma específica de agir nesse sentido, aplicando uma correção e confirmando se ela realmente foi implementada.
Isso depende da combinação de fatores de risco, e não apenas da inclusão na lista KEV. A diretriz BOD 26-04 da CISA leva em consideração a exposição, o status na lista KEV, se um invasor pode automatizar a exploração e o nível de controle que isso implica. As combinações de maior risco têm prazo de três dias; outras, de 14 ou 60; e as descobertas que não atendem a nenhum dos critérios podem aguardar uma atualização programada. A diretiva se aplica apenas a órgãos civis federais, embora a CISA já venha há muito tempo incentivando as empresas privadas a priorizarem as entradas do KEV também.
As opções incluem migrar para uma versão compatível, substituir o software ou contratar um provedor terceirizado de suporte estendido. A TuxCare, por exemplo, continua disponibilizando correções de segurança para distribuições, ambientes de execução, bibliotecas e aplicativos que chegaram ao fim da vida útil por meio do seu gerenciador de pacotes habitual, de modo que o sistema permaneça atualizado e você tenha evidências de auditoria para apresentar enquanto planeja a migração propriamente dita.
Para kernels e bibliotecas compartilhadas compatíveis, geralmente sim. A aplicação de patches sem reinicialização aplica a correção diretamente em um sistema em execução; portanto, atualizações compatíveis do kernel e patches para bibliotecas como glibc ou OpenSSL entram em vigor sem a necessidade de reinicialização. Outras atualizações de aplicativos, serviços e firmware podem ainda exigir a reinicialização de um processo, de um serviço ou de todo o sistema.
Ele fornece as evidências que os avaliadores costumam solicitar: o que há em seu ambiente, o que está atualizado e o que não está, quanto tempo as correções estão demorando e um registro de tudo o que você adiou deliberadamente. O programa NIST SP 800-40r4 se alinha bem às categorias da Estrutura de Segurança Cibernética e aos controles da SP 800-53 (o NIST SP 1800-31 mapeia sua solução de exemplo para ambos), de modo que as evidências correspondem ao que os auditores já estão verificando.