
 Technischer Support
 Dokumentation
 Anmeldung
 Kontakt



Gehen Sie direkt zu einer KI-Zusammenfassung dieses Blogbeitrags 


Wichtigste Erkenntnisse
- NIST SP 800-40, Revision 4 betrachtet das Installieren von Patches als vorbeugende Wartung, also als einen normalen Kostenfaktor im Geschäftsbetrieb.
- Bei Linux-Systemflotten, die ständig in Betrieb sind, können Neustartfenster dazu führen, dass Patches erst lange nach Fertigstellung des Fixes installiert werden.
- Mit der Richtlinie BOD 26-04 der CISA wurden die pauschalen KEV-Fristen durch Stufen ersetzt, die sich nach dem Risiko, dem KEV-Status, dem Automatisierungsgrad und den Auswirkungen richten.
- Auch Systeme, deren Lebenszyklus sich dem Ende zuneigt, benötigen weiterhin Patches, und der erweiterte Support deckt diese ab, bis Sie die Migration nach Ihrem eigenen Zeitplan durchführen.
Der Patch ist bereits seit zwei Wochen fertig. Alle sind sich einig, dass er bereitgestellt werden muss. Doch das Change-Board tagt erst wieder am Donnerstag, das einzige genehmigte Wartungsfenster ist der dritte Samstag, und der Cluster, der die Korrektur tatsächlich benötigt, ist genau der, der nicht heruntergefahren werden darf.
Dieser Artikel gibt einen Überblick über den vom NIST für das Patch-Management in Unternehmen festgelegten Patch-Lebenszyklus, den Unterschied zwischen Standard- und Notfall-Patches, wo der traditionelle Ansatz an seine Grenzen stößt und welche Tools die durchschnittliche Zeit bis zur Patch-Installation (MTTP) tatsächlich verkürzen.
Was ist Patch-Management in Unternehmen?
Unter „Patch-Management im Unternehmensbereich“ versteht man den Prozess der Identifizierung, Priorisierung, Beschaffung, Installation und Überprüfung von Patches, Updates und Upgrades für alle von einem Unternehmen betriebenen Systeme. Diese Definition stammt aus NIST SP 800-40, Revision 4, in der das Patchen als vorbeugende Wartung und als normaler Geschäftsaufwand betrachtet wird und nicht als Sicherheitsaufgabe, die man erst dann erledigt, wenn es mal ruhiger wird.
Der Begriff „Unternehmen“ spielt hier eine entscheidende Rolle. Das Installieren eines Patches auf einem Laptop ist eine Aufgabe. Das Installieren von Patches auf 8.000 gemischten Linux- und Windows-Systemen, verteilt auf vier Rechenzentren, drei Clouds und eine Produktionshalle, ist hingegen ein Planungsproblem – und genau deshalb konzentriert sich der Leitfaden des NIST auf die Planung statt auf die Tools. Der vollständige Titel lautet wörtlich: „Leitfaden zur Planung des Patch-Managements in Unternehmen“.
Außerdem ist es hilfreich, das Patch-Management von einigen Praktiken zu trennen, die oft damit in einen Topf geworfen werden:
| Übung | Frage, auf die sie eine Antwort gibt | Ausgabe |
| Patch-Verwaltung | Ist der Patch installiert und noch immer vorhanden? | Bereitgestellte, verifizierte Patches |
| Schwachstellenmanagement | Was ist betroffen, wie stark, und was können wir dagegen tun? | Risikoentscheidungen, Sanierungswarteschlange |
| Konfigurationsmanagement | Befindet sich das System im genehmigten Zustand? | Vorgeschriebene Basislinien, Drift-Warnungen |
| Endpunktverwaltung | Was befindet sich auf dem Gerät und wer kontrolliert es? | Bestandsverwaltung, Richtlinien, Softwarebereitstellung |
Drei weitere Begriffe werden oft synonym verwendet, doch es lohnt sich, sie klar voneinander abzugrenzen. Ein Patch behebt einen Fehler in bereits installierter Software, ein Update aktualisiert die Software auf eine neuere Version, und ein Upgrade ist in der Regel ein größerer Sprung auf eine neue Version. Der Unterschied ist entscheidend, wenn Sie entscheiden müssen, ob eine Fehlerbehebung einen kurzen Test, ein Wartungsfenster oder einen umfassenden Migrationsplan erfordert.
Wichtige Phasen des Lebenszyklus des Patch-Managements in Unternehmen
Das NIST unterteilt den Lebenszyklus eines Patches in drei große Phasen: Erkennen der Sicherheitslücke, Planen der Gegenmaßnahmen und anschließende Umsetzung dieser Maßnahmen durch Vorbereitung, Bereitstellung, Überprüfung und Überwachung des Patches. Für ein funktionierendes Patch-Team lässt sich dies in der Regel in fünf praktische Schritte unterteilen.
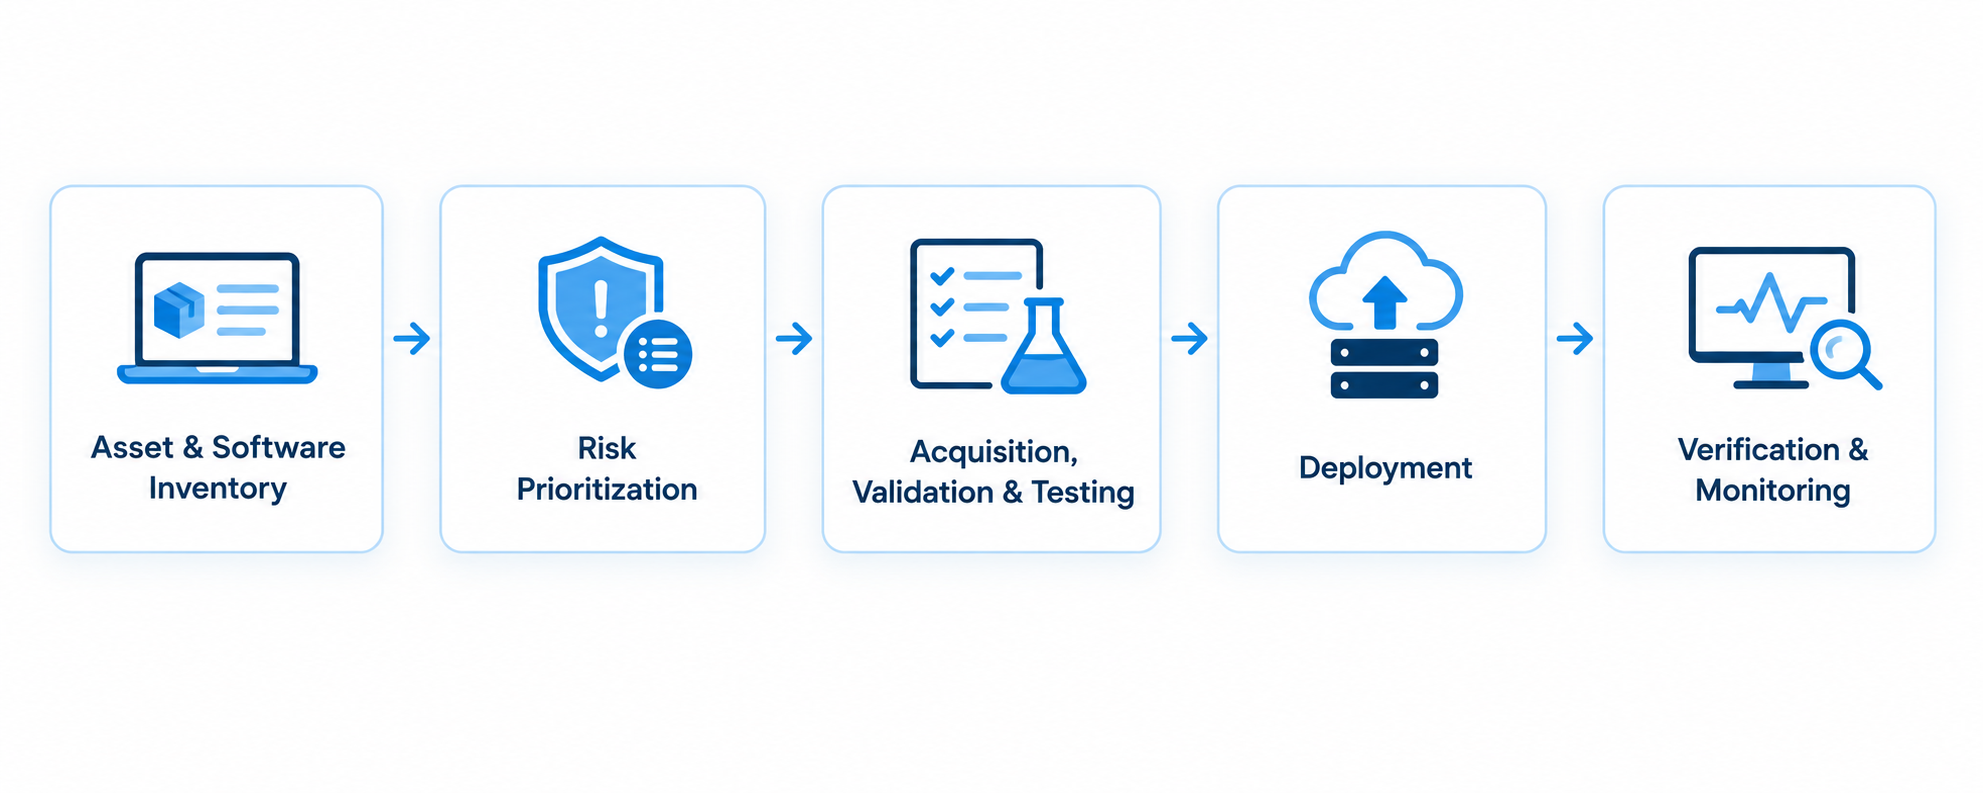
1. Bestandsaufnahme von Anlagen und Software
Was man nicht gefunden hat, kann man auch nicht patchen. Das NIST fordert Bestandsaufnahmen, die bis hin zu den Paketen und Bibliotheken reichen, die auf den einzelnen Ressourcen laufen – und damit weit über eine bloße Liste von Hostnamen hinausgehen. Außerdem heißt es dort, dass die alte Gewohnheit, Bestandsaufnahmen monatlich oder vierteljährlich durch einen Schwachstellenscan zu aktualisieren, aufgegeben werden sollte – und Container sowie Autoscaling-Gruppen zeigen, warum. Sie ändern sich viel zu schnell für eine periodische Momentaufnahme, sodass die Erfassung automatisiert und nahezu kontinuierlich erfolgen muss.
2. Risikopriorisierung
A CVSS-Wert allein sagt Ihnen nicht, was Sie zuerst beheben sollten. Ein Wert von 9,8 auf einem System, auf das niemand Zugriff hat, ist weniger wichtig als ein niedrigerer Wert, der aktiv auf einem System ausgenutzt wird, das mit dem Internet verbunden ist. Der Katalog der bekannten ausgenutzten Schwachstellen der CISA ist eine der nützlichsten kostenlosen Informationsquellen für Schwachstellen, von denen bekannt ist, dass sie in der Praxis ausgenutzt werden, da die CISA eine CVE erst dann hinzufügt, wenn sie Beweise für eine aktive Ausnutzung hat. Sehen Sie dort nach, bevor Sie eine Warteschlange allein nach Schweregrad sortieren.
3. Erfassung, Validierung und Prüfung
Die Vorbereitungsarbeiten des NIST lassen sich im Wesentlichen darauf zusammenfassen, den Patch zu beschaffen, seine Echtheit und Unversehrtheit zu überprüfen, ihn zu testen und die Installation einzuplanen. Die Validierung ist der Schritt, der am leichtesten übersehen werden kann. Ein Patch, der von einem kompromittierten Mirror stammt oder während der Übertragung manipuliert wurde, kann vollkommen legitim aussehen; daher sollten Signatur- und Prüfsummenprüfungen automatisch durchgeführt werden, bevor etwas installiert wird.
Achtung: Das Aufschieben von routinemäßigen Patches erschwert später die Installation von Notfall-Patches. Das NIST weist darauf hin, dass neue Patches oft davon abhängen, dass ältere zuvor installiert wurden. Daher muss ein System, das drei Zyklen im Rückstand ist, diesen Rückstand möglicherweise erst aufholen, bevor eine dringende Korrektur überhaupt angewendet werden kann.
4. Bereitstellung
Führen Sie die Änderung zunächst in einer kleinen Gruppe ein, dann in größeren Kreisen und schließlich bei allen. Das NIST empfiehlt, diesen „Kanarienvogel“-Schritt auch in Notfällen beizubehalten, allerdings auf einen Zeitraum von einigen Minuten bis zu einigen Stunden zu verkürzen. An dieser Stelle kommt es häufig zu Verzögerungen. Kernel-Korrekturen erfordern in der Regel einen Neustart, aktualisierte gemeinsam genutzte Bibliotheken erfordern einen Neustart der Prozesse, die sie nutzen, und beides bedeutet ein Ticket, ein Zeitfenster und jemanden, der dies koordiniert.
5. Überprüfung und Überwachung
„Überprüfen“ bedeutet, sicherzustellen, dass der Patch tatsächlich installiert wurde und wirksam ist. „Überwachen“ bedeutet, zu überprüfen, ob er auch im nächsten Monat noch vorhanden ist, da ein Neuaufbau anhand eines veralteten Images oder ein Rollback auf einen alten Snapshot die Sicherheitslücke unbemerkt wiederherstellen kann. Dabei handelt es sich um zwei unterschiedliche Aufgaben, die zusammen einen Großteil der Nachweise liefern, die ein Prüfer anfordern wird.
Standard- und Notfall-Patching-Verfahren
Sowohl das NIST als auch die CISA gehen von demselben Grundgedanken aus: Nicht jede Sicherheitslücke erfordert die gleiche Dringlichkeit. Der Leitfaden des NIST beschreibt vier Szenarien für die Risikobewältigung (routinemäßige Patches, Notfall-Patches, Notfallmaßnahmen und nicht patchebare Systeme) und sieht vor, dass jedes System einer Wartungsgruppe zugeordnet wird, für die jeweils ein eigener Plan vorliegt.
Standard-Patching
Routinemäßige Patches werden nach einem festgelegten Zeitplan für jede Art von Asset durchgeführt, wobei Tests, Freigaben und ein festes Zeitfenster integriert sind. Das NIST empfiehlt, Assets danach zu gruppieren, was sie tatsächlich benötigen – beispielsweise, wie viel Ausfallzeit sie tolerieren können, durch welche Sicherheitsmaßnahmen sie bereits geschützt sind und wie schwerwiegend eine Kompromittierung wäre. Die unten aufgeführten Zeitabstände sind Beispiele und stellen keinen Standard dar. Das NIST überlässt die Festlegung des tatsächlichen Zeitplans vollständig der Organisation, und Ihr Zeitplan sollte sich nach dem Ausmaß der Gefährdung, den Empfehlungen der Anbieter und der Risikobereitschaft Ihres Unternehmens richten.
| Anlageklasse | Beispiel für eine Kadenz | Ausfalltoleranz | Prüftiefe |
| Web- und App-Server mit Internetanbindung | Alle 7–14 Tage | Schrittweise Umstellung mit nahezu null Ausfallzeiten | Automatisierte Rauch- und Regressionsprüfung |
| Interne Anwendungsserver | Monatlich | Zeitfenster | Regression auf gemeinsame Komponenten |
| Datenbanken und zustandsbehaftete Cluster | Monatlich bis vierteljährlich | Strenges Zeitfenster, Failover erforderlich | Vollständige Regression |
| Laptops für Endnutzer | Wöchentlich bis monatlich | Tolerant | Nur Steuerring |
| OT und eingebettete Geräte | Anbieterabhängig, oft jährlich | Sehr begrenzt | Anbieterzertifizierung |
| EOL-Systeme mit erweitertem Support | Häufigkeit der Patch-Veröffentlichungen durch den Hersteller | Unterschiedlich | Vom Hersteller getestete Backports |
Routinemäßige Patches schlagen bei den Systemen, die sich nie nahtlos in ein Zeitfenster einfügen lassen, oft unbemerkt fehl. Kernel-Updates auf Systemen, die rund um die Uhr laufen, werden Zyklus für Zyklus aufgeschoben, bis das Überspringen dieser Updates zur inoffiziellen Vorgehensweise wird. Kernel-Patches ohne Neustart umgeht dieses Problem, anstatt es zu umgehen – weshalb es sich so gut für Red Hat Enterprise Linux und andere ständig aktive Systemflotten eignet.
Notfall-Patches
Das Patching im Notfall ist kein anderer Prozess. Die NIST-Leitlinien sehen vor, denselben allgemeinen Ansatz wie beim routinemäßigen Patching zu verfolgen, jedoch nach einem wesentlich strafferen Zeitplan, einschließlich der Canary-Gruppe.
Die Auslöser für den Übergang in den Notfallmodus sollten im Voraus in den Richtlinien festgelegt werden. Zu den gängigen Auslösern zählen eine Schwachstelle, die auf die KEV-Liste der CISA gesetzt wird, eine bestätigte Ausnutzung in freier Wildbahn, ein mit dem Internet verbundenes System mit einem Exploit, der automatisiert werden kann, oder ein aktiver Vorfall. Kernel-Fehler, Apache-Problemesowie OpenSSL-Schwachstellen sind klassische Beispiele dafür, was auf dieser Spur landet.
Was sich im Jahr 2026 geändert hat: Gemäß BOD 22-01 hatten zivile Bundesbehörden standardmäßig zwei Wochen Zeit, um Probleme auf der KEV-Liste zu beheben, bzw. sechs Monate, wenn die CVE-ID vor 2021 vergeben wurde. Dies änderte sich am 10. Juni 2026, als die CISA diese Regelung durch BOD 26-04ersetzte. Anstelle einer einheitlichen Frist berücksichtigt die neue Richtlinie vier Faktoren: ob die Ressource öffentlich zugänglich ist, ob die CVE auf der KEV-Liste steht, ob ein Angreifer den Exploit automatisieren könnte und wie viel Kontrolle ein erfolgreicher Exploit dem Angreifer verschafft – was die CISA als „technische Auswirkung“ bezeichnet. Die risikoreichsten Kombinationen erhalten drei Tage, und bei den KEV-Kombinationen mit dem höchsten Risiko ist zudem eine forensische Triage erforderlich, um zu prüfen, ob das System bereits kompromittiert wurde. Andere Kombinationen fallen unter die Fristen von 14 oder 60 Tagen, und Fälle, die keines der Kriterien erfüllen, können bis zum nächsten planmäßigen Update warten. Die vollständige Richtlinie listet alle 16 Kombinationen auf.
Falls noch kein Patch verfügbar ist, hat das NIST auch hierfür einen separaten Plan: Notfallmaßnahmen, die Zeit gewinnen, bis eine echte Lösung bereitgestellt wird.
Bei Systemen, die ständig in Betrieb sind, kann die Genehmigung eines Neustarts ein Hindernis für Notfall-Patches darstellen, selbst wenn die Lösung bereits gefunden und getestet wurde. Ein Kernel-Fehler in einer Cluster-Datenbank kann bedeuten, dass der Datenverkehr von den betroffenen Knoten umgeleitet, ein Failover durchgeführt, ein Neustart vorgenommen und schließlich überprüft werden muss, ob alles wieder ordnungsgemäß funktioniert. Diese Abfolge erfordert oft Genehmigungen, die über den normalen Notfall-Änderungsprozess hinausgehen. Die Vorabgenehmigung von Notfall-Neustartfenstern für jede Systemgruppe ist dabei hilfreich. Wo dies unterstützt wird, machen Patches ohne Neustart den Neustart bei Kernel- und Bibliothekskorrekturen gänzlich überflüssig.
Warum herkömmliches Patch-Management für Unternehmen nicht ausreicht
Beim herkömmlichen Patch-Management ging man davon aus, dass man ein System bei Bedarf jederzeit vom Netz nehmen könne. In Unternehmensumgebungen funktioniert das jedoch nicht so, und deshalb treten immer wieder drei Probleme auf.
1. Das Wartungsfenster bietet nie genug Platz
Stellen Sie sich einen regionalen Versicherer vor, der 1.200 RHEL-Server betreibt und monatlich genau ein vierstündiges Zeitfenster zur Verfügung hat. Kernel-Updates, Datenbank-Patches, Firmware-Updates und neue Anwendungsversionen konkurrieren alle um diese vier Stunden, und was nicht untergebracht werden kann, muss weitere 30 Tage warten. Setzen Sie Ihre eigenen Zahlen ein, und die Frage bleibt dieselbe: Was muss diesen Monat zurückgestellt werden?
Der Verizon DBIR 2026 ergab, dass die Medianzeit bis zur vollständigen Behebung kritischer Schwachstellen von 32 Tagen im Vorjahr auf 43 Tage gestiegen ist. Verizon stuft eine Schwachstelle als kritisch ein, wenn sie auf der KEV-Liste der CISA steht, und nur 26 % davon wurden vollständig behoben – ein Rückgang gegenüber 38 %. Das liegt zum Teil am Umfang, da die durchschnittliche Organisation 50 % mehr Schwachstellen zu beheben hatte als im Vorjahr. Die andere Hälfte ist auf die Kapazität zurückzuführen. In vielen Fällen existiert der Patch bereits, und die Schwierigkeit besteht darin, Zeit für das Testen, die Bereitstellung und die Überprüfung zu finden.
2. Für manche Software werden einfach keine Patches mehr bereitgestellt
Sobald eine Distribution oder Laufzeitumgebung das Ende ihres Lebenszyklus erreicht hat, stellt der Anbieter die Bereitstellung von Sicherheitsupdates ein, auch wenn weiterhin neue CVEs auftauchen. Das NIST bringt es auf den Punkt: Es kann sein, dass niemals ein Patch veröffentlicht wird, weil die Software das Ende ihres Lebenszyklus erreicht hat. Wer noch CentOS 7 nutzt, weiß genau, wie das aussieht – ebenso wie jeder, der RHEL 7 ohne erweiterten Supportvertrag. Der Scanner meldet jeden Monat dieselben CVEs, und die Spalte „Behebung“ bleibt einfach leer.
Die üblichen Optionen sind entweder die Migration von der alten Version oder die Bezahlung eines erweiterten Supports, bei dem Sie weiterhin Patches über Ihren üblichen Paketmanager erhalten, während Sie die Migration nach Ihrem eigenen Zeitplan planen.
3. Teams setzen Prioritäten auf der Grundlage unvollständiger Informationen
Viele Teams sortieren ihre Warteschlange nach wie vor nach dem CVSS-Wert in einem Scanner-Bericht – doch dieser Wert sagt nichts darüber aus, ob eine Schwachstelle tatsächlich ausgenutzt wird, ob die Software bereits das Ende ihrer Lebensdauer erreicht hat oder ob der anfällige Code überhaupt noch im Speicher geladen ist. Sortiert man allein nach diesem Wert, erhält man eine Warteschlange mit Tausenden von Einträgen, die nach einer Zahl geordnet sind, die das tatsächliche Risiko nicht widerspiegelt.
Der „M-Trends“-Bericht 2026 von Mandiant ergab, dass Exploits bereits im sechsten Jahr in Folge der häufigste anfängliche Infektionsvektor waren und für 32 % der Angriffe verantwortlich waren. Mandiant schätzte zudem die durchschnittliche Zeit bis zum Exploit auf minus sieben Tage, was bedeutet, dass Exploits regelmäßig bereits vor der Veröffentlichung eines Patches stattfinden. Eine Warteschlange, die auf umfassenderen Kontextinformationen wie dem Exploit-Status, der Gefährdung und den tatsächlich ausgeführten Prozessen basiert, wird so zu einer Grundlage, auf deren Grundlage Sie Maßnahmen ergreifen können.
Diese drei Probleme verstärken sich gegenseitig. Eine schlecht priorisierte Warteschlange führt dazu, dass zunächst die falschen Aufgaben bearbeitet werden. Das winzige Wartungsfenster bietet nur Platz für einen Bruchteil selbst dieser fehlerhaften Warteschlange. Und Befunde zu Systemen am Ende ihrer Lebensdauer bleiben Monat für Monat unberücksichtigt, da es vom Anbieter keine Patches gibt, mit denen sie behoben werden könnten. Der Rückstand wächst, und da neue Patches oft von früheren abhängen, kostet das Fenster im nächsten Monat mehr als das in diesem Monat. Es ist leicht nachvollziehbar, warum selbst ein gut besetztes Team am Ende Behebungszeiten hat, die sich in Wochen bemessen.
Bewährte Verfahren für modernes Patch-Management in Unternehmen
Im Folgenden geht es größtenteils darum, die Abfolge der bereits von Ihnen ausgeführten Arbeiten anzupassen, wobei jede Änderung auf einen der oben genannten Engpässe abzielt. Die erste Änderung bedeutet in der Regel den Einsatz zusätzlicher Tools, da das Patchen eines laufenden Systems ohne Neustart nicht allein durch eine Prozessänderung erreicht werden kann.
1. Den Neustart aus dem kritischen Pfad herausnehmen
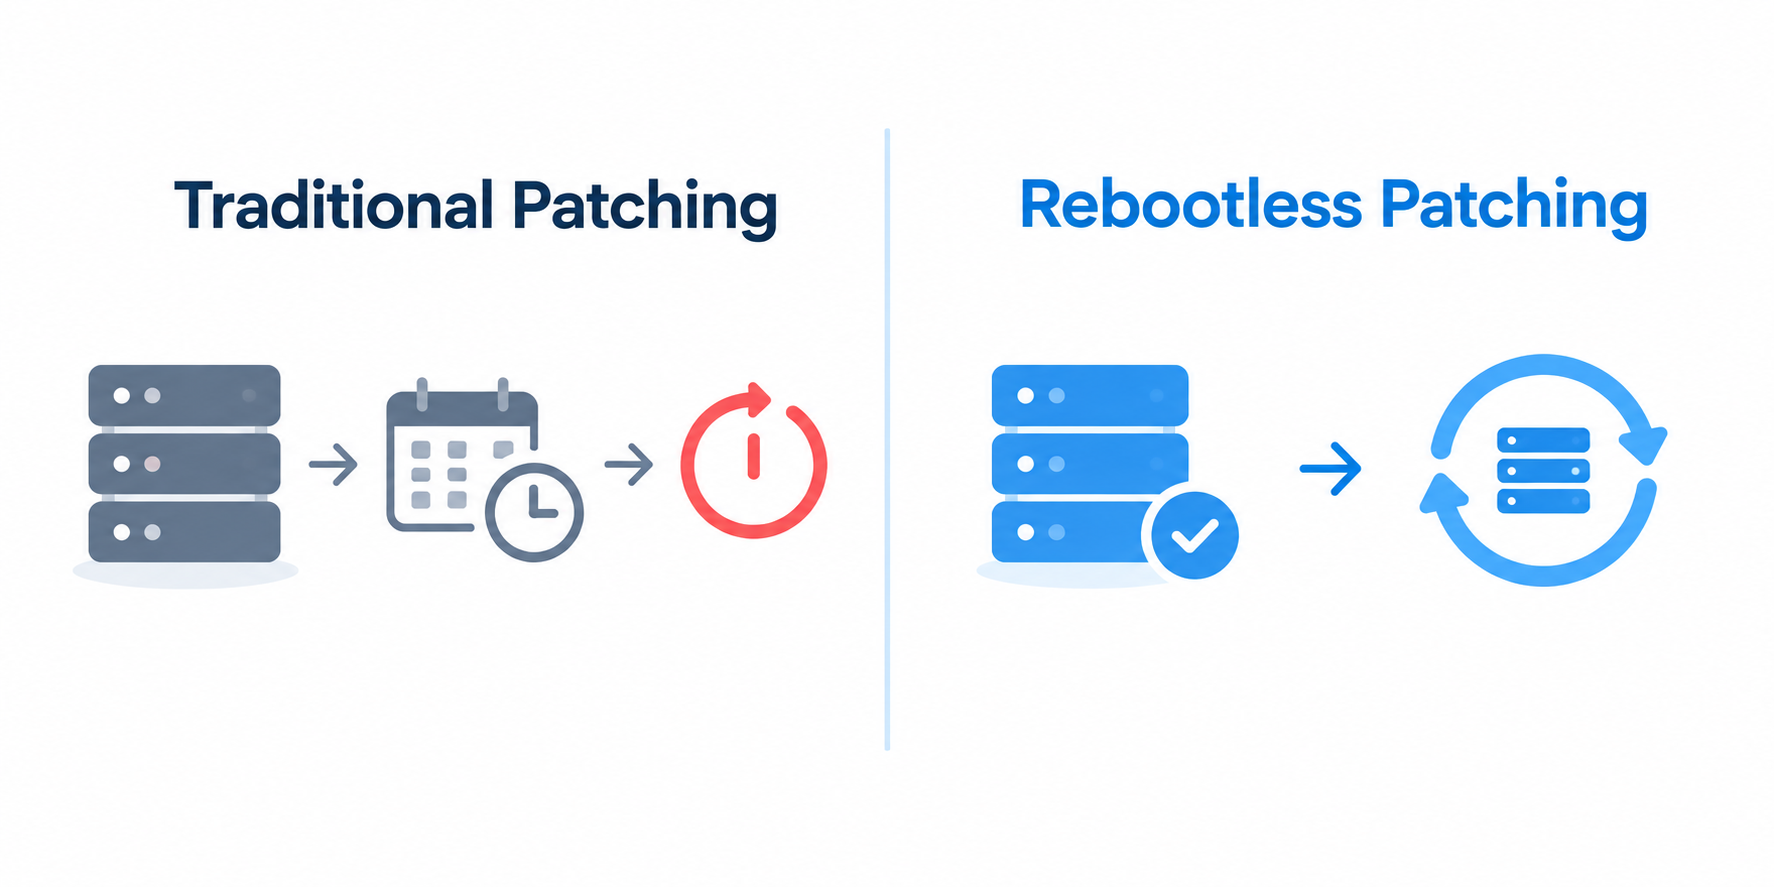
Bei Korrekturen am Kernel und an Bibliotheken können Sie die Patching-Geschwindigkeit am effektivsten steigern, indem Sie die Verknüpfung zwischen der Anwendung der Korrektur und der Planung einer Ausfallzeit dafür aufheben. Beim „Rebootless Patching“ (auch „Live-Patching“ genannt) wird der korrigierte Code direkt auf den laufenden Kernel oder auf den betroffenen Bibliothekscode im Arbeitsspeicher angewendet, sodass die Korrektur innerhalb weniger Minuten in Betrieb genommen werden kann, anstatt auf das nächste Wartungsfenster am Samstag warten zu müssen.
KernelCare von TuxCare erledigt dies für Kernel-CVEs in mehr als 70 Linux-Distributionen, und LibCare leistet dasselbe für glibc und OpenSSL, ohne dass die davon abhängigen Dienste neu gestartet werden müssen. Wenn Ihre Infrastruktur mehr als eine Distribution nutzt, ist diese Breite von Bedeutung. Die Live-Patching-Dienste der Anbieter sind in der Regel an ihre eigene Distribution gebunden, sodass eine gemischte Infrastruktur unter Umständen für jede Distribution ein eigenes Tool einsetzen muss.
In der Praxis: OCLC betreibt rund zehntausend Systeme, überwiegend RHEL mit einer Handvoll CentOS-Rechnern. Nach der Umstellung auf Patches ohne Neustart vermeldete OCLC einen Rückgang der patchbedingten Ausfälle von 73 pro Jahr auf null, eine Reduzierung des Zeitaufwands für CVE-Patches um 72 % sowie eine Verkürzung des Sicherheitsrisikofensters von 115 Tagen auf 12.
Bevor man einen Neustart plant, sollte man prüfen, ob dieser tatsächlich erforderlich ist. Auf Systemen der RHEL-Familie gibt dieser Befehl Auskunft darüber, ob installierte Updates, wie beispielsweise ein neuer Kernel oder eine neue glibc, einen vollständigen Neustart erfordern:
muss neu gestartet werden -r
Debian und Ubuntu zeigen dasselbe mit einem /run/reboot-required -Datei an. Ein Haken: Keine der beiden Prüfungen berücksichtigt Live-Patches, sodass ein Host, den KernelCare bereits gepatcht hat, dennoch für einen Neustart markiert werden kann. Sobald Sie wissen, was wirklich einen Neustart erfordert, zahlt sich die Automatisierung im weiteren Arbeitsablauf aus.
2. Den gesamten Lebenszyklus automatisieren
Viele Teams automatisieren nur den Teil, bei dem der Patch tatsächlich bereitgestellt wird, und führen Bestandserfassung, Validierung und Verifizierung weiterhin manuell durch. Das bedeutet, dass der einzige automatisierte Teil des Prozesses oft auf veralteten Informationen aus den nicht automatisierten Teilen basiert. Die Erkennung, die Signaturvalidierung, die Canary-Einführung und die Überprüfung, ob der Patch tatsächlich wirksam geworden ist, gehören in dieselbe Pipeline.
3. Cloud- und On-Premise-Systeme unter ein und derselben Richtlinie verwalten
Die Anwendung zweier unterschiedlicher Patching-Richtlinien für die Cloud und lokale Umgebungen führt häufig dazu, dass zwei unterschiedliche Nachweissätze entstehen, was Audits unnötig erschwert. Autoscaling-Gruppen sind hier ein häufiger blinder Fleck. Bei einer Instanz, die aus einem zwei Monate alten Image gestartet wird, fehlen möglicherweise bereits beim Hochfahren zwei Monate an Sicherheitsupdates. Um diese Lücke zu schließen, benötigen Sie daher sowohl ein gepatchtes Basis-Image als auch fortlaufende Patches während der Laufzeit. Die Lösung besteht darin, Wartungsgruppen zu definieren, die beide Umgebungen umfassen, und für diese dieselben Priorisierungsregeln, Überprüfungsanforderungen und Berichtspflichten festzulegen.
Die Enterprise-Patch-Management-Lösungen von TuxCare
Alles, was in den oben genannten Engpässen und Best Practices beschrieben wird, führt zu derselben Schlussfolgerung: Die größten Erfolge lassen sich erzielen, indem man Einschränkungen beseitigt, anstatt die Planung um sie herum anzupassen. Die Produktpalette von TuxCare basiert auf diesem Ansatz, und jedes Produkt schließt eine andere Lücke aus den oben genannten Abschnitten.
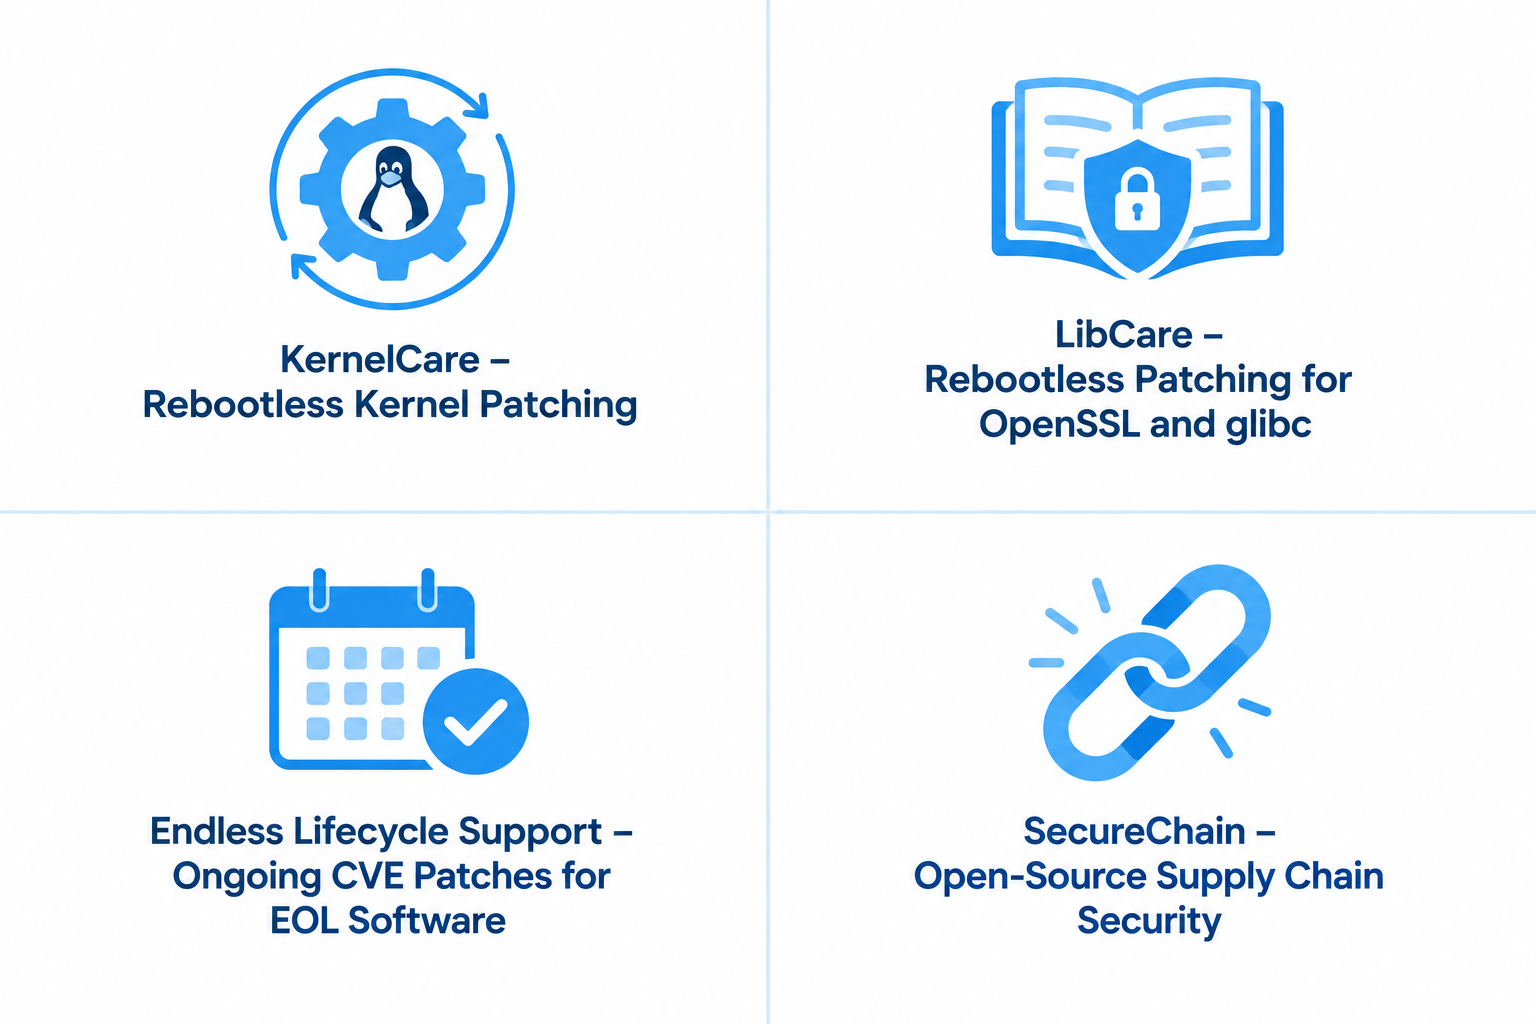
KernelCare behebt den Engpass bei der Bereitstellung direkt. Es automatisiert die Bereitstellung von Kernel-Sicherheitspatches auf laufenden Systemen ohne Neustart und deckt mehr als 70 Distributionsversionen von RHEL, CentOS, Ubuntu, Debian, Oracle Linux, Amazon Linux, CloudLinux und anderen unter einem einzigen Agenten ab. Dies ist besonders wichtig für Workloads im 24/7-Betrieb und für Cluster-Datenbanken – überall dort, wo die Genehmigung eines Neustarts länger dauert als das Anwenden des Patches selbst. Da die Lösung nicht für Windows-Rechner oder Windows-Software von Drittanbietern ausgelegt ist, wird sie in den meisten gemischten Umgebungen mit einem separaten Tool für diesen Teil der Infrastruktur kombiniert.
LibCare erweitert dieses Konzept auf gemeinsam genutzte Bibliotheken. Es patcht glibc und OpenSSL innerhalb laufender Prozesse, ohne die davon abhängigen Anwendungen neu zu starten, und schließt damit für den Userspace-Code dieselbe Art von Neustartlücke, die KernelCare auf Kernel-Ebene schließt.
Unbegrenzter Lebenszyklus-Support löst den Beschaffungsengpass. Sobald eine Distribution oder Laufzeitumgebung das Ende ihres Lebenszyklus erreicht hat, sind keine Hersteller-Patches mehr erhältlich. ELS stellt weiterhin Sicherheitspatches für Open-Source-Versionen am Ende ihres Lebenszyklus über den gesamten Stack hinweg bereit, einschließlich Linux-Betriebssystemen, Sprach-Laufzeitumgebungen, Bibliotheken und Anwendungen, sodass ein Team nicht zwischen einem ungepatchten System und einer überstürzten Migration wählen muss.
SecureChain greift weiter vorgelagert ein, und zwar bei den Open-Source-Abhängigkeiten, die eine Codebasis einbindet, und nicht beim darunterliegenden Betriebssystem. Es ersetzt öffentliche Register durch ein kuratiertes Repository, in dem Pakete aus dem Quellcode neu kompiliert, auf Malware überprüft und im Rahmen eines SLA gepatcht werden, sobald neue CVEs auftreten – und zwar für JavaScript, Python, Java, Go, Rust und PHP. Das sind Risiken in der Lieferkette, die durch Patches auf Betriebssystemebene niemals abgedeckt werden.
Zusammengenommen schließen diese vier Produkte die Lücken, die in diesem Artikel erläutert wurden. TuxCare hat bis heute mehr als 14.000 Sicherheitslücken in Open-Source-Software behoben.
Beginnen Sie mit dem Zeitplan
Vieles, was das Patchen in großem Maßstab erschwert, ist eher betrieblicher als technischer Natur. Der Patch ist bereit. Das Wartungsfenster jedoch nicht. Sobald man den Neustart aus dem kritischen Pfad herausnimmt, EOL-Systeme gepatcht hält, anstatt sie ungeschützt zu lassen, und Prioritäten danach setzt, was tatsächlich ausgenutzt wird, lässt sich der Rest viel besser bewältigen.
TuxCare entwickelt jedes seiner Tools mit dem Ziel, einen bestimmten Aspekt dieses Planungsproblems zu beseitigen, anstatt von Ihnen zu verlangen, Patches mit demselben Arbeitsablauf, den Sie bereits nutzen, schneller zu erstellen.
Wenn Sie noch dabei sind, herauszufinden, wo in Ihrem eigenen Programm die größte Lücke besteht, hilft Ihnen unser Leitfaden zum Linux-Patch-Management ein guter Ausgangspunkt. Wenn Sie dies bereits wissen und lediglich ein auf Ihre Umgebung zugeschnittenes Angebot wünschen, besuchen Sie unsere Preisseite.
FAQs
NIST SP 800-40, Revision 4, dient als Leitfaden für die Umsetzung. Er behandelt den Anwendungsbereich, die vier Szenarien für die Risikobewältigung sowie die Einteilung von Ressourcen in Wartungspläne. Kombinieren Sie ihn mit dem KEV-Katalog der CISA und der BOD 26-04, um Prioritäten festzulegen, sowie mit NIST SP 1800-31 als Leitfaden für die Umsetzung.
Beim Schwachstellenmanagement geht es um das große Ganze: herauszufinden, welche Schwachstellen vorhanden sind, und zu entscheiden, was dagegen zu tun ist. Das Patch-Management ist eine konkrete Maßnahme in diesem Zusammenhang, bei der ein Patch installiert und überprüft wird, ob er tatsächlich erfolgreich angewendet wurde.
Es hängt von der Kombination der Risikofaktoren ab, nicht allein von der KEV-Listung. Die Richtlinie BOD 26-04 der CISA berücksichtigt die Gefährdung, den KEV-Status, die Frage, ob ein Angreifer den Exploit automatisieren kann, und inwieweit dadurch die Kontrolle abgegeben wird. Kombinationen mit dem höchsten Risiko erhalten drei Tage, andere 14 oder 60, und Befunde, die keines der Kriterien erfüllen, können bis zu einem geplanten Upgrade warten. Die Richtlinie gilt zwar nur für zivile Bundesbehörden, doch die CISA fordert private Unternehmen seit langem dazu auf, KEV-Einträge ebenfalls vorrangig zu behandeln.
Zu den Optionen gehören die Migration auf eine unterstützte Version, der Austausch der Software oder die Beauftragung eines Drittanbieters für erweiterten Support. TuxCare beispielsweise stellt weiterhin Sicherheitspatches für nicht mehr unterstützte Distributionen, Laufzeitumgebungen, Bibliotheken und Anwendungen über Ihren üblichen Paketmanager bereit, sodass das System auf dem neuesten Stand bleibt und Sie während der Planung der eigentlichen Migration entsprechende Nachweise vorlegen können.
Bei unterstützten Kerneln und gemeinsam genutzten Bibliotheken ist dies in der Regel der Fall. Beim „Rebootless Patching“ wird der Fix direkt auf ein laufendes System angewendet, sodass unterstützte Kernel-Updates und Patches für Bibliotheken wie glibc oder OpenSSL ohne Neustart in Kraft treten. Bei anderen Anwendungs-, Dienst- und Firmware-Updates kann es jedoch weiterhin erforderlich sein, einen Prozess, einen Dienst oder das gesamte System neu zu starten.
Es liefert die Nachweise, die Prüfer in der Regel verlangen: Was befindet sich in Ihrer Umgebung, was ist gepatcht und was nicht, wie lange dauert die Behebung von Schwachstellen und eine Auflistung aller Maßnahmen, die Sie bewusst zurückgestellt haben. Das Programm lässt sich gut auf die Kategorien des Cybersecurity Framework und die Kontrollmaßnahmen nach SP 800-53 abbilden (NIST SP 1800-31 ordnet seine Beispielslösung beiden zu), sodass die Nachweise genau das widerspiegeln, was Auditoren ohnehin bereits prüfen.