
 Support technique
 Documentation
 Connexion
 Nous contacter



Accédez directement au résumé généré par l'IA de cet article de blog 


Principaux enseignements
- NIST SP 800-40, révision 4 considère l'application de correctifs comme une mesure de maintenance préventive, un coût standard inhérent à l'activité.
- Sur les parcs de serveurs Linux fonctionnant en continu, les fenêtres de redémarrage peuvent retarder l'application des correctifs bien après que ceux-ci soient disponibles.
- La décision BOD 26-04 de la CISA a remplacé les délais fixes prévus par le KEV par des niveaux de priorité déterminés en fonction de l'exposition, du statut KEV, du degré d'automatisation et de l'impact.
- Les systèmes en fin de vie nécessitent toujours des correctifs, et le support étendu les couvre jusqu'à ce que vous procédiez à la migration selon votre calendrier.
Le correctif est prêt depuis deux semaines. Tout le monde s'accorde à dire qu'il faut le déployer. Mais le comité chargé des modifications ne se réunira pas avant jeudi, la seule plage horaire approuvée pour la maintenance est le troisième samedi du mois, et le cluster qui a réellement besoin de ce correctif est justement celui qui ne peut pas être mis hors service.
Cet article présente le cycle de vie des correctifs défini par le NIST pour la gestion des correctifs en entreprise, la différence entre les correctifs standard et les correctifs d'urgence, les limites de l'approche traditionnelle, ainsi que les outils qui permettent réellement de réduire le délai moyen de déploiement des correctifs (MTTP).
Qu'est-ce que la gestion des correctifs en entreprise ?
La gestion des correctifs en entreprise désigne le processus consistant à identifier, hiérarchiser, acquérir, installer et vérifier les correctifs, les mises à jour et les mises à niveau sur l'ensemble des systèmes exploités par une organisation. Cette définition est tirée de la norme NIST SP 800-40, révision 4, qui considère l'application des correctifs comme une maintenance préventive et un coût normal de l'activité, plutôt que comme une tâche de sécurité à laquelle on ne s'attelle que lorsque le rythme de travail ralentit.
Le terme « entreprise » prend ici tout son sens. Appliquer un correctif sur un seul ordinateur portable est une tâche. Appliquer des correctifs sur 8 000 systèmes mixtes Linux et Windows répartis dans quatre centres de données, trois environnements cloud et un site de production est un véritable casse-tête en matière de planification, et c’est pourquoi le guide du NIST met l’accent sur la planification plutôt que sur les outils. Son titre complet commence d’ailleurs littéralement par « Guide de planification de la gestion des correctifs en entreprise ».
Cela permet également de distinguer la gestion des correctifs de certaines pratiques que l'on a tendance à lui associer :
| Entraînement | Question à laquelle elle répond | Sortie |
| Gestion des correctifs | Le correctif a-t-il été installé et est-il toujours installé ? | Correctifs déployés et vérifiés |
| Gestion des vulnérabilités | Qu'est-ce qui est exposé, dans quelle mesure, et que pouvons-nous y faire ? | Décisions relatives aux risques, file d'attente des mesures correctives |
| Gestion de la configuration | Le système est-il dans son état validé ? | Seuils imposés, alertes de dérive |
| Gestion des terminaux | Que contient cet appareil et qui en a le contrôle ? | Inventaire, politique, déploiement de logiciels |
Trois autres termes sont souvent utilisés de manière interchangeable, et il est important de bien les distinguer. Un « patch » corrige un problème dans un logiciel déjà installé, une « mise à jour » permet de passer à une version plus récente, tandis qu’une « mise à niveau » correspond généralement à un changement plus important vers une nouvelle version. Cette distinction est importante lorsque vous devez déterminer si une correction nécessite un test rapide, une fenêtre de maintenance ou un plan de migration complet.
Étapes clés du cycle de vie de la gestion des correctifs en entreprise
Le NIST divise le cycle de vie des correctifs en trois grandes phases : identification de la vulnérabilité, planification de la réponse, puis mise en œuvre de cette réponse par la préparation, le déploiement, la vérification et le suivi du correctif. Pour une équipe chargée des correctifs, cela se décline généralement en cinq étapes concrètes.
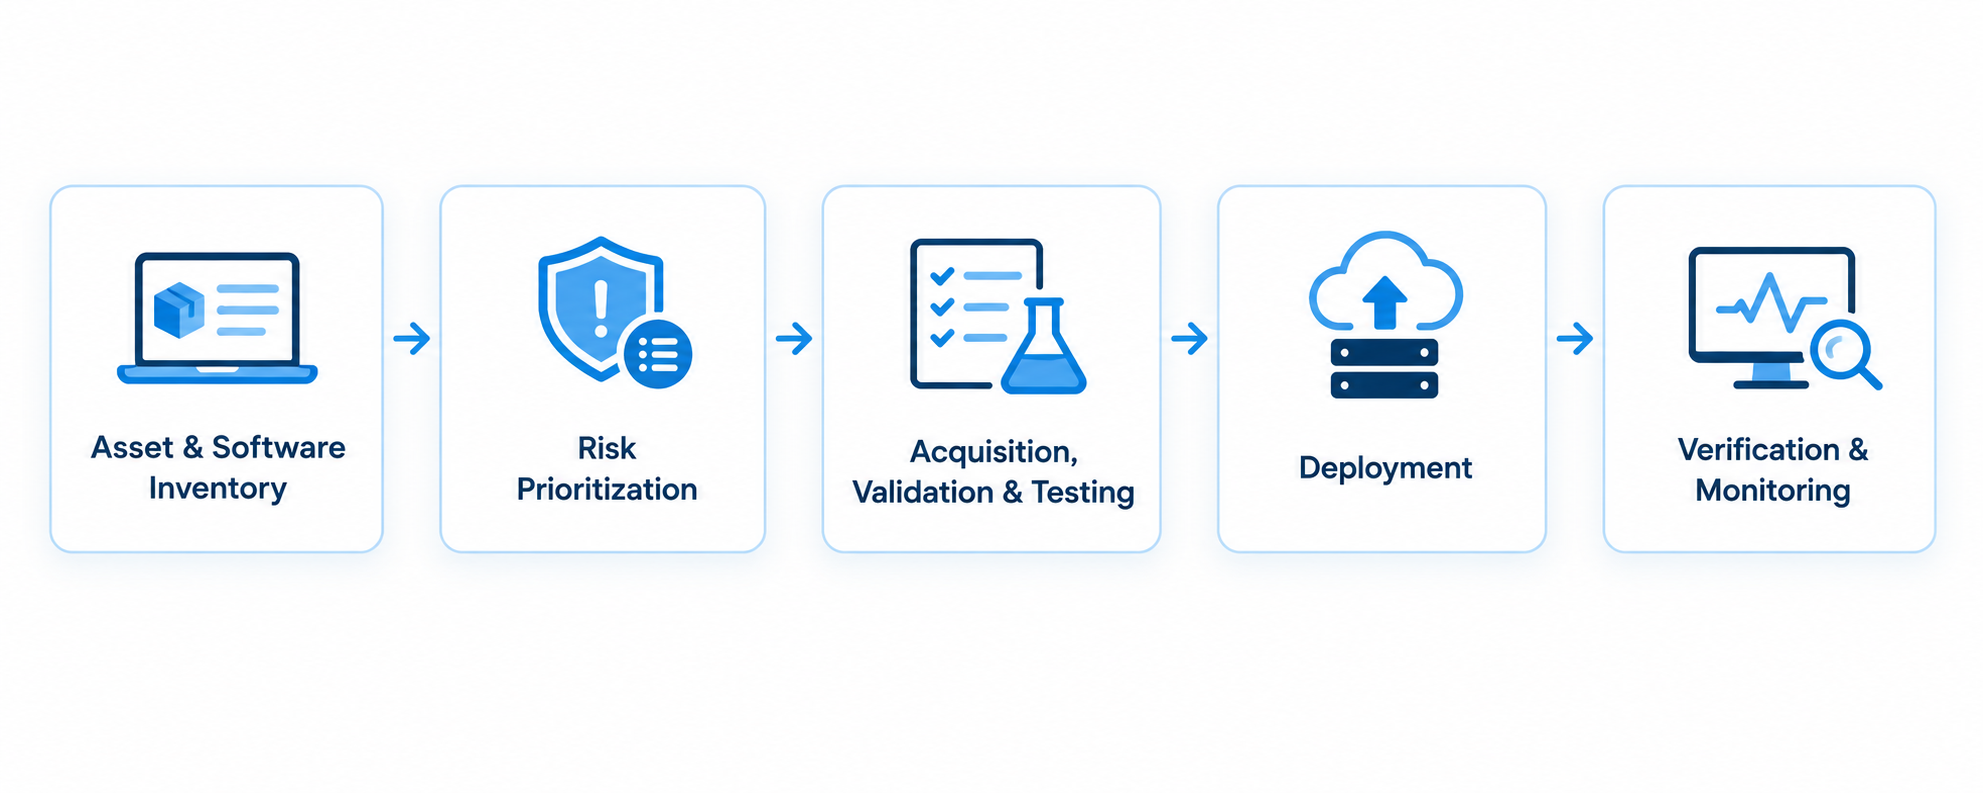
1. Inventaire des actifs et des logiciels
On ne peut pas corriger ce que l'on n'a pas identifié. Le NIST préconise des inventaires qui descendent jusqu'aux paquets et bibliothèques exécutés par chaque ressource, bien au-delà d'une simple liste de noms d'hôtes. Il indique également qu'il faudrait abandonner l'ancienne habitude consistant à actualiser les inventaires tous les mois ou tous les trimestres à l'aide d'un scan de vulnérabilités, et les conteneurs ainsi que les groupes à dimensionnement automatique en expliquent la raison. Ils évoluent bien trop rapidement pour se contenter d'un instantané périodique ; l'identification doit donc être automatisée et quasi continue.
2. Hiérarchisation des risques
A score CVSS ne suffit pas à lui seul à déterminer ce qu’il faut corriger en priorité. Un score de 9,8 sur un système inaccessible a moins d’importance qu’un score inférieur pour lequel une faille est activement exploitée sur un système exposé à Internet. Le catalogue des vulnérabilités connues pour être exploitées de la CISA est l’une des sources d’informations gratuites les plus utiles concernant les vulnérabilités dont on sait qu’elles sont exploitées dans la nature, car la CISA n’ajoute un CVE qu’une fois qu’elle dispose de preuves d’une exploitation active. Consultez-le avant de trier une file d’attente uniquement en fonction de la gravité.
3. Acquisition, validation et essais
Le travail préparatoire du NIST consiste essentiellement à récupérer le correctif, à vérifier qu’il est authentique et qu’il n’a pas été altéré, à le tester et à planifier son installation. La validation est l’étape qu’il est le plus facile de négliger. Un correctif provenant d’un miroir compromis ou ayant été altéré en cours de transfert peut paraître parfaitement légitime ; c’est pourquoi les vérifications de signature et de somme de contrôle doivent s’effectuer automatiquement avant toute installation.
Attention : Repousser l'installation des correctifs de routine rendra les correctifs d'urgence plus difficiles à appliquer par la suite. Le NIST souligne que les nouveaux correctifs dépendent souvent de l'installation préalable des anciens ; ainsi, un système qui a trois cycles de retard devra peut-être rattraper son retard avant même qu'un correctif urgent puisse être appliqué.
4. Déploiement
Déployez-le d’abord auprès d’un petit groupe, puis à des cercles plus larges, avant de le généraliser à tous les utilisateurs. Le NIST recommande de conserver cette étape de « canari » même en cas d’urgence, en la limitant simplement à une durée comprise entre quelques minutes et quelques heures. C’est souvent à ce stade que les choses ralentissent. Les correctifs du noyau nécessitent généralement un redémarrage, tandis que la mise à jour des bibliothèques partagées exige le redémarrage des processus qui les utilisent ; dans les deux cas, cela implique la création d’un ticket, la définition d’une fenêtre de maintenance et la coordination par un responsable.
5. Vérification et suivi
La vérification consiste à s’assurer que le correctif a bien été installé et qu’il est effectif. La surveillance consiste à vérifier qu’il est toujours présent le mois suivant, car une reconstruction à partir d’une image obsolète ou un retour à un ancien instantané peut réintroduire la vulnérabilité sans que l’on s’en aperçoive. Il s’agit de deux tâches distinctes qui, à elles deux, fournissent une grande partie des preuves qu’un auditeur demandera.
Procédures de correction standard et procédures de correction d'urgence
Le NIST et la CISA partent tous deux du même principe : toutes les vulnérabilités ne nécessitent pas le même degré d'urgence. Le guide du NIST présente quatre scénarios de réponse aux risques (correctifs de routine, correctifs d'urgence, mesures d'atténuation d'urgence et ressources ne pouvant pas être corrigées) et préconise que chaque ressource soit affectée à un groupe de maintenance disposant de son propre plan pour chacun de ces scénarios.
Mises à jour standard
Les opérations de correction de routine s’effectuent selon un calendrier défini pour chaque type de ressource, intégrant des phases de test, de validation et une fenêtre de mise en œuvre fixe. Le NIST recommande de regrouper les ressources en fonction de leurs besoins réels, notamment le temps d’indisponibilité qu’elles peuvent tolérer, les contrôles de sécurité dont elles bénéficient déjà et la gravité d’une éventuelle compromission. Les cadences indiquées ci-dessous sont des exemples et ne constituent pas une norme. Le NIST laisse entièrement à l’organisation le soin de définir le calendrier effectif, qui doit tenir compte de l’exposition aux risques, des recommandations des fournisseurs et du niveau de risque que vous êtes prêt à assumer.
| Catégorie d'actifs | Exemple de cadence | Tolérance aux pannes | Profondeur d'essai |
| Serveurs web et serveurs d'applications exposés à Internet | Tous les 7 à 14 jours | Mise en service progressive, temps d'arrêt quasi nul | Tests automatisés de fumée et de régression |
| Serveurs d'applications internes | Mensuel | Plage horaire prévue | Régression sur les composantes communes |
| Bases de données et clusters avec état | Tous les mois à tous les trimestres | Fenêtre stricte, basculement requis | Régression complète |
| Ordinateurs portables destinés aux utilisateurs finaux | Chaque semaine ou chaque mois | Tolérant | Anneau pilote uniquement |
| OT et appareils embarqués | Organisées par les exposants, souvent une fois par an | Très limité | Certification des fournisseurs |
| Systèmes en fin de vie bénéficiant d'une assistance prolongée | Fréquence de publication des correctifs par les éditeurs | Variable | Backports testés par le fournisseur |
Les mises à jour de routine ont tendance à échouer discrètement sur les ressources qui ne s'inscrivent jamais parfaitement dans une fenêtre de maintenance. Les mises à jour du noyau sur les systèmes fonctionnant 24 heures sur 24 sont repoussées cycle après cycle, jusqu'à ce que leur omission devienne la politique officieuse. L'application de correctifs au noyau sans redémarrage contourne ce problème au lieu de chercher à le contourner, ce qui explique pourquoi cette solution est si couramment adoptée pour Red Hat Enterprise Linux et d'autres parcs de serveurs fonctionnant en continu.
Corrections d'urgence
L'application de correctifs d'urgence ne constitue pas un processus différent. Le NIST recommande d'adopter la même approche générale que pour l'application de correctifs de routine, mais selon un calendrier beaucoup plus serré, y compris pour le groupe « canary ».
Les conditions déclenchant le passage en mode d’urgence doivent être définies à l’avance dans une politique. Parmi les cas les plus courants, on peut citer l’ajout d’une vulnérabilité à la liste KEV de la CISA, la confirmation d’une exploitation en milieu réel, la présence d’une faille exploitable de manière automatisée sur un système connecté à Internet, ou encore un incident en cours. Bugs du noyau, problèmes liés à Apacheet failles d’OpenSSL sont des exemples classiques de ce qui finit par être traité dans cette voie.
Ce qui a changé en 2026 : En vertu de la directive BOD 22-01, les agences civiles fédérales disposaient par défaut de deux semaines pour corriger tout élément figurant sur la liste KEV, ou de six mois si l’identifiant CVE avait été attribué avant 2021. Cela a changé le 10 juin 2026, lorsque la CISA l’a remplacée par la BOD 26-04. Au lieu d’un délai unique et fixe, la nouvelle directive prend en compte quatre critères : si le système est exposé au public, si le CVE figure sur la liste KEV, si un attaquant pourrait automatiser l’exploitation de la faille, et quel niveau de contrôle une exploitation réussie confère à l’attaquant, ce que la CISA appelle « l’impact technique ». Les combinaisons les plus risquées se voient accorder trois jours, et les combinaisons KEV présentant le risque le plus élevé nécessitent également un triage informatique pour vérifier si le système a déjà été compromis. D’autres combinaisons donnent droit à 14 ou 60 jours, et les cas ne répondant à aucun de ces critères peuvent attendre la prochaine mise à jour programmée. La directive complète détaille l’ensemble des 16 combinaisons.
Si aucun correctif n'est encore disponible, le NIST a également prévu une solution pour ce cas de figure : des mesures d'atténuation d'urgence, qui permettent de gagner du temps jusqu'à ce qu'un véritable correctif soit mis à disposition.
Sur les systèmes fonctionnant en continu, l’autorisation de redémarrage est l’un des points où l’application d’un correctif d’urgence peut être bloquée, même après que la solution a été trouvée et testée. Un bug du noyau sur une base de données en cluster peut impliquer de détourner le trafic des nœuds affectés, d’effectuer un basculement, de redémarrer et de vérifier que tout fonctionne à nouveau correctement. Cette séquence nécessite souvent une validation allant au-delà de ce que couvre le processus normal de modification d’urgence. Il est utile de pré-approuver des créneaux de redémarrage d’urgence pour chaque groupe de systèmes. Lorsque cela est pris en charge, l’application de correctifs sans redémarrage élimine complètement la nécessité d’un redémarrage pour les correctifs du noyau et des bibliothèques.
Pourquoi la gestion traditionnelle des correctifs ne répond pas aux besoins des entreprises
La gestion traditionnelle des correctifs partait du principe qu'il était possible de mettre un système hors ligne à tout moment. Or, les environnements d'entreprise ne fonctionnent pas ainsi, ce qui entraîne régulièrement l'apparition de trois problèmes.
1. La fenêtre de maintenance n'a jamais assez d'espace
Imaginez un assureur régional exploitant 1 200 serveurs RHEL et ne disposant que d’une seule fenêtre de quatre heures par mois pour intervenir. Les mises à jour du noyau, les correctifs de base de données, les mises à jour de micrologiciel et les nouvelles versions d’applications se disputent toutes ces quatre heures, et tout ce qui n’est pas pris en compte doit attendre encore 30 jours. Remplacez ces chiffres par les vôtres, et la question reste la même : qu’est-ce qui va être mis de côté ce mois-ci ?
Le rapport DBIR 2026 de Verizon a révélé que le délai médian nécessaire pour résoudre complètement les vulnérabilités critiques est passé à 43 jours, contre 32 l’année précédente. Verizon considère qu’une vulnérabilité est critique lorsqu’elle figure sur la liste KEV de la CISA, et seules 26 % d’entre elles ont été entièrement corrigées, contre 38 % l’année précédente. Le volume explique en partie cette évolution, puisque l'entreprise médiane avait 50 % de vulnérabilités supplémentaires à corriger par rapport à l'année précédente. La capacité explique l'autre moitié. Dans de nombreux cas, le correctif existe déjà, et la difficulté réside dans la recherche de temps pour le tester, le déployer et le vérifier.
2. Certains logiciels ne reçoivent tout simplement plus de correctifs
Dès qu’une distribution ou un environnement d’exécution arrive en fin de vie, le fournisseur cesse de publier des correctifs de sécurité, même si de nouveaux CVE continuent d’apparaître. Le NIST le dit sans détour : il se peut qu’aucun correctif ne soit jamais publié parce que le logiciel est en fin de vie. Quiconque utilise encore CentOS 7 sait exactement à quoi cela ressemble, tout comme ceux qui utilisent RHEL 7 sans contrat de support étendu. Le scanner continue de signaler les mêmes CVE chaque mois, et la colonne « correctif » reste vide.
Les options habituelles consistent soit à migrer depuis l'ancienne version, soit à souscrire à un support étendu qui vous permet de continuer à recevoir les correctifs via votre gestionnaire de paquets habituel pendant que vous planifiez la migration selon votre propre calendrier.
3. Les équipes établissent des priorités sur la base d'informations incomplètes
De nombreuses équipes continuent de trier leur file d’attente en fonction du score CVSS figurant dans le rapport d’un scanner – or, ce chiffre ne permet pas de savoir si une faille est réellement exploitée, si le logiciel a déjà atteint sa fin de vie, ni même si le code vulnérable est toujours chargé en mémoire. En se basant uniquement sur ce critère, on se retrouve avec une file d’attente de milliers d’éléments classés selon un chiffre qui ne reflète pas le risque réel.
Le rapport « M-Trends 2026 » de Mandiant a révélé que les exploits constituaient le vecteur d’infection initial le plus courant pour la sixième année consécutive, à l’origine de 32 % des intrusions. Mandiant a également estimé le délai moyen avant exploitation à moins sept jours, ce qui signifie que l’exploitation a généralement lieu avant même la publication d’un correctif. Une file d’attente s’appuyant sur un contexte plus riche, tel que le statut d’exploitation, l’exposition et ce qui est réellement en cours d’exécution, se transforme en une information exploitable.
Ces trois problèmes s'alimentent mutuellement. Une mauvaise hiérarchisation des priorités fait que ce sont les mauvaises tâches qui sont traitées en premier. La fenêtre de maintenance, déjà très réduite, ne permet de traiter qu'une fraction de cette file d'attente défaillante. Et les problèmes identifiés sur les systèmes en fin de vie restent en suspens mois après mois, car le fournisseur ne fournit aucun correctif pour y remédier. Le retard s'accumule, et comme les nouveaux correctifs dépendent souvent des précédents, la fenêtre de maintenance du mois suivant coûte plus cher que celle du mois en cours. On comprend aisément comment même une équipe dotée d’effectifs suffisants peut se retrouver avec des délais de correction se chiffrant en semaines.
Meilleures pratiques en matière de gestion des correctifs dans les entreprises modernes
La majeure partie de ce qui suit porte sur la manière de réorganiser les tâches que vous effectuez déjà, et chaque changement vise à résoudre l’un des goulots d’étranglement mentionnés ci-dessus. Le premier implique généralement l’ajout d’outils, car l’application de correctifs à un système en cours d’exécution sans redémarrage ne peut pas être réalisée uniquement par un changement de processus.
1. Retirer le redémarrage du chemin critique
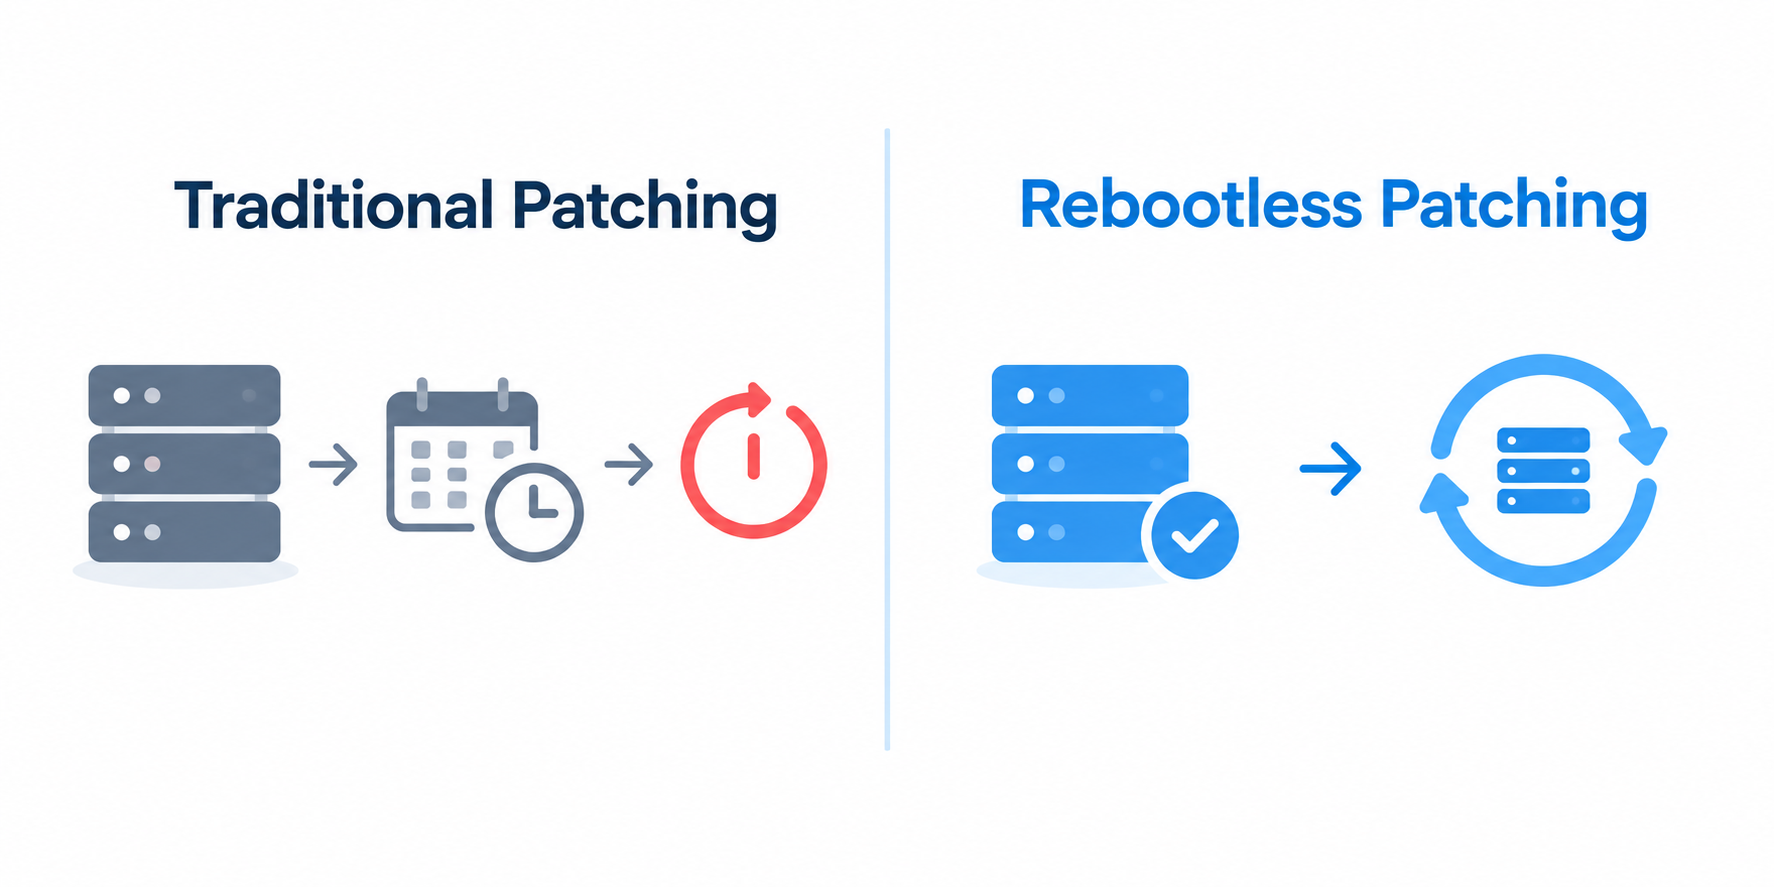
En ce qui concerne les correctifs du noyau et des bibliothèques, l'une des mesures les plus efficaces pour accélérer le déploiement des correctifs consiste à dissocier l'application du correctif de la planification d'une période d'indisponibilité. Le déploiement de correctifs sans redémarrage (également appelé « déploiement à chaud ») applique le code corrigé directement au noyau en cours d'exécution ou au code de la bibliothèque concernée en mémoire. Le correctif peut ainsi être mis en production en quelques minutes, sans avoir à attendre la prochaine fenêtre de maintenance du samedi.
KernelCare de TuxCare assure cette fonctionnalité pour les vulnérabilités CVE du noyau sur plus de 70 versions de distributions Linux, tandis que LibCare fait de même pour glibc et OpenSSL sans redémarrer les services qui en dépendent. Si votre parc utilise plusieurs distributions, cette polyvalence est essentielle. Les services de correctifs en temps réel proposés par les éditeurs sont généralement liés à leur propre distribution ; un parc hétérogène peut donc se retrouver à devoir jongler avec un outil distinct pour chacune d’entre elles.
En pratique : OCLC exploite environ dix mille systèmes, principalement sous RHEL, avec quelques machines sous CentOS. Après être passé à l'application de correctifs sans redémarrage, OCLC a indiqué être passé de 73 interruptions de service liées à l'application de correctifs par an à zéro, avoir réduit de 72 % le temps consacré à l'application des correctifs CVE et avoir ramené sa fenêtre d'exposition de 115 jours à 12.
Avant de planifier un redémarrage, il est conseillé de vérifier si celui-ci est réellement nécessaire. Sur les systèmes de la famille RHEL, cette commande indique si les mises à jour installées, telles qu’un nouveau noyau ou une nouvelle version de glibc, nécessitent un redémarrage complet :
doit-être-redémarré -r
Debian et Ubuntu signalent la même chose avec un fichier /run/reboot-required . Un bémol toutefois : aucune de ces deux vérifications ne tient compte des correctifs en temps réel ; ainsi, un hôte sur lequel KernelCare a déjà appliqué un correctif peut tout de même être signalé comme nécessitant un redémarrage. Une fois que vous savez ce qui nécessite réellement un redémarrage, c’est dans la suite du processus que l’automatisation prend tout son sens.
2. Automatiser l'ensemble du cycle de vie
De nombreuses équipes automatisent uniquement la phase de déploiement du correctif, tout en conservant les étapes d’inventaire, de validation et de vérification au format manuel. Cela signifie que la seule partie automatisée du processus fonctionne souvent à partir d’informations obsolètes provenant des étapes qui ne le sont pas. La détection, la validation de la signature, le déploiement « canary » et la vérification de la prise d’effet effective du correctif doivent faire partie du même pipeline.
3. Appliquer les correctifs aux environnements cloud et sur site selon une même politique
Le fait d’appliquer deux politiques de correctifs différentes pour le cloud et les environnements sur site a tendance à générer deux ensembles de preuves distincts, ce qui complique inutilement les audits. Les groupes à dimensionnement automatique constituent souvent un angle mort à cet égard. Une instance lancée à partir d’une image datant de deux mois peut ne pas disposer des correctifs de sécurité des deux derniers mois dès son démarrage ; il est donc nécessaire de disposer à la fois d’une image de base mise à jour et d’une mise à jour continue en cours d’exécution pour combler cette lacune. La solution consiste à définir des groupes de maintenance couvrant les deux environnements et à leur appliquer les mêmes règles de priorisation, les mêmes exigences de vérification et les mêmes procédures de reporting.
Solutions de gestion des correctifs pour les entreprises proposées par TuxCare
Tout ce qui a été évoqué ci-dessus concernant les goulots d'étranglement et les bonnes pratiques conduit à la même conclusion : les gains les plus importants proviennent de la suppression des contraintes, et non de la mise en place d'un planning pour les contourner. La gamme de produits de TuxCare s'articule autour de ce principe, et chaque élément comble une lacune différente parmi celles évoquées dans les sections précédentes.
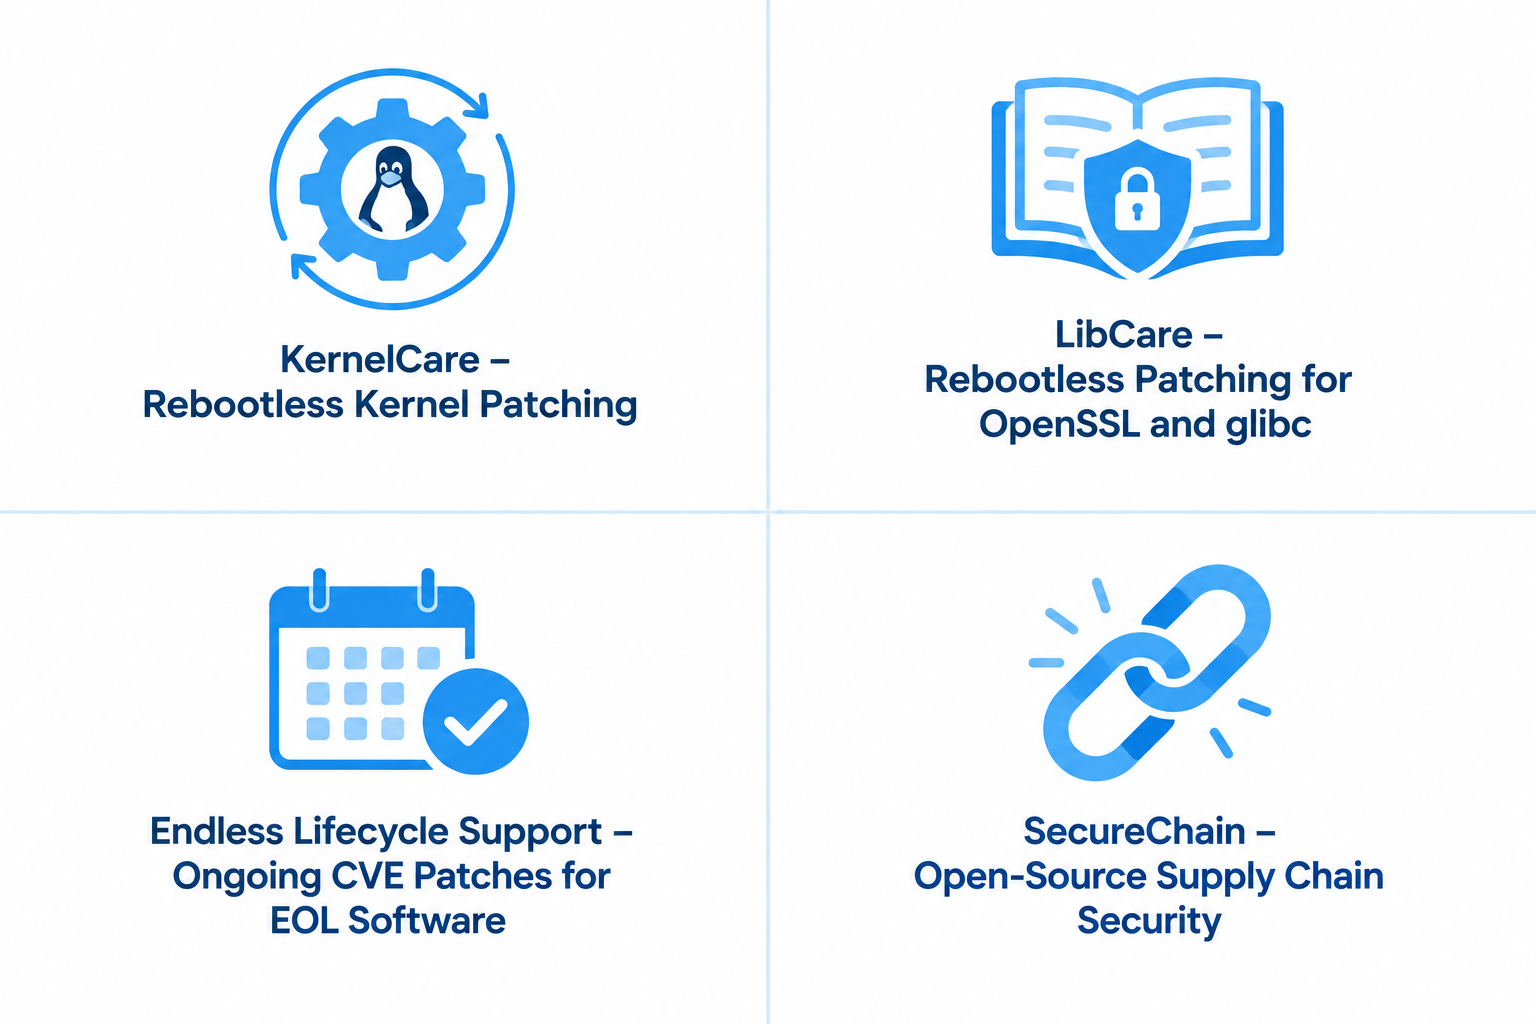
KernelCare résout directement le problème des goulots d’étranglement liés au déploiement. Il automatise le déploiement des correctifs de sécurité du noyau sur les systèmes en cours d’exécution sans redémarrage, couvrant plus de 70 versions de distributions, notamment RHEL, CentOS, Ubuntu, Debian, Oracle Linux, Amazon Linux, CloudLinux et bien d’autres, le tout via un seul agent. Cela revêt une importance capitale pour les charges de travail fonctionnant 24 h/24 et 7 j/7 ainsi que pour les bases de données en cluster, partout où l’obtention de l’autorisation de redémarrage prend plus de temps que l’application du correctif lui-même. Cette solution n’est pas conçue pour les machines Windows ni pour les logiciels Windows tiers ; c’est pourquoi la plupart des environnements mixtes l’associent à un outil distinct pour cette partie du parc.
LibCare étend ce même principe aux bibliothèques partagées. Il applique des correctifs à glibc et OpenSSL au sein des processus en cours d'exécution sans redémarrer les applications qui en dépendent, comblant ainsi pour le code de l'espace utilisateur le même type de lacune liée au redémarrage que KernelCare comble au niveau du noyau.
Prise en charge illimitée du cycle de vie résout le problème des difficultés d’acquisition. Lorsqu’une distribution ou un environnement d’exécution arrive en fin de vie, il n’y a plus de correctifs disponibles auprès du fournisseur. L’ELS continue de fournir des correctifs de sécurité pour les versions en fin de vie des logiciels open source sur l’ensemble de la pile, y compris les systèmes d’exploitation Linux, les environnements d’exécution des langages, les bibliothèques et les applications. Ainsi, les équipes n’ont pas à choisir entre un système non mis à jour et une migration précipitée.
SecureChain intervient davantage en amont, au niveau des dépendances open source utilisées par une base de code plutôt qu'au niveau du système d'exploitation sous-jacent. Il remplace les registres publics par un référentiel contrôlé où les paquets sont recompilés à partir du code source, analysés à la recherche de logiciels malveillants et corrigés dans le cadre d'un SLA à mesure que de nouvelles vulnérabilités (CVE) apparaissent, que ce soit en JavaScript, Python, Java, Go, Rust ou PHP. Il s'agit là d'un risque lié à la chaîne d'approvisionnement que les correctifs au niveau du système d'exploitation ne traitent jamais.
Ensemble, ces quatre produits comblent les lacunes évoquées dans cet article. À ce jour, TuxCare a corrigé plus de 14 000 failles de sécurité dans des logiciels libres.
Commencez par le calendrier
Une grande partie des difficultés liées à l'application de correctifs à grande échelle est d'ordre opérationnel plutôt que technique. Le correctif est prêt. La fenêtre de maintenance, elle, ne l'est pas. Une fois que vous avez supprimé le redémarrage du chemin critique, que vous veillez à ce que les systèmes en fin de vie soient mis à jour plutôt que laissés exposés, et que vous établissez vos priorités en fonction des vulnérabilités réellement exploitées, le reste devient beaucoup plus facile à gérer.
TuxCare conçoit chacun de ses outils dans le but de résoudre un aspect spécifique de ce problème de planification, plutôt que de vous demander d'appliquer des correctifs plus rapidement en utilisant le même flux de travail que celui dont vous disposez déjà.
Si vous cherchez encore à identifier les principales lacunes de votre propre programme, consultez notre guide sur la gestion des correctifs Linux est un bon point de départ. Si vous le savez déjà et que vous souhaitez simplement obtenir un devis adapté à votre environnement, consultez notre page de tarifs.
FAQ
La norme NIST SP 800-40, révision 4, constitue le guide de référence. Elle couvre le champ d'application, les quatre scénarios de réponse aux risques et la manière de regrouper les actifs dans des plans de maintenance. Associez-la au catalogue KEV de la CISA et à la directive BOD 26-04 pour déterminer les priorités, ainsi qu'à la norme NIST SP 1800-31 pour obtenir des conseils de mise en œuvre.
La gestion des vulnérabilités s'inscrit dans une perspective plus large : identifier les points d'exposition et déterminer les mesures à prendre pour y remédier. La gestion des correctifs est l'une des façons concrètes d'y parvenir : appliquer un correctif et vérifier qu'il a bien été pris en compte.
Cela dépend de la combinaison des facteurs de risque, et non pas uniquement de la présence sur la liste KEV. La directive BOD 26-04 de la CISA prend en compte l’exposition, le statut KEV, la capacité d’un attaquant à automatiser l’exploitation et l’étendue du contrôle ainsi conféré. Les combinaisons présentant le risque le plus élevé bénéficient d’un délai de trois jours, les autres de 14 ou 60 jours, et les vulnérabilités ne répondant à aucun de ces critères peuvent attendre une mise à jour programmée. Cette directive ne s’applique qu’aux agences civiles fédérales, bien que la CISA exhorte depuis longtemps les entreprises privées à accorder également la priorité aux entrées du KEV.
Les options possibles consistent à migrer vers une version prise en charge, à remplacer le logiciel ou à faire appel à un prestataire tiers proposant une assistance étendue. TuxCare, par exemple, continue de fournir des correctifs de sécurité pour les distributions, les environnements d'exécution, les bibliothèques et les applications en fin de vie via votre gestionnaire de paquets habituel. Ainsi, le système reste à jour et vous disposez de preuves d'audit à présenter pendant que vous planifiez la migration proprement dite.
Pour les noyaux et les bibliothèques partagées pris en charge, c'est généralement le cas. L'application de correctifs sans redémarrage applique la correction directement au système en cours d'exécution ; ainsi, les mises à jour du noyau et les correctifs pour des bibliothèques telles que glibc ou OpenSSL sont déployés sans nécessiter de redémarrage. D'autres mises à jour d'applications, de services et de micrologiciels peuvent toutefois nécessiter le redémarrage d'un processus, d'un service ou de l'ensemble du système.
Il fournit les éléments de preuve généralement demandés par les évaluateurs : ce qui se trouve dans votre environnement, ce qui a été corrigé et ce qui ne l’a pas été, le temps nécessaire à la mise en place des correctifs, ainsi qu’un relevé de tout ce que vous avez délibérément reporté. Le programme NIST SP 800-40r4 s’aligne parfaitement sur les catégories du Cybersecurity Framework et les contrôles de la norme SP 800-53 (la norme NIST SP 1800-31 fait correspondre sa solution type à ces deux référentiels), de sorte que ces éléments de preuve correspondent exactement à ce que les auditeurs vérifient déjà.