Soporte técnico
 Documentación
 Inicio de sesión
 Contáctenos


Ir directamente al resumen generado por IA de esta entrada del blog 


Principales conclusiones
- Las medidas de protección de RHEL constituyen un sólido punto de partida para la seguridad de Red Hat, pero nada de eso sirve de nada sin una aplicación activa de parches, ciclos de auditoría y una gestión rigurosa del ciclo de vida.
- El uso de RHEL 7 o cualquier versión fuera de soporte sin un plan de soporte ampliado conlleva riesgos en materia de auditorías e incumplimientos normativos.
- La aplicación de parches en tiempo real permite aplicar correcciones CVE del núcleo a sistemas en funcionamiento sin necesidad de reiniciar; KernelCare, de TuxCare, lo hace en todas las principales versiones de RHEL.
La mayoría de los equipos que utilizan Red Hat Enterprise Linux dan por sentado que su nivel de seguridad es sólido debido a la excelente reputación de Red Hat. La plataforma incluye SELinux activado, paquetes firmados y un proceso consolidado de divulgación de vulnerabilidades. Esa reputación se ha ganado a pulso.
Pero esto da lugar a un fallo concreto en la seguridad de Red Hat: dar por sentado que la plataforma se encarga de todo, cuando en realidad el trabajo —la aplicación de parches para vulnerabilidades, la planificación del ciclo de vida y el mantenimiento de las auditorías— recae en el equipo que la gestiona.
Esto es lo que ocurre en la práctica. Un martes se publica un CVE del núcleo de Linux. El parche está disponible el viernes. Tu próxima ventana de mantenimiento es dentro de 18 días. Un atacante que conozca ese CVE dispone ahora de un margen de 18 días para actuar contra tus sistemas. No se trata de una hipótesis: es la realidad cotidiana de la seguridad de Linux en las empresas, y por eso la periodicidad de las actualizaciones es tan importante como la disponibilidad de los parches.
Cómo es realmente la seguridad de Red Hat
La arquitectura de seguridad de RHEL está estructurada en capas, lo que constituye tanto su punto fuerte como la razón por la que su mantenimiento requiere un esfuerzo activo, en lugar de una confianza pasiva.
A nivel del núcleo, SELinux aplica un control de acceso obligatorio, lo que significa que ni siquiera un proceso comprometido puede salir del ámbito de la política que se le ha aplicado. Esto supone una protección significativa cuando se configura correctamente y resulta totalmente inútil cuando alguien ejecuta setenforce 0 durante un incidente y nunca lo revoca. Además, el control de acceso basado en roles gestiona los límites de identidad y privilegios. Por otra parte, la infraestructura de actualizaciones firmadas de Red Hat y su Vulnerabilidad de Linux El canal de seguimiento te ofrece un proceso de gestión de CVE fiable y parches cuya procedencia puedes confiar.
El problema es que nada de esto se mantiene por sí solo. RHEL es seguro desde el primer día. Que siga siéndolo depende totalmente de lo que haga tu equipo a partir de entonces. Un sistema RHEL 7 que se reforzó adecuadamente en 2020 y al que no se le han aplicado parches desde mediados de 2024 acumula años de vulnerabilidades (CVE) sin parchear tanto en el núcleo como en el espacio de usuario. El diseño original no protege contra las vulnerabilidades reveladas después de la aplicación del último parche.
Para los equipos que siguen utilizando RHEL 7 tras su fin de vida útil (EOL) en junio de 2024, el servicio «Endless Lifecycle Support» de TuxCare es una de las únicas formas de seguir recibiendo parches para vulnerabilidades CVE sin verse obligados a realizar una migración que quizá aún no sea viable desde el punto de vista operativo.
Por qué es importante la seguridad de Red Hat
RHEL suele utilizarse para gestionar la infraestructura, que, aunque aburrida, es fundamental. Los bancos la utilizan para la liquidación de operaciones. Las empresas de telecomunicaciones la emplean para el enrutamiento. Los hospitales ejecutan en ella sus sistemas de historias clínicas electrónicas. Cuando las principales aerolíneas e instituciones financieras detallan sus arquitecturas, RHEL suele ocupar un lugar central y crucial. Esto significa que la superficie de ataque es amplia y que el alcance de una brecha de seguridad es considerable.
Los ataques dirigidos a Linux han aumentado considerablemente en los últimos años. Los grupos de ransomware y los actores maliciosos vinculados a Estados han desplazado su atención de los terminales Windows hacia los servidores Linux, donde se encuentran realmente las cargas de trabajo de alto valor. La puerta trasera 2024 XZ Utils (CVE-2024-3094) fue un conato de ataque que habría afectado a una parte sustancial de las distribuciones derivadas de RHEL de haber llegado a una versión estable. Fue detectada. Puede que la próxima no lo sea.
El cumplimiento normativo añade un nivel adicional de urgencia. La HIPAA, la norma PCI DSS, el RGPD y la certificación SOC 2 parten de un mismo supuesto: que se utiliza un software que sigue recibiendo actualizaciones de seguridad del proveedor. En el momento en que un sistema alcanza el fin de su vida útil (EOL) sin un acuerdo de soporte ampliado, ese supuesto deja de ser válido, y los auditores se dan cuenta. «El sistema funciona bien» no es un argumento válido en materia de cumplimiento normativo. Para comprender mejor lo que esto implica desde el punto de vista operativo, consulte qué significa el fin de la vida útil de RHEL 7 para su empresa.
Riesgos de seguridad habituales en RHEL
Los riesgos que se enumeran a continuación no son casos extremos teóricos. Aparecen una y otra vez en los análisis posteriores a los incidentes y conviene conocerlos por su nombre.
Riesgo n.º 1: Vulnerabilidades CVE del núcleo sin parchear

Los parches del núcleo requieren reinicios, y estos se suelen posponer. Un clúster de bases de datos en producción, una pila de enrutamiento de telecomunicaciones, un sistema de procesamiento en tiempo real... Todos ellos tienen motivos de peso para evitar tiempos de inactividad no planificados. Así que los parches se quedan ahí. Para CVE-2022-0847 (Dirty Pipe) se dispuso de parches a los pocos días de su divulgación; sin embargo, muchos sistemas en producción pasaron meses sin aplicarlos porque nadie quería programar los reinicios progresivos.
La CISA añadió recientemente el CVE-2026-31431 (Copy Fail), una vulnerabilidad de escalada de privilegios que permite a cualquier usuario local sin privilegios obtener privilegios de root al corromper la caché de páginas en memoria del núcleo —sin tocar el disco— en su catálogo KEV el 1 de mayo de 2026, lo que da a las agencias federales dos semanas para aplicar el parche. La mayoría de los entornos Linux empresariales no pueden actuar con tanta rapidez a través de los ciclos de parches convencionales. La vulnerabilidad no requiere acceso remoto por sí sola, pero si se combina con algo tan común como credenciales SSH robadas o un proceso de contenedor comprometido, se convierte en una compromisión total de los privilegios de root.
Riesgo n.º 2: SELinux desactivado o mal configurado
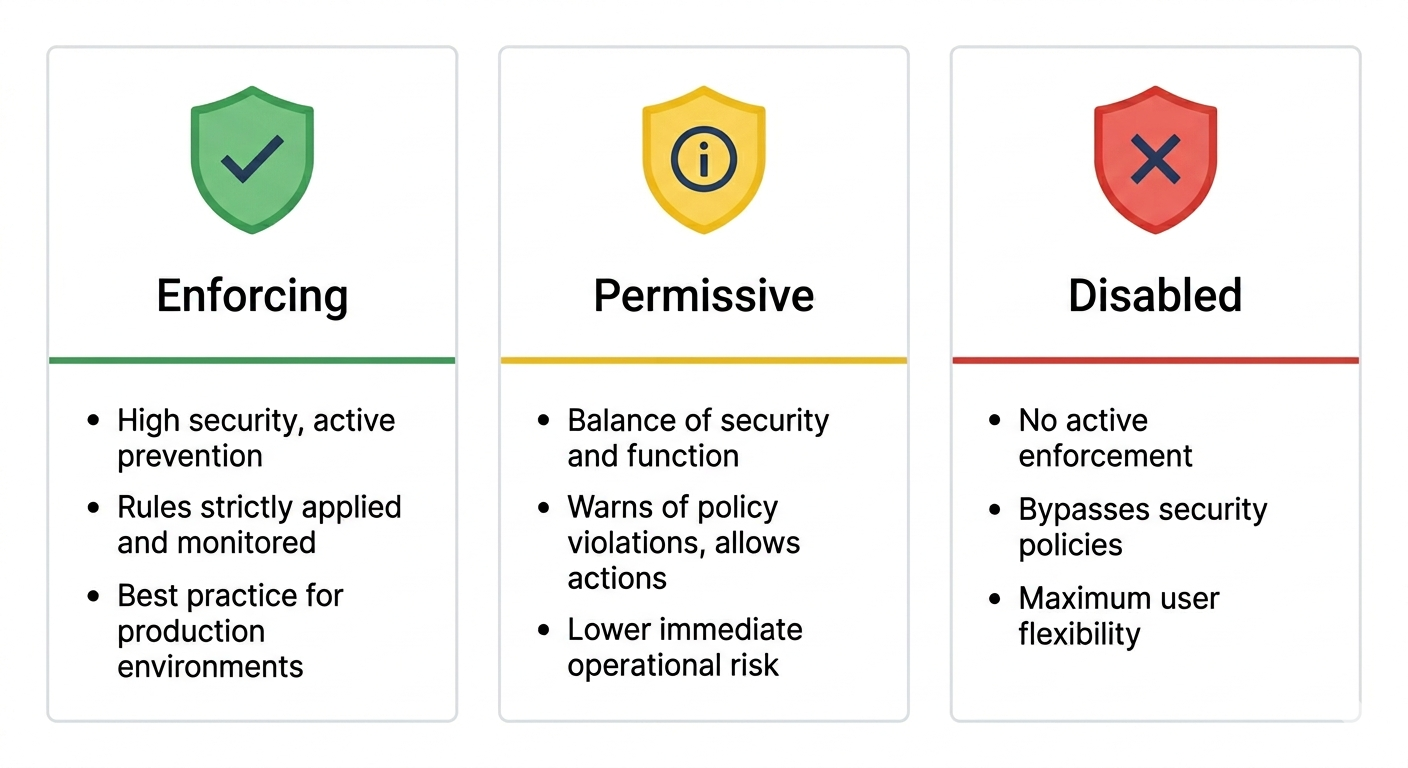
Cuando algo falla en el entorno de producción, setenforce 0 Es la solución más rápida, pero también la peor. SELinux En el modo permisivo se registran las infracciones de las políticas, pero no se bloquea nada, y la frase «lo volveremos a habilitar una vez hayamos diagnosticado el problema» tiende a convertirse en algo permanente. Los módulos de políticas excesivamente amplios son casi igual de perjudiciales: si a un servicio se le conceden más capacidades de las que necesita, una vulneración de ese servicio tendrá un alcance mayor del que debería.
Consejo de experto: Antes de desactivar SELinux para solucionar el problema, cambia temporalmente al modo permisivo con el comando `setenforce 0` y comprueba ausearch -m avc -ts recent para consultar los rechazos recientes. En la mayoría de los casos, el registro de rechazos te indica exactamente qué regla de política debes escribir, y nunca tendrás que salir del modo de aplicación de forma permanente.
Riesgo n.º 3: Sistemas EOL que siguen en funcionamiento en producción
RHEL 7 llegó al final de su ciclo de vida en junio de 2024. Un número considerable de organizaciones sigue utilizándolo: la migración resulta costosa, supone una interrupción de las operaciones y, a menudo, tiene menor prioridad que los problemas más urgentes de este trimestre. Sin un servicio de soporte ampliado, cada vulnerabilidad (CVE) del núcleo y de los paquetes que se revele tras la fecha de fin de vida útil supone una exposición permanente sin parchear. Una vez que finaliza el soporte del proveedor, no hay forma de ponerse al día.
Riesgo n.º 4: Límites de privilegios deficientes
Cuentas de servicio que se ejecutan como root. Archivos «sudoers» con entradas generales del tipo «NOPASSWD». Claves SSH configuradas en 2019 y que nunca se han renovado. No se trata de vectores de ataque sofisticados, sino de fallos básicos que marcan la diferencia entre un servicio comprometido y un host comprometido.
Riesgo n.º 5: Repositorios de terceros no auditados
EPEL, los repositorios RPM de terceros y los servidores espejo de paquetes proporcionados por los proveedores suelen ser necesarios. Pero también son vectores de la cadena de suministro. Un equipo que añade un repositorio para instalar un paquete y nunca revisa qué más se considera ahora de confianza ha ampliado su superficie de ataque sin haberlo decidido conscientemente.
Prácticas recomendadas de seguridad de Red Hat
Las soluciones a los riesgos mencionados no son complicadas. Lo difícil es aplicarlas de forma sistemática en flotas de gran tamaño que se encuentran bajo presión operativa.
Práctica n.º 1: Aplicar parches siguiendo un calendario real
El intervalo entre la disponibilidad de los parches y su implementación es cuando se producen los ataques. Una periodicidad semanal para las actualizaciones de paquetes y una periodicidad mensual para las actualizaciones del núcleo es un mínimo viable para la mayoría de las organizaciones. La decisión es de carácter operativo:
- Si es posible programar reinicios, la aplicación de parches estándar con
dnf updateAdemás, reiniciar Windows no supone ningún problema. - Si los reinicios perturban el funcionamiento, la aplicación de parches sin reinicio es la única solución que permite mantenerse al día con el ritmo de publicación de vulnerabilidades sin poner en riesgo la disponibilidad.
Práctica n.º 2: Modificaciones en tiempo real para el núcleo y las bibliotecas compartidas
La aplicación de parches al núcleo en tiempo real permite aplicar correcciones de CVE a un núcleo en ejecución sin necesidad de reiniciar el sistema. Red Hat ofrece kpatch para algunas ramas del núcleo, pero la cobertura se limita a las versiones actualmente compatibles. KernelCare de TuxCare cubre una gama más amplia de versiones del núcleo de RHEL, incluidas las versiones más antiguas y aquellas que han llegado al final de su ciclo de vida (EOL).
|
Enfoque |
Es necesario reiniciar |
Cobertura |
Lo mejor para |
|
Actualización manual con reinicio |
Sí |
Completo |
Desarrollo/pruebas, sistemas con poco tiempo de actividad |
|
Red Hat kpatch |
No |
Ramas del núcleo limitadas |
Compatible con RHEL estándar |
|
TuxCare KernelCare |
No |
Amplio, incluidos los núcleos EOL |
Producción con un alto nivel de disponibilidad, sistemas al final de su vida útil |
Para obtener un desglose detallado de las diferencias entre KernelCare y kpatch en cuanto a cobertura, núcleos compatibles y capacidad de reversión, consulte la comparación entre KernelCare Enterprise y Red Hat kpatch.
Nota:LibCare amplía la aplicación de parches en tiempo real a bibliotecas compartidas críticas como glibc y OpenSSL , componentes que requieren reiniciar los servicios dependientes cuando se aplican parches de forma convencional. No se trata de un reinicio completo del sistema, pero sí es lo suficientemente disruptivo para cualquier cosa que mantenga conexiones persistentes o el estado de la sesión. Aplicar parches a un OpenSSL en ejecución sin reiniciar los servicios que lo utilizan no es una capacidad trivial, y es importante para entornos con un alto tiempo de actividad.
Práctica n.º 3: Utilizar la priorización de CVE, no solo las listas de CVE
Las cifras brutas de CVE no sirven para tomar medidas. La mayoría de los entornos acumulan cientos de vulnerabilidades reveladas en un momento dado, y tratar todas ellas con la misma urgencia es lo que lleva a los equipos al agotamiento sin que mejoren su nivel de seguridad.
Práctica n.º 4: Mantén SELinux en modo de aplicación
Ejecuta en modo de aplicación. Cuando algo genere un error, investiga el motivo con ausearch y audit2allow en lugar de desactivar la política. Si una regla personalizada es realmente necesaria, redacte un módulo de política específico que se ajuste a las necesidades reales del servicio. Los equipos que mantienen esta disciplina suelen descubrir que los rechazos de SELinux son la primera señal de que algo no funciona correctamente, antes de que cualquier otro sistema de supervisión lo detecte.
Práctica n.º 5: Revisar periódicamente los límites de los privilegios
Las cuentas de servicio deben ejecutarse con los privilegios mínimos que realmente necesitan para funcionar. Las entradas de los usuarios con privilegios «sudo» deben ser específicas, no generales. Las claves SSH deben renovarse según un calendario definido y la autenticación basada en claves debe ser el único método aceptado. Pipe auditd registrar los datos en algún lugar donde se puedan revisar, y configurar AIDE para supervisar la integridad de los archivos en las rutas críticas.
Consejo de experto: Ejecutar sudo -l -U <serviceaccount> para comprobar exactamente qué privilegios tiene una cuenta de servicio concreta. Se trata de una comprobación de 30 segundos que a menudo revela entradas «NOPASSWD» o permisos de comando excesivamente amplios que se han ido acumulando a lo largo de años de modificaciones incrementales en el archivo «sudoers».
Práctica n.º 6: Planifica el final de tu vida antes de que llegue
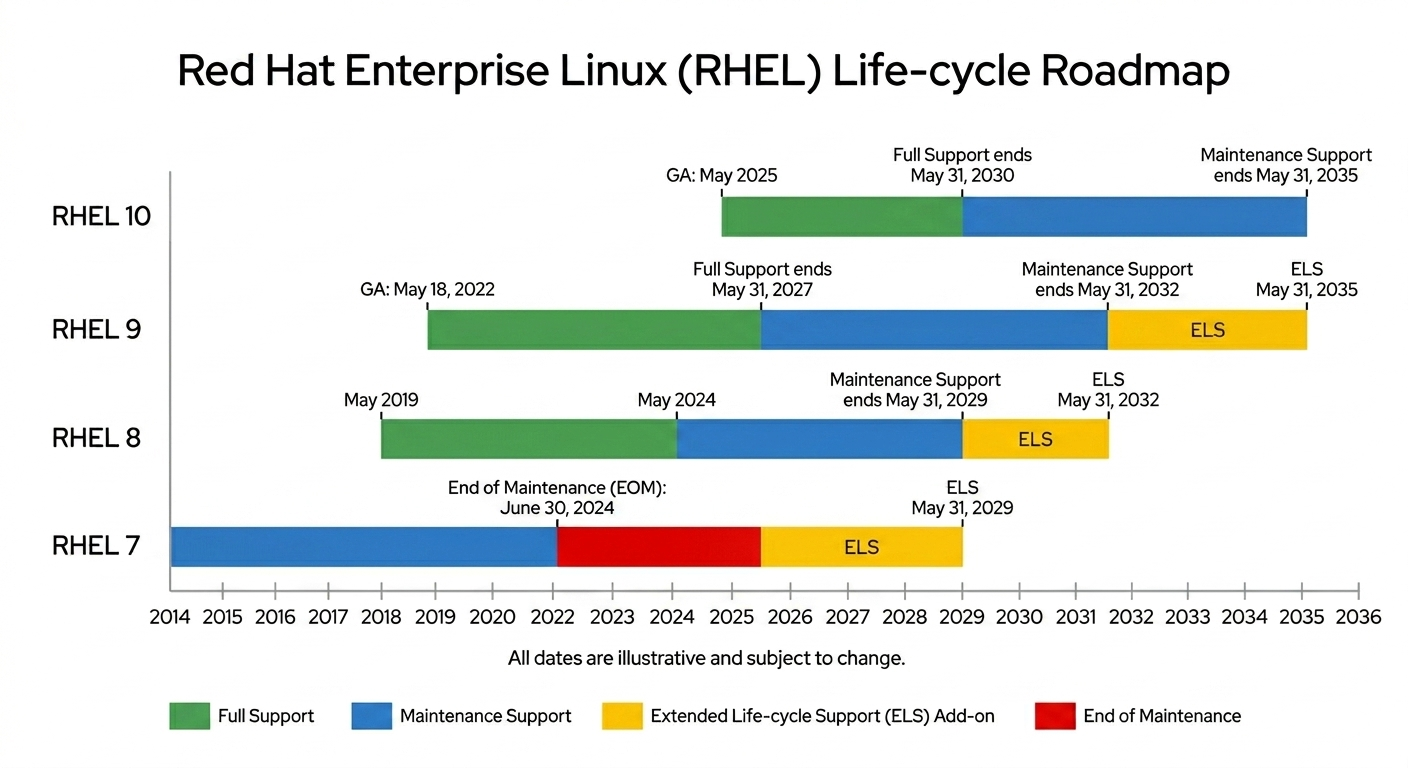
Red Hat publica las fechas del ciclo de vida con años de antelación. El error habitual es considerar la migración como un problema futuro hasta que se convierte en una emergencia actual. Es fundamental conocer los próximos hitos del fin de vida útil (EOL) de RHEL 8, ya que el soporte de mantenimiento finaliza en mayo de 2029; si dispone de un gran parque de sistemas RHEL 8, el reloj ya está en marcha.
- Si la migración a RHEL 9 o 10 es viable antes de que finalice el ciclo de vida del producto, empieza a planificarla ya. «Empezar a planificar con tres meses de antelación» no es tiempo suficiente para una migración real de todo el parque informático.
- Si la migración no es viable en ese plazo, asegúrate de contar con un soporte ampliado antes de que finalice el plazo. El servicio «Endless Lifecycle Support» de TuxCare para RHEL 7 ofrece la aplicación continua de parches para CVE mucho más allá del propio plazo de soporte ampliado de Red Hat, lo cual es importante si tienes pilas de aplicaciones heredadas que no se van a migrar ni este año fiscal ni el próximo.
4 herramientas que refuerzan la seguridad de RHEL
Hay muchas herramientas que prometen mejorar la seguridad de Linux. Estas cuatro, sin embargo, subsanan realmente las vulnerabilidades que realmente importan en entornos RHEL de producción.
TuxCare
TuxCare aborda los dos retos más difíciles en las operaciones de seguridad de RHEL: mantener actualizados los CVE del núcleo y de las bibliotecas compartidas sin necesidad de reiniciar el sistema, y seguir aplicando parches a los sistemas una vez que Red Hat deja de publicar actualizaciones para ellos.
KernelCare aplica correcciones CVE del núcleo a sistemas en funcionamiento en una amplia gama de versiones de RHEL, incluidas las versiones antiguas y aquellas que han llegado al final de su vida útil. LibCare amplía esta funcionalidad a bibliotecas compartidas como glibc y OpenSSL, que también requieren reiniciar los servicios cuando se aplican parches de forma convencional. Juntas, estas dos soluciones subsanan la deficiencia en el aplazamiento del reinicio que afecta a la mayoría de los programas de aplicación de parches de Linux para empresas.
El programa Endless Lifecycle Support (ELS) resulta especialmente relevante para las organizaciones que utilizan RHEL 7. El soporte ampliado de Red Hat abarca un periodo limitado tras el fin de vida útil (EOL) en junio de 2024. La oferta de TuxCare amplía la aplicación de parches para vulnerabilidades CVE más allá de esa fecha, durante todo el tiempo que la organización lo necesite, lo cual es importante cuando el plazo de migración se mide en años en lugar de en trimestres.
OpenSCAP
OpenSCAP es el escáner de cumplimiento que se incluye con RHEL. Funciona con políticas de seguridad en formato SCAP —pautas CIS, STIG de la DISA, perfiles PCI DSS— y genera un informe detallado de las desviaciones de tu sistema. Los informes requieren cierta interpretación y la herramienta no es muy atractiva, pero es la vía más directa para obtener una referencia de cumplimiento real en un parque de servidores RHEL sin incurrir en ningún gasto adicional al que ya estás asumiendo.
Red Hat Insights
Insights es el servicio de análisis predictivo integrado de Red Hat. Analiza los datos de telemetría de los sistemas registrados y detecta vulnerabilidades conocidas, desviaciones en la configuración y problemas de rendimiento. Se incluye en la mayoría de las suscripciones activas a RHEL, lo que significa que los equipos que no lo utilizan están dejando sin usar algo por lo que ya han pagado. La pega es que hay que registrar los sistemas y consultar el panel de control; Insights no sirve de mucho si nadie revisa sus resultados.
Wazuh
Wazuh es una plataforma de código abierto de SIEM y detección de intrusiones en hosts que funciona bien en RHEL. Gestiona la supervisión de la integridad de los archivos, el análisis de registros, la detección de vulnerabilidades y la generación de informes de cumplimiento en una sola solución. Para los equipos que no desean utilizar Splunk o IBM QRadar, Wazuh es una alternativa fiable, aunque con la contrapartida de que ahora son ustedes mismos los responsables de gestionar y mantener el SIEM.
Refuerza la seguridad de Red Hat con TuxCare
Red Hat ofrece una base de seguridad sólida. La diferencia radica en lo que la plataforma ofrece desde el primer día y lo que se necesita para mantener ese nivel de seguridad en un entorno real, a lo largo del tiempo y bajo presión operativa.
Los dos aspectos en los que esta brecha se manifiesta con mayor frecuencia en la seguridad de Red Hat son la periodicidad de la aplicación de parches —en concreto, el problema del aplazamiento del reinicio para las vulnerabilidades (CVE) del núcleo y de las bibliotecas compartidas— y la planificación del ciclo de vida, especialmente lo que ocurre con los sistemas que han alcanzado o se acercan al fin de su vida útil (EOL) sin tener preparada una ruta de migración.
Si tu equipo tiene una lista de reinicios del núcleo aplazados, utiliza RHEL 7 sin contrato de soporte o gestiona un parque de servidores tan grande que los calendarios de aplicación de parches convencionales no pueden seguir el ritmo de las tasas de divulgación, TuxCare ofrece una solución para estas tres situaciones. KernelCare y LibCare cubren la brecha de reinicio. El soporte de ciclo de vida ilimitado amplía la cobertura de CVE más allá del fin de vida útil (EOL).