Suporte Técnico
 Documentação
 Entrar
 Entre em contato conosco


Vá direto para um resumo gerado por IA desta postagem do blog 


Principais conclusões
- As defesas do RHEL constituem um sólido ponto de partida para a segurança da Red Hat, mas nada disso se sustenta sem a aplicação ativa de patches, ciclos de auditoria e disciplina no gerenciamento do ciclo de vida.
- A execução do RHEL 7 ou de qualquer versão cujo ciclo de vida tenha chegado ao fim (EOL) sem um plano de suporte estendido gera riscos em auditorias e falhas de conformidade.
- A aplicação de patches em tempo real permite aplicar correções de CVE no kernel a sistemas em execução sem a necessidade de reinicialização – o KernelCare da TuxCare faz isso em todas as principais versões do RHEL.
A maioria das equipes que utilizam o Red Hat Enterprise Linux parte do princípio de que sua postura de segurança é sólida, pois a Red Hat possui uma reputação sólida. A plataforma vem com o SELinux ativado, pacotes assinados e um processo maduro de divulgação de vulnerabilidades. Essa reputação é merecida.
Mas isso leva a um modo específico de falha na segurança da Red Hat: presumir que a plataforma está fazendo o trabalho, quando, na verdade, o trabalho real — aplicação de correções de vulnerabilidades, planejamento do ciclo de vida e práticas adequadas de auditoria — recai sobre a equipe que a opera.
Veja como isso funciona na prática. Um CVE do kernel do Linux é divulgado numa terça-feira. O patch fica disponível na sexta-feira. Sua próxima janela de manutenção está marcada para daqui a 18 dias. Um invasor que tenha conhecimento desse CVE passa a ter uma janela de 18 dias para atacar seus sistemas. Isso não é uma hipótese — é o dia a dia da segurança do Linux corporativo, e é por isso que a frequência de aplicação de patches é tão importante quanto a disponibilidade deles.
Como funciona, na prática, a segurança da Red Hat
A arquitetura de segurança do RHEL é estruturada em camadas, o que constitui tanto seu ponto forte quanto a razão pela qual sua manutenção exige um trabalho ativo, em vez de uma confiança passiva.
No nível do kernel, SELinux impõe um controle de acesso obrigatório — o que significa que nem mesmo um processo comprometido consegue acessar recursos fora da política aplicada a ele. Essa é uma proteção significativa quando configurada corretamente e totalmente inútil quando alguém executa setenforce 0 durante um incidente e nunca o reverte. Além disso, o controle de acesso baseado em funções gerencia os limites de identidade e privilégios. E ainda, a infraestrutura de atualizações assinadas da Red Hat e sua Vulnerabilidade no Linux O feed de rastreamento oferece um fluxo confiável de CVEs e patches cuja proveniência você pode confiar.
O problema é que nada disso se mantém por si só. O RHEL é seguro desde o primeiro dia. Se ele permanecer assim depende inteiramente do que sua equipe fizer depois. Um sistema RHEL 7 que foi devidamente fortificado em 2020 e não recebeu patches desde meados de 2024 acumula anos de CVEs não corrigidos no kernel e no espaço do usuário. O projeto original não oferece proteção contra vulnerabilidades divulgadas após a aplicação do último patch.
Para equipes que ainda utilizam o RHEL 7 após o fim do suporte (EOL) em junho de 2024, o Endless Lifecycle Support da TuxCare é uma das únicas maneiras de continuar recebendo correções de vulnerabilidades (CVEs) sem ser forçado a realizar uma migração que talvez ainda não seja viável do ponto de vista operacional.
Por que a segurança da Red Hat é importante
O RHEL costuma ser utilizado na infraestrutura que, embora pareça monótona, é essencial. Os bancos o utilizam para a liquidação de transações. As operadoras de telecomunicações o empregam para o roteamento. Os hospitais operam sistemas de prontuários eletrônicos (EHR) nele. Quando grandes companhias aéreas e instituições financeiras listam suas pilhas de tecnologia, o RHEL geralmente ocupa uma posição central e de suporte. Isso significa que a superfície de ataque é ampla e o alcance de uma violação é significativo.
Os ataques direcionados ao Linux cresceram significativamente nos últimos anos. Grupos de ransomware e agentes de ameaças ligados a governos mudaram o foco dos terminais Windows para os servidores Linux, onde, na verdade, residem as cargas de trabalho de alto valor. O backdoor 2024 XZ Utils (CVE-2024-3094) foi um caso que por pouco não afetou uma parcela substancial das distribuições derivadas do RHEL, caso tivesse chegado a uma versão estável. Ele foi detectado. O próximo pode não ser.
A conformidade acrescenta um nível adicional de urgência. HIPAA, PCI DSS, GDPR e SOC 2 compartilham uma mesma premissa: você está executando um software que ainda recebe atualizações de segurança do fornecedor. No momento em que um sistema chega ao fim da vida útil (EOL) sem um acordo de suporte estendido, essa premissa deixa de se aplicar — e os auditores percebem isso. “O sistema funciona bem” não é um argumento válido em termos de conformidade. Para entender melhor o que isso significa operacionalmente, veja o que o fim da vida útil (EOL) do RHEL 7 significa para a sua empresa.
Riscos comuns de segurança no RHEL
Os riscos abaixo não são casos extremos teóricos. Eles aparecem repetidamente nas análises pós-incidente e vale a pena conhecê-los pelo nome.
Risco nº 1: Vulnerabilidades (CVEs) no kernel sem correção

Os patches do kernel exigem reinicializações, e essas reinicializações acabam sendo adiadas. Um cluster de bancos de dados em produção, uma pilha de roteamento de telecomunicações, um sistema de processamento em tempo real — todos eles têm motivos legítimos para evitar tempo de inatividade não planejado. Assim, os patches ficam parados. O CVE-2022-0847 (Dirty Pipe) teve patches disponíveis poucos dias após a divulgação; muitos sistemas em produção passaram meses sem aplicá-los porque ninguém queria agendar as reinicializações progressivas.
A CISA adicionou recentemente o CVE-2026-31431 (Copy Fail), uma falha de escalonamento de privilégios que permite que qualquer usuário local sem privilégios obtenha acesso root ao corromper o cache de páginas na memória do kernel — sem acessar o disco — em seu catálogo KEV em 1º de maio de 2026, dando às agências federais duas semanas para aplicar a correção. A maioria dos ambientes Linux corporativos não consegue agir tão rapidamente por meio dos ciclos convencionais de correção. A falha, por si só, não requer acesso remoto, mas, quando combinada com algo tão comum quanto credenciais SSH roubadas ou um processo de contêiner comprometido, ela se transforma em um comprometimento total dos privilégios de root.
Risco nº 2: SELinux desativado ou mal configurado
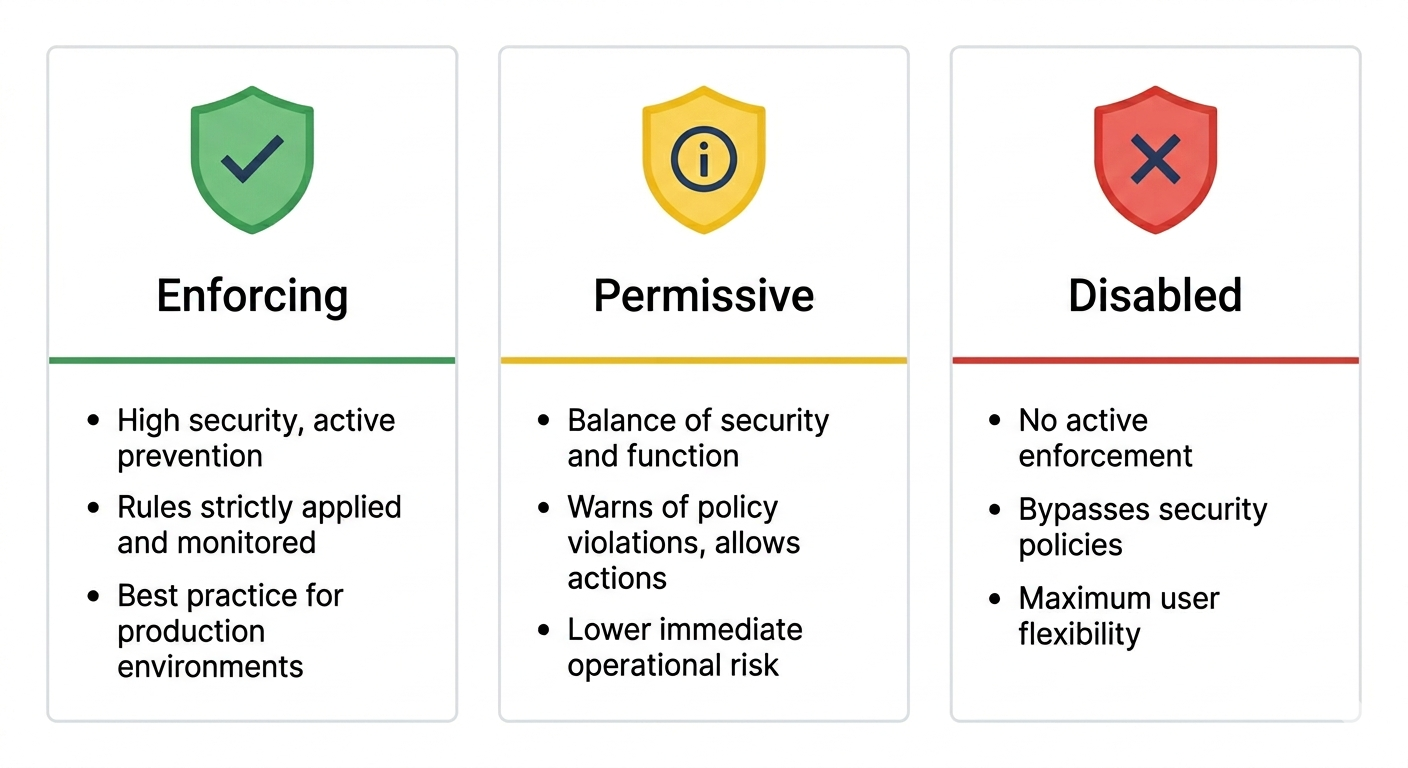
Quando algo dá errado no ambiente de produção, setenforce 0 é a solução mais rápida, mas também a pior. SELinux No modo permissivo, as violações da política são registradas, mas nada é bloqueado, e a frase “vamos reativá-la depois de diagnosticarmos o problema” costuma acabar se tornando permanente. Módulos de política excessivamente amplos são quase tão ruins quanto — se um serviço receber mais recursos do que o necessário, uma violação desse serviço terá um alcance maior do que deveria.
Dica profissional: Antes de desativar o SELinux para solucionar problemas, alterne temporariamente para o modo permissivo com o comando `setenforce 0` e verifique ausearch -m avc -ts recent para consultar as recusas recentes. Na maioria dos casos, o registro de recusas indica exatamente qual regra de política deve ser definida – e você nunca precisa sair do modo de aplicação de forma definitiva.
Risco nº 3: Sistemas em fim de vida útil (EOL) ainda em operação na produção
O RHEL 7 chegou ao fim da vida útil em junho de 2024. Um número significativo de organizações ainda o utiliza — a migração é cara, causa interrupções e, muitas vezes, tem prioridade menor do que as questões mais urgentes deste trimestre. Sem um serviço de suporte estendido, cada vulnerabilidade (CVE) do kernel e dos pacotes divulgada após a data de fim de vida útil representa uma exposição permanente sem correção. Não há como recuperar o atraso depois que o suporte do fornecedor termina.
Risco nº 4: Limites de privilégios fracos
Contas de serviço executadas como root. Arquivos “sudoers” com entradas genéricas do tipo NOPASSWD. Chaves SSH configuradas em 2019 e que nunca foram atualizadas. Esses não são vetores de ataque sofisticados — são falhas básicas que fazem a diferença entre um serviço comprometido e um host comprometido.
Risco nº 5: Repositórios de terceiros não auditados
O EPEL, repositórios RPM de terceiros e espelhos de pacotes fornecidos por fornecedores costumam ser necessários. Eles também são vetores da cadeia de suprimentos. Uma equipe que adiciona um repositório para instalar um pacote e nunca verifica o que mais passou a ser considerado confiável acaba ampliando sua superfície de ataque sem ter tomado uma decisão consciente nesse sentido.
Melhores práticas de segurança da Red Hat
As soluções para os riscos acima não são complicadas. O difícil é aplicá-las de forma consistente em grandes frotas sob pressão operacional.
Prática nº 1: Aplicar patches seguindo um cronograma real
É no intervalo entre a disponibilidade da correção e sua implantação que ocorrem as explorações. Uma frequência semanal para atualizações de pacotes e uma frequência mensal para atualizações do kernel constituem um padrão mínimo viável para a maioria das organizações. O ponto de decisão é operacional:
- Se for possível realizar reinicializações programadas – aplicação padrão de patches com
dnf updateAlém disso, reiniciar o Windows não é problema. - Se as reinicializações causam interrupções operacionais, a aplicação de patches sem reinicialização é a única abordagem que acompanha o ritmo das divulgações de vulnerabilidades sem criar riscos à disponibilidade.
Prática nº 2: Ajustes em tempo real no kernel e nas bibliotecas compartilhadas
A aplicação de patches no kernel em tempo real aplica correções de CVE a um kernel em execução sem a necessidade de reinicialização. A Red Hat fornece o kpatch para alguns ramos do kernel, mas a cobertura se limita às versões atualmente suportadas. O KernelCare da TuxCare abrange uma gama mais ampla de versões do kernel do RHEL, incluindo versões mais antigas e aquelas em fim de vida útil (EOL).
|
Abordagem |
É necessário reiniciar o sistema |
Cobertura |
Ideal para |
|
Aplicação manual de patches com reinicialização |
Sim |
Completo |
Sistemas de desenvolvimento/teste, com baixo tempo de atividade |
|
Red Hat kpatch |
Não |
Ramos limitados do kernel |
RHEL com suporte padrão |
|
TuxCare KernelCare |
Não |
Amplo, incluindo kernels em fim de vida útil |
Produção com alto tempo de atividade, sistemas em fim de vida útil |
Para uma análise detalhada comparativa entre o KernelCare e o kpatch em termos de cobertura, kernels compatíveis e capacidade de reversão, consulte “Comparando o KernelCare Enterprise com o Red Hat kpatch”.
Observação:O LibCare amplia a aplicação de patches em tempo real para bibliotecas compartilhadas críticas, como glibc e OpenSSL – componentes que exigem a reinicialização dos serviços dependentes quando atualizados de forma convencional. Não se trata de uma reinicialização completa do sistema, mas ainda assim é perturbador o suficiente para qualquer processo que mantenha conexões persistentes ou estado de sessão. Aplicar correções em um OpenSSL em execução sem reiniciar os serviços que o utilizam não é uma capacidade trivial, e isso é importante para ambientes que exigem alto tempo de atividade.
Prática nº 3: Use a priorização de CVEs, não apenas as listas de CVEs
Os números brutos de CVEs não são úteis para a tomada de decisões. A maioria dos ambientes acumula centenas de vulnerabilidades divulgadas a qualquer momento, e tratar todas elas com a mesma urgência é o que leva as equipes ao esgotamento, sem que consigam melhorar sua postura de segurança.
Prática nº 4: Mantenha o SELinux no modo “Enforcing”
Execute no modo de imposição. Quando algo gerar uma recusa, investigue o caso com ausearch e audit2allow em vez de desativar a política. Se uma regra personalizada for realmente necessária, crie um módulo de política específico, limitado ao que o serviço realmente precisa. As equipes que mantêm essa disciplina costumam perceber que as recusas do SELinux são o primeiro sinal de que algo está funcionando mal — antes que qualquer outro sistema de monitoramento detecte o problema.
Prática nº 5: Auditar regularmente os limites de privilégios
As contas de serviço devem ser executadas com o mínimo de privilégios de que realmente precisam para funcionar. As entradas no arquivo `sudoers` devem ser específicas, e não genéricas. As chaves SSH devem ser renovadas de acordo com um cronograma definido, e a autenticação baseada em chave deve ser o único método aceito. Pipe auditd registrar em algum lugar que seja revisado e configurar o AIDE para monitorar a integridade dos arquivos em caminhos críticos.
Dica profissional: Correr sudo -l -U <serviceaccount> para verificar exatamente quais privilégios uma determinada conta de serviço possui. É uma verificação de 30 segundos que, muitas vezes, revela entradas “NOPASSWD” ou concessões de comandos excessivamente amplas que se acumularam ao longo de anos de edições incrementais no arquivo `sudoers`.
Prática nº 6: Planeje o fim da vida antes que ele chegue
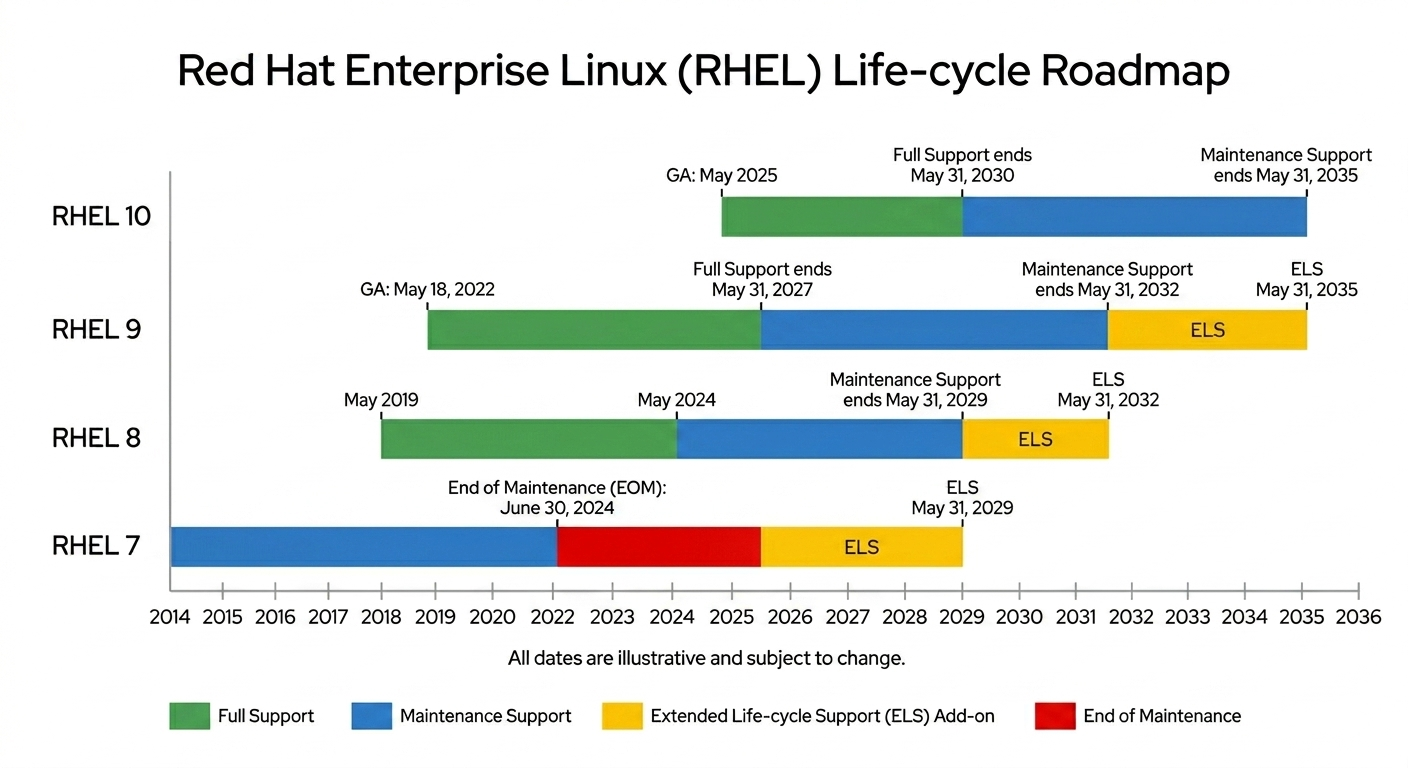
A Red Hat divulga as datas do ciclo de vida com anos de antecedência. O erro comum é tratar a migração como um problema futuro, até que ela se torne uma emergência imediata. É fundamental compreender os próximos marcos para o fim do ciclo de vida (EOL) do RHEL 8, já que o suporte de manutenção termina em maio de 2029 — se você possui um grande parque de sistemas RHEL 8, o prazo já está correndo.
- Se a migração para o RHEL 9 ou 10 for viável antes do fim da vida útil (EOL) – comece a planejar agora. “Começar a planejar com três meses de antecedência” não é tempo suficiente para uma migração real de todo o parque de servidores.
- Se a migração não for viável dentro desse prazo, providencie um suporte estendido antes do prazo final. O Suporte de Ciclo de Vida Ilimitado da TuxCare para o RHEL 7 oferece a aplicação contínua de patches para CVEs muito além do próprio período de suporte estendido da Red Hat, o que é importante se você tiver pilhas de aplicativos legadas que não serão migradas neste ano fiscal nem no próximo.
4 ferramentas que reforçam a segurança do RHEL
Muitas ferramentas afirmam melhorar a segurança do Linux. Essas quatro, no entanto, realmente preenchem lacunas importantes em ambientes RHEL de produção.
TuxCare
O TuxCare resolve os dois maiores desafios nas operações de segurança do RHEL: manter as vulnerabilidades (CVEs) do kernel e das bibliotecas compartilhadas corrigidas sem a necessidade de reinicialização e continuar a aplicar correções nos sistemas mesmo depois que a Red Hat deixar de lançar atualizações para eles.
O KernelCare aplica correções CVE do kernel a sistemas em execução em uma ampla gama de versões do RHEL, incluindo versões mais antigas e aquelas em fim de vida útil (EOL). O LibCare estende isso a bibliotecas compartilhadas, como a glibc e o OpenSSL, que também exigem a reinicialização dos serviços quando atualizadas de forma convencional. Juntos, esses dois ferramentas eliminam a lacuna no adiamento da reinicialização que afeta a maioria dos programas de aplicação de patches para Linux corporativo.
O programa Endless Lifecycle Support (ELS) é particularmente relevante para organizações que utilizam o RHEL 7. O suporte estendido oferecido pela própria Red Hat abrange um período limitado após o fim do ciclo de vida (EOL), previsto para junho de 2024. A oferta da TuxCare estende a aplicação de patches para vulnerabilidades CVE além desse prazo, pelo tempo que a organização precisar — o que é importante quando o cronograma de migração é medido em anos, e não em trimestres.
OpenSCAP
O OpenSCAP é o verificador de conformidade que vem integrado ao RHEL. Ele opera com base em políticas de segurança no formato SCAP — padrões CIS, STIGs da DISA, perfis PCI DSS — e gera um relatório detalhado indicando onde o seu sistema apresenta desvios. Os relatórios exigem alguma interpretação e a ferramenta não é nada sofisticada, mas é o caminho mais direto para se obter uma linha de base de conformidade real em um parque de servidores RHEL, sem gastar nada além do que você já está pagando.
Red Hat Insights
O Insights é o serviço de análise preditiva integrado da Red Hat. Ele analisa dados de telemetria de sistemas registrados e identifica vulnerabilidades conhecidas, desvios de configuração e problemas de desempenho. Ele está incluído na maioria das assinaturas ativas do RHEL, o que significa que as equipes que não o estão utilizando estão deixando de usar algo pelo qual já pagaram. O problema é que é preciso registrar os sistemas e realmente consultar o painel de controle — o Insights não adianta muito se ninguém analisar suas descobertas.
Wazuh
O Wazuh é uma plataforma SIEM de código aberto e de detecção de intrusão em hosts que funciona bem no RHEL. Ele lida com monitoramento de integridade de arquivos, análise de logs, detecção de vulnerabilidades e geração de relatórios de conformidade em uma única pilha. Para equipes que não desejam utilizar o Splunk ou o IBM QRadar, o Wazuh é uma alternativa confiável — com a contrapartida de que agora você é responsável por operar e manter o SIEM por conta própria.
Reforce a segurança da Red Hat com a TuxCare
A Red Hat oferece uma base sólida de segurança. A lacuna está entre o que a plataforma oferece desde o início e o que é necessário para manter essa postura em um parque de máquinas real, ao longo do tempo e sob pressão operacional.
Os dois pontos em que essa lacuna se manifesta com mais frequência na segurança da Red Hat são a frequência de aplicação de patches — especificamente o problema do adiamento da reinicialização para CVEs do kernel e de bibliotecas compartilhadas — e o planejamento do ciclo de vida, mais precisamente o que acontece com os sistemas que atingiram ou estão se aproximando do fim da vida útil (EOL) sem um plano de migração pronto.
Se sua equipe está lidando com uma fila de reinicializações do kernel adiadas, executando o RHEL 7 sem um contrato de suporte ou gerenciando um parque de máquinas tão grande que os cronogramas convencionais de aplicação de patches não conseguem acompanhar o ritmo das divulgações de vulnerabilidades, a TuxCare resolve todas essas três situações. O KernelCare e o LibCare eliminam a lacuna de reinicialização. O Suporte de Ciclo de Vida Ilimitado estende a cobertura de CVEs além do fim da vida útil (EOL).