Support technique
 Documentation
 Connexion
 Nous contacter


Accédez directement au résumé généré par l'IA de cet article de blog 


Principaux enseignements
- La surveillance de Linux est essentielle pour garantir les performances, la sécurité, la disponibilité et la conformité des charges de travail.
- Utilisez des outils tels que htop, Netdata et Prometheus pour suivre l'évolution du processeur, de la mémoire, des entrées/sorties du disque, de l'activité du réseau et de l'état général du système.
- La surveillance n'est que la moitié de l'équation. solutions de correctifs sans redémarrage comme KernelCare pour réduire les temps d'arrêt et combler les lacunes en matière de sécurité.
La surveillance des serveurs Linux s'accompagne d'un ensemble unique de défis, que vous ne rencontrerez peut-être pas avec d'autres systèmes d'exploitation. Elle requiert un niveau plus élevé de compétences techniques. Les administrateurs se retrouveront à configurer et à rédiger des scripts pour que leurs systèmes atteignent des spécifications optimales.
Le processus peut sembler intimidant au début. Bien qu'il y ait une courbe d'apprentissage, vous pouvez surmonter la plupart des obstacles en maîtrisant les concepts fondamentaux et en tirant parti des techniques d'automatisation courantes. Vous irez loin en répétant et en maîtrisant les principes de base.
Cependant, pour maintenir les serveurs en parfait état 24 heures sur 24 et 7 jours sur 7, il faut plus qu'une simple surveillance de base ; il faut des stratégies complètes pour une sécurité continue, une maintenance proactive et des mises à jour sans faille. Ce guide explore ces aspects essentiels.
L'importance de la surveillance de Linux
La surveillance de vos systèmes Linux est essentielle pour maintenir la stabilité, les performances et la sécurité de Linux, en particulier dans les environnements modernes et toujours actifs.
Voici pourquoi la surveillance de Linux est essentielle en 2026 :

- Performance : Détectez une utilisation élevée de l'unité centrale, de la mémoire, du disque ou du réseau avant qu'elle n'affecte les utilisateurs.
- Sécurité : Identifiez rapidement les processus inhabituels, les échecs de connexion ou les comportements suspects.
- Conformité : Maintenir des pistes d'audit et répondre aux exigences réglementaires ou sectorielles.
- Disponibilité : Prévenir les pannes et réduire le temps moyen de rétablissement (MTTR).
- Efficacité : Optimiser les ressources, éviter le surapprovisionnement et rationaliser les opérations.
Les véritables défis de la surveillance des systèmes Linux
Le système d'exploitation Linux vous offre un contrôle et une flexibilité incroyables, mais garder un œil sur les systèmes modernes n'est pas aussi simple que d'exécuter quelques commandes. La maîtrise de ce paysage dynamique, où les problèmes peuvent se cacher à la vue de tous, est la clé d'une surveillance efficace.
La prolifération des outils et l'intégration
L'écosystème Linux regorge d'outils de surveillance, depuis les utilitaires légers en ligne de commande jusqu'aux plates-formes d'entreprise complètes. Mais plus d'options ne signifie pas toujours une meilleure visibilité.
Le défi consiste à sélectionner la bonne combinaison de solutions de surveillance, à intégrer des sources de données disparates et à construire une vue unifiée sans créer une prolifération d'outils ou des silos de données qui compliquent l'analyse et l'alerte.
Environnements dynamiques et distribués
Les déploiements Linux modernes impliquent souvent de vastes infrastructures distribuées avec des composants éphémères tels que des conteneurs et des microservices. La surveillance de ces instances hautement dynamiques et éphémères et de ces charges de travail éphémères représente un défi de taille, nécessitant des stratégies avancées pour suivre les performances, allouer les ressources et garantir la visibilité sur une infrastructure informatique en constante évolution.
Alerte Fatigue et bruit
Compte tenu du volume considérable de mesures disponibles, la génération d'un trop grand nombre d'alertes ou de faux positifs constitue un écueil courant. Cela conduit à une fatigue des alertes, où les avertissements critiques se perdent dans le bruit.
Les administrateurs système sont confrontés au défi d'affiner les seuils et de construire des systèmes d'alerte intelligents qui fournissent des notifications opportunes et pertinentes sans submerger les équipes.
Analyse des causes profondes
Un pic soudain du processeur peut signifier une douzaine de choses différentes : un processus qui s'emballe, un verrou de base de données ou même un goulot d'étranglement caché dans le réseau. Dans les piles Linux complexes, les symptômes pointent rarement directement vers le problème. Le défi consiste à rassembler les indices des journaux, des mesures et des traces pour trouver le véritable problème. Sans les bons outils de surveillance, vous êtes obligé de jouer au détective au lieu de résoudre les problèmes.
Visibilité de la sécurité et menaces
La surveillance de la sécurité ne consiste pas seulement à détecter les menaces connues, mais aussi à identifier les comportements anormaux, les accès non autorisés et les processus suspects.
Le défi consiste à passer au crible de vastes journaux et données système pour repérer les indicateurs subtils de compromission, maintenir des pistes d'audit et assurer une conformité continue dans un paysage de menaces en constante évolution.
Frais généraux de maintenance et temps d'arrêt
La surveillance permet d'identifier les vulnérabilités de Linux, mais les corriger en toute sécurité est un autre défi. Les redémarrages pendant les mises à jour du noyau entraînent toujours des temps d'arrêt. En l'absence de correctifs sans redémarrage, la maintenance devient un risque opérationnel récurrent. Assurer une haute disponibilité pendant ces procédures nécessaires et minimiser le risque de redémarrage et de temps d'arrêt est un exercice d'équilibre permanent pour les administrateurs.
Principales mesures à suivre sur les serveurs Linux
Une surveillance efficace de Linux repose également sur le suivi des bons indicateurs. Vous trouverez ci-dessous les mesures les plus importantes concernant le processeur, la mémoire, le disque, le réseau et la santé du système, qui sont essentielles à la détection précoce des problèmes et au maintien du temps de fonctionnement.
1. Utilisation de l'unité centrale
- Permet de connaître la puissance de traitement utilisée.
- Surveillez l'unité centrale de l'utilisateur par rapport à celle du système, le temps d'inactivité et l'iowait.
- Outils utiles : top, htop, mpstat.
- Un niveau élevé d'iowait signale souvent des goulets d'étranglement sous-jacents au niveau des E/S du disque, et pas seulement une surcharge de l'unité centrale.
2. Utilisation de la mémoire
- Mesure l'utilisation de la mémoire vive, de la mémoire libre et de l'espace de pagination.
- Surveiller les erreurs de page et la consommation de la mémoire tampon/du cache.
- Outils : free, vmstat, sar, smem.
- L'utilisation excessive de l'espace de pagination est un indicateur important de la pression exercée sur la mémoire, ce qui entraîne une dégradation significative des performances.
3. Entrées/sorties de disque
- Suivi de la vitesse de lecture/écriture, de l'IOPS et du temps d'attente E/S
- Utiliser iostat, iotop ou dstat pour la surveillance des disques.
- Une latence élevée des E/S a souvent un impact sur les performances de l'application en premier lieu
4. Débit et erreurs du réseau
- Surveillance réseau des taux RX/TX, des paquets abandonnés et des états de connexion.
- Outils : ifstat, ss, netstat, nload, vnstat.
- Indispensable pour détecter la saturation de la bande passante, la perte de paquets, les goulets d'étranglement du réseau ou les attaques DDoS potentielles.
5. Moyenne de la charge
- Indique le nombre moyen de processus en attente de temps CPU.
- Contrôler les moyennes sur 1, 5 et 15 minutes.
- Outils : uptime, top.
- Une charge soutenue supérieure au nombre de cœurs de l'unité centrale signifie souvent une surcharge du système.
6. Disponibilité
- Suivre le temps de démarrage du système, la durée de fonctionnement et les redémarrages inattendus.
- Outils : uptime, who -b, dernier redémarrage.
- Il est essentiel de respecter les accords de niveau de service, de suivre la fiabilité du système et de planifier la maintenance pour assurer la continuité de l'activité.
7. Utilisation du système de fichiers
- Surveillez l'espace disque, l'utilisation des inodes et la capacité des points de montage.
- Outils : df -h, du -sh, ncdu.
- Des disques pleins peuvent entraîner des échecs d'écriture, des pannes d'application et des interruptions de la journalisation.
8. Santé des processus et des services
- Vérifier si les processus critiques sont en cours d'exécution et consomment les ressources prévues.
- Outils : ps, pidstat, systemctl status.
- Critique pour alerter sur les défaillances de service, les arrêts inattendus ou les processus zombies.
Meilleurs outils pour la surveillance de Linux
Vous trouverez ci-dessous quelques-uns des meilleurs outils de surveillance Linux à prendre en considération, qu'il s'agisse d'utilitaires en ligne de commande ou de plates-formes d'entreprise. Chaque outil présente des avantages et des inconvénients différents, qui détermineront dans quelle mesure il convient aux besoins uniques de votre équipe en matière de surveillance.
htop
Utilitaire interactif de ligne de commande amélioré, htop fournit une vue en temps réel du CPU, de la mémoire, du swap, des arborescences de processus et des moyennes de charge.

Pour :
- Interface conviviale avec code couleur pour une navigation aisée.
- Idéal pour des contrôles rapides et interactifs des ressources et des processus.
- Léger et largement disponible sur la plupart des distributions Linux.
Cons :
- Absence de suivi des données historiques.
- Principalement pour un serveur unique, des informations en temps réel.
btop
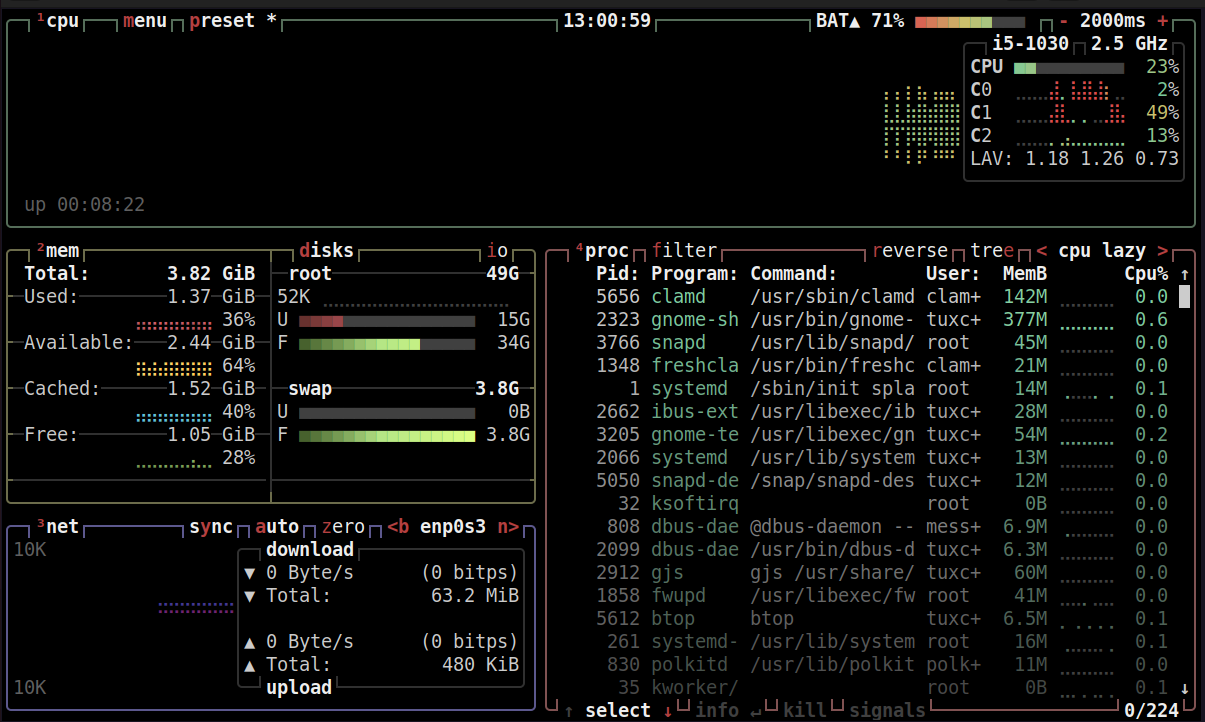
Moniteur système visuellement impressionnant et riche en fonctionnalités, btop (et ses prédécesseurs tels que bashtop/bpytop) offre un aperçu en temps réel de l'activité du processeur, de la mémoire vive, du disque et du réseau par le biais d'une interface terminale attrayante.
Pour :
- Interface utilisateur moderne, très réactive, avec prise en charge de la souris et personnalisation poussée.
- Fournit des mesures plus détaillées et une meilleure visualisation que htop dans un terminal.
- Excellent pour la surveillance interactive locale ou basée sur SSH.
Cons :
- Sa richesse visuelle peut consommer un peu plus de ressources que des outils CLI plus simples.
- Moins idéal pour les scripts purs ou les agents distants disposant de très peu de ressources et n'ayant besoin que d'un texte brut.
iotop
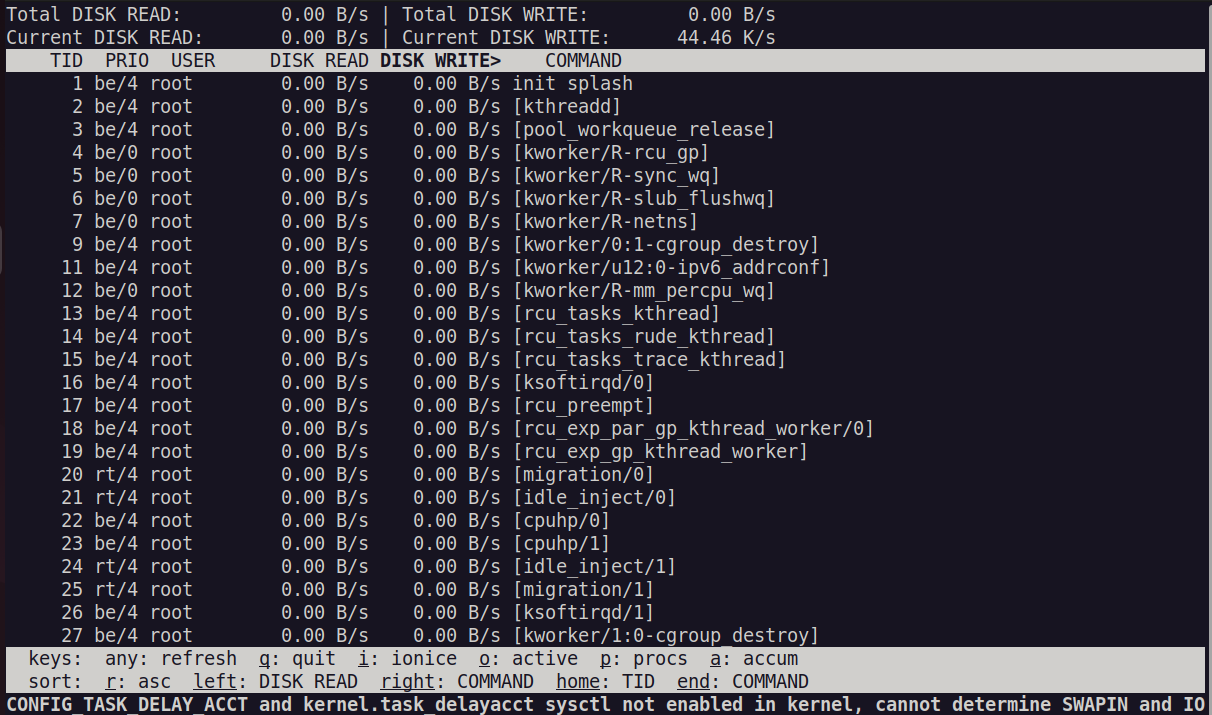
iotop est un utilitaire en ligne de commande spécialement conçu pour suivre l'utilisation des E/S disque par processus. Il est très utile pour identifier en temps réel les processus qui provoquent des goulets d'étranglement sur le disque, ce qui en fait un outil de choix en cas de ralentissement des performances.
Pour :
- Fournit des statistiques en temps réel sur les entrées/sorties de disque par processus.
- Excellent pour identifier les applications ou processus spécifiques à l'origine des goulets d'étranglement sur les disques.
- Simple et direct pour un dépannage immédiat.
Cons :
- L'exécution de ce programme nécessite généralement les privilèges de l'administrateur (root).
- Se concentre uniquement sur les E/S de disque et n'est pas un moniteur système complet.
Netdata
Netdata est un agent de surveillance haute fidélité en temps réel qui fournit des informations instantanées sur des centaines de paramètres du système via des tableaux de bord web interactifs et des alertes de santé.

Pour :
- Extrêmement léger, il se configure automatiquement et ne nécessite pratiquement aucune maintenance.
- Offre une granularité profonde, à la seconde près, pour un dépannage immédiat.
- L'interface web interactive est accessible à partir de n'importe quel navigateur.
- L'architecture distribuée permet des déploiements d'entreprise évolutifs.
Cons :
- Nécessite un navigateur web pour ses tableaux de bord, ce qui n'est pas idéal pour les environnements purement CLI.
- Peut nécessiter plus de réflexion pour la conservation des données à long terme par rapport aux bases de données de séries temporelles dédiées.
Prometheus + Grafana
Cette combinaison puissante s'appuie sur Prometheus pour récupérer et stocker des métriques de séries temporelles, tandis que Grafana fournit une visualisation robuste grâce à des tableaux de bord personnalisables et des alertes intégrées.

Pour :
- Hautement évolutif, flexible et piloté par des alertes pour les environnements complexes.
- Idéal pour les infrastructures Linux cloud-natives, microservices et hybrides.
- Vaste écosystème d'exportateurs pour divers services et applications.
- Source ouverte avec un soutien important de la part de la communauté.
Cons :
- Nécessite une configuration initiale de Prometheus et de Grafana.
- Nécessite des "exportateurs" dédiés (comme node_exporter) installés sur les systèmes cibles.
- La courbe d'apprentissage peut être plus raide pour les débutants en raison de sa nature distribuée.
Zabbix
Zabbix est une solution complète de surveillance d'entreprise capable de superviser les serveurs Linux, les applications, les périphériques réseau et les machines virtuelles.

Pour :
- Fort en suivi historique, en alertes avancées et en tableaux de bord flexibles.
- Fournit des agents intégrés et un support SNMP pour une large compatibilité.
- Console de gestion centralisée pour les environnements à grande échelle.
- Système de modèles étendu pour une surveillance cohérente sur de nombreux hôtes.
Cons :
- La courbe d'apprentissage est plus raide que celle des outils plus simples, en particulier pour l'installation initiale et les configurations complexes.
- Les besoins en ressources du serveur Zabbix peuvent être plus élevés pour les déploiements très importants.
Meilleures pratiques et techniques de surveillance pour les administrateurs de systèmes Linux
Une surveillance efficace du système Linux ne se limite pas à une simple réaction aux alertes ; elle nécessite une approche proactive et stratégique. En adoptant ces techniques clés, les administrateurs peuvent obtenir des informations plus approfondies, prévenir les problèmes et garantir une santé optimale du système.
Adopter l'automatisation pour les tâches routinières
Les tâches manuelles de surveillance et de maintenance, en particulier pour les grandes infrastructures, sont sujettes à l'erreur humaine et consomment un temps précieux.
Automatisez les processus répétitifs tels que l'analyse des journaux, la collecte des données de performance et même les tâches de détection des menaces de base, telles que l'identification des entrées de journaux suspectes. Les administrateurs peuvent ainsi se consacrer à la résolution de problèmes complexes et à des initiatives stratégiques plutôt qu'à des tâches répétitives.
Mise en œuvre de l'infrastructure en tant que code (IaC) pour la surveillance des configurations
La gestion manuelle des configurations de surveillance sur de nombreux serveurs peut rapidement entraîner des incohérences. En traitant les configurations de surveillance comme du code, les outils IaC vous permettent de définir, de contrôler les versions et de déployer automatiquement les configurations. Cela garantit l'uniformité, réduit la dérive de la configuration et minimise l'erreur humaine dans votre paysage de surveillance.
Suivre la communication des microservices avec l'observabilité
Dans les architectures modernes de microservices, il est primordial de comprendre les interactions entre les services distribués.
Adoptez des pratiques d'observabilité, notamment le traçage distribué et la surveillance du maillage des services, pour suivre les flux de communication, les dépendances et la latence entre les services. Cela permet d'obtenir des informations cruciales sur les goulets d'étranglement potentiels, les taux d'erreur et les problèmes de performance au sein d'applications complexes.
Ajustement stratégique des paramètres du noyau
Pour obtenir des performances optimales sur un serveur Linux, il faut souvent aller au-delà des paramètres par défaut. Le réglage précis des paramètres du noyau permet d'optimiser le système en fonction de la charge de travail, ce qui a un impact sur la gestion de la mémoire, le comportement de la pile réseau et la planification des entrées/sorties.
Il s'agit d'un processus itératif - les changements doivent être testés dans des environnements de simulation et surveillés de près avant d'être appliqués à la production.
Analyser de manière proactive les schémas de trafic anormaux
L'analyse cohérente des modèles de trafic réseau est une pratique de sécurité essentielle. En surveillant les écarts par rapport au comportement normal - comme une activité portuaire inhabituelle, des pics soudains de données sortantes ou des accès provenant de zones géographiques inattendues - les administrateurs peuvent détecter et prévenir en temps réel les accès non autorisés ou les cyberattaques en cours. Les outils automatisés de détection des anomalies peuvent contribuer de manière significative à cette vigilance.
Surveillance de Linux dans les environnements virtuels et en nuage
Alors que les mesures fondamentales de Linux restent critiques, une surveillance efficace dans les environnements cloud ou virtualisés introduit des complexités distinctes. Les instances sont souvent éphémères, évoluent de manière dynamique et font partie d'architectures microservices hautement distribuées. Cela exige une stratégie plus flexible, car les outils traditionnels basés sur des agents ne parviennent pas toujours à suivre les instances qui se mettent en place et s'arrêtent rapidement.
Parmi les éléments clés à prendre en compte, citons l'utilisation de services de surveillance natifs du cloud (par exemple, AWS CloudWatch, Azure Monitor), qui offrent une découverte automatique et une intégration native avec les ressources du cloud. Il est également essentiel de comprendre le modèle de responsabilité partagée du fournisseur de cloud computing, en définissant clairement les composants (comme le matériel et le réseau principal) qu'il surveille, par rapport à ce qui reste sous votre responsabilité (comme les VM Linux, les applications et les données).
L'évolution vers l'observabilité devient primordiale, en mettant l'accent sur la collecte et la corrélation des mesures, des journaux et des traces à travers les composants distribués. Cette visibilité détaillée est cruciale pour le suivi de l'allocation dynamique des ressources, l'optimisation des dépenses en nuage en identifiant les ressources sous-utilisées, et le maintien d'une visibilité cohérente alors que l'infrastructure change constamment.
Améliorez votre surveillance Linux : Prochaines étapes
Une surveillance efficace du système Linux, que ce soit sur site, dans des environnements virtuels ou dans des infrastructures cloud dynamiques, exige plus que de simples outils de base ou des réponses réactives. Comme nous l'avons vu, la maîtrise de cet environnement en constante évolution nécessite des approches stratégiques en matière d'analyse des métriques, d'automatisation et de résolution des défis uniques liés aux déploiements Linux modernes, en particulier en matière de sécurité et de disponibilité. Les outils d'automatisation Linux peuvent aider en automatisant les tâches répétitives, telles que la surveillance de la configuration, l'analyse des journaux et la détection des menaces de base, permettant ainsi aux administrateurs de se concentrer sur les problèmes complexes. Compte tenu de ces exigences, le fait de s'appuyer uniquement sur des processus manuels peut entraîner des risques et un manque d'efficacité.
C'est là que KernelCare Enterprise de TuxCare devient inestimable. Grâce à l'application automatisée de correctifs sans redémarrage, KernelCare élimine les temps d'arrêt liés aux correctifs et garantit que votre infrastructure Linux reste sécurisée, conforme et stable sans interruption.
Prêt à simplifier les correctifs Linux et à améliorer la sécurité ? Parlez à un expert TuxCare dès aujourd'hui et découvrez comment KernelCare peut vous aider à automatiser la gestion des correctifs et à protéger vos serveurs Linux.