Technischer Support
 Dokumentation
 Anmeldung
 Kontakt


Gehen Sie direkt zu einer KI-Zusammenfassung dieses Blogbeitrags 


Wichtigste Erkenntnisse
- Die Linux-Überwachung ist für die Gewährleistung von Leistung, Sicherheit, Verfügbarkeit und Compliance bei allen Workloads unerlässlich.
- Verwenden Sie Tools wie htop, Netdata und Prometheus, um CPU, Speicher, Festplatten-E/A, Netzwerkaktivität und den allgemeinen Systemzustand zu überwachen.
- Überwachung ist nur die Hälfte der Gleichung - in Verbindung mit Rebootless-Patching-Lösungen wie KernelCare um Ausfallzeiten zu reduzieren und Sicherheitslücken zu schließen.
Die Überwachung von Linux-Servern bringt eine Reihe von Herausforderungen mit sich, die bei anderen Betriebssystemen nicht auftreten können. Sie erfordert ein höheres Maß an technischen Kenntnissen. Die Administratoren müssen ihre Systeme selbst konfigurieren und Skripte erstellen, um optimale Spezifikationen zu erreichen.
Der Prozess kann anfangs einschüchternd wirken. Es gibt zwar eine Lernkurve, aber Sie können die meisten Hindernisse überwinden, wenn Sie die grundlegenden Konzepte beherrschen und sich gängige Automatisierungstechniken zunutze machen. Wenn Sie die Grundlagen wiederholen und beherrschen, kommen Sie sehr weit.
Um Server rund um die Uhr in Topform zu halten, bedarf es jedoch mehr als nur einer grundlegenden Überwachung; es sind umfassende Strategien für kontinuierliche Sicherheit, proaktive Wartung und nahtlose Updates erforderlich. In diesem Leitfaden werden diese wesentlichen Aspekte untersucht.
Warum Linux-Überwachung wichtig ist
Die Überwachung Ihrer Linux-Systeme ist für die Aufrechterhaltung von Stabilität, Leistung und Linux-Sicherheit unerlässlich - insbesondere in modernen, ständig aktiven Umgebungen.
Hier sind die Gründe, warum die Linux-Überwachung im Jahr 2026 von entscheidender Bedeutung ist:

- Leistung: Erkennen Sie eine hohe CPU-, Speicher-, Festplatten- oder Netzwerkauslastung, bevor sie sich auf die Benutzer auswirkt.
- Sicherheit: Erkennen Sie ungewöhnliche Prozesse, fehlgeschlagene Anmeldungen oder verdächtiges Verhalten frühzeitig.
- Einhaltung von Vorschriften: Pflegen Sie Prüfpfade und erfüllen Sie gesetzliche oder branchenspezifische Anforderungen.
- Verfügbarkeit: Verhindern Sie Ausfälle und reduzieren Sie die MTTR (Mean Time to Recovery).
- Effizienz: Optimieren Sie Ressourcen, vermeiden Sie eine übermäßige Bereitstellung und rationalisieren Sie den Betrieb.
Die wahren Herausforderungen bei der Überwachung von Linux-Systemen
Das Linux-Betriebssystem bietet Ihnen eine unglaubliche Kontrolle und Flexibilität, aber ein Auge auf moderne Systeme zu haben, ist nicht so einfach, wie ein paar Befehle auszuführen. Die Beherrschung dieser dynamischen Landschaft, in der sich Probleme im Verborgenen abspielen können, ist der Schlüssel für eine effektive Überwachung.
Ausufernde Werkzeuge und Integration
Das Linux-Ökosystem ist vollgepackt mit Überwachungstools - von leichtgewichtigen Befehlszeilen-Dienstprogrammen bis hin zu umfassenden Unternehmensplattformen. Aber mehr Optionen bedeuten nicht immer eine bessere Übersicht.
Die Herausforderung besteht darin, die richtige Kombination von Überwachungslösungen auszuwählen, unterschiedliche Datenquellen zu integrieren und eine einheitliche Ansicht zu erstellen, ohne dass es zu einem Übermaß an Tools oder Datensilos kommt, die die Analyse und Alarmierung erschweren.
Dynamische und verteilte Umgebungen
Moderne Linux-Bereitstellungen umfassen oft große, verteilte Infrastrukturen mit ephemeren Komponenten wie Containern und Microservices. Die Überwachung dieser hochdynamischen, kurzlebigen Instanzen und ephemeren Workloads stellt eine große Herausforderung dar und erfordert fortschrittliche Strategien zur Leistungsverfolgung, Ressourcenzuweisung und Gewährleistung der Transparenz in der sich ständig verändernden IT-Infrastruktur.
Alert Müdigkeit & Lärm
Bei der schieren Menge an verfügbaren Metriken besteht eine häufige Gefahr darin, zu viele Warnungen oder Fehlalarme zu erzeugen. Dies führt zu einer Alarmmüdigkeit, bei der wichtige Warnungen im Rauschen untergehen.
Sysadmins stehen vor der Herausforderung, Schwellenwerte fein abzustimmen und intelligente Warnsysteme zu entwickeln, die zeitnahe, relevante Benachrichtigungen liefern, ohne die Teams zu überfordern.
Analyse der Grundursache
Eine plötzliche CPU-Spitze kann ein Dutzend verschiedener Dinge bedeuten - einen durchgebrannten Prozess, eine Datenbanksperre oder sogar einen versteckten Netzwerkengpass. In komplexen Linux-Stacks weisen die Symptome selten direkt auf das Problem hin. Die Herausforderung besteht darin, Hinweise aus Protokollen, Metriken und Traces zusammenzustellen, um das eigentliche Problem zu finden. Ohne die richtigen Überwachungstools müssen Sie Detektiv spielen, anstatt das Problem zu lösen.
Sichtbarkeit der Sicherheit und Bedrohungen
Bei der Sicherheitsüberwachung geht es nicht nur um die Erkennung bekannter Bedrohungen, sondern auch um die Identifizierung von anormalem Verhalten, unbefugtem Zugriff und verdächtigen Prozessen.
Die Herausforderung besteht darin, umfangreiche Protokolle und Systemdaten zu durchsuchen, um subtile Anzeichen für eine Kompromittierung zu erkennen, Prüfprotokolle zu führen und die kontinuierliche Einhaltung der Vorschriften in einer sich ständig weiterentwickelnden Bedrohungslandschaft sicherzustellen.
Wartungskosten und Ausfallzeiten
Durch die Überwachung können Linux-Schwachstellen ermittelt werden - sie sicher zu patchen ist jedoch eine andere Herausforderung. Reboots während Kernel-Updates führen immer noch zu Ausfallzeiten. Ohne rebootloses Patching wird die Wartung zu einem wiederkehrenden Betriebsrisiko. Die Gewährleistung einer hohen Verfügbarkeit während dieser notwendigen Vorgänge und die Minimierung des Risikos von Neustarts und Ausfallzeiten ist ein ständiger Balanceakt für Administratoren.
Wichtige Metriken, die auf Linux-Servern zu verfolgen sind
Eine effektive Linux-Überwachung hängt auch von der Überwachung der richtigen Indikatoren ab. Im Folgenden finden Sie die wichtigsten Metriken für CPU, Speicher, Festplatte, Netzwerk und Systemzustand, die für die frühzeitige Erkennung von Problemen und die Aufrechterhaltung der Betriebszeit entscheidend sind.
1. CPU-Auslastung
- Verfolgt, wie viel Rechenleistung verbraucht wird.
- Überwachung von Benutzer- und System-CPU, Leerlaufzeit und Iowait.
- Nützliche Werkzeuge: top, htop, mpstat.
- Hohe Iowait-Werte deuten oft auf zugrundeliegende Festplatten-E/A-Engpässe hin, nicht nur auf eine CPU-Überlastung.
2. Speicherauslastung
- Misst die RAM-Nutzung, den freien Speicher und die Swap-Nutzung.
- Überwachung von Seitenfehlern und Puffer-/Cache-Verbrauch.
- Werkzeuge: free, vmstat, sar, smem.
- Eine übermäßige Swap-Nutzung ist ein deutlicher Indikator für Speicherdruck, der zu erheblichen Leistungseinbußen führt.
3. Festplatten-E/A
- Verfolgt Lese-/Schreibgeschwindigkeit, IOPS und E/A-Wartezeit
- Verwenden Sie iostat, iotop oder dstat zur Festplattenüberwachung
- Hohe E/A-Latenz wirkt sich oft zuerst auf die Anwendungsleistung aus
4. Netzwerkdurchsatz und Fehler
- Netzwerküberwachung von RX/TX-Raten, verworfenen Paketen und Verbindungsstatus.
- Werkzeuge: ifstat, ss, netstat, nload, vnstat.
- Unerlässlich für die Erkennung von Bandbreitensättigung, Paketverlusten, Netzwerkengpässen oder potenziellen DDoS-Angriffen.
5. Last Durchschnitt
- Gibt die durchschnittliche Anzahl der Prozesse an, die auf CPU-Zeit warten.
- Überwachen Sie 1-, 5- und 15-Minuten-Mittelwerte.
- Tools: Betriebszeit, top.
- Eine anhaltende Last, die höher ist als die Anzahl der CPU-Kerne, bedeutet oft eine Überlastung des Systems.
6. Betriebszeit und Verfügbarkeit
- Verfolgen Sie die Systemstartzeit, die Betriebsdauer und unerwartete Neustarts.
- Werkzeuge: uptime, who -b, letzter Neustart.
- Entscheidend für die Einhaltung von SLAs, die Verfolgung der Systemzuverlässigkeit und die Planung geplanter Wartungsarbeiten für die Geschäftskontinuität.
7. Dateisystem-Nutzung
- Überwachen Sie Festplattenspeicher, Inode-Nutzung und Einhängepunktkapazität.
- Werkzeuge: df -h, du -sh, ncdu.
- Volle Festplatten können zu fehlgeschlagenen Schreibvorgängen, Anwendungsabstürzen und unterbrochener Protokollierung führen.
8. Prozess und Service Gesundheit
- Prüfen Sie, ob kritische Prozesse ausgeführt werden und die erwarteten Ressourcen verbrauchen.
- Werkzeuge: ps, pidstat, systemctl status.
- Entscheidend für die Warnung bei Dienstausfällen, unerwarteten Stopps oder Zombie-Prozessen.
Die besten Tools für die Linux-Überwachung
Im Folgenden finden Sie einige der wichtigsten Linux-Überwachungstools, die sowohl Befehlszeilen-Dienstprogramme als auch Plattformen der Enterprise-Klasse abdecken. Jedes Tool hat unterschiedliche Vor- und Nachteile, die bestimmen, wie gut es für die speziellen Überwachungsanforderungen Ihres Teams geeignet ist.
htop
htop ist ein erweitertes, interaktives Befehlszeilen-Dienstprogramm, das eine Echtzeit-Ansicht von CPU, Speicher, Swap, Prozessbäumen und Last-Durchschnittswerten bietet.

Vorteile:
- Farbcodierte, tastaturfreundliche Oberfläche für einfache Navigation.
- Hervorragend geeignet für schnelle, interaktive Ressourcenprüfungen und Prozesskontrolle.
- Leichtgewichtig und in den meisten Linux-Distributionen verfügbar.
Nachteile:
- Es fehlt die Verfolgung historischer Daten.
- In erster Linie für Echtzeit-Einblicke auf einem einzelnen Server.
btop
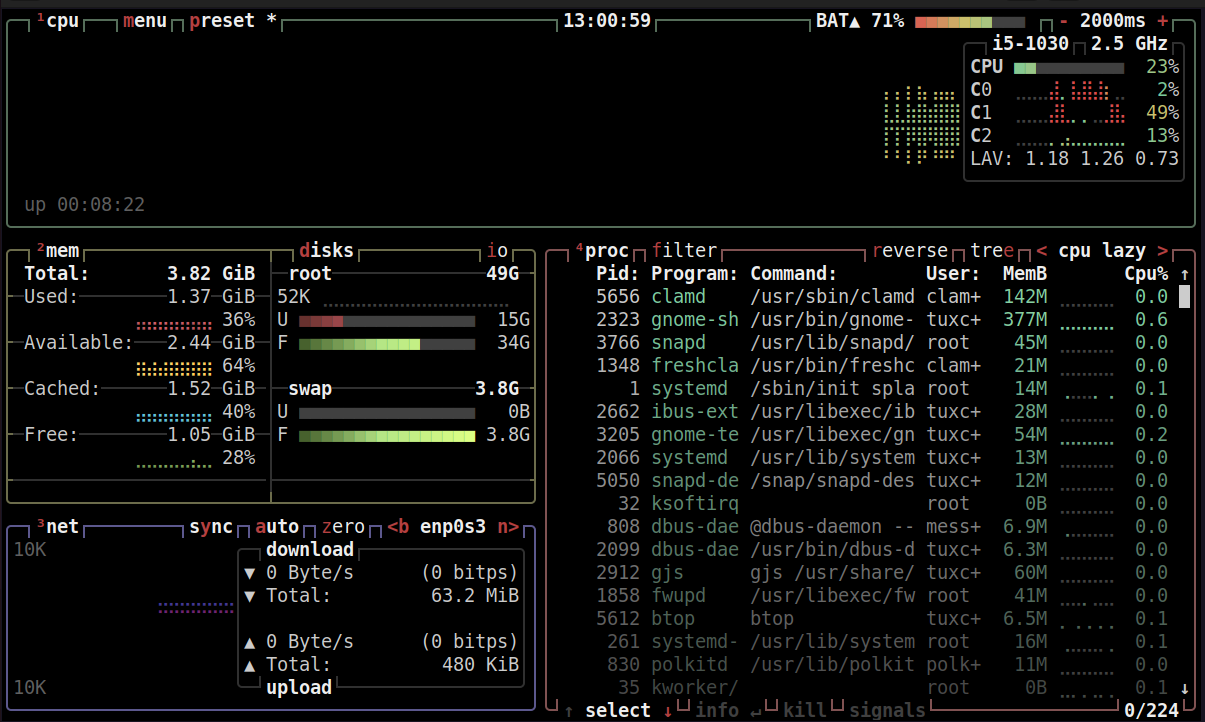
Als visuell beeindruckender und funktionsreicher Systemmonitor bietet btop (und seine Vorgänger wie bashtop/bpytop) Echtzeiteinblicke in CPU-, RAM-, Festplatten- und Netzwerkaktivitäten über eine ansprechende Terminalschnittstelle.
Vorteile:
- Moderne, reaktionsschnelle Benutzeroberfläche mit Mausunterstützung und umfangreichen Anpassungsmöglichkeiten.
- Bietet detailliertere Metriken und eine bessere Visualisierung als htop in einem Terminal.
- Hervorragend geeignet für die interaktive lokale oder SSH-basierte Überwachung.
Nachteile:
- Der visuelle Reichtum könnte etwas mehr Ressourcen verbrauchen als einfachere CLI-Tools.
- Weniger ideal für reine Skripterstellung oder sehr ressourcenarme Remote-Agenten, die nur eine Rohtextausgabe benötigen.
iotop
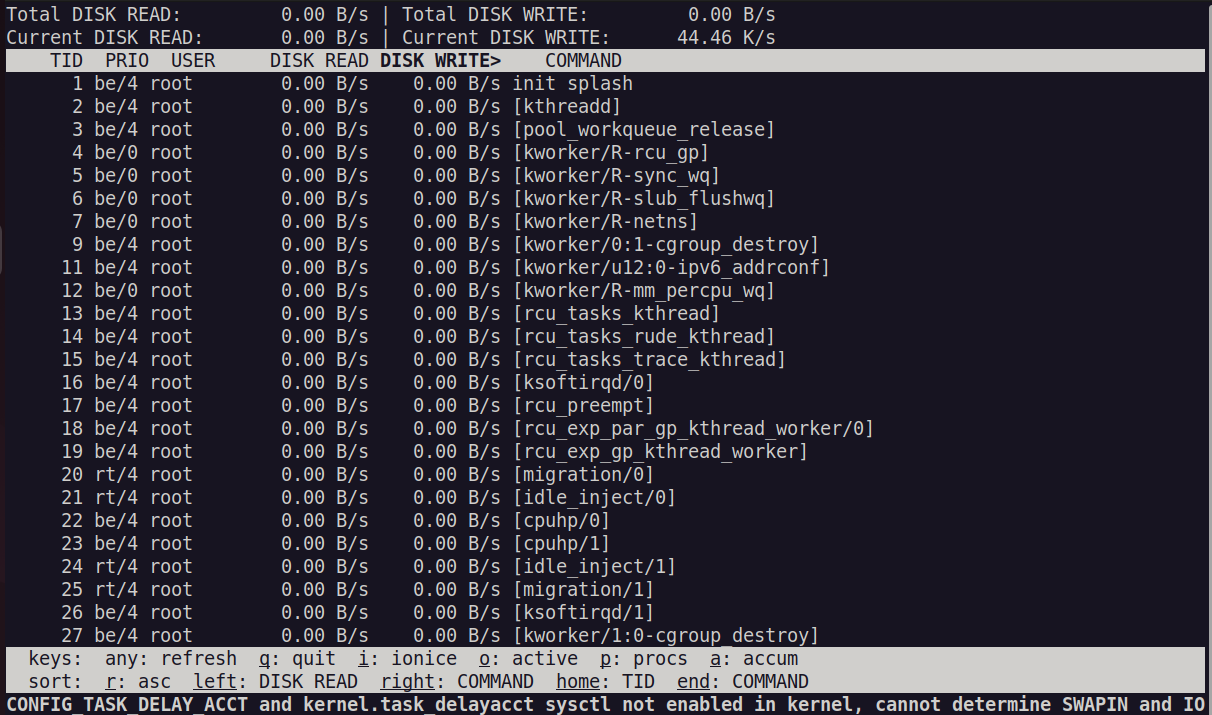
iotop ist ein Befehlszeilen-Dienstprogramm, das speziell dafür entwickelt wurde, die Festplatten-E/A-Nutzung nach Prozessen zu verfolgen. Es ist von unschätzbarem Wert, wenn es darum geht, in Echtzeit festzustellen, welche Prozesse Engpässe auf der Festplatte verursachen, was es zu einem wichtigen Werkzeug bei Leistungseinbrüchen macht.
Vorteile:
- Liefert E/A-Statistiken pro Prozess in Echtzeit.
- Hervorragend geeignet, um bestimmte Anwendungen oder Prozesse, die Festplattenengpässe verursachen, zu ermitteln.
- Einfach und direkt für eine sofortige Fehlerbehebung.
Nachteile:
- Für die Ausführung sind in der Regel Root-Rechte erforderlich.
- Konzentriert sich ausschließlich auf Festplatten-E/A, kein umfassender Systemmonitor.
Netdata
Netdata ist ein Echtzeit-Überwachungsagent, der über interaktive Web-Dashboards und Zustandswarnungen sofortige Einblicke in Hunderte von Systemmetriken bietet.

Vorteile:
- Extrem leicht, selbstkonfigurierend und praktisch wartungsfrei.
- Bietet tiefe, sekundengenaue Granularität für eine sofortige Fehlerbehebung.
- Die interaktive Web-Benutzeroberfläche ist von jedem Browser aus zugänglich.
- Die verteilte Architektur ermöglicht skalierbare Unternehmensbereitstellungen.
Nachteile:
- Erfordert einen Webbrowser für seine Dashboards, weniger ideal für reine CLI-Umgebungen.
- Im Vergleich zu speziellen Zeitreihendatenbanken muss man sich möglicherweise mehr Gedanken über die langfristige Datenspeicherung machen.
Prometheus + Grafana
Diese leistungsstarke Kombination nutzt Prometheus zum Scrapen und Speichern von Zeitserienmetriken, während Grafana eine robuste Visualisierung durch anpassbare Dashboards und integrierte Warnmeldungen bietet.

Vorteile:
- Hochgradig skalierbar, flexibel und alarmgesteuert für komplexe Umgebungen.
- Ideal für Cloud-Native-, Microservices- und hybride Linux-Infrastrukturen.
- Umfangreiches Ökosystem von Exporteuren für verschiedene Dienste und Anwendungen.
- Open-Source mit starker Unterstützung der Gemeinschaft.
Nachteile:
- Erfordert die anfängliche Einrichtung und Konfiguration von Prometheus und Grafana.
- Erfordert die Installation spezieller "Exporter" (wie node_exporter) auf den Zielsystemen.
- Die Lernkurve für Anfänger kann aufgrund des verteilten Charakters steiler sein.
Zabbix
Zabbix ist eine umfassende Überwachungslösung für Unternehmen, mit der Linux-Server, Anwendungen, Netzwerkgeräte und virtuelle Maschinen überwacht werden können.

Vorteile:
- Stark in historischer Verfolgung, erweiterter Alarmierung und flexiblen Dashboards.
- Bietet integrierte Agenten und SNMP-Unterstützung für umfassende Kompatibilität.
- Zentralisierte Verwaltungskonsole für große Umgebungen.
- Umfangreiches Templating-System für konsistente Überwachung über viele Hosts hinweg.
Nachteile:
- Die Lernkurve ist im Vergleich zu einfacheren Tools steiler, insbesondere bei der Ersteinrichtung und bei komplexen Konfigurationen.
- Die Ressourcenanforderungen für den Zabbix-Server können bei sehr großen Einsätzen höher sein.
Bewährte Überwachungspraktiken und -techniken für Linux-Systemadministratoren
Eine wirksame Überwachung von Linux-Systemen geht über das bloße Reagieren auf Warnmeldungen hinaus; sie erfordert einen proaktiven und strategischen Ansatz. Durch die Anwendung dieser Schlüsseltechniken können Administratoren tiefere Einblicke gewinnen, Probleme verhindern und einen optimalen Systemzustand sicherstellen.
Automatisierung von Routineaufgaben
Manuelle Überwachungs- und Wartungsaufgaben, insbesondere bei großen Infrastrukturen, sind anfällig für menschliche Fehler und kosten wertvolle Zeit.
Automatisieren Sie sich wiederholende Prozesse wie die Protokollanalyse, die Erfassung von Leistungsdaten und sogar grundlegende Aufgaben zur Erkennung von Bedrohungen, z. B. die Identifizierung verdächtiger Protokolleinträge. Dadurch können sich Administratoren auf komplexe Problemlösungen und strategische Initiativen konzentrieren, anstatt Routinearbeit zu leisten.
Implementierung von Infrastructure as Code (IaC) zur Überwachung von Konfigurationen
Die Verwaltung von Überwachungskonfigurationen auf zahlreichen Servern kann schnell zu Inkonsistenzen führen, wenn sie manuell erfolgt. Durch die Behandlung von Überwachungs-Setups als Code ermöglichen IaC-Tools die Definition, Versionskontrolle und automatische Bereitstellung von Konfigurationen. Dies gewährleistet Einheitlichkeit, reduziert Konfigurationsabweichungen und minimiert menschliche Fehler in Ihrer Überwachungslandschaft.
Microservices-Kommunikation mit Observability verfolgen
In modernen Microservices-Architekturen ist das Verständnis der Interaktionen zwischen verteilten Diensten von zentraler Bedeutung.
Führen Sie Beobachtungspraktiken ein, einschließlich verteiltem Tracing und Service-Mesh-Monitoring, um Kommunikationsflüsse, Abhängigkeiten und Latenzzeiten zwischen Diensten zu verfolgen. Dies bietet wichtige Einblicke in potenzielle Engpässe, Fehlerraten und Leistungsprobleme innerhalb komplexer Anwendungen.
Strategische Feinabstimmung der Kernel-Parameter
Um eine optimale Leistung von Linux-Servern zu erreichen, sind oft mehr als die Standardeinstellungen erforderlich. Die Feinabstimmung der Kernel-Parameter ermöglicht Optimierungen auf Systemebene, die speziell auf Ihre Arbeitslast abgestimmt sind und sich auf die Speicherverwaltung, das Verhalten des Netzwerkstapels und die E/A-Planung auswirken.
Dies ist ein iterativer Prozess - Änderungen sollten in Staging-Umgebungen getestet und genau überwacht werden, bevor sie in die Produktion übernommen werden.
Proaktive Analyse von abnormalen Verkehrsmustern
Die konsequente Analyse von Netzwerkverkehrsmustern ist eine wichtige Sicherheitsmaßnahme. Durch die Überwachung von Abweichungen vom normalen Verhalten - z. B. ungewöhnliche Port-Aktivitäten, plötzliche Spitzen bei ausgehenden Daten oder Zugriffe aus unerwarteten Regionen - können Administratoren unbefugten Zugriff oder laufende Cyberangriffe in Echtzeit erkennen und verhindern. Automatisierte Tools zur Erkennung von Anomalien können diese Wachsamkeit erheblich unterstützen.
Linux-Überwachung in Cloud- und virtuellen Umgebungen
Während die grundlegenden Linux-Metriken nach wie vor von entscheidender Bedeutung sind, bringt die effektive Überwachung in Cloud- oder virtualisierten Umgebungen besondere Komplexitäten mit sich. Instanzen sind oft kurzlebig, skalieren dynamisch und sind Teil hochgradig verteilter Microservices-Architekturen. Dies erfordert eine flexiblere Strategie, da herkömmliche agentenbasierte Tools bei der Überwachung von Instanzen, die schnell hoch- und heruntergefahren werden, oft versagen.
Zu den wichtigsten Überlegungen gehört die Nutzung von Cloud-nativen Überwachungsdiensten (z. B. AWS CloudWatch, Azure Monitor), die automatische Erkennung und native Integration mit Cloud-Ressourcen bieten. Ein Verständnis des Modells der geteilten Verantwortung des Cloud-Anbieters ist ebenfalls von entscheidender Bedeutung - es muss klar definiert werden, welche Komponenten (wie Hardware und Kernnetzwerke) von diesem überwacht werden und was in Ihrer Verantwortung bleibt (wie Linux-VMs, Anwendungen und Daten).
Die Verlagerung in Richtung Beobachtbarkeit ist von entscheidender Bedeutung, wobei der Schwerpunkt auf der Erfassung und Korrelation von Metriken, Protokollen und Traces über verteilte Komponenten hinweg liegt. Diese detaillierte Sichtbarkeit ist entscheidend für die Verfolgung der dynamischen Ressourcenzuweisung, die Optimierung der Cloud-Ausgaben durch die Identifizierung von nicht ausgelasteten Ressourcen und die Aufrechterhaltung einer konsistenten Sichtbarkeit bei ständigen Veränderungen der Infrastruktur.
Verbessern Sie Ihre Linux-Überwachung: Die nächsten Schritte
Eine effektive Überwachung von Linux-Systemen, sei es vor Ort, in virtuellen Umgebungen oder über dynamische Cloud-Infrastrukturen hinweg, erfordert mehr als nur grundlegende Tools oder reaktive Maßnahmen. Wie wir gesehen haben, erfordert die Beherrschung dieser sich ständig weiterentwickelnden Landschaft strategische Ansätze für die Metrikanalyse, Automatisierung und Bewältigung der besonderen Herausforderungen moderner Linux-Bereitstellungen, insbesondere in Bezug auf Sicherheit und Verfügbarkeit. Linux-Automatisierungstools können dabei helfen, indem sie sich wiederholende Aufgaben wie die Überwachung der Konfiguration, die Protokollanalyse und die grundlegende Erkennung von Bedrohungen automatisieren, sodass sich Administratoren auf komplexe Probleme konzentrieren können. Angesichts dieser Anforderungen kann die ausschließliche Verwendung manueller Prozesse Risiken und Ineffizienzen mit sich bringen.
An dieser Stelle wird TuxCare's KernelCare Enterprise unschätzbar wertvoll. Mit automatisiertem, rebootlosem Patching eliminiert KernelCare patchbedingte Ausfallzeiten und sorgt dafür, dass Ihre Linux-Infrastruktur ohne Unterbrechung sicher, konform und stabil bleibt.
Sind Sie bereit, das Linux-Patching zu vereinfachen und die Sicherheit zu verbessern? Sprechen Sie noch heute mit einem TuxCare-Experten und erfahren Sie, wie Sie mit KernelCare das Patch-Management automatisieren und Ihre Linux-Server schützen können.