Suporte Técnico
 Documentação
 Entrar
 Entre em contato conosco


Vá direto para um resumo gerado por IA desta postagem do blog 


Principais conclusões
- O monitoramento do Linux é essencial para garantir o desempenho, a segurança, a disponibilidade e a conformidade em todas as cargas de trabalho.
- Utilize ferramentas como htop, Netdata e Prometheus para monitorar a CPU, a memória, a E/S de disco, a atividade de rede e o estado geral do sistema.
- O monitoramento é apenas metade da equação — combine-o com soluções de aplicação de patches sem reinicialização, como o KernelCare para reduzir o tempo de inatividade e sanar brechas de segurança.
O monitoramento de servidores Linux apresenta um conjunto específico de desafios, que talvez você não encontre em outros sistemas operacionais. Isso exige um nível mais aprofundado de conhecimento técnico. Os administradores precisarão configurar e criar scripts para seus sistemas a fim de atingir as especificações ideais.
No início, o processo pode parecer intimidador. Embora haja uma curva de aprendizado, é possível superar a maioria dos obstáculos ao dominar os conceitos básicos e aproveitar as técnicas comuns de automação. Você já vai longe apenas repetindo e dominando o básico.
No entanto, manter os servidores em perfeitas condições 24 horas por dia, 7 dias por semana, exige mais do que apenas um monitoramento básico; requer estratégias abrangentes para segurança contínua, manutenção proativa e atualizações sem interrupções. Este guia abordará esses aspectos essenciais.
Por que o monitoramento do Linux é importante
O monitoramento dos seus sistemas Linux é essencial para manter a estabilidade, o desempenho e a segurança do Linux — especialmente em ambientes modernos que permanecem sempre ativos.
Veja por que o monitoramento do Linux é fundamental em 2026:

- Desempenho: Detecte picos de uso da CPU, da memória, do disco ou da rede antes que isso afete os usuários.
- Segurança: Identifique antecipadamente processos incomuns, tentativas de login malsucedidas ou comportamentos suspeitos.
- Conformidade: Manter registros de auditoria e atender aos requisitos regulatórios ou específicos do setor.
- Disponibilidade: Evite interrupções e reduza o Tempo Médio de Recuperação (MTTR).
- Eficiência: Otimize recursos, evite o provisionamento excessivo e simplifique as operações.
Os verdadeiros desafios do monitoramento de sistemas Linux
O sistema operacional Linux oferece um controle e uma flexibilidade incríveis, mas ficar de olho nos sistemas modernos não é tão simples quanto executar alguns comandos. Dominar esse cenário dinâmico, onde os problemas podem estar bem à vista, é fundamental para um monitoramento eficaz.
Multiplicação e integração de ferramentas
O ecossistema do Linux está repleto de ferramentas de monitoramento — desde utilitários leves de linha de comando até plataformas corporativas completas. Mas mais opções nem sempre significam melhor visibilidade.
O desafio está em selecionar a combinação certa de soluções de monitoramento, integrar fontes de dados díspares e criar uma visão unificada, sem gerar uma proliferação de ferramentas ou silos de dados que compliquem a análise e os alertas.
Ambientes dinâmicos e distribuídos
As implantações modernas do Linux geralmente envolvem infraestruturas vastas e distribuídas, com componentes efêmeros, como contêineres e microsserviços. O monitoramento dessas instâncias altamente dinâmicas e de curta duração, bem como das cargas de trabalho efêmeras, representa um desafio significativo, exigindo estratégias avançadas para acompanhar o desempenho, alocar recursos e garantir visibilidade em uma infraestrutura de TI em constante mudança.
Fadiga de alertas e ruído
Com o grande volume de métricas disponíveis, uma armadilha comum é gerar um número excessivo de alertas ou falsos positivos. Isso leva à fadiga de alertas, em que avisos críticos se perdem em meio ao ruído.
Os administradores de sistemas enfrentam o desafio de ajustar os limites e criar sistemas de alerta inteligentes que forneçam notificações oportunas e relevantes, sem sobrecarregar as equipes.
Análise da Causa Raiz
Um pico repentino na CPU pode significar uma dúzia de coisas diferentes — um processo fora de controle, um bloqueio no banco de dados ou até mesmo um gargalo oculto na rede. Em pilhas complexas do Linux, os sintomas raramente apontam diretamente para o problema. O desafio está em juntar as pistas dos logs, métricas e rastreamentos para identificar o problema real. Sem as ferramentas de monitoramento adequadas, você fica preso a bancar o detetive, em vez de resolver o problema.
Visibilidade de segurança e ameaças
O monitoramento de segurança não se resume apenas à detecção de ameaças conhecidas; trata-se de identificar comportamentos anômalos, acessos não autorizados e processos suspeitos.
O desafio consiste em analisar minuciosamente vastos registros e dados do sistema para identificar indicadores sutis de violação, manter trilhas de auditoria e garantir a conformidade contínua em um cenário de ameaças em constante evolução.
Custos indiretos de manutenção e tempo de inatividade
O monitoramento pode identificar vulnerabilidades no Linux — mas corrigi-las com segurança é outro desafio. As reinicializações durante as atualizações do kernel ainda causam tempo de inatividade. Sem a aplicação de patches sem reinicialização, a manutenção se torna um risco operacional recorrente. Garantir alta disponibilidade durante esses procedimentos necessários e minimizar o risco de reinicializações e tempo de inatividade é um equilíbrio constante para os administradores.
Principais métricas a serem monitoradas em servidores Linux
Um monitoramento eficaz do Linux também depende do acompanhamento dos indicadores certos. Abaixo estão as métricas mais importantes relacionadas à CPU, à memória, ao disco, à rede e ao estado do sistema, essenciais para a detecção precoce de problemas e para manter o tempo de atividade.
1. Utilização da CPU
- Monitora a quantidade de poder de processamento que está sendo utilizada.
- Monitorar o uso da CPU pelo usuário e pelo sistema, o tempo de inatividade e o iowait.
- Ferramentas úteis: top, htop, mpstat.
- Um valor elevado de iowait costuma indicar gargalos subjacentes de E/S de disco, e não apenas sobrecarga da CPU.
2. Utilização da memória
- Mede o uso da RAM, a memória livre e o uso do swap.
- Monitorar falhas de página e o consumo de buffer/cache.
- Ferramentas: free, vmstat, sar, smem.
- O uso excessivo do swap é um forte indicador de pressão na memória, levando a uma degradação significativa do desempenho.
3. E/S de disco
- Monitora a velocidade de leitura/gravação, o IOPS e o tempo de espera de E/S
- Use o iostat, o iotop ou o dstat para monitorar o disco
- A alta latência de E/S costuma afetar, em primeiro lugar, o desempenho dos aplicativos
4. Taxa de transferência e erros na rede
- Monitoramento de rede das taxas de recepção (RX) e transmissão (TX), pacotes perdidos e estados das conexões.
- Ferramentas: ifstat, ss, netstat, nload, vnstat.
- Essencial para detectar saturação da largura de banda, perda de pacotes, gargalos na rede ou possíveis ataques DDoS.
5. Média de carga
- Indica o número médio de processos aguardando tempo de CPU.
- Acompanhe as médias de 1, 5 e 15 minutos.
- Ferramentas: uptime, top.
- Uma carga sustentada superior ao número de núcleos da CPU geralmente indica sobrecarga do sistema.
6. Tempo de funcionamento e disponibilidade
- Acompanhe o tempo de inicialização do sistema, o tempo de atividade e as reinicializações inesperadas.
- Ferramentas: uptime, who -b, last reboot.
- É fundamental para cumprir os SLAs, monitorar a confiabilidade do sistema e planejar a manutenção programada para garantir a continuidade dos negócios.
7. Uso do sistema de arquivos
- Monitore o espaço em disco, o uso de inodes e a capacidade dos pontos de montagem.
- Ferramentas: df -h, du -sh, ncdu.
- Discos cheios podem causar falhas na gravação, travamentos de aplicativos e interrupções no registro de logs.
8. Integridade dos processos e serviços
- Verifique se os processos críticos estão em execução e consumindo os recursos esperados.
- Ferramentas: ps, pidstat, systemctl status.
- É fundamental para alertar sobre falhas no serviço, interrupções inesperadas ou processos “zumbis”.
As melhores ferramentas para monitoramento do Linux
A seguir, apresentamos algumas das principais ferramentas de monitoramento do Linux a serem consideradas, abrangendo tanto utilitários de linha de comando quanto plataformas de nível empresarial. Cada ferramenta possui diferentes prós e contras, que determinarão o quanto ela é adequada às necessidades específicas de monitoramento da sua equipe.
htop
O htop, um utilitário de linha de comando aprimorado e interativo, oferece uma visualização em tempo real da CPU, da memória, do espaço de troca, das árvores de processos e das médias de carga.

Prós:
- Interface com código de cores e otimizada para o teclado, facilitando a navegação.
- Ótimo para verificações rápidas e interativas de recursos e para o controle de processos.
- É leve e está amplamente disponível na maioria das distribuições do Linux.
Contras:
- Não possui acompanhamento de dados históricos.
- Destinado principalmente a análises em tempo real em um único servidor.
btop
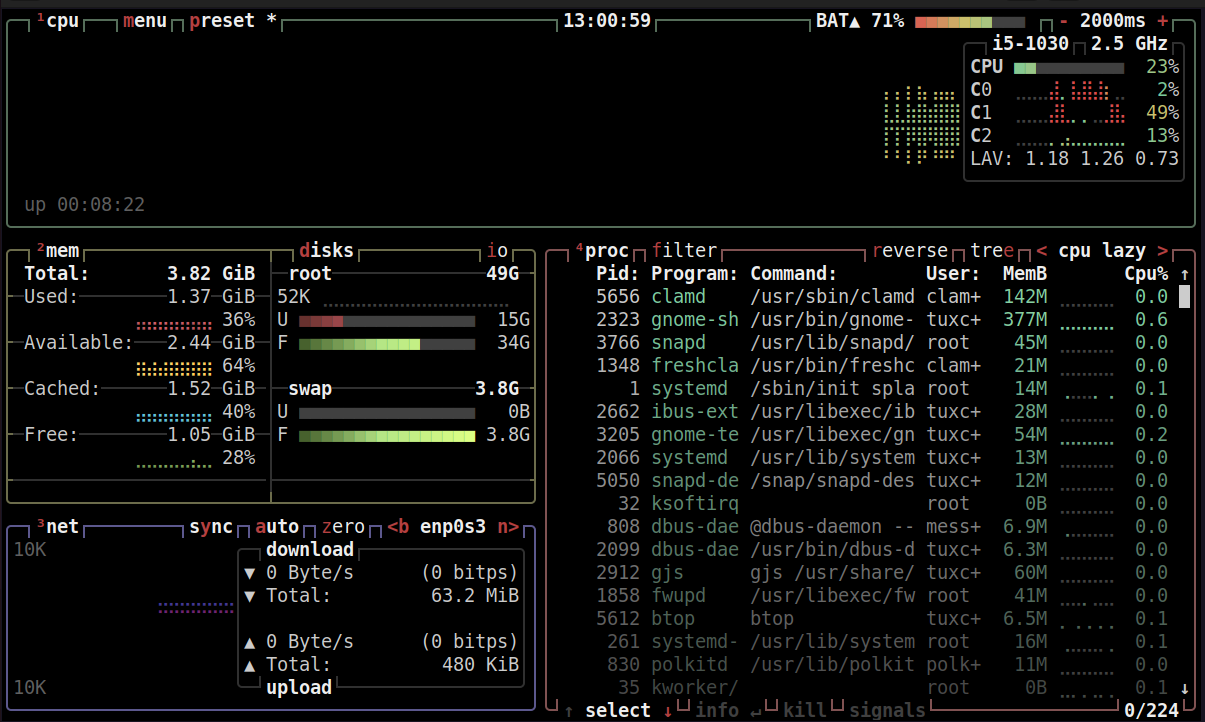
Um monitor de sistema visualmente impressionante e repleto de recursos, o btop (e seus antecessores, como o bashtop/bpytop) oferece informações em tempo real sobre a atividade da CPU, da memória RAM, do disco e da rede por meio de uma interface de terminal atraente.
Prós:
- Interface de usuário moderna e altamente responsiva, com suporte ao mouse e amplas opções de personalização.
- Oferece métricas mais detalhadas e uma visualização melhor do que o htop em um terminal.
- Excelente para monitoramento interativo local ou via SSH.
Contras:
- Sua riqueza visual pode consumir um pouco mais de recursos do que ferramentas de CLI mais simples.
- Menos adequado para scripts puros ou agentes remotos com recursos muito limitados, nos quais é necessária apenas a saída de texto bruto.
iotop
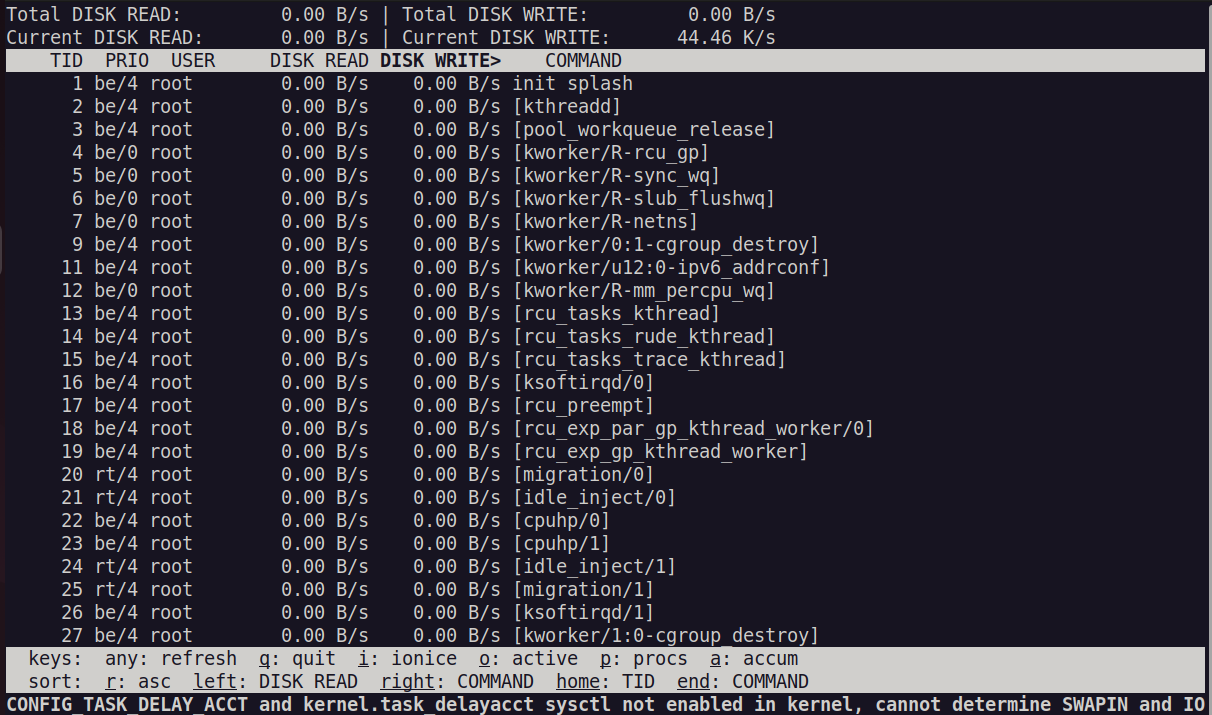
O iotop é um utilitário de linha de comando desenvolvido especificamente para monitorar o uso de E/S de disco por processo. É uma ferramenta indispensável para identificar, em tempo real, quais processos estão causando gargalos no disco, o que o torna a escolha ideal em casos de queda de desempenho.
Prós:
- Fornece estatísticas de E/S de disco em tempo real, por processo.
- Excelente para identificar aplicações ou processos específicos que causam gargalos no disco.
- Simples e direto para uma solução imediata de problemas.
Contras:
- Normalmente, é necessário ter privilégios de root para executá-lo.
- Concentra-se exclusivamente na E/S de disco; não é um monitor de sistema abrangente.
Netdata
O Netdata é um agente de monitoramento em tempo real e de alta precisão que oferece informações instantâneas sobre centenas de métricas do sistema por meio de painéis interativos na web e alertas de integridade.

Prós:
- Extremamente leve, com configuração automática e praticamente sem necessidade de manutenção.
- Oferece granularidade detalhada, por segundo, para resolução imediata de problemas.
- A interface de usuário interativa da web pode ser acessada a partir de qualquer navegador.
- A arquitetura distribuída permite implantações corporativas escaláveis.
Contras:
- Requer um navegador da web para acessar seus painéis; não é a melhor opção para ambientes que utilizam exclusivamente a interface de linha de comando (CLI).
- Pode exigir uma reflexão mais aprofundada sobre a retenção de dados a longo prazo, em comparação com bancos de dados dedicados a séries temporais.
Prometheus + Grafana
Essa poderosa combinação utiliza o Prometheus para coletar e armazenar métricas de séries temporais, enquanto o Grafana oferece uma visualização robusta por meio de painéis personalizáveis e alertas integrados.

Prós:
- Altamente escalável, flexível e orientado por alertas para ambientes complexos.
- Ideal para infraestruturas Linux nativas da nuvem, de microsserviços e híbridas.
- Um vasto ecossistema de exportadores de diversos serviços e aplicações.
- De código aberto, com forte apoio da comunidade.
Contras:
- Requer a instalação inicial e a configuração tanto do Prometheus quanto do Grafana.
- É necessário ter “exportadores” dedicados (como o node_exporter) instalados nos sistemas de destino.
- Pode apresentar uma curva de aprendizado mais íngreme para iniciantes devido à sua natureza distribuída.
Zabbix
O Zabbix é uma solução abrangente de monitoramento corporativo, capaz de supervisionar servidores Linux, aplicativos, dispositivos de rede e máquinas virtuais.

Prós:
- Destaca-se pelo acompanhamento histórico, alertas avançados e painéis flexíveis.
- Oferece agentes integrados e suporte a SNMP para ampla compatibilidade.
- Console de gerenciamento centralizado para ambientes de grande escala.
- Sistema abrangente de modelos para monitoramento consistente em vários hosts.
Contras:
- Apresenta uma curva de aprendizado mais íngreme em comparação com ferramentas mais simples, especialmente no que diz respeito à instalação inicial e a configurações complexas.
- Os requisitos de recursos para o servidor Zabbix podem ser maiores em implantações de grande porte.
Melhores práticas e técnicas de monitoramento para administradores de sistemas Linux
O monitoramento eficaz de sistemas Linux vai além da simples reação a alertas; ele exige uma abordagem proativa e estratégica. Ao adotarem essas técnicas essenciais, os administradores podem obter insights mais profundos, prevenir problemas e garantir o funcionamento ideal do sistema.
Aproveite a automação para tarefas rotineiras
As tarefas manuais de monitoramento e manutenção, especialmente em grandes infraestruturas, estão sujeitas a erros humanos e consomem um tempo valioso.
Automatize processos repetitivos, como análise de logs, coleta de dados de desempenho e até mesmo tarefas básicas de detecção de ameaças, como a identificação de entradas suspeitas nos logs. Isso libera os administradores para que possam se concentrar na resolução de problemas complexos e em iniciativas estratégicas, em vez de se dedicarem a tarefas rotineiras.
Implementar Infraestrutura como Código (IaC) para o monitoramento de configurações
Gerenciar configurações de monitoramento em vários servidores pode rapidamente levar a inconsistências se for feito manualmente. Ao tratar as configurações de monitoramento como código, as ferramentas de IaC permitem definir, controlar versões e implantar automaticamente as configurações. Isso garante uniformidade, reduz o desvio de configuração e minimiza erros humanos em seu ambiente de monitoramento.
Acompanhe a comunicação entre microsserviços com observabilidade
Nas arquiteturas modernas de microsserviços, é fundamental compreender as interações entre os serviços distribuídos.
Adote práticas de observabilidade, incluindo rastreamento distribuído e monitoramento de service mesh, para acompanhar os fluxos de comunicação, as dependências e a latência entre os serviços. Isso fornece informações essenciais sobre possíveis gargalos, taxas de erro e problemas de desempenho em aplicativos complexos.
Ajustar os parâmetros do kernel de forma estratégica
Para alcançar o desempenho ideal de um servidor Linux, muitas vezes é necessário ir além das configurações padrão. O ajuste fino dos parâmetros do kernel permite otimizações no nível do sistema específicas para a sua carga de trabalho, afetando o gerenciamento de memória, o comportamento da pilha de rede e o agendamento de E/S.
Esse é um processo iterativo — as alterações devem ser testadas em ambientes de teste e monitoradas de perto antes de serem aplicadas à produção.
Analisar proativamente padrões de tráfego anormais
A análise consistente dos padrões de tráfego de rede é uma prática essencial de segurança. Ao monitorar desvios em relação ao comportamento normal — como atividade incomum nas portas, picos repentinos de dados enviados ou acessos provenientes de regiões geográficas inesperadas —, os administradores podem detectar e impedir, em tempo real, acessos não autorizados ou ataques cibernéticos em andamento. Ferramentas automatizadas de detecção de anomalias podem auxiliar significativamente nessa vigilância.
Monitoramento do Linux em ambientes de nuvem e virtuais
Embora as métricas fundamentais do Linux continuem sendo essenciais, o monitoramento eficaz em ambientes de nuvem ou virtualizados apresenta complexidades específicas. As instâncias costumam ser efêmeras, escalam dinamicamente e fazem parte de arquiteturas de microsserviços altamente distribuídas. Isso exige uma estratégia mais flexível, já que as ferramentas tradicionais baseadas em agentes muitas vezes não conseguem acompanhar instâncias que são iniciadas e encerradas rapidamente.
Entre as principais considerações estão o aproveitamento de serviços de monitoramento nativos da nuvem (por exemplo, AWS CloudWatch, Azure Monitor), que oferecem detecção automática e integração nativa com os recursos da nuvem. Compreender o modelo de responsabilidade compartilhada do provedor de nuvem também é fundamental — definir claramente quais componentes (como hardware e rede básica) são monitorados por ele, em comparação com o que permanece sob sua responsabilidade (como VMs Linux, aplicativos e dados).
A transição para a observabilidade torna-se fundamental, com ênfase na coleta e correlação de métricas, logs e rastreamentos entre componentes distribuídos. Essa visibilidade detalhada é crucial para acompanhar a alocação dinâmica de recursos, otimizar os gastos com a nuvem por meio da identificação de recursos subutilizados e manter uma visibilidade consistente à medida que a infraestrutura sofre mudanças constantes.
Aprimore seu monitoramento do Linux: próximos passos
O monitoramento eficaz de sistemas Linux — seja em instalações locais, em ambientes virtuais ou em infraestruturas dinâmicas de nuvem — exige mais do que apenas ferramentas básicas ou respostas reativas. Conforme já exploramos, dominar esse cenário em constante evolução requer abordagens estratégicas para a análise de métricas, automação e o enfrentamento dos desafios específicos das implantações modernas do Linux, especialmente no que diz respeito à segurança e ao tempo de atividade. As ferramentas de automação do Linux podem ajudar ao automatizar tarefas repetitivas, como o monitoramento de configurações, a análise de logs e a detecção básica de ameaças, permitindo que os administradores se concentrem em questões complexas. Diante dessas demandas, depender exclusivamente de processos manuais pode gerar riscos e ineficiência.
É aqui que o KernelCare Enterprise da TuxCare se torna indispensável. Com a aplicação automatizada de patches sem necessidade de reinicialização, o KernelCare elimina o tempo de inatividade relacionado a patches e garante que sua infraestrutura Linux permaneça segura, em conformidade e estável, sem interrupções.
Pronto para simplificar a aplicação de patches no Linux e melhorar a segurança? Fale hoje mesmo com um especialista da TuxCare e descubra como o KernelCare pode ajudá-lo a automatizar o gerenciamento de patches e proteger seus servidores Linux.