Soporte técnico
 Documentación
 Inicio de sesión
 Contáctenos


Ir directamente al resumen generado por IA de esta entrada del blog 


Principales conclusiones
- La supervisión de Linux es esencial para garantizar el rendimiento, la seguridad, la disponibilidad y el cumplimiento de las cargas de trabajo.
- Utilice herramientas como htop, Netdata y Prometheus para realizar un seguimiento de la CPU, la memoria, la E/S del disco, la actividad de la red y el estado general del sistema.
- La supervisión es sólo la mitad de la ecuación. soluciones de parcheo sin reinicio como KernelCare para reducir el tiempo de inactividad y cerrar las brechas de seguridad.
La supervisión de servidores Linux conlleva una serie de retos únicos, que puede que no encuentre con otros sistemas operativos. Requiere un mayor nivel de conocimientos técnicos. Los administradores se encontrarán configurando y programando sus sistemas para lograr especificaciones óptimas.
Al principio, el proceso puede parecer intimidatorio. Aunque tiene una curva de aprendizaje, puedes superar la mayoría de los obstáculos si dominas los conceptos básicos y aprovechas las técnicas de automatización habituales. Si repites y dominas los conceptos básicos, llegarás muy lejos.
Sin embargo, para mantener los servidores en perfecto estado las 24 horas del día, los 7 días de la semana, se necesita algo más que una supervisión básica: se requieren estrategias integrales de seguridad continua, mantenimiento proactivo y actualizaciones sin interrupciones. Esta guía explorará estos aspectos esenciales.
Por qué es importante la supervisión de Linux
Supervisar sus sistemas Linux es esencial para mantener la estabilidad, el rendimiento y la seguridad de Linux, especialmente en entornos modernos y siempre activos.
He aquí por qué la supervisión de Linux es fundamental en 2026:

- Rendimiento: Detecte el uso elevado de CPU, memoria, disco o red antes de que afecte a los usuarios.
- Seguridad: Identifique a tiempo procesos inusuales, inicios de sesión fallidos o comportamientos sospechosos.
- Conformidad: Mantenga registros de auditoría y cumpla los requisitos normativos o específicos del sector.
- Disponibilidad: Evite las interrupciones y reduzca el tiempo medio de recuperación (MTTR).
- Eficacia: Optimice los recursos, evite el sobreaprovisionamiento y agilice las operaciones.
Los verdaderos retos de la supervisión de sistemas Linux
El sistema operativo Linux le ofrece un control y una flexibilidad increíbles, pero vigilar los sistemas modernos no es tan sencillo como ejecutar unos cuantos comandos. Dominar este paisaje dinámico, donde los problemas pueden esconderse a plena vista, es clave para una supervisión eficaz.
Despliegue e integración de herramientas
El ecosistema Linux está repleto de herramientas de supervisión, desde ligeras utilidades de línea de comandos hasta plataformas empresariales a gran escala. Pero más opciones no siempre significan mejor visibilidad.
El reto consiste en seleccionar la combinación adecuada de soluciones de supervisión, integrar fuentes de datos dispares y construir una visión unificada sin crear una proliferación de herramientas o silos de datos que compliquen el análisis y las alertas.
Entornos dinámicos y distribuidos
Los despliegues modernos de Linux a menudo implican vastas infraestructuras distribuidas con componentes efímeros como contenedores y microservicios. La supervisión de estas instancias altamente dinámicas y efímeras y de las cargas de trabajo efímeras plantea un reto importante, ya que requiere estrategias avanzadas para realizar un seguimiento del rendimiento, asignar recursos y garantizar la visibilidad en una infraestructura de TI en constante cambio.
Alerta Fatiga y ruido
Con el enorme volumen de métricas disponibles, un escollo común es generar demasiadas alertas o falsos positivos. Esto conduce a la fatiga de alerta, donde las advertencias críticas se pierden en el ruido.
Los administradores de sistemas se enfrentan al reto de ajustar los umbrales y crear sistemas de alerta inteligentes que proporcionen notificaciones oportunas y pertinentes sin abrumar a los equipos.
Análisis de las causas
Un pico repentino de la CPU podría significar una docena de cosas diferentes: un proceso fuera de control, un bloqueo de la base de datos o incluso un cuello de botella oculto en la red. En las complejas pilas de Linux, los síntomas rara vez apuntan directamente al problema. El reto consiste en reunir pistas a partir de registros, métricas y trazas para encontrar el problema real. Sin las herramientas de monitorización adecuadas, no queda más remedio que jugar a los detectives en lugar de solucionar los problemas.
Visibilidad de la seguridad y amenazas
La supervisión de la seguridad no consiste sólo en detectar amenazas conocidas, sino también en identificar comportamientos anómalos, accesos no autorizados y procesos sospechosos.
El reto consiste en examinar una gran cantidad de registros y datos del sistema para detectar indicadores sutiles de peligro, mantener registros de auditoría y garantizar el cumplimiento continuo en un panorama de amenazas en constante evolución.
Gastos generales de mantenimiento y tiempos de inactividad
La supervisión puede identificar las vulnerabilidades de Linux, pero parchearlas con seguridad es otro reto. Los reinicios durante las actualizaciones del kernel siguen provocando tiempos de inactividad. Sin la aplicación de parches sin reinicios, el mantenimiento se convierte en un riesgo operativo recurrente. Garantizar una alta disponibilidad durante estos procedimientos necesarios y minimizar el riesgo de reinicios y tiempos de inactividad es un equilibrio constante para los administradores.
Métricas clave de los servidores Linux
La monitorización eficaz de Linux también depende del seguimiento de los indicadores correctos. A continuación se presentan las métricas más importantes de la CPU, la memoria, el disco, la red y la salud del sistema, cruciales para la detección temprana de problemas y el mantenimiento del tiempo de actividad.
1. Utilización de la CPU
- Registra cuánta potencia de procesamiento se está utilizando.
- Supervisa la CPU del usuario frente a la del sistema, el tiempo de inactividad y el iowait.
- Herramientas útiles: top, htop, mpstat.
- Un iowait alto suele indicar cuellos de botella subyacentes en la E/S del disco, no sólo una sobrecarga de la CPU.
2. Utilización de la memoria
- Mide el uso de RAM, memoria libre y uso de swap.
- Supervisar los fallos de página y el consumo de búfer/caché.
- Herramientas: free, vmstat, sar, smem.
- El uso excesivo de swap es un fuerte indicador de la presión de la memoria, lo que conduce a una degradación significativa del rendimiento.
3. E/S de disco
- Seguimiento de la velocidad de lectura/escritura, IOPS y tiempo de espera de E/S
- Utilice iostat, iotop o dstat para la supervisión de discos
- La alta latencia de E/S suele afectar primero al rendimiento de la aplicación
4. Rendimiento de la red y errores
- Supervisión en red de las tasas de RX/TX, paquetes perdidos y estados de conexión.
- Herramientas: ifstat, ss, netstat, nload, vnstat.
- Esencial para detectar saturación de ancho de banda, pérdida de paquetes, cuellos de botella en la red o posibles ataques DDoS.
5. Carga Media
- Indica el número medio de procesos en espera de tiempo de CPU.
- Monitoriza las medias de 1, 5 y 15 minutos.
- Herramientas: tiempo de actividad, top.
- Una carga sostenida superior al número de núcleos de la CPU suele significar una sobrecarga del sistema.
6. Tiempo de actividad y disponibilidad
- Realiza un seguimiento del tiempo de arranque del sistema, la duración del tiempo de actividad y los reinicios inesperados.
- Herramientas: uptime, who -b, último reinicio.
- Fundamental para cumplir los acuerdos de nivel de servicio, hacer un seguimiento de la fiabilidad del sistema y planificar el mantenimiento programado para la continuidad de la actividad.
7. Uso del sistema de archivos
- Supervisa el espacio en disco, el uso de inodos y la capacidad de los puntos de montaje.
- Herramientas: df -h, du -sh, ncdu.
- Los discos llenos pueden provocar fallos en las escrituras, caídas de las aplicaciones e interrupciones en el registro.
8. Salud de los procesos y servicios
- Compruebe si los procesos críticos se están ejecutando y consumen los recursos previstos.
- Herramientas: ps, pidstat, systemctl status.
- Crítico para alertar sobre fallos de servicio, paradas inesperadas o procesos zombis.
Las mejores herramientas para supervisar Linux
A continuación se presentan algunas de las principales herramientas de monitorización de Linux a tener en cuenta, que cubren tanto las utilidades de línea de comandos como las plataformas de nivel empresarial. Cada herramienta tiene sus pros y sus contras, lo que determinará su idoneidad para las necesidades de monitorización específicas de su equipo.
htop
htop, una utilidad de línea de comandos interactiva y mejorada, proporciona una vista en tiempo real de los promedios de CPU, memoria, swap, árboles de procesos y carga.

Pros:
- Interfaz con código de colores y teclado para facilitar la navegación.
- Ideal para realizar comprobaciones rápidas e interactivas de los recursos y controlar los procesos.
- Ligero y ampliamente disponible en la mayoría de las distribuciones de Linux.
Contras:
- Carece de seguimiento de datos históricos.
- Principalmente para información en tiempo real de un solo servidor.
btop
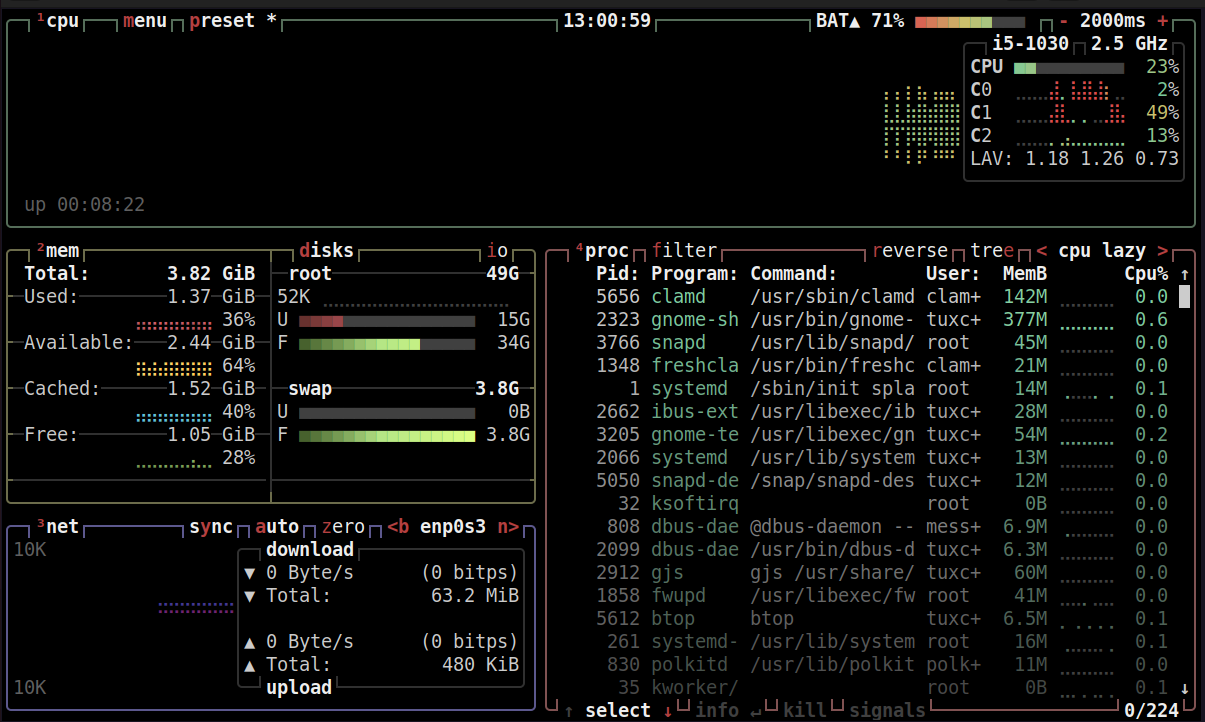
btop (y sus predecesores, como bashtop/bpytop), un monitor del sistema visualmente impresionante y con muchas funciones, ofrece información en tiempo real sobre la actividad de la CPU, la RAM, el disco y la red a través de una atractiva interfaz de terminal.
Pros:
- Interfaz de usuario moderna y con gran capacidad de respuesta, compatible con el ratón y ampliamente personalizable.
- Proporciona métricas más detalladas y una mejor visualización que htop en un terminal.
- Excelente para la supervisión interactiva local o basada en SSH.
Contras:
- Su riqueza visual puede consumir algo más de recursos que las herramientas CLI más sencillas.
- Menos ideal para scripts puros o agentes remotos con muy pocos recursos donde sólo se necesita salida de texto sin procesar.
iotop
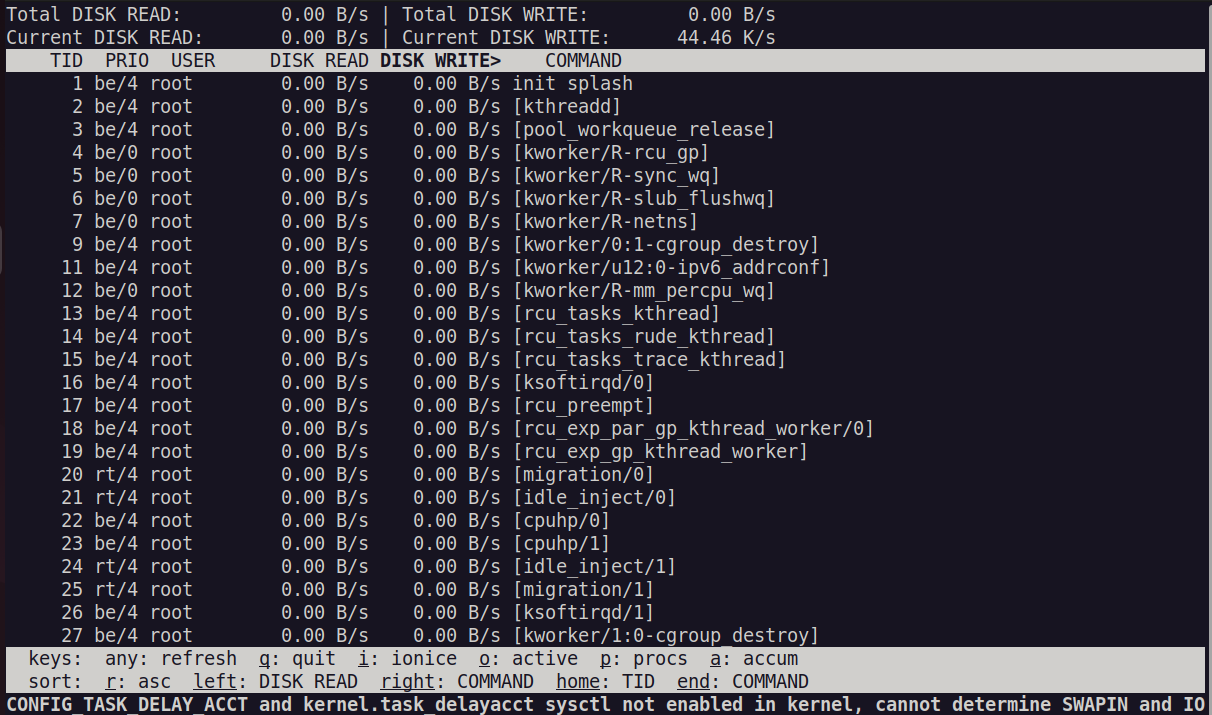
iotop es una utilidad de línea de comandos diseñada específicamente para rastrear el uso de E/S de disco por proceso. Es muy valiosa para identificar en tiempo real qué procesos están causando cuellos de botella en el disco, por lo que es una herramienta imprescindible durante las ralentizaciones de rendimiento.
Pros:
- Proporciona estadísticas de E/S de disco en tiempo real y por proceso.
- Excelente para localizar aplicaciones o procesos específicos que causan cuellos de botella en los discos.
- Sencillo y directo para la solución inmediata de problemas.
Contras:
- Normalmente requiere privilegios de root para ejecutarse.
- Se centra únicamente en la E/S del disco, no es un monitor completo del sistema.
Netdata
Netdata es un agente de supervisión de alta fidelidad en tiempo real que proporciona información instantánea sobre cientos de parámetros del sistema a través de paneles web interactivos y alertas de estado.

Pros:
- Extremadamente ligero, autoconfigurable y prácticamente sin mantenimiento.
- Ofrece una granularidad profunda y por segundos para la solución inmediata de problemas.
- La interfaz de usuario web interactiva es accesible desde cualquier navegador.
- La arquitectura distribuida permite implantaciones empresariales escalables.
Contras:
- Requiere un navegador web para sus cuadros de mando, menos ideal para entornos CLI puros.
- Puede requerir más reflexión para la conservación de datos a largo plazo en comparación con las bases de datos dedicadas a series temporales.
Prometheus + Grafana
Esta potente combinación aprovecha Prometheus para raspar y almacenar métricas de series temporales, mientras que Grafana proporciona una sólida visualización a través de paneles personalizables y alertas integradas.

Pros:
- Alta escalabilidad, flexibilidad y gestión de alertas para entornos complejos.
- Ideal para infraestructuras Linux nativas en la nube, de microservicios e híbridas.
- Amplio ecosistema de exportadores para diversos servicios y aplicaciones.
- Código abierto con fuerte apoyo comunitario.
Contras:
- Requiere la configuración inicial de Prometheus y Grafana.
- Necesita "exportadores" dedicados (como node_exporter) instalados en los sistemas de destino.
- Puede tener una curva de aprendizaje más pronunciada para los principiantes debido a su naturaleza distribuida.
Zabbix
Zabbix es una completa solución de monitorización empresarial capaz de supervisar servidores Linux, aplicaciones, dispositivos de red y máquinas virtuales.

Pros:
- Gran capacidad de seguimiento histórico, alertas avanzadas y cuadros de mando flexibles.
- Proporciona agentes incorporados y soporte SNMP para una amplia compatibilidad.
- Consola de gestión centralizada para entornos a gran escala.
- Amplio sistema de plantillas para una supervisión coherente en muchos hosts.
Contras:
- Tiene una curva de aprendizaje más pronunciada en comparación con herramientas más sencillas, especialmente para la configuración inicial y las configuraciones complejas.
- Los requisitos de recursos para el servidor Zabbix pueden ser mayores para despliegues muy grandes.
Mejores prácticas y técnicas de supervisión para administradores de sistemas Linux
La supervisión eficaz de los sistemas Linux va más allá de la simple reacción a las alertas; requiere un enfoque proactivo y estratégico. Mediante la adopción de estas técnicas clave, los administradores pueden obtener información más profunda, prevenir problemas y garantizar la salud óptima del sistema.
Automatización de tareas rutinarias
Las tareas manuales de supervisión y mantenimiento, especialmente en grandes infraestructuras, son propensas a errores humanos y consumen un tiempo valioso.
Automatice procesos repetitivos como el análisis de registros, la recopilación de datos de rendimiento e incluso tareas básicas de detección de amenazas, como la identificación de entradas de registro sospechosas. Esto libera a los administradores para que puedan centrarse en la resolución de problemas complejos y en iniciativas estratégicas, en lugar de en el trabajo rutinario.
Implantar la infraestructura como código (IaC ) para supervisar las configuraciones
La gestión de las configuraciones de supervisión en numerosos servidores puede dar lugar rápidamente a incoherencias si se hace manualmente. Al tratar las configuraciones de monitorización como código, las herramientas de IaC le permiten definir, controlar las versiones y desplegar automáticamente las configuraciones. Esto garantiza la uniformidad, reduce la desviación de la configuración y minimiza el error humano en su entorno de supervisión.
Seguimiento de la comunicación entre microservicios con Observability
En las arquitecturas de microservicios modernas, es primordial comprender las interacciones entre los servicios distribuidos.
Adopte prácticas de observabilidad, como el rastreo distribuido y la supervisión de la malla de servicios, para realizar un seguimiento de los flujos de comunicación, las dependencias y la latencia entre servicios. Esto proporciona información crucial sobre posibles cuellos de botella, tasas de error y problemas de rendimiento en aplicaciones complejas.
Ajuste estratégico de los parámetros del núcleo
Lograr un rendimiento óptimo del servidor Linux a menudo requiere algo más que la configuración predeterminada. El ajuste fino de los parámetros del kernel permite realizar optimizaciones a nivel de sistema específicas para su carga de trabajo, que afectan a la gestión de la memoria, el comportamiento de la pila de red y la programación de E/S.
Se trata de un proceso iterativo: los cambios deben probarse en entornos de ensayo y supervisarse de cerca antes de aplicarlos a la producción.
Analizar proactivamente los patrones de tráfico anómalos
El análisis coherente de los patrones de tráfico de red es una práctica de seguridad fundamental. Mediante la supervisión de las desviaciones del comportamiento normal -como la actividad inusual de los puertos, los picos repentinos en los datos salientes o el acceso desde zonas geográficas inesperadas- los administradores pueden detectar y prevenir el acceso no autorizado o los ciberataques en curso en tiempo real. Las herramientas automatizadas de detección de anomalías pueden ayudar significativamente en esta vigilancia.
Supervisión de Linux en entornos virtuales y de nube
Aunque las métricas fundamentales de Linux siguen siendo críticas, la supervisión eficaz en entornos virtualizados o en la nube introduce complejidades distintas. Las instancias suelen ser efímeras, escalar dinámicamente y formar parte de arquitecturas de microservicios altamente distribuidas. Esto exige una estrategia más flexible, ya que las herramientas tradicionales basadas en agentes a menudo se quedan cortas a la hora de realizar el seguimiento de instancias que se activan y desactivan rápidamente.
Las consideraciones clave incluyen el aprovechamiento de los servicios de supervisión nativos de la nube (por ejemplo, AWS CloudWatch, Azure Monitor), que ofrecen detección automática e integración nativa con los recursos de la nube. Comprender el modelo de responsabilidad compartida del proveedor de la nube también es vital: definir claramente qué componentes (como el hardware y las redes principales) supervisan, frente a lo que sigue siendo su responsabilidad (como las máquinas virtuales Linux, las aplicaciones y los datos).
El cambio hacia la observabilidad se convierte en primordial, haciendo hincapié en la recopilación y correlación de métricas, registros y trazas en todos los componentes distribuidos. Esta visibilidad detallada es crucial para realizar un seguimiento de la asignación dinámica de recursos, optimizar el gasto en la nube identificando los recursos infrautilizados y mantener una visibilidad coherente a medida que la infraestructura cambia constantemente.
Mejore su supervisión de Linux: Próximos pasos
La supervisión eficaz de los sistemas Linux, ya sea en instalaciones locales, en entornos virtuales o en infraestructuras dinámicas en la nube, exige algo más que herramientas básicas o respuestas reactivas. Como hemos visto, dominar este panorama en constante evolución requiere enfoques estratégicos para el análisis métrico, la automatización y la resolución de los retos únicos que plantean las implementaciones modernas de Linux, especialmente en lo que respecta a la seguridad y el tiempo de actividad. Las herramientas de automatización de Linux pueden ayudar a automatizar tareas repetitivas, como la supervisión de la configuración, el análisis de registros y la detección básica de amenazas, lo que permite a los administradores centrarse en cuestiones más complejas. Dadas estas exigencias, confiar únicamente en procesos manuales puede suponer un riesgo y una ineficiencia.
Aquí es donde KernelCare Enterprise de TuxCare adquiere un valor incalculable. Con la aplicación de parches automatizada y sin reinicios, KernelCare elimina el tiempo de inactividad relacionado con los parches y garantiza que su infraestructura Linux siga siendo segura, conforme y estable sin interrupciones.
¿Está preparado para simplificar la aplicación de parches en Linux y mejorar la seguridad? Hable hoy mismo con un experto de TuxCare y descubra cómo KernelCare puede ayudarle a automatizar la gestión de parches y proteger sus servidores Linux.