
 Support technique
 Documentation
 Connexion
 Nous contacter


Accédez directement au résumé généré par l'IA de cet article de blog 


- Les temps d'arrêt de Linux se produisent lorsque les systèmes ou les services deviennent temporairement indisponibles.
- Même les temps d'arrêt planifiés entraînent des coûts réels en termes de productivité, de revenus et d'exposition à la sécurité.
- L'application automatisée de correctifs en direct supprime le besoin de redémarrage, ce qui permet une disponibilité continue et un déploiement plus rapide des correctifs.
Dans les entreprises où le temps de fonctionnement est synonyme de chiffre d'affaires, même de brefs redémarrages de redémarrage de Linux peuvent provoquer des perturbations majeures. Les activités routinières de l'administrateur système, telles que les cycles de correctifs, les fenêtres de maintenance et les vérifications après redémarrage, réduisent discrètement la productivité, retardent les opérations et augmentent le risque de manquer des mises à jour de sécurité. Chaque minute de temps d'arrêt peut avoir un impact significatif sur l'expérience des clients, la performance des accords de niveau de service et la performance globale de l'entreprise.
Cet article analyse le coût réel des temps d'arrêt de Linux - des dépenses cachées liées aux fenêtres de maintenance aux risques de sécurité liés à un retard dans l'application des correctifs - et explique comment live patching peut aider les entreprises à éliminer complètement les temps d'arrêt liés aux correctifs.
Quelles sont les causes des temps d'arrêt de Linux ?
Les systèmes Linux connaissent des temps d'arrêt non seulement en raison de pannes ou de défaillances, mais aussi, dans la plupart des cas, en raison de mises à jour. Les fréquentes mises à jour du noyau et des bibliothèques nécessitent un redémarrage, ce qui entraîne des interruptions courtes mais fréquentes. Le noyau Linux est responsable de la gestion de la mémoire, du processeur et du matériel. Lorsque ce composant central est mis à jour, le serveur doit redémarrer afin de charger correctement la nouvelle image du noyau. L'ensemble de ce processus devient donc une source d'interruption inévitable des services.
Parmi les sources courantes d'indisponibilité de Linux, on peut citer
- Mises à jour du noyau et correctifs de sécurité qui nécessitent des redémarrages.
- Fenêtres de maintenance programmées pour les mises à jour du système d'exploitation ou des applications.
- Remplacements de matériel ou changements de configuration qui mettent les services hors ligne.
- Défaillances inattendues de dépendances ou de services pendant les redémarrages.
Même lorsque les temps d'arrêt sont planifiés, ces événements perturbent les charges de travail critiques, retardent les travaux par lots et ont un impact sur les utilisateurs finaux.
Les coûts cachés de l'indisponibilité de Linux
Perte de productivité
Chaque redémarrage ou fenêtre de maintenance entraîne la perte d'un temps précieux pour le personnel. Les administrateurs système doivent planifier les temps d'arrêt, exécuter les correctifs et vérifier la stabilité après le redémarrage. Lorsque des dizaines ou des centaines de serveurs sont concernés, cela se transforme en un cycle répétitif qui peut absorber des journées entières de travail chaque mois. Les équipes passent des heures à attendre que les systèmes redémarrent, à recharger les services et à résoudre les problèmes après le redémarrage. Cette inefficacité détourne les informaticiens qualifiés des projets d'innovation, d'optimisation et d'automatisation. Au bout d'un an, ce ralentissement de la maintenance se traduit par une perte importante de productivité opérationnelle et de vélocité des projets.
Recettes et impact sur les clients
Pour les services en contact avec la clientèle, il suffit de quelques minutes d'indisponibilité pour avoir un impact direct sur les résultats de l'entreprise. Les plateformes de commerce électronique risquent d'abandonner des paniers, les fournisseurs de SaaS s'exposent à des pénalités au titre des accords de niveau de service (SLA) et les institutions financières n'effectuent aucune transaction en raison de l'indisponibilité de leurs systèmes. Dans les secteurs où le temps de fonctionnement définit la réputation, les clients s'attendent à une disponibilité 24 heures sur 24 et 7 jours sur 7 - et remarquent immédiatement lorsque les systèmes sont hors service.
Les fenêtres de maintenance mal programmées ou répétées peuvent faire fuir les utilisateurs, entraînant une mauvaise réputation et une diminution de la crédibilité de la marque. Ces dommages financiers et de réputation s'étendent bien au-delà du département informatique, affectant les performances commerciales et la fidélité des clients à long terme.
Exposition à la sécurité due à un retard dans l'application des correctifs
Un temps d'arrêt est souvent nécessaire pour corriger le noyau, et les équipes finissent donc par repousser les mises à jour pour éviter les perturbations. Un tel retard ouvre une fenêtre de vulnérabilité qui peut durer des jours, voire des semaines - précisément la période exploitée par les attaquants. Non seulement le retard dans l'application des correctifs augmente la probabilité d'une violation des données, mais il affaiblit également la conformité des organisations avec les cadres réglementaires tels que PCI DSS, HIPAAou FIPS.
Lorsqu'un incident de sécurité se produit, les coûts grimpent en flèche : réponse à l'incidentl'analyse médico-légale, la remédiation et les amendes potentielles. Paradoxalement, le fait d'éviter une brève période d'indisponibilité a souvent pour conséquence que le rétablissement après une attaque prend beaucoup plus de temps, voire un temps d'indisponibilité exponentiellement plus important.
Frais généraux opérationnels et coûts de planification
Les fenêtres de maintenance, qu'elles soient planifiées ou non, peuvent entraîner des frais généraux opérationnels considérables. Les équipes informatiques doivent impérativement se coordonner avec les différents services, programmer les temps d'arrêt pendant les heures de faible trafic, informer les parties prenantes et obtenir l'approbation de la gestion des changements.
Dans les environnements critiques, la maintenance nécessite un séquençage complexe pour garantir la stabilité du système et être prêt à revenir en arrière en cas de problèmes imprévus. Chacune de ces étapes représente des coûts cachés - du temps consacré non pas à l'innovation mais à l'atténuation des risques. Au fil du temps, ces efforts de coordination répétitifs se traduisent par des centaines d'heures de travail par an, ce qui nuit à l'efficacité des technologies de l'information.
Calculer le coût réel de l'indisponibilité de Linux : Une analyse rapide
Pour aller au-delà des coûts anecdotiques, les entreprises doivent utiliser un modèle complet pour déterminer l'exposition financière réelle de l'interruption du système. Une façon simple d'estimer l'impact des temps d'arrêt est la suivante :
Coût total des temps d'arrêt = perte de revenus directs + coût de la main-d'œuvre informatique + valeur de l'exposition au risque + pénalités de l'accord de niveau de service (SLA) + frais généraux de récupération
La valeur d'exposition au risque est la partie de l'équation la plus difficile à modéliser correctement. C'est la partie qui attribue une valeur monétaire à l'événement de sécurité qui se produit lorsque le service informatique retarde intentionnellement l'installation des correctifs de sécurité. Néanmoins, si l'on travaille uniquement sur le coût de la main-d'œuvre, l'entreprise y voit souvent une révélation immédiate.
Le calcul du nombre total d'heures consommées par les administrateurs système, les développeurs et les chefs de projet - pendant, avant et après chaque redémarrage du noyau - montre immédiatement que la charge opérationnelle est une "taxe sur les temps d'arrêt" importante et continue. Toute solution permettant de réduire à zéro cette composante temporelle offre un Retour sur investissement (ROI).
De nombreuses études sectorielles indiquent que le coût moyen d'un temps d'arrêt informatique peut varier entre des milliers et des dizaines de milliers de dollars par minute, en fonction de l'importance des services affectés. A rapport de 2016 de l'Institut Ponemon estimait le coût moyen d'un temps d'arrêt informatique à 9 000 dollars par minute. Même si votre organisation est moins confrontée à ce type de problèmes, l'effet cumulatif des redémarrages réguliers de Linux dans un environnement distribué peut tranquillement se transformer en un centre de coûts important.
Pourquoi les redémarrages de Linux restent un problème
Les redémarrages sont souvent considérés comme une partie inévitable de la maintenance des systèmes, en particulier lorsqu'il s'agit d'appliquer des correctifs au noyau (kernel patching). correctifs du noyau. Chaque mise à jour du noyau nécessite un redémarrage pour charger la nouvelle version en mémoire. Bien que cela puisse sembler anodin, le temps d'arrêt nécessaire pour redémarrer les serveurs, vérifier les services et resynchroniser les systèmes en grappe peut facilement s'étendre de quelques minutes à plusieurs heures. Pendant cette période, les applications sont en attente, les transactions échouent et les utilisateurs ne peuvent pas accéder au système.
Dans les environnements en grappes ou virtualisés, l'impact est multiplié. Le redémarrage d'un hôte peut déclencher des arrêts en cascade dans les services dépendants, créant une instabilité temporaire dans les charges de travail de production. Pour les entreprises qui ont des exigences strictes en matière de disponibilité, la coordination de redémarrages et de basculements échelonnés ajoute à la complexité opérationnelle - et au risque.
En fin de compte, les redémarrages restent l'un des rares facteurs à l'origine de temps d'arrêt prévisibles dans les environnements Linux. Ils ne sont pas le résultat d'une défaillance matérielle ou d'un bogue logiciel, mais font plutôt partie du processus global de maintenance lui-même. C'est pourquoi l'élimination des besoins de redémarrage figure désormais parmi les principales priorités des organisations qui cherchent à maximiser simultanément le temps de fonctionnement et la sécurité.
L'avantage du Live Patching : Élimination totale des temps d'arrêt
L'application de correctifs en direct modifie la façon dont les systèmes Linux sont maintenus en supprimant la nécessité de redémarrer après les mises à jour du noyau. Au lieu de mettre les serveurs hors ligne, les correctifs de sécurité sont appliqués directement au noyau en cours d'exécution, ce qui garantit la sécurité, la conformité et la disponibilité permanente des systèmes.
Avec les correctifs en direct, les équipes informatiques n'ont plus besoin de programmer des fenêtres de maintenance ou d'attendre les heures creuses pour déployer les mises à jour. Les correctifs sont injectés de manière transparente pendant que les charges de travail continuent de fonctionner, et le système reste stable tout au long du processus. Cela signifie qu'il n'y a aucune interruption pour les utilisateurs, les applications ou les environnements de production.
KernelCare de TuxCare de TuxCare permet aux entreprises d'appliquer automatiquement les correctifs critiques du noyau en temps réel, sans redémarrer ni interrompre les charges de travail. Les correctifs peuvent être déployés dès qu'ils sont disponibles, réduisant ainsi la fenêtre de vulnérabilité qui existe généralement lorsque les mises à jour sont reportées. Les entreprises peuvent ainsi rester en conformité avec les normes réglementaires qui exigent des correctifs en temps voulu, sans sacrifier la disponibilité.
KernelCare prend en charge la plupart des grandes distributions Linux d'entreprise, notamment RHEL, CentOS, AlmaLinux, Rocky Linux, Oracle Linux, CloudLinux, Ubuntu, Amazon Linux, etc.
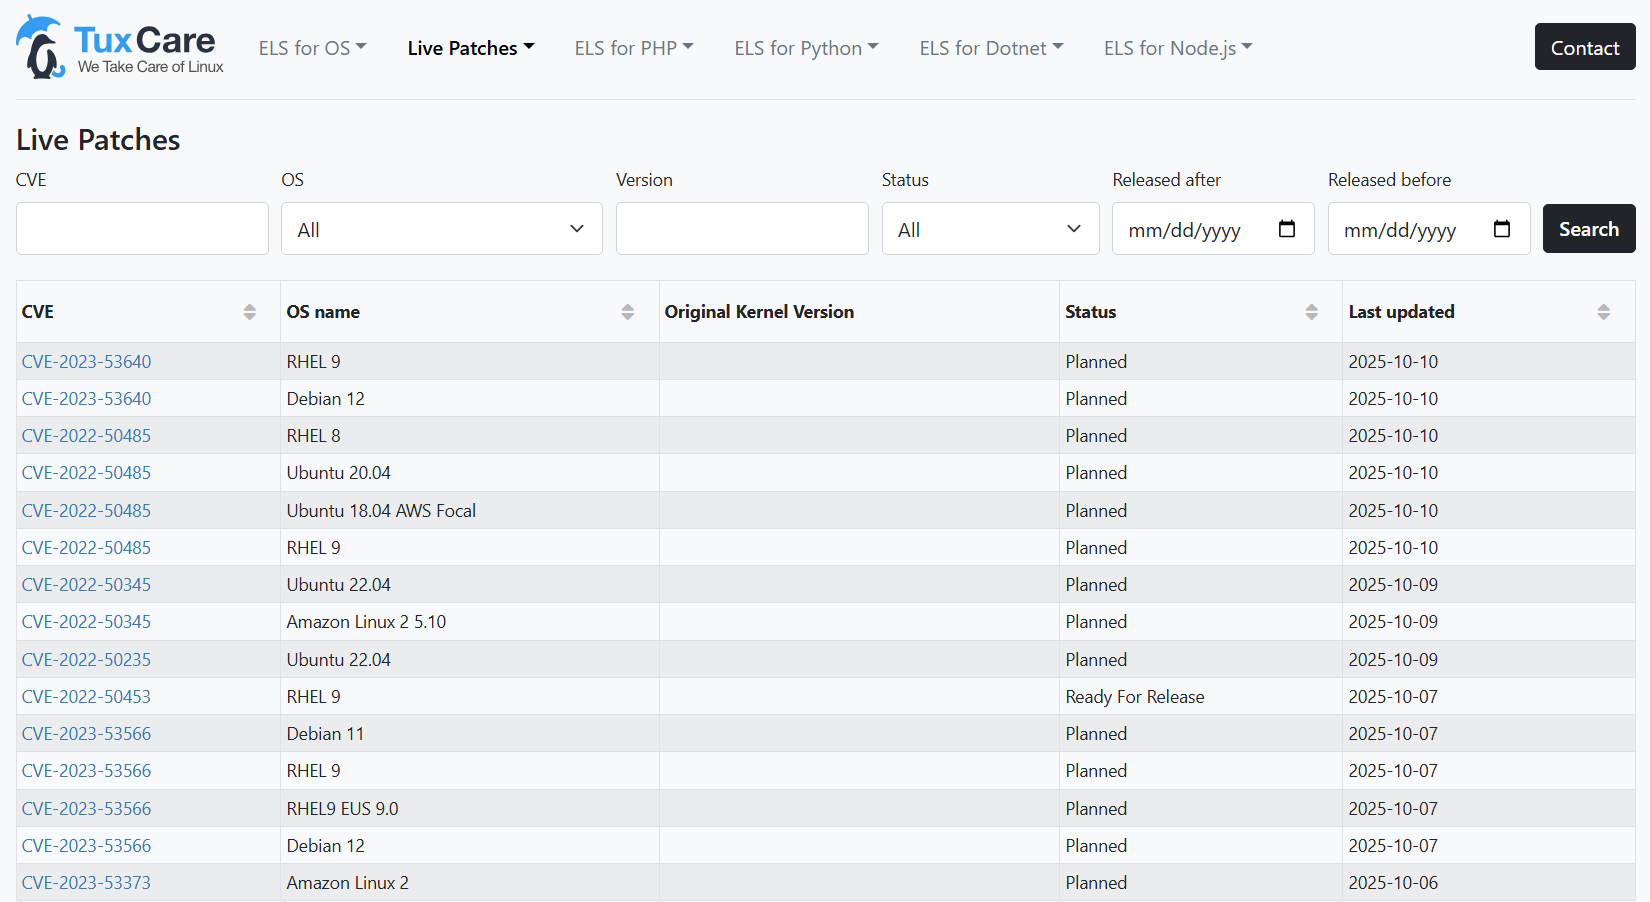
Visiter le tableau de bord CVE de TuxCare pour obtenir une vue détaillée des CVE du noyau Linux, montrant quelles vulnérabilités ont été corrigées dans toutes les distributions prises en charge.
Corrections du noyau Linux sans redémarrage avec KernelCare
Les temps d'arrêt ne sont pas seulement un désagrément - c'est un coût récurrent qui affecte la productivité, l'expérience client et la sécurité. Les modèles de correctifs traditionnels qui dépendent des redémarrages ne sont plus adaptés aux infrastructures modernes, toujours actives.
En adoptant les correctifs en direct, les entreprises peuvent éliminer les temps d'arrêt planifiés, combler plus rapidement les lacunes en matière de vulnérabilité et libérer les équipes informatiques des cycles de maintenance répétitifs. L'application de correctifs en direct est un investissement fondamental pour toute entreprise qui s'engage à assurer une disponibilité à 100 % et une sécurité proactive à grande échelle.
Avec KernelCare de TuxCare et LibCare de TuxCare, vous pouvez appliquer le noyau et les bibliothèques partagées (glibc et OpenSSL) automatiquement - sans redémarrage, interruption de service ou fenêtre de maintenance.

