
 Technischer Support
 Dokumentation
 Anmeldung
 Kontakt


Gehen Sie direkt zu einer KI-Zusammenfassung dieses Blogbeitrags 


- Linux-Ausfallzeiten entstehen, wenn Systeme oder Dienste vorübergehend nicht mehr verfügbar sind.
- Selbst geplante Ausfallzeiten verursachen reale Kosten in Bezug auf Produktivität, Umsatz und Sicherheitsrisiken.
- Automatisiertes Live-Patching macht Neustarts überflüssig und ermöglicht eine kontinuierliche Betriebszeit und eine schnellere Bereitstellung von Patches.
In Unternehmensumgebungen, in denen die Betriebszeit gleich dem Umsatz ist, sind selbst kurze Linux-Reboots zu erheblichen Unterbrechungen führen. Die routinemäßigen Aktivitäten von Systemadministratoren wie Patching-Zyklen, Wartungsfenster und Prüfungen nach dem Neustart beeinträchtigen die Produktivität, verzögern den Betrieb und erhöhen das Risiko verpasster Sicherheitsupdates. Jede Minute Ausfallzeit kann erhebliche Auswirkungen auf die Kundenerfahrung, die SLA-Leistung und die allgemeine Unternehmensleistung haben.
In diesem Artikel werden die wahren Kosten von Linux-Ausfallzeiten aufgeschlüsselt - von den versteckten Kosten von Wartungsfenstern bis hin zu den Sicherheitsrisiken durch verzögerte Patches - und es wird erklärt, wie Live-Patching Unternehmen helfen kann, patchingbedingte Ausfallzeiten vollständig zu vermeiden.
Was sind die Ursachen für Linux-Ausfallzeiten?
Bei Linux-Systemen kommt es nicht nur aufgrund von Abstürzen oder Ausfällen zu Ausfallzeiten, sondern in den meisten Fällen aufgrund von Aktualisierungen. Häufige Kernel- und Bibliotheksaktualisierungen erfordern einen Neustart, was zu kurzen, aber häufigen Unterbrechungen führt. Der Linux-Kernel ist für die Verwaltung von Speicher, CPU und Hardware zuständig. Wenn diese Kernkomponente aktualisiert wird, muss der Server neu gestartet werden, um das neue Kernel-Image korrekt zu laden. Daher wird dieser gesamte Prozess zu einer Quelle unvermeidlicher Unterbrechungen der Dienste.
Einige häufige Ursachen für Linux-Ausfallzeiten sind:
- Kernel-Updates und Sicherheits-Patches die Neustarts erfordern.
- Geplante Wartungsfenster für Betriebssystem- oder Anwendungs-Upgrades.
- Austausch von Hardware oder Konfigurationsänderungen die Dienste offline nehmen.
- Unerwartete Ausfälle von Abhängigkeiten oder Diensten während eines Neustarts.
Selbst wenn Ausfallzeiten geplant sind, stören solche Ereignisse kritische Workloads, verzögern Batch-Aufträge und beeinträchtigen die Endbenutzer.
Die versteckten Kosten von Linux-Ausfallzeiten
Produktivitätsverluste
Jeder Neustart oder jedes Wartungsfenster bedeutet den Verlust wertvoller Arbeitszeit. Systemadministratoren müssen Ausfallzeiten planen, Patches ausführen und die Stabilität nach dem Neustart überprüfen. Wenn Dutzende oder Hunderte von Servern betroffen sind, wird dies zu einem sich wiederholenden Zyklus, der jeden Monat ganze Arbeitstage verschlingen kann. Teams verbringen Stunden damit, auf den Neustart der Systeme zu warten, Dienste neu zu laden und Probleme nach dem Neustart zu beheben. Diese Ineffizienz lenkt qualifizierte IT-Experten von Innovations-, Optimierungs- und Automatisierungsprojekten ab. Im Laufe eines Jahres wird dieser Wartungsstau zu einem erheblichen Verlust an betrieblicher Produktivität und Projektgeschwindigkeit.
Auswirkungen auf Umsatz und Kunden
Bei kundenorientierten Diensten können sich schon wenige Minuten Ausfallzeit direkt auf die Geschäftsergebnisse auswirken. E-Commerce-Plattformen riskieren verlassene Warenkörbe, SaaS-Anbieter müssen mit Vertragsstrafen für Service-Level-Agreements (SLA) rechnen, und Finanzinstitute können aufgrund von Nichtverfügbarkeit keine Transaktionen durchführen. In Branchen, in denen die Betriebszeit den Ruf definiert, erwarten die Kunden eine 24/7-Verfügbarkeit - und merken sofort, wenn Systeme offline gehen.
Schlecht getimte oder wiederholte Wartungsfenster können Benutzer vergraulen, was zu einem schlechten Ruf und einem Rückgang der Glaubwürdigkeit der Marke führt. Dieser finanzielle und rufschädigende Schaden geht weit über die IT-Abteilung hinaus und beeinträchtigt die Verkaufsleistung und die langfristige Kundenbindung.
Sicherheitsprobleme durch verzögerte Patches
Für das Kernel-Patching ist oft eine Ausfallzeit erforderlich, so dass die Teams die Aktualisierungen aufschieben, um Störungen zu vermeiden. Eine solche Verzögerung öffnet ein Fenster für Schwachstellen, das Tage bis Wochen dauern kann - genau der Zeitraum, den Angreifer ausnutzen. Ein verzögertes Patching erhöht nicht nur die Wahrscheinlichkeit von Datenschutzverletzungen, sondern schwächt auch die Einhaltung von Vorschriften wie PCI DSS, HIPAAoder FIPS.
Sobald ein Sicherheitsvorfall eintritt, steigen die Kosten drastisch an: Reaktion auf den Vorfallforensische Analyse, Abhilfemaßnahmen und mögliche Geldstrafen. Ironischerweise führt die Vermeidung eines kurzen Ausfallzeitfensters oft dazu, dass die Wiederherstellung nach einem Angriff viel länger dauert, sogar exponentiell länger, was die Ausfallzeit betrifft.
Operative Gemeinkosten und Planungskosten
Wartungsfenster, ob geplant oder nicht, können zu enormen Betriebskosten führen. Die IT-Teams müssen sich mit den verschiedenen Abteilungen abstimmen, Ausfallzeiten zu Zeiten mit geringem Datenverkehr einplanen, die Beteiligten benachrichtigen und Genehmigungen des Änderungsmanagements einholen.
In unternehmenskritischen Umgebungen erfordert die Wartung eine komplexe Abfolge von Schritten, um die Systemstabilität zu gewährleisten und bei unvorhergesehenen Problemen ein Rollback zu ermöglichen. Jeder dieser Schritte verursacht versteckte Kosten - Zeit, die nicht für Innovationen, sondern für die Risikominderung aufgewendet wird. Im Laufe der Zeit summieren sich diese sich wiederholenden Koordinierungsbemühungen auf Hunderte von Personalstunden pro Jahr und beeinträchtigen die IT-Effizienz nachhaltig.
Berechnung der tatsächlichen Kosten von Linux-Ausfallzeiten: Eine schnelle Aufschlüsselung
Um über die anekdotischen Kosten hinauszukommen, müssen Unternehmen ein umfassendes Modell verwenden, um das tatsächliche finanzielle Risiko einer Systemunterbrechung zu ermitteln. Eine einfache Methode zur Abschätzung der Auswirkungen von Ausfallzeiten ist:
Gesamtkosten der Ausfallzeit = Direkte Umsatzeinbußen + IT-Arbeitskosten + Risikowert + SLA-Strafen + Wiederherstellungsgemeinkosten
Der Risikowert ist der Teil der Gleichung, der am schwierigsten korrekt zu modellieren ist. Es ist der Teil, der dem Sicherheitsereignis, das eintritt, wenn die IT-Abteilung die Installation von Sicherheits-Patches absichtlich verzögert, einen Geldwert zuweist. Wenn jedoch nur die Arbeitskosten berücksichtigt werden, fällt dies dem Unternehmen oft sofort ins Auge.
Die Berechnung der von den hochbezahlten SysAdmins, Entwicklern und Projektmanagern verbrauchten Gesamtstunden - während, vor und nach jedem Kernel-Neustart - zeigt sofort, dass die betriebliche Belastung eine große und kontinuierliche "Ausfallzeitsteuer" ist. Jede Lösung, die diese Zeitkomponente auf Null reduzieren kann, bietet einen sofortigen und erheblichen Investitionsrendite (ROI).
Viele Branchenstudien haben ergeben, dass die durchschnittlichen Kosten von IT-Ausfallzeiten je nach Bedeutung der betroffenen Dienste zwischen Tausenden und Zehntausenden von Dollar pro Minute liegen können. A Bericht des Ponemon Institute aus dem Jahr 2016 schätzt die durchschnittlichen Kosten von IT-Ausfallzeiten auf 9.000 US-Dollar pro Minute. Selbst wenn Ihr Unternehmen weniger davon betroffen ist, kann sich die kumulative Wirkung regelmäßiger Linux-Neustarts in einer verteilten Umgebung unbemerkt zu einer großen Kostenstelle entwickeln.
Warum Linux-Reboots immer noch ein Problem sind
Reboots werden oft als unvermeidlicher Teil der Systemwartung angesehen, insbesondere wenn es sich um Kernel-Patching. Jede Kernel-Aktualisierung erfordert einen Neustart, um die neue Version in den Speicher zu laden. Das mag zwar harmlos erscheinen, aber die Ausfallzeit, die für den Neustart von Servern, die Überprüfung von Diensten und die Neusynchronisierung von geclusterten Systemen erforderlich ist, kann sich leicht auf Minuten bis Stunden belaufen. Während dieser Zeit werden Anwendungen angehalten, Transaktionen schlagen fehl und die Benutzer können nicht auf das System zugreifen.
In geclusterten oder virtualisierten Umgebungen vervielfachen sich die Auswirkungen. Der Neustart eines Hosts kann zu kaskadenartigen Ausfällen bei abhängigen Diensten führen, was eine vorübergehende Instabilität der Produktions-Workloads zur Folge hat. Für Unternehmen mit strengen Anforderungen an die Betriebszeit bedeutet die Koordinierung von gestaffelten Neustarts und Failovers zusätzliche betriebliche Komplexität - und Risiken.
Letztendlich sind Neustarts immer noch einer der wenigen Faktoren, die in Linux-Umgebungen vorhersehbare Ausfallzeiten verursachen. Sie sind nicht das Ergebnis von Hardwareausfällen oder Softwarefehlern - sie sind vielmehr ein Teil des gesamten Wartungsprozesses. Aus diesem Grund gehört die Beseitigung von Reboot-Anforderungen zu den obersten Prioritäten von Unternehmen, die gleichzeitig die Betriebszeit und die Sicherheit maximieren wollen.
Der Vorteil von Live-Patching: Vollständige Eliminierung von Ausfallzeiten
Live-Patching verändert die Art und Weise, wie Linux-Systeme gewartet werden, da nach Kernel-Updates keine Neustarts mehr erforderlich sind. Anstatt Server vom Netz zu nehmen, werden Sicherheits-Patches direkt auf den laufenden Kernel angewendet - so bleiben Systeme sicher, konform und kontinuierlich verfügbar.
Mit Live-Patching müssen IT-Teams keine Wartungsfenster mehr einplanen oder auf Randzeiten warten, um Updates bereitzustellen. Patches werden nahtlos eingespielt, während die Workloads weiterlaufen, und das System bleibt während des gesamten Prozesses stabil. Dies bedeutet keine Unterbrechung für Benutzer, Anwendungen oder Produktionsumgebungen.
TuxCare's KernelCare ermöglicht Unternehmen die automatische Anwendung kritischer Kernel-Patches in Echtzeit - ohne Neustart oder Unterbrechung der Arbeitslast. Patches können bereitgestellt werden, sobald sie verfügbar sind, wodurch das Fenster der Anfälligkeit reduziert wird, das normalerweise besteht, wenn Updates verschoben werden. Auf diese Weise können Unternehmen die gesetzlichen Vorschriften einhalten, die eine zeitnahe Bereitstellung von Patches vorschreiben - ohne die Verfügbarkeit zu beeinträchtigen.
KernelCare unterstützt die meisten wichtigen Linux-Distributionen für Unternehmen, darunter RHEL, CentOS, AlmaLinux, Rocky Linux, Oracle Linux, CloudLinux, Ubuntu, Amazon Linux und andere.
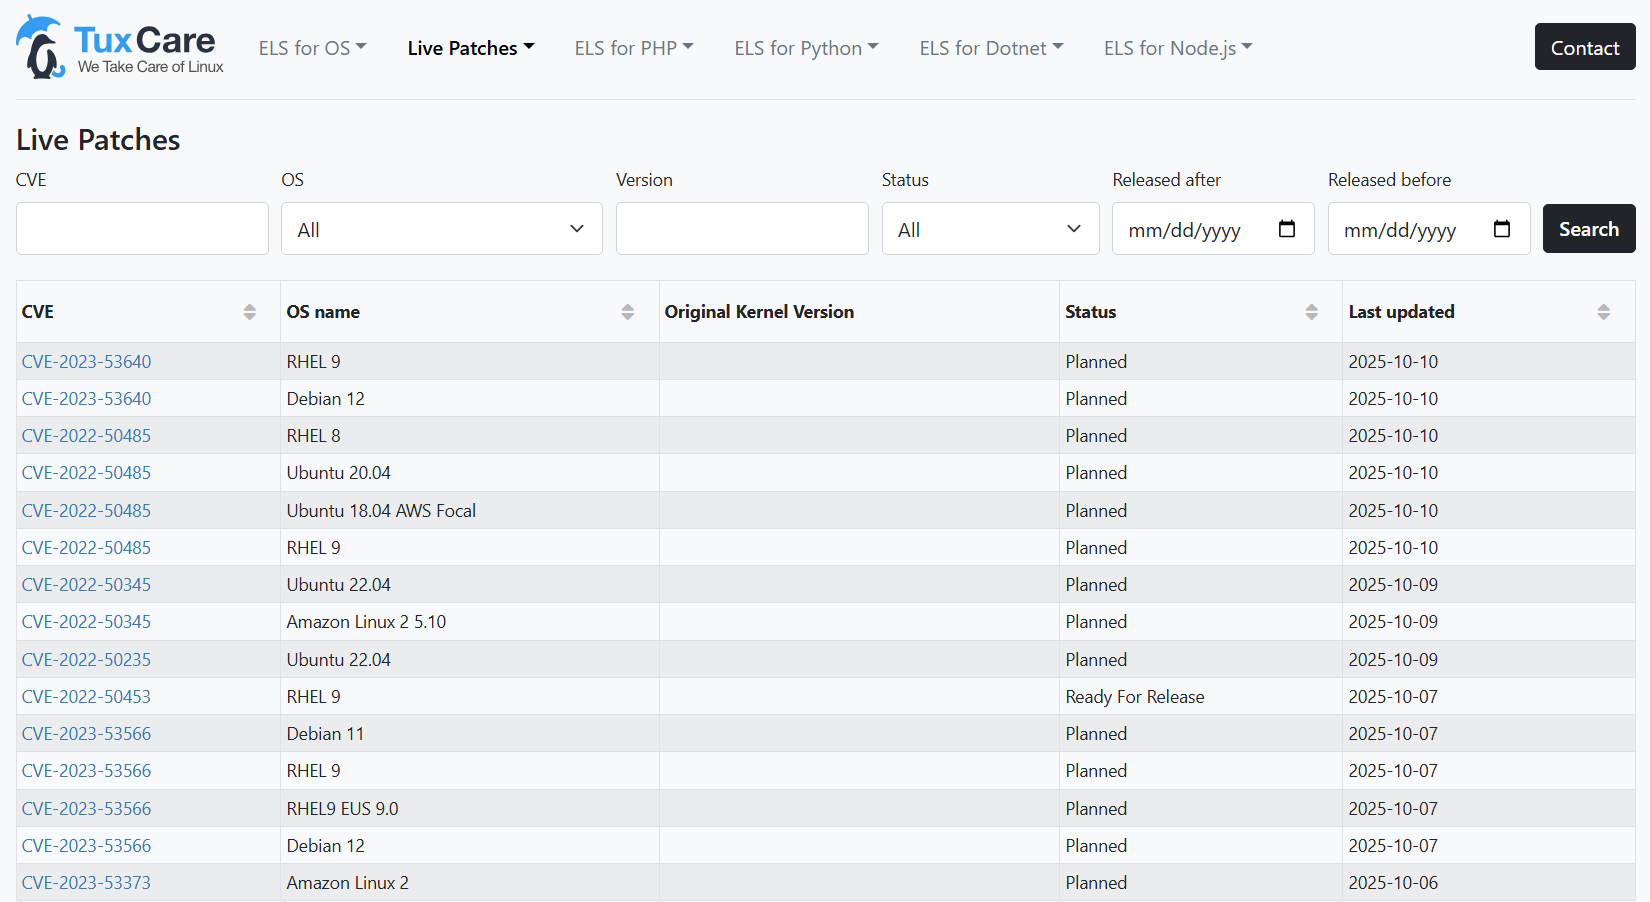
Besuchen Sie Das CVE-Dashboard von TuxCare um eine detaillierte Ansicht der CVEs des Linux-Kernels zu erhalten, die zeigt, welche Schwachstellen in allen unterstützten Distributionen gepatcht wurden.
Neustartfreies Linux-Kernel-Patching mit KernelCare
Ausfallzeiten sind nicht nur eine Unannehmlichkeit, sondern auch wiederkehrende Kosten, die die Produktivität, die Kundenerfahrung und die Sicherheit beeinträchtigen. Herkömmliche Patching-Modelle, die auf Neustarts angewiesen sind, sind für moderne, ständig aktive Infrastrukturen nicht mehr praktikabel.
Durch die Einführung von Live-Patching können Unternehmen geplante Ausfallzeiten vermeiden, Sicherheitslücken schneller schließen und IT-Teams von sich wiederholenden Wartungszyklen befreien. Live-Patching ist eine grundlegende Investition für jedes Unternehmen, das 100 %ige Verfügbarkeit und proaktive Sicherheit in großem Umfang anstrebt.
Mit TuxCare's KernelCare und LibCare Add-on können Sie Kernel- und Shared-Libraries (glibc und OpenSSL) Patches automatisch anwenden - ohne Neustart, Dienstunterbrechungen oder Wartungsfenster.

