
 Suporte Técnico
 Documentação
 Entrar
 Entre em contato conosco


Vá direto para um resumo gerado por IA desta postagem do blog 


- O tempo de inatividade do Linux ocorre quando os sistemas ou serviços ficam temporariamente indisponíveis.
- Mesmo as paradas programadas acarretam custos reais em termos de produtividade, receita e exposição a riscos de segurança.
- A aplicação automatizada de patches em tempo real elimina a necessidade de reinicializações, garantindo disponibilidade contínua e uma implantação mais rápida dos patches.
Em ambientes corporativos, onde o tempo de atividade é sinônimo de receita, mesmo breves reinicializações do Linux podem causar grandes interrupções. As atividades rotineiras de administração de sistemas, como ciclos de aplicação de patches, janelas de manutenção e verificações pós-reinicialização, reduzem silenciosamente a produtividade, atrasam as operações e aumentam o risco de que atualizações de segurança sejam perdidas. Cada minuto de inatividade pode ter um impacto significativo na experiência do cliente, no cumprimento do SLA e no desempenho geral dos negócios.
Este artigo detalha o custo real do tempo de inatividade do Linux — desde as despesas ocultas das janelas de manutenção até os riscos de segurança decorrentes do atraso na aplicação de patches — e explica como a aplicação de patches em tempo real pode ajudar as organizações a eliminar totalmente o tempo de inatividade relacionado à aplicação de patches.
O que causa o tempo de inatividade do Linux?
Os sistemas Linux sofrem tempo de inatividade não apenas devido a falhas ou interrupções, mas, na maioria dos casos, isso é causado por atualizações. As atualizações frequentes do kernel e das bibliotecas exigem a reinicialização, o que, consequentemente, causa interrupções curtas, porém frequentes. O kernel do Linux é responsável pelo gerenciamento da memória, da CPU e do hardware. Quando esse componente essencial é atualizado, o servidor precisa ser reiniciado para carregar a nova imagem do kernel corretamente. Portanto, todo esse processo se torna uma fonte de interrupção inevitável dos serviços.
Algumas causas comuns de interrupção no funcionamento do Linux incluem:
- Atualizações do kernel e correções de segurança que exigem reinicialização.
- Janelas de manutenção programadas para atualizações do sistema operacional ou de aplicativos.
- Substituições de hardware ou alterações de configuração que deixem os serviços fora do ar.
- Falhas inesperadas em dependências ou serviços durante reinicializações.
Mesmo quando o tempo de inatividade é programado, tais eventos interrompem cargas de trabalho críticas, atrasam tarefas em lote e afetam os usuários finais.
Os custos ocultos do tempo de inatividade do Linux
Perda de produtividade
Cada reinicialização ou janela de manutenção significa perda de tempo valioso da equipe. Os administradores de sistema precisam planejar o tempo de inatividade, aplicar patches e verificar a estabilidade após a reinicialização. Quando dezenas ou centenas de servidores estão envolvidos, isso se transforma em um ciclo repetitivo que pode consumir dias inteiros de trabalho a cada mês. As equipes passam horas aguardando a reinicialização dos sistemas, recarregando serviços e solucionando problemas após a reinicialização. Essa ineficiência desvia profissionais de TI qualificados de projetos de inovação, otimização e automação. Ao longo de um ano, esse peso da manutenção se transforma em uma perda significativa de produtividade operacional e velocidade dos projetos.
Receita e impacto sobre os clientes
No caso de serviços voltados para o cliente, apenas alguns minutos de inatividade podem afetar diretamente os resultados comerciais. As plataformas de comércio eletrônico correm o risco de ter carrinhos de compras abandonados, os provedores de SaaS enfrentam penalidades relacionadas aos acordos de nível de serviço (SLA) e as instituições financeiras ficam sem transações devido à indisponibilidade. Em setores onde o tempo de atividade define a reputação, os clientes esperam disponibilidade 24 horas por dia, 7 dias por semana — e percebem imediatamente quando os sistemas ficam fora do ar.
Janelas de manutenção mal programadas ou repetidas podem afastar os usuários, levando a uma má reputação e a uma diminuição da credibilidade da marca. Esses prejuízos financeiros e de reputação vão muito além do departamento de TI, afetando o desempenho das vendas e a fidelidade dos clientes a longo prazo.
Risco à segurança decorrente do atraso na aplicação de correções
O tempo de inatividade costuma ser necessário para a aplicação de patches no kernel; por isso, as equipes acabam adiando as atualizações para evitar interrupções. Esse atraso abre uma janela de vulnerabilidade que pode durar de dias a semanas — exatamente o período que os invasores exploram. O atraso na aplicação de patches não apenas aumenta a probabilidade de violações de dados, mas também enfraquece a conformidade das organizações com estruturas regulatórias, como PCI DSS, HIPAAou FIPS.
Quando ocorre um incidente de segurança, os custos aumentam drasticamente: resposta ao incidente, análise forense, correção e possíveis multas. Ironicamente, evitar um breve período de inatividade muitas vezes faz com que a recuperação após um ataque demore muito mais tempo, podendo até mesmo resultar em um tempo de inatividade exponencialmente maior.
Despesas gerais operacionais e custos de planejamento
As janelas de manutenção, sejam elas planejadas ou não, podem resultar em enormes custos operacionais. É fundamental que as equipes de TI coordenem-se com os diferentes departamentos, programem o tempo de inatividade para horários de baixo tráfego, notifiquem as partes interessadas e obtenham as aprovações necessárias para a gestão de mudanças.
Em ambientes de missão crítica, a manutenção exige uma sequência complexa de etapas para garantir a estabilidade do sistema e estar preparado para reverter as alterações em caso de problemas imprevistos. Cada uma dessas etapas representa custos ocultos — tempo dedicado não à inovação, mas à mitigação de riscos. Com o tempo, esses esforços repetitivos de coordenação acumulam-se em centenas de horas de trabalho por ano, criando um entrave constante à eficiência de TI.
Calculando o custo real do tempo de inatividade do Linux: uma análise rápida
Para ir além dos custos baseados em dados pontuais, as empresas devem utilizar um modelo abrangente para determinar a verdadeira exposição financeira decorrente da interrupção do sistema. Uma maneira simples de estimar o impacto do tempo de inatividade é:
Custo total do tempo de inatividade = Receita direta perdida + Custo com mão de obra de TI + Valor da exposição ao risco + Multas por violação do SLA + Despesas gerais de recuperação
O Valor de Exposição ao Risco é a parte mais difícil da equação a ser modelada corretamente. É a parte que atribui um valor monetário ao incidente de segurança que ocorre quando o departamento de TI adia intencionalmente a instalação de patches de segurança. No entanto, ao analisar apenas o custo de mão de obra, a empresa muitas vezes percebe imediatamente a real dimensão do problema.
O cálculo do total de horas consumidas pelos administradores de sistemas, desenvolvedores e gerentes de projeto — que recebem altos salários — durante, antes e depois de cada reinicialização do kernel — mostra imediatamente que a carga operacional representa um grande e contínuo “imposto pelo tempo de inatividade”. Qualquer solução capaz de reduzir a componente de tempo a zero proporciona um Retorno sobre o Investimento (ROI).
Muitos estudos do setor indicam que o custo médio do tempo de inatividade de TI pode variar entre milhares e dezenas de milhares de dólares por minuto, dependendo da importância dos serviços afetados. Um relatório de 2016 do Ponemon Institute estimou o custo médio da inatividade de TI em US$ 9.000 por minuto. Mesmo que sua organização enfrente menos casos desse tipo, o efeito cumulativo das reinicializações regulares do Linux em um ambiente distribuído pode, sem que se perceba, se transformar em um grande centro de custos.
Por que as reinicializações do Linux ainda são um problema
As reinicializações são frequentemente vistas como uma parte inevitável da manutenção do sistema, especialmente quando se trata de aplicação de patches no kernel. Toda atualização do kernel exige uma reinicialização para carregar a nova versão na memória. Embora isso possa parecer inofensivo, o tempo de inatividade necessário para reiniciar servidores, verificar serviços e ressincronizar sistemas em cluster pode facilmente se estender de minutos a horas. Durante esse período, os aplicativos ficam paralisados, as transações falham e os usuários não conseguem acessar o sistema.
Em ambientes em cluster ou virtualizados, o impacto se multiplica. Reiniciar um host pode provocar um tempo de inatividade em cascata nos serviços dependentes, gerando instabilidade temporária nas cargas de trabalho de produção. Para organizações com requisitos rigorosos de tempo de atividade, coordenar reinicializações escalonadas e transições de failover aumenta a complexidade operacional — e o risco.
No fim das contas, as reinicializações continuam sendo um dos poucos fatores que causam tempo de inatividade previsível em ambientes Linux. Elas não são resultado de falhas de hardware ou bugs de software — ao contrário, fazem parte do próprio processo geral de manutenção. É por isso que eliminar a necessidade de reinicializações passou a figurar entre as principais prioridades estabelecidas por organizações que buscam maximizar simultaneamente o tempo de atividade e a segurança.
A vantagem do Live Patching: eliminar totalmente o tempo de inatividade
A aplicação de patches em tempo real muda a forma como os sistemas Linux são mantidos, eliminando a necessidade de reinicializações após atualizações do kernel. Em vez de desligar os servidores, os patches de segurança são aplicados diretamente ao kernel em execução — mantendo os sistemas seguros, em conformidade e continuamente disponíveis.
Com a aplicação de patches em tempo real, as equipes de TI não precisam mais programar janelas de manutenção nem esperar pelos horários de menor movimento para implantar atualizações. Os patches são aplicados de forma contínua enquanto as cargas de trabalho continuam em execução, e o sistema permanece estável durante todo o processo. Isso significa zero interrupção para os usuários, aplicativos ou ambientes de produção.
O KernelCare da TuxCare permite que as organizações apliquem automaticamente patches críticos do kernel em tempo real — sem reinicialização ou interrupção das cargas de trabalho. Os patches podem ser implantados assim que estiverem disponíveis, reduzindo o período de vulnerabilidade que normalmente ocorre quando as atualizações são adiadas. Isso permite que as organizações mantenham a conformidade com as normas regulatórias que exigem a aplicação oportuna de patches — sem comprometer a disponibilidade.
O KernelCare é compatível com a maioria das principais distribuições Linux corporativas, incluindo RHEL, CentOS, AlmaLinux, Rocky Linux, Oracle Linux, CloudLinux, Ubuntu, Amazon Linux e outras.
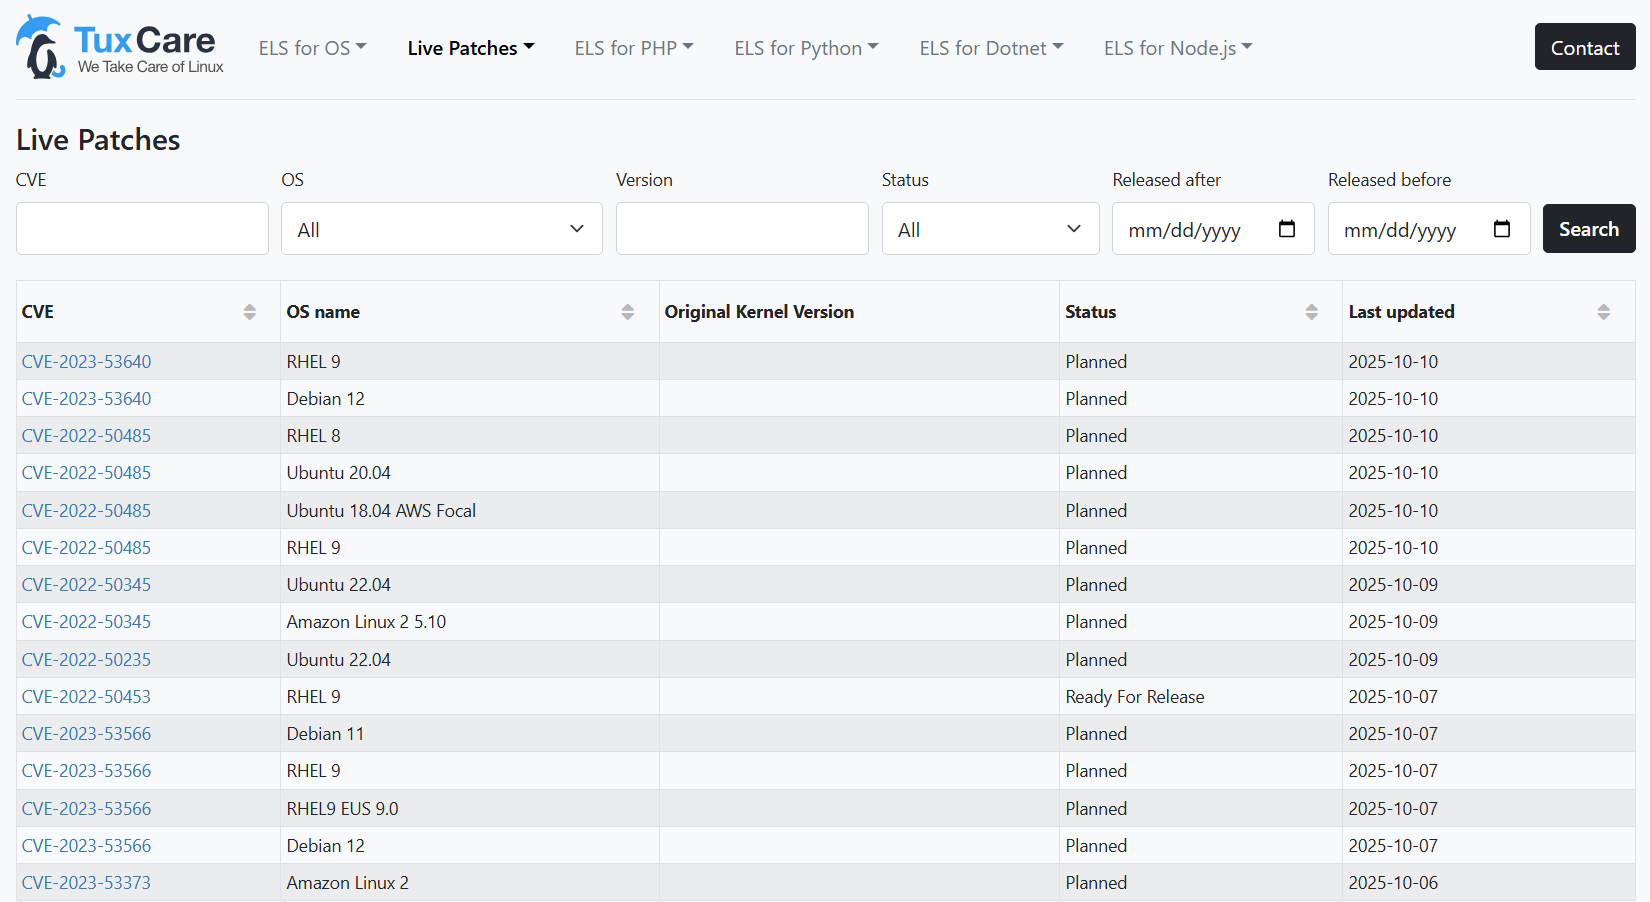
Acesse o painel de controle de CVEs da TuxCare para ver uma visão detalhada dos CVEs do kernel do Linux, mostrando quais vulnerabilidades foram corrigidas em todas as distribuições suportadas.
Aplicação de patches no kernel do Linux sem reinicialização com o KernelCare
O tempo de inatividade não é apenas um inconveniente — é um custo recorrente que afeta a produtividade, a experiência do cliente e a segurança. Os modelos tradicionais de aplicação de patches, que dependem de reinicializações, não são mais viáveis para infraestruturas modernas que permanecem sempre em operação.
Ao adotar a aplicação de patches em tempo real, as organizações podem eliminar o tempo de inatividade planejado, corrigir vulnerabilidades mais rapidamente e liberar as equipes de TI de ciclos repetitivos de manutenção. A aplicação de patches em tempo real é um investimento fundamental para qualquer empresa comprometida com 100% de disponibilidade e segurança proativa em grande escala.
Com o KernelCare da TuxCare e LibCare da TuxCare, você pode aplicar patches no kernel e nas bibliotecas compartilhadas (glibc e OpenSSL) automaticamente — sem reinicializações, interrupções de serviço ou janelas de manutenção.

