Support technique
 Documentation
 Connexion
 Nous contacter


Accédez directement au résumé généré par l'IA de cet article de blog 


Principaux enseignements
- L'exploitation de vulnérabilités non corrigées est désormais la cause la plus fréquente des violations de sécurité, mais l'application des correctifs comporte elle-même des risques liés aux temps d'arrêt, aux échecs de mise à jour et aux lacunes de restauration que la plupart des équipes sous-estiment.
- De nombreuses failles liées à une vulnérabilité connue surviennent alors qu'un correctif était déjà disponible. Il s'agit d'une défaillance opérationnelle, et non technique.
- Les scores de gravité génériques (scores CVSS de base, utilisés sans tenir compte du contexte de la menace ou de l'environnement) constituent un mauvais guide de hiérarchisation ; l'exploitabilité et l'exposition des actifs sont des critères plus importants pour déterminer ce qu'il faut corriger en priorité.
- L'application de correctifs sans redémarrage élimine l'une des principales causes de retard dans l'application des correctifs – à savoir le redémarrage de l'ordinateur ou du service – ce qui permet de déployer les correctifs pris en charge en quelques heures, sans avoir à attendre la prochaine fenêtre de maintenance.
La plupart des équipes savent qu’elles devraient appliquer les correctifs plus rapidement. Ce qui les freine réellement, ce n’est pas la paresse. C’est la crainte que le correctif provoque une panne à 2 heures du matin sur un serveur dont personne ne comprend plus vraiment le fonctionnement. La mise à jour reste donc en attente. Cette hésitation est au cœur du risque lié à la gestion des correctifs, et c’est la question à laquelle la plupart des équipes tentent de répondre : comment corriger des vulnérabilités connues sans que le correctif lui-même ne devienne l’incident ?
Les risques liés à la gestion des correctifs peuvent se manifester de deux manières. D'une part, il y a le risque de laisser des systèmes sans correctifs ; d'autre part, il y a les risques inhérents au processus d'application des correctifs : échecs de mise à jour, temps d'arrêt, lacunes dans la mise à jour. Cet article analyse ces deux types de risques, en identifie les causes, explique les conséquences de leur négligence et présente les mesures concrètes ainsi que les outils permettant de réduire les risques dans chaque cas.
Comprendre les risques liés à la gestion traditionnelle des correctifs
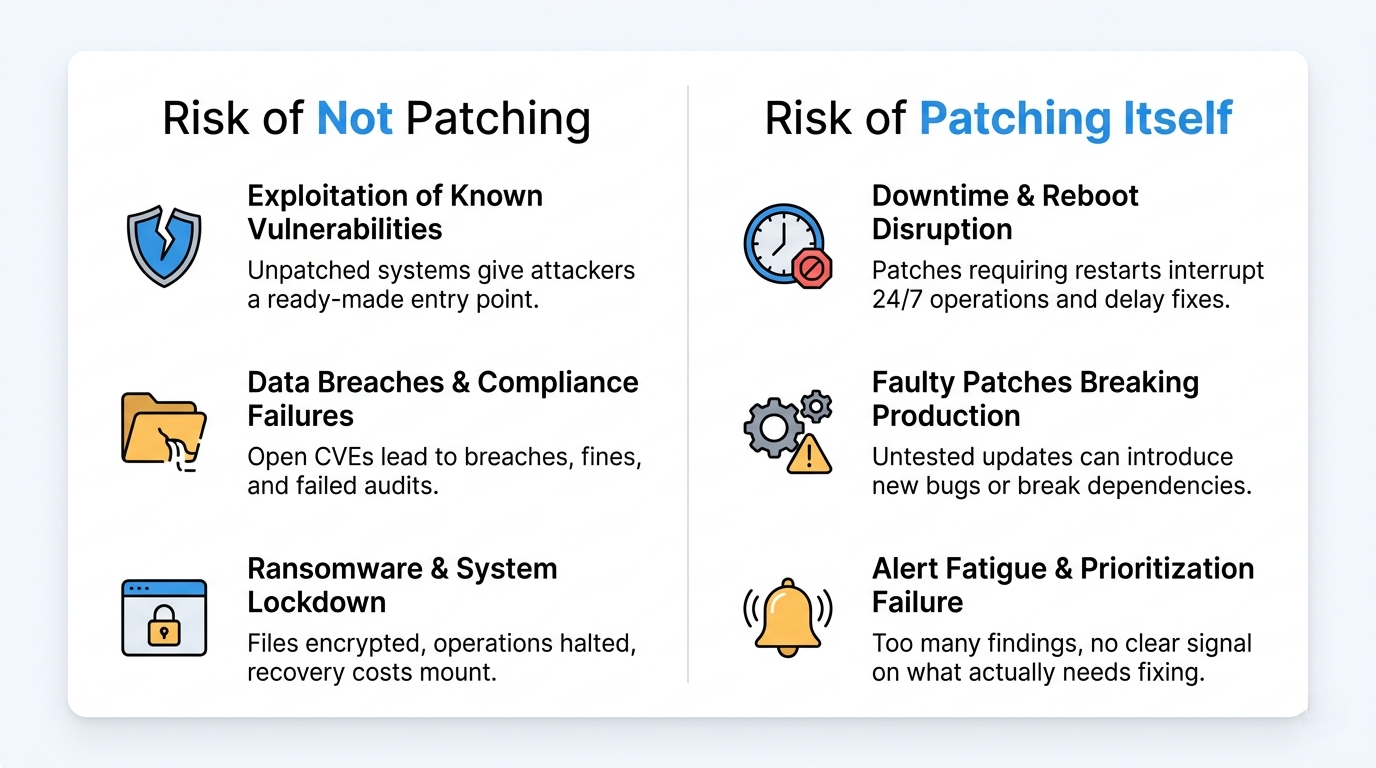
La gestion traditionnelle des correctifs suit un cycle bien connu : rechercher les mises à jour manquantes, planifier une fenêtre de maintenance, tester si le temps le permet, déployer, redémarrer, vérifier. Sur le papier, cela fonctionne. En production, chaque étape comporte des risques.
Ce modèle part du principe que vous pouvez mettre les systèmes hors ligne pendant les fenêtres de maintenance programmées. Or, dans la réalité, l’infrastructure se prête rarement à cela. Les fenêtres de maintenance se réduisent, les charges de travail fonctionnant 24 h/24 et 7 j/7 ne peuvent pas être redémarrées, et l’environnement de test ne correspond jamais tout à fait à l’environnement de production. Il en résulte une accumulation de correctifs « en attente », et c’est précisément cette situation que les attaquants exploitent.
L'approche conventionnelle comporte trois faiblesses structurelles intrinsèques :
- Cela dépend du redémarrage. Les mises à jour traditionnelles du noyau nécessitent généralement un redémarrage avant que le nouveau code ne soit exécuté, et les mises à jour des bibliothèques principales exigent le redémarrage des services concernés. Dans les deux cas, cela entraîne un temps d'arrêt, ce qui se traduit par un retard.
- Ce processus est dicté par le calendrier, et non par les menaces. Le « Patch Tuesday » et les fenêtres de mise à jour mensuelles ne tiennent pas compte du fait qu’une vulnérabilité CVE a fait l’objet d’une exploitation active un jeudi.
- Cette approche considère la couverture comme un objectif en soi. Atteindre un taux de correction de 98 % fait bonne impression sur un tableau de bord, alors que les 2 % restants représentent une part disproportionnée des risques.
Retour à la réalité : Un taux de conformité aux correctifs de 98 % n’est pas un indicateur de sécurité. C’est un indicateur de couverture. Les systèmes qui constituent ces 2 % restants sont rarement choisis au hasard. Il s’agit des machines héritées, des serveurs impossibles à redémarrer, des environnements d’exécution non pris en charge – précisément les systèmes qui deviennent des cibles de choix dès lors qu’ils sont exposés et reconnus comme vulnérables.
Risques liés à l'absence de correctifs (ou à une mise en place trop lente de ceux-ci)
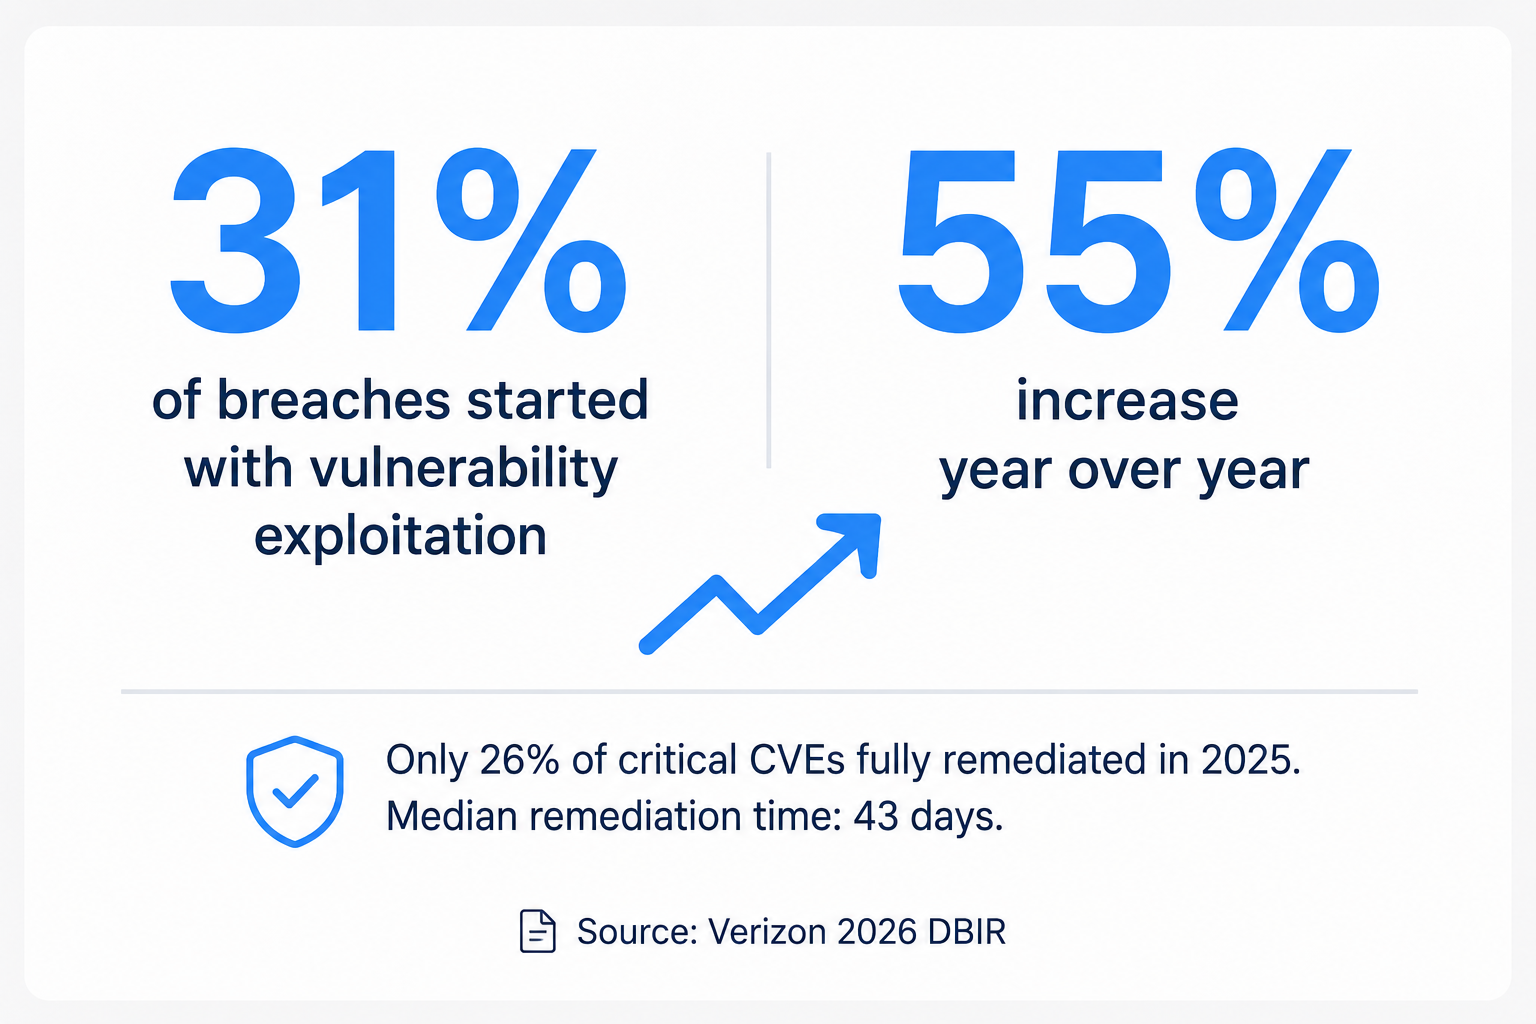
Le retard ou l'absence d'application des correctifs n'est pas un simple problème d'entretien informatique. Cela laisse ouverte ce qui est devenu la voie d'accès la plus courante au sein d'une organisation. Le rapport DBIR 2026 de Verizon a révélé que l’exploitation des vulnérabilités est désormais le vecteur d’accès initial le plus courant pour les violations de données, représentant 31 % des cas – contre 20 % l’année précédente, soit une hausse de 55 % d’une année sur l’autre – et c’est la première fois en 19 ans d’existence du rapport que l’exploitation de vulnérabilités occupe la première place, devant l’usurpation d’identifiants et le hameçonnage.
Ce même rapport a révélé que seules 26 % des vulnérabilités répertoriées dans la liste KEV de la CISA avaient été entièrement corrigées en 2025, contre 38 % l'année précédente, tandis que le délai médian nécessaire à leur résolution complète est passé de 32 à 43 jours. Les mesures correctives cèdent du terrain face à l'exploitation des failles.
Ces risques ne sont pas isolés les uns des autres. Une vulnérabilité CVE non corrigée entraîne une faille de sécurité, laquelle engendre des risques en matière de conformité, et les conséquences de ces derniers finissent souvent par coûter plus cher que l'interruption de service que l'équipe cherchait à éviter au départ.
Exploitation de failles connues
Le risque le plus direct est aussi le plus simple : une vulnérabilité CVE est publique, un correctif existe, et vous ne l’avez pas appliqué. Les pirates n’ont pas besoin d’une faille « zero-day » lorsqu’une faille connue reste exposée. Selon une enquête réalisée en 2019 par le Ponemon Institute pour le compte de ServiceNow, 60 % des victimes de violations de données ont déclaré que leur violation était due à une vulnérabilité pour laquelle un correctif était disponible mais n’avait pas été déployé. Cette enquête est ancienne, mais les chiffres du DBIR relatifs aux mesures correctives, présentés ci-dessus, suggèrent que le comportement sous-jacent n’a pas beaucoup changé depuis.
Pour les vulnérabilités très médiatisées et facilement exploitables, le délai entre leur divulgation et leur exploitation active s'est pratiquement réduit à néant : des codes d'exploitation peuvent apparaître quelques heures seulement après la publication de l'avis de sécurité. Au moment où la fenêtre de maintenance mensuelle arrive, la vulnérabilité peut déjà être exploitée depuis des semaines. Le catalogue des vulnérabilités connues pour être exploitées de la CISA existe précisément parce que les attaquants se concentrent sur un ensemble prévisible de failles non corrigées et activement exploitées.
C'est particulièrement difficile dans le noyau et les bibliothèques principales, où les correctifs traditionnels nécessitent un redémarrage du système ou des services concernés – ce qui explique précisément pourquoi les équipes reportent l'application de ces correctifs. KernelCare de TuxCare applique les correctifs CVE du noyau aux noyaux Linux pris en charge sans mettre l’hôte hors service, ce qui élimine le délai lié au redémarrage qui maintient ces correctifs en attente dans la file d’attente.
Manquements aux obligations réglementaires et sanctions financières
Les cadres de sécurité et de conformité imposent différentes obligations en matière de gestion des vulnérabilités. La norme PCI DSS est la norme la plus contraignante : l’exigence 6.3.3 impose l’installation des correctifs de sécurité critiques et de gravité élevée dans un délai d’un mois à compter de leur publication, les autres correctifs applicables devant être installés selon un calendrier défini et justifié par l’organisation. HIPAA et SOC 2 ne fixent pas de délai universel pour l’application des correctifs ; ils exigent des organisations qu’elles mettent en place des contrôles raisonnables, basés sur les risques, et qu’elles respectent ensuite le processus qu’elles ont documenté. Dans la pratique, c’est le fait de laisser une vulnérabilité CVE critique non corrigée au-delà du délai que vous avez vous-même fixé qui donne lieu à une constatation d’audit.
Le coût ne se limite pas à l'amende. Un audit non conforme peut entraîner la perte de contrats, la suspension du traitement des paiements et mobiliser du temps de travail des ingénieurs pour remédier aux problèmes dans l'urgence. Le rapport 2026 d'IBM intitulé « Cost of a Data Breach » (Coût d'une fuite de données) estime le coût moyen mondial d’une violation de données à un niveau record de 4,99 millions de dollars, soit une hausse de 12 % par rapport à l’année précédente ; ces coûts vont bien au-delà de la remise en état technique et englobent la détection et l’escalade, la notification, les mesures juridiques et réglementaires, ainsi que la perte d’activité.
Attention : Certains scanners basés sur les paquets signalent qu’une vulnérabilité CVE a été « corrigée » dès l’installation du paquet mis à jour, avant même le redémarrage du service concerné. Dans les workflows de correction traditionnels, un processus en cours d’exécution peut continuer à exécuter le code vulnérable jusqu’à ce qu’il soit redémarré, rechargé ou corrigé sans redémarrage. Le tableau de bord affiche le vert ; la mémoire, quant à elle, peut indiquer le contraire. Les technologies de correction à chaud prises en charge résolvent ce problème en appliquant des correctifs au noyau en cours d’exécution ou au code des bibliothèques vulnérables dans les processus actifs.
Préjudice opérationnel et préjudice à la réputation
Une faille dans un système non mis à jour se limite rarement à un seul serveur. Le ransomware se propage latéralement, l'exfiltration de données se poursuit pendant plusieurs jours avant d'être détectée, et la restauration mobilise la même équipe qui était déjà trop occupée pour appliquer les correctifs.
Et puis, il y a cet aspect qu’aucun tableur ne peut rendre : la confiance. Les clients, les partenaires et les autorités de régulation lisent tous la même communication. « Nous étions au courant de la faille de sécurité, mais nous n’avions pas encore appliqué le correctif » : voilà l’une des phrases les plus préjudiciables qu’une entreprise puisse être contrainte de publier.
Risques inhérents au processus de gestion des correctifs lui-même
On accorde beaucoup moins d'attention à l'envers de la médaille : l'application de correctifs comporte des risques que les approches traditionnelles ne parviennent pas à gérer correctement. Les entreprises se focalisent sur les indicateurs de couverture des correctifs et négligent les défaillances au niveau des processus qui se cachent derrière.
C'est là une vision plus nuancée des risques liés à la gestion des correctifs. Il ne s'agit pas de se demander « avons-nous appliqué les correctifs ? », mais « quel a été le coût de cette opération, et qu'est-ce qu'elle a discrètement endommagé ? ». Les risques énumérés ci-dessous expliquent pourquoi les équipes expérimentées hésitent – et cette hésitation nous ramène directement aux risques liés aux systèmes non mis à jour évoqués plus haut.
Des correctifs défectueux ou non testés qui perturbent l'environnement de production
Un correctif est un logiciel, et tout logiciel peut entraîner des régressions. Une mise à jour proposée par un éditeur peut introduire un nouveau bogue, modifier un paramètre par défaut ou entrer en conflit avec une dépendance dont vous ignoriez l'existence. Les dégâts causés par un correctif défectueux peuvent être aussi graves que la vulnérabilité qu'il était censé corriger.
C'est pourquoi les équipes effectuent leurs tests en environnement de préproduction – sauf que celui-ci reflète rarement à l'identique l'environnement de production, et c'est justement dans cette différence que se cachent les surprises. Un correctif qui fonctionne parfaitement sur une machine de test toute neuve peut échouer sur un serveur où les configurations ont dérivé au fil de trois ans.
Sur le terrain : Prenons l’exemple d’une mise à jour de routine de la bibliothèque déployée directement en production un vendredi parce qu’elle « semblait mineure ». Elle modifie un paramètre TLS par défaut, empêche la validation des certificats par rapport à l’API d’un partenaire et paralyse le processus de paiement pendant six heures. La vulnérabilité CVE qu’elle corrigeait présentait un score CVSS de base de 5,3. L’indisponibilité a causé des dommages immédiats et mesurables ; la faille non exploitée n’en a causé aucun.
Interruptions de service, redémarrages et créneaux de maintenance
De nombreuses mises à jour du noyau, des bibliothèques principales et des services système nécessitent généralement un redémarrage du système ou un redémarrage des services concernés avant que le nouveau code ne prenne effet. Pour une charge de travail fonctionnant 24 heures sur 24, 7 jours sur 7, ce redémarrage représente un risque. Chaque redémarrage comporte le risque qu’un service ne redémarre pas, qu’un montage échoue ou qu’une configuration ne se charge pas correctement.
Le problème de planification ne fait qu’aggraver la situation. Les équipes internationales n’ont pas d’horaires de travail communs, et les créneaux de maintenance ne cessent de se réduire. Les correctifs sont donc regroupés par lots, ces lots prennent du retard, et ce retard fait resurgir le risque lié aux systèmes non mis à jour. La mise à jour des bibliothèques de l’espace utilisateur se heurte au même obstacle : la mise à jour de glibc ou OpenSSL nécessite généralement de redémarrer les services concernés qui y sont liés.
C'est là que réside la lacune pour lequel . L'application de correctifs à un noyau ou à une bibliothèque partagée en cours d'exécution, sans redémarrage, élimine d'un seul coup le risque d'indisponibilité et le retard qu'il entraîne. LibCare de TuxCare de TuxCare étend ce modèle aux bibliothèques partagées prises en charge, notamment OpenSSL et glibc.
Fatigue liée aux alertes et incapacité à établir des priorités
Les scanners de vulnérabilité sont implacables. Un environnement de taille moyenne peut mettre en évidence des milliers de vulnérabilités par mois, dont seule une infime partie est réellement exploitée où que ce soit. Lorsque tout est signalé comme critique, rien ne l'est vraiment.
Les équipes de sécurité perdent le cap. Soit elles se concentrent sur des vulnérabilités à faible risque alors qu'une faille CVE réellement exploitable reste en suspens, soit elles passent à côté de l'alerte qui comptait vraiment, noyée dans le bruit de fond. La solution consiste à établir des priorités en fonction de l'exploitabilité réelle plutôt que des scores CVSS bruts, et c'est là que les données de prédiction d'exploitation entrent en jeu.
Que se passe-t-il lorsque les risques ne sont pas pris en compte ?
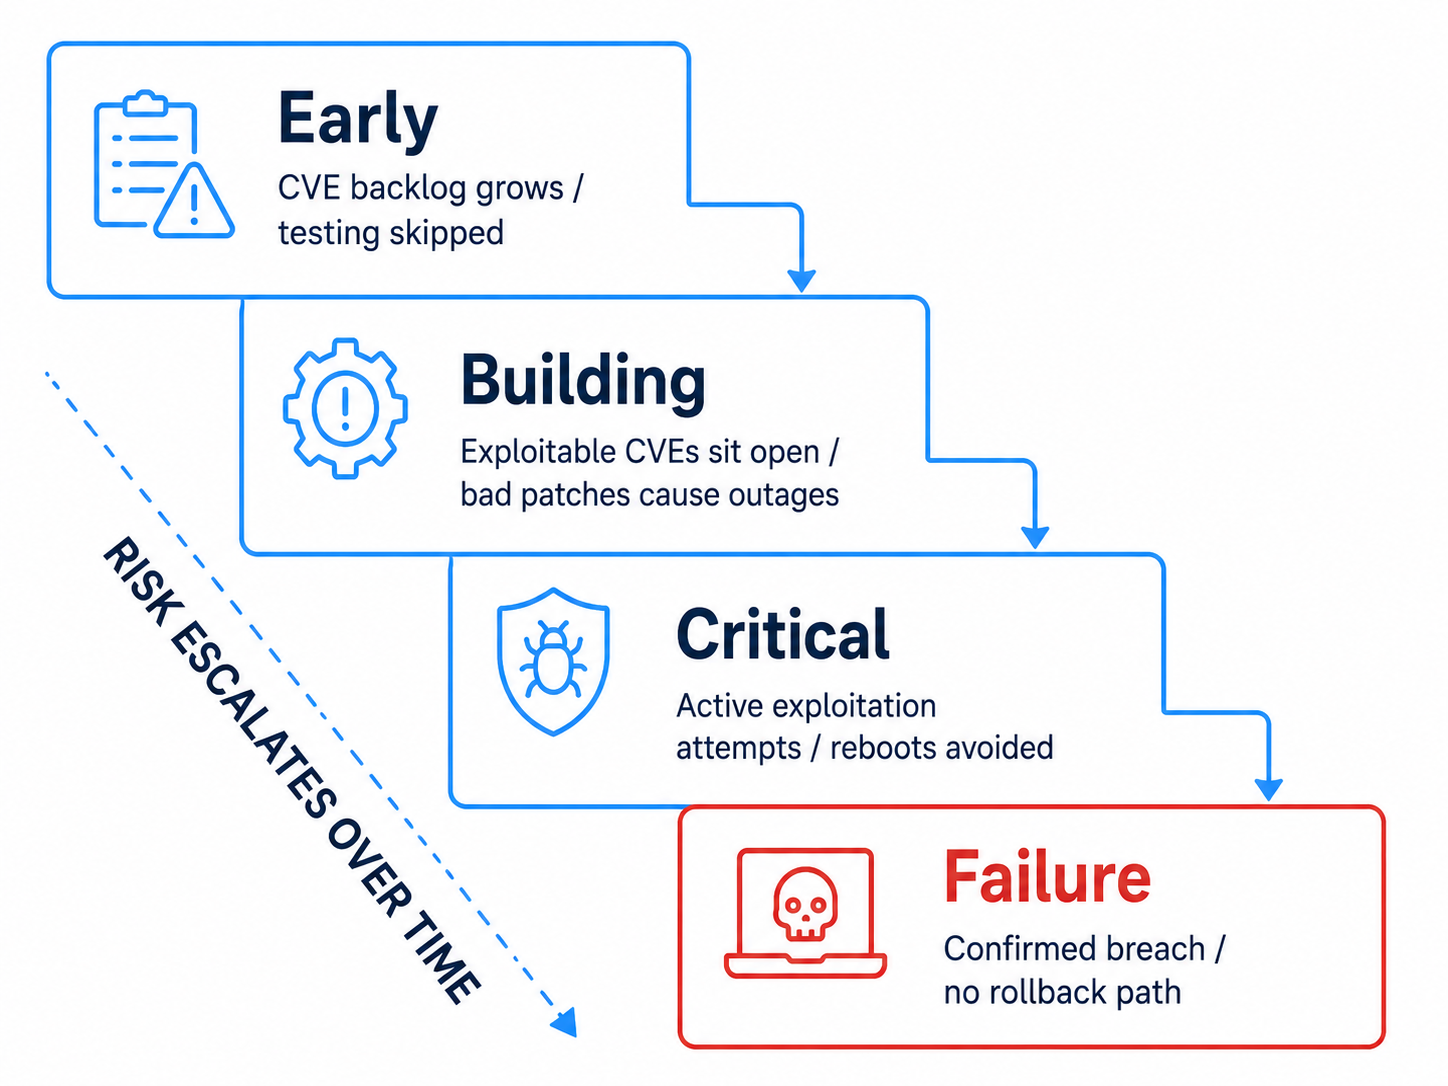
Si l'on néglige suffisamment longtemps les deux aspects du risque lié à la gestion des correctifs, les sources de défaillance s'accumulent. Les risques liés aux systèmes non mis à jour et ceux liés aux processus ne constituent pas des problèmes distincts : ils s'alimentent mutuellement pour aboutir à une crise qui s'installe progressivement.
Voici comment la situation s'envenime entre les deux parties si rien ne change :
| Stade | Côté « sans correctif » | Côté processus |
| Tôt | Le nombre de CVE en attente ne cesse d'augmenter | Les équipes font l'impasse sur les tests pour gagner du temps |
| Bâtiment | Des vulnérabilités CVE exploitables restent non corrigées pendant des semaines | Des problèmes techniques entraînent des coupures occasionnelles |
| Critique | Exploitation active, tentatives d'intrusion | Les redémarrages sont évités, les corrections ne sont plus appliquées |
| Échec | Violation confirmée, risque de non-conformité | Instabilité de la production, absence de procédure de restauration |
Au final, on se retrouve avec une équipe à la fois peu sûre d'elle et réticente à appliquer des correctifs : elle en applique moins parce que ceux-ci ne cessent de causer des dysfonctionnements, et ces dysfonctionnements surviennent plus souvent car les systèmes qui gèrent ce retard s'éloignent de plus en plus d'un état de fonctionnement optimal.
Comment réduire les risques liés à la gestion des correctifs
Une gestion efficace des correctifs implique de s’attaquer simultanément à deux aspects : le retard dans l’application des correctifs et les défaillances au niveau des processus. Si vous corrigez l’un en négligeant l’autre, vous ne faites que déplacer le risque ailleurs.
Ce processus doit fonctionner comme un système, et non comme une simple liste de contrôle. Les étapes ci-dessous s'enchaînent les unes après les autres. La rigueur des tests détermine les priorités, la définition des priorités guide le déploiement, et la suppression de l'obligation de redémarrage accélère l'ensemble du cycle.
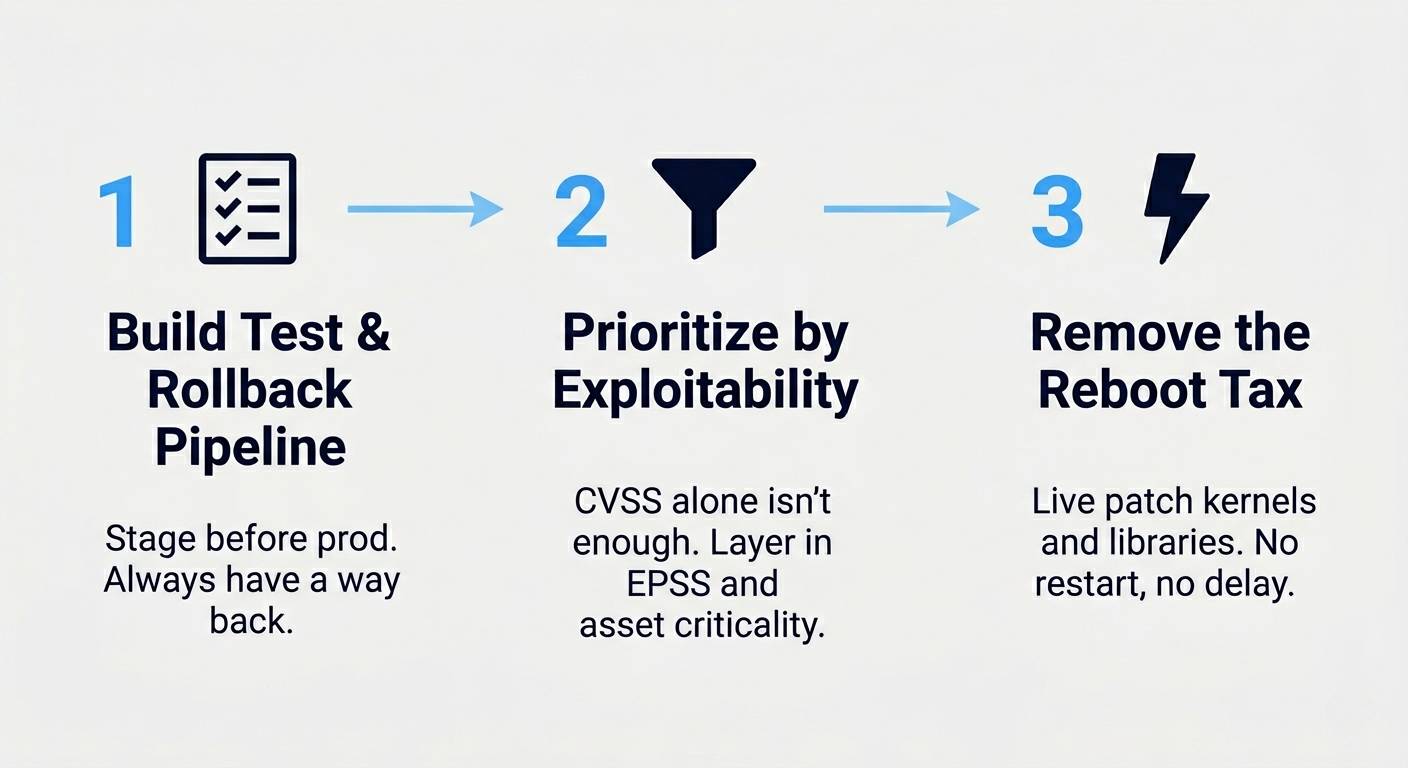
Étape 1 : Mettre en place un pipeline complet de tests et de restauration
Avant qu'un correctif ne soit déployé en production, il doit passer par un environnement représentatif et disposer d'un chemin de retour testé et fiable. Deux éléments qui réduisent sensiblement les risques :
- Un environnement de préproduction qui reflète l'environnement de production : mêmes versions de système d'exploitation, même configuration principale, mêmes dépendances clés. Les systèmes de test basés sur des instantanés facilitent cette tâche en garantissant la reproductibilité des tests répétés.
- Une restauration automatisée : verrouillage des paquets, instantanés du système de fichiers ou gestion des versions des images de conteneurs, afin que la restauration se fasse en une seule commande plutôt que de nécessiter un travail d'analyse approfondie.
Si un correctif passe avec succès la phase de test et que vous pouvez effectuer une annulation sans problème, déployez-le en toute confiance. Si vous ne pouvez pas annuler le déploiement sans problème, ce n’est pas automatiquement une raison d’attendre : dans le cas d’une vulnérabilité CVE activement exploitée, attendre est souvent le choix le plus risqué. Mettez en place des contrôles compensatoires, déployez d’abord le correctif sur un groupe « canary » et documentez votre décision avant de poursuivre. Un correctif que vous ne pouvez pas annuler revient à miser sur l’assurance qualité du fournisseur, et ce choix doit être mûrement réfléchi.
Étape 2 : Hiérarchiser en fonction de la vulnérabilité, et non du volume
Cessez de considérer tous les CVSS 9,8 comme équivalents. Une faille de gravité élevée pour laquelle il n’existe aucun exploit public et qui ne présente aucun risque d’exposition au réseau est moins urgente qu’une faille de gravité moyenne faisant l’objet d’une attaque active. Utilisez des signaux de couche 3 pour filtrer le bruit :
- Statut de l'exploit : figure-t-il dans le catalogue KEV de la CISA, ou présente-t-il un score EPSS élevé ou en forte hausse ?
- Exposition : le service concerné est-il accessible depuis Internet ou réservé à un usage interne ?
- Criticité de l'actif : le serveur contient-il des données réglementées ou exécute-t-il des processus essentiels au chiffre d'affaires ?
Classez les vulnérabilités par ordre de priorité en fonction de la combinaison la plus forte de ces trois critères. Vous continuerez à reporter l'application de certains correctifs, mais la différence est que c'est vous qui choisissez lesquels, et que vous pouvez justifier ce choix.
Étape 3 : Supprimer l'obligation de redémarrage grâce à l'application de correctifs sans redémarrage
Pour les systèmes où la disponibilité est cruciale, le coût en temps d'indisponibilité lié aux redémarrages et aux relances de services est l'une des principales causes de retard dans l'application des correctifs. En supprimant cette contrainte, une partie importante du retard s'efface d'elle-même. L'application de correctifs sans redémarrage permet d'appliquer les correctifs pris en charge pour le noyau et les bibliothèques à des systèmes en cours d'exécution sans redémarrage ; ainsi, un correctif sans redémarrage disponible peut être déployé en quelques heures, sans avoir à attendre la prochaine fenêtre de maintenance.
Comment l'IA peut-elle contribuer à la gestion des correctifs ?
L'IA est utile dans la gestion des correctifs pour une raison simple : ce domaine croule sous les données, et ces systèmes excellent justement dans la mise en corrélation et la classification rapide de grands volumes de données. Elle ne remplace pas le jugement humain. Elle réduit simplement le nombre de décisions qu'un être humain doit prendre.
L'IA et l'identification des risques
Les outils assistés par IA établissent des corrélations entre les flux CVE, les inventaires d’actifs et les données de configuration plus rapidement que n’importe quelle analyse manuelle. Au lieu qu’un opérateur humain croise les informations d’un nouvel avis de sécurité avec une liste d’actifs, le système signale quels hôtes spécifiques sont concernés. À condition de disposer de données suffisamment complètes sur les dépendances et l’exécution, il peut également aider à mettre en évidence des expositions indirectes : une bibliothèque vulnérable enfouie à plusieurs niveaux de profondeur dans un arbre de dépendances, ou un service qui a techniquement reçu un correctif mais qui exécute toujours l’ancien code en mémoire.
Considérez cela comme un système automatisé d'alerte précoce qui établit simultanément des corrélations entre les publications de correctifs, les bases de données de vulnérabilités et les flux d'informations sur les menaces – non pas parce qu'un être humain ne serait pas capable de le faire, mais parce qu'aucun être humain ne dispose de la capacité nécessaire pour traiter un tel volume de données sans passer à côté de quelque chose.
Hiérarchisation des risques grâce à l'IA
C'est là que l'IA prend tout son sens. Les modèles entraînés à partir de données d'exploits peuvent estimer quelles vulnérabilités (CVE) sont les plus susceptibles d'être utilisées à des fins malveillantes, en classant les résultats en fonction du risque réel probable plutôt que de leur gravité brute. Cela permet de s'attaquer directement au problème de la « fatigue des alertes ».
Le saviez-vous ? L’EPSS (Exploit Prediction Scoring System), géré par FIRST, estime la probabilité qu’une activité d’exploitation impliquant un CVE publié soit observée au cours des 30 prochains jours. Des recherches menées par le Cyentia Institute et FIRST ont révélé que seuls environ 6 % des CVE publiés ont déjà été observés en situation réelle, alors que des milliers d’entre eux reçoivent chaque année des scores CVSS de base se situant dans la fourchette « critique ». La gravité seule conduit régulièrement les équipes à se concentrer en premier lieu sur les correctifs inappropriés.
Les plateformes plus avancées peuvent associer la prédiction des failles à des éléments de contexte organisationnel que ne prend pas en compte une évaluation générique de la gravité : configuration du système, exposition, présence éventuelle de contrôles compensatoires réduisant déjà le risque, et impact métier du système concerné – à condition que ces données soient disponibles et correctement intégrées. Il en résulte une liste hiérarchisée qui reflète votre environnement, plutôt qu’un avis générique émanant d’un fournisseur.
Rapports
L'IA permet également de réduire la charge de travail liée à la production de rapports. Les résumés de conformité générés automatiquement, les synthèses sur l'état des correctifs et les justificatifs prêts pour un audit réduisent le travail manuel qui incombe généralement à la personne la moins occupée. Le résultat final doit tout de même faire l'objet d'une vérification humaine, mais la rédaction de la première ébauche demande beaucoup moins d'efforts.
Un compte rendu détaillé des actions menées en matière de gestion des correctifs et de leurs résultats fournit aux équipes le contexte nécessaire pour traiter les problèmes récurrents, et c’est ce dont la direction a besoin pour justifier le budget consacré à la sécurité. L’IA peut produire ce compte rendu de manière plus cohérente qu’une personne qui le rédigerait à 23 heures – même si le résultat doit tout de même être validé afin de détecter d’éventuelles omissions ou erreurs.
Comment utiliser l'IA dans la gestion des correctifs
Commencez modestement. L'IA appliquée à la gestion des correctifs fonctionne mieux en tant que filtre et assistant, et non comme un robot autonome chargé d'appliquer les correctifs et laissé libre cours dans l'environnement de production. Les équipes qui en tirent pleinement parti l'appliquent aux étapes du flux de travail qui génèrent un volume élevé et qui sont régies par des règles claires et reproductibles.
Une approche raisonnable consiste à l'utiliser d'abord pour le triage. Laissez-le classer et regrouper les résultats, puis confiez à un humain la validation de la liste des priorités. De plus, il faut automatiser les classes de correctifs à faible risque et bien testées, pour lesquelles la restauration est garantie, ainsi que les mises à jour courantes de l'espace utilisateur — mais pas les noyaux de production dès le premier jour. Assurez-vous qu'un humain reste impliqué pour toute opération irréversible : noyaux de production, moteurs de bases de données, ou tout autre élément ne pouvant pas être restauré proprement.
Avant de choisir un outil, vous devez également vous assurer que les bases nécessaires sont bien en place. Un système d'IA a besoin d'informations exhaustives sur votre environnement pour formuler des recommandations précises : un inventaire complet des actifs, les configurations actuelles des systèmes, les dépendances documentées et des créneaux de maintenance bien définis. Si vous ne lui fournissez qu'une vision partielle de la situation, vous obtiendrez des recommandations qui semblent fiables, mais qui reposent en réalité sur une vision partielle.
Retour à la réalité : Sur la page marketing d’un outil de correctifs, la mention « alimenté par l’IA » désigne souvent un modèle de hiérarchisation des vulnérabilités CVE, et rien de plus. C’est utile, mais cela ne relève pas de l’autonomie. Demandez au fournisseur de préciser exactement quelles décisions sont prises par le modèle et lesquelles sont soumises à un humain : c’est à cette frontière que le marketing a tendance à prendre le pas sur le produit.
Les meilleurs outils pour gérer les risques liés à la gestion des correctifs
Les outils se divisent en deux catégories : les solutions ponctuelles qui ne font qu’une seule chose (analyse, déploiement ou correction en direct) et les plateformes qui intègrent le flux de travail de bout en bout. Le niveau d’intégration importe davantage que le nombre de fonctionnalités. Un outil d’analyse qui ne s’intègre pas à votre processus de déploiement ne fait que générer davantage d’alertes qu’il faudra ignorer.
La comparaison ci-dessous s'appuie sur quatre critères : l'adéquation avec l'environnement principal, la possibilité pour l'outil d'appliquer des correctifs sans redémarrage du système ou des services, la prise en charge des systèmes d'exploitation et le modèle de licence. Les fonctionnalités et les tarifs étant susceptibles d'évoluer, veuillez vérifier les informations dans la documentation actuelle de chaque fournisseur avant de vous engager.
| Outil | Idéal pour | patching sans redémarrage | Modèle |
| de TuxCare | Parcs informatiques sous Linux, systèmes en fin de vie, disponibilité 24 h/24, 7 j/7 | Oui (noyau + bibliothèques) | Abonnement par hôte |
| Automox | Parcs informatiques hétérogènes, équipes axées sur le cloud | Non | SaaS par terminal |
| ManageEngine Patch Manager Plus | Large gamme d'applications tierces, sur site ou dans le cloud | Non | Licence à plusieurs niveaux |
TuxCare
Ce qui distingue TuxCare dans cette comparaison, c'est la mise en place de correctifs sans interruption de service. KernelCare appliquait des correctifs en temps réel aux noyaux Linux sur des hôtes en fonctionnement, LibCare applique des correctifs en direct aux bibliothèques partagées telles que glibc et OpenSSL sans redémarrer les services qui y sont liés, et le support de cycle de vie illimité permet aux distributions et aux environnements d’exécution en fin de vie de continuer à bénéficier des correctifs CVE même après que le fournisseur d’origine a cessé de fournir des mises à jour de sécurité pour ces versions. TuxCare assure la prise en charge d’un large éventail de distributions Linux d’entreprise, notamment RHEL, CentOS, AlmaLinux, Rocky Linux, CloudLinux, Debian, Ubuntu, Amazon Linux et Oracle Linux – soit plus de 70 versions de distributions au total.
Cette combinaison permet de couvrir les deux aspects du risque lié à la gestion des correctifs. Pour les correctifs pris en charge, l’obligation de redémarrage ou de relance du service, source de retards, est supprimée, tandis que la lacune liée aux systèmes non pris en charge – ces machines impossibles à redémarrer ou à mettre à jour que les procédures de correctifs traditionnelles laissent de côté – reste comblée. Cette solution convient aux équipes exploitant Linux à grande échelle, aux organisations dont les charges de travail sont régies par des SLA de disponibilité, ainsi qu’aux environnements qui doivent maintenir leurs systèmes en fonctionnement au-delà de la période de support du fournisseur.
Automox
Automox est une plateforme cloud native dédiée aux terminaux qui gère l'application des correctifs sous Windows, macOS et Linux à partir d'une console unique, et propose un catalogue de plusieurs centaines d'applications tierces. Son atout réside dans sa portée : elle fonctionne avec des agents, est multiplateforme et conçue pour les parcs informatiques distribués ne disposant pas d'infrastructure sur site.
Cette solution convient parfaitement aux équipes axées sur le cloud et aux petites entreprises qui souhaitent disposer d’un tableau de bord unique pour gérer des terminaux hétérogènes. À la date de publication, Automox ne mentionne pas dans la documentation de son produit la possibilité d’appliquer des correctifs au noyau Linux sans redémarrage ; les temps d’arrêt liés au redémarrage restent donc inévitables pour les mises à jour essentielles de Linux. Toutefois, pour assurer la bonne santé générale des terminaux au sein d’un parc hétérogène, cette solution est très appréciée.
ManageEngine Patch Manager Plus
ManageEngine Patch Manager Plus prend en charge les terminaux Windows, macOS et Linux, ainsi que plus de 1 100 applications tierces, et est disponible sous forme d'installation sur site ou de service cloud. Son principal atout réside dans l'étendue de son catalogue d'applications, ce qui explique pourquoi il est le plus souvent utilisé dans les environnements à forte prédominance Windows comportant un grand nombre de logiciels tiers.
Le processus suit une approche traditionnelle : analyse, planification, test, déploiement, redémarrage. Les risques liés aux processus évoqués précédemment restent pleinement d'actualité. Comme pour toute plateforme de déploiement automatisée, des contrôles insuffisants au niveau des tests et des validations peuvent permettre à une mise à jour problématique d'atteindre l'environnement de production dans les délais prévus ; il convient donc de l'associer à une discipline rigoureuse en matière de tests et de retour en arrière.
Bonnes pratiques de déploiement
L'outillage permet de réduire les risques. C'est la rigueur dans le déploiement qui garantit sa pérennité. Les pratiques ci-dessous permettent de distinguer un programme de correctifs qui réduit les risques de celui qui se contente de générer de l'activité.
- Échelonnez vos déploiements. Déployez d'abord sur un groupe « canary », surveillez les régressions, puis étendez le déploiement. Ne procédez jamais à un déploiement sur l'ensemble du parc en une seule fois.
- Appliquez les correctifs en fonction du niveau de vulnérabilité, et non selon le calendrier. Les CVE répertoriés dans le KEV sont traités en priorité ; les mises à jour de routine suivent le calendrier habituel.
- Vérifiez que la correction a bien été appliquée. Pour le code déjà chargé par un processus en cours d'exécution ou par le noyau, l'installation du paquet ne suffit pas : le composant concerné doit être redémarré, réinitialisé ou corrigé sans redémarrage.
- Conservez une piste d'audit. Consignez les correctifs appliqués, la date et l'auteur de ces interventions, à des fins de conformité et pour l'analyse post-incident que vous espérez ne jamais avoir à mener.
- Dissocier l'urgent de la routine. Apportez des correctifs en temps réel aux vulnérabilités CVE qui ne peuvent pas attendre, afin que le reste du programme puisse continuer à fonctionner à un rythme raisonnable.
Conseil de pro : Sur les systèmes de la famille RHEL, needs-restarting -r (fourni avec dnf-utils) indique si les mises à jour installées suggèrent qu'un redémarrage est nécessaire. Considérez cela comme un signal plutôt que comme une preuve de correction : cela reflète les paquets mis à jour et les processus en cours d'exécution, et non le statut CVE. Lorsqu'un CVE du noyau est couvert par un correctif chargé avec succès sans redémarrage, aucun redémarrage n'est requis pour cette correction spécifique, bien que la commande puisse toujours signaler d'autres mises à jour qui en nécessitent un.
Si votre parc informatique est important et que la disponibilité est un facteur essentiel, privilégiez l'application des correctifs sans redémarrage et mettez en œuvre le reste par étapes. Si vous utilisez principalement Windows et que les redémarrages répondent sans problème à vos exigences en matière de sécurité et de disponibilité, un déploiement par étapes standard avec une option de restauration testée pourrait suffire.
Sécurisez vos systèmes grâce à la gestion des correctifs de TuxCare
Le risque lié à la gestion des correctifs ne se résout pas en multipliant les installations de correctifs. Il se résout en éliminant les raisons qui poussent les équipes à repousser ces opérations – les redémarrages, les temps d'arrêt, la crainte qu'une mise à jour défaillante ne perturbe l'environnement de production – et en assurant une couverture des systèmes que les outils traditionnels négligent.
C'est là que réside le fossé que TuxCare comble. Grâce à l’application de correctifs en direct sur le noyau et les bibliothèques, les correctifs disponibles pour les systèmes pris en charge peuvent être appliqués sans redémarrage. Le support à vie illimité permet de continuer à corriger les distributions et les environnements d’exécution en fin de vie bien après que le fournisseur ait cessé de le faire. Il en résulte une réduction du nombre de vulnérabilités non corrigées et des interruptions de service liées aux correctifs, ce qui diminue les risques à tous les niveaux du processus.
Le choix entre la sécurité et la connectivité en ligne est précisément le dilemme que TuxCare a pour mission de résoudre. N'hésitez pas à nous parler de votre environnement.
FAQ
Exploitation d’une vulnérabilité connue et non corrigée. De nombreuses violations impliquant une faille connue se produisent alors qu’un correctif est déjà disponible, ce qui fait de cette défaillance un problème opérationnel plutôt que technique. Dans le rapport DBIR 2026 de Verizon, l’exploitation de vulnérabilités représentait 31 % des violations et figurait comme le vecteur d’accès initial le plus courant, faisant des vulnérabilités connues et non corrigées l’une des voies d’attaque les plus prévisibles dans les environnements d’entreprise.
Oui. Un correctif défectueux ou non testé peut perturber l'environnement de production, modifier un paramètre par défaut ou introduire un nouveau bogue. Les correctifs peuvent également nécessiter des redémarrages du système ou des services, ce qui comporte le risque que ceux-ci ne se relancent pas correctement ; par ailleurs, des déploiements effectués à la hâte sans possibilité de retour en arrière peuvent entraîner des pannes plus graves que la vulnérabilité CVE qu'ils étaient censés corriger.
Aussi rapidement que votre processus le permet en toute sécurité – idéalement en l’espace de quelques heures à quelques jours pour les CVE activement exploitées. L’exigence 6.3.3 de la norme PCI DSS fixe un délai maximal d’un mois pour les correctifs critiques et de gravité élevée, et le code d’exploitation des failles très médiatisées apparaît souvent dans les heures qui suivent leur divulgation. Les cycles mensuels sont généralement trop lents pour les vulnérabilités activement exploitées ou directement exposées, quel que soit leur score CVSS de base.
Ils ne reçoivent plus les correctifs de sécurité fournis par les éditeurs et deviennent une source de vulnérabilité persistante. Les distributions et les environnements d'exécution en fin de vie continuent de fonctionner, mais accumulent des vulnérabilités non corrigées, à moins que l'entreprise ne procède à une migration, n'applique ses propres correctifs ou n'obtienne un support prolongé. Des services tels que l'« Endless Lifecycle Support » de TuxCare continuent de fournir des correctifs pour ces systèmes sans imposer de migration immédiate.
Cela élimine la phase d'indisponibilité. L'application de correctifs sans redémarrage permet d'appliquer les correctifs pris en charge pour le noyau et les bibliothèques aux systèmes en cours d'exécution sans redémarrage ; ainsi, un correctif disponible peut être déployé en quelques heures, sans avoir à attendre une fenêtre de maintenance. Cela élimine une source majeure de retard et réduit la durée pendant laquelle les systèmes restent exposés.