Suporte Técnico
 Documentação
 Entrar
 Entre em contato conosco


Vá direto para um resumo gerado por IA desta postagem do blog 


Principais conclusões
- A exploração de vulnerabilidades não corrigidas é hoje a forma mais comum de início de violações de segurança, mas a própria aplicação de patches traz riscos por meio de tempo de inatividade, falhas nas atualizações e lacunas de reversão que a maioria das equipes subestima.
- Muitas violações envolvendo uma vulnerabilidade conhecida ocorrem depois que uma correção já estava disponível. A falha é operacional, não técnica.
- Pontuações genéricas de gravidade (pontuações básicas do CVSS, utilizadas sem levar em conta o contexto da ameaça ou do ambiente) são um guia inadequado para a priorização; a possibilidade de exploração e a exposição dos ativos são fatores mais importantes na hora de decidir o que corrigir primeiro.
- A aplicação de patches sem reinicialização elimina uma das principais causas de atraso na aplicação de patches — a reinicialização do sistema ou do serviço —, de modo que as correções compatíveis podem ser implementadas em questão de horas, em vez de ter que aguardar a próxima janela de manutenção.
A maioria das equipes sabe que deveria aplicar as correções mais rapidamente. O que realmente as atrasa não é preguiça. É o medo de que a correção cause algum problema às 2 da manhã em um servidor que ninguém mais entende direito. Assim, a atualização fica na fila. Essa hesitação está no essência do risco do gerenciamento de patches, e é a pergunta que a maioria das equipes está tentando responder: como corrigir vulnerabilidades conhecidas sem que a própria atualização se torne o incidente?
O risco associado ao gerenciamento de patches se manifesta de duas maneiras. Há o risco de deixar os sistemas sem patches e há o risco decorrente do próprio processo de aplicação de patches: falhas nas atualizações, tempo de inatividade e lacunas na reversão das atualizações. Este artigo analisa ambos os tipos, identifica suas causas, mostra o que acontece quando são ignorados e apresenta as etapas práticas e as ferramentas que reduzem o risco em cada uma dessas frentes.
Compreendendo os riscos do gerenciamento tradicional de patches
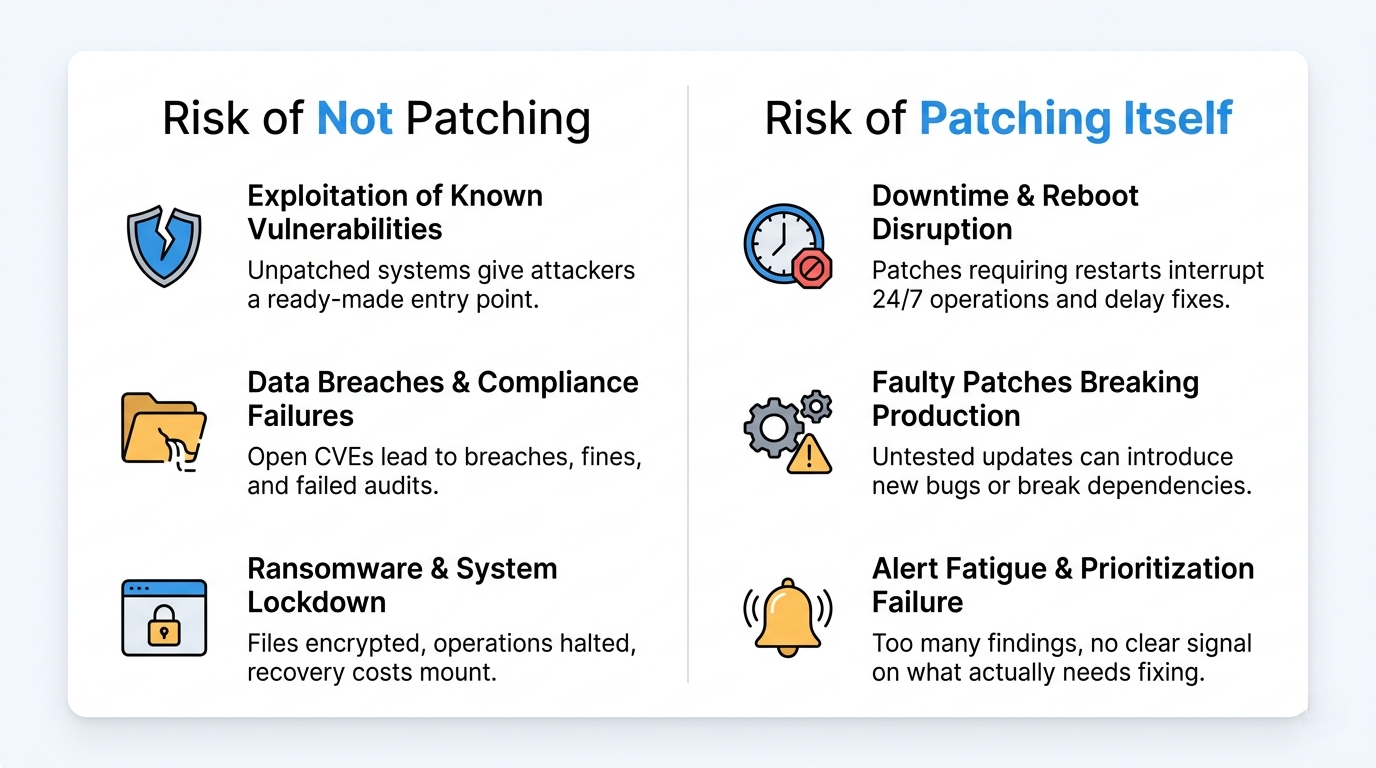
O gerenciamento tradicional de patches segue um ciclo conhecido: verificar se há atualizações pendentes, agendar um intervalo de tempo, testar se há tempo disponível, implementar, reiniciar e confirmar. Na teoria, funciona. Na prática, porém, apresenta riscos em cada etapa.
O modelo pressupõe que é possível colocar os sistemas fora do ar durante janelas de manutenção programadas. Na prática, a infraestrutura raramente coopera. As janelas de manutenção ficam cada vez mais curtas, as cargas de trabalho 24 horas por dia, 7 dias por semana não podem ser reiniciadas e o ambiente de teste nunca corresponde totalmente ao de produção. O resultado é um acúmulo de patches que ficam para “mais tarde”, que é exatamente a situação que os invasores exploram.
A abordagem convencional apresenta três pontos fracos estruturais:
- Isso depende da necessidade de reinicialização. As atualizações tradicionais do kernel geralmente exigem uma reinicialização antes que o novo código seja executado, e as atualizações das bibliotecas principais exigem que os serviços afetados sejam reiniciados. De qualquer forma: tempo de inatividade, o que significa atraso.
- É orientado pelo calendário, não por ameaças. A “Patch Tuesday” e as janelas mensais não levam em conta que uma vulnerabilidade CVE passou a ser explorada ativamente numa quinta-feira.
- O sistema trata a cobertura como o objetivo. Atingir 98% de correções fica bem em um painel de controle, enquanto os 2% restantes concentram uma parcela desproporcional do risco.
Análise da realidade: Uma taxa de conformidade com patches de 98% não é uma métrica de segurança. É uma métrica de cobertura. Os sistemas que compõem os 2% restantes raramente são aleatórios. São os equipamentos legados, os servidores que não podem ser reiniciados, os ambientes de execução sem suporte — exatamente os sistemas que se tornam alvos atraentes assim que ficam expostos e se sabe que são vulneráveis.
Riscos de não aplicar as correções (ou de aplicá-las com muita demora)
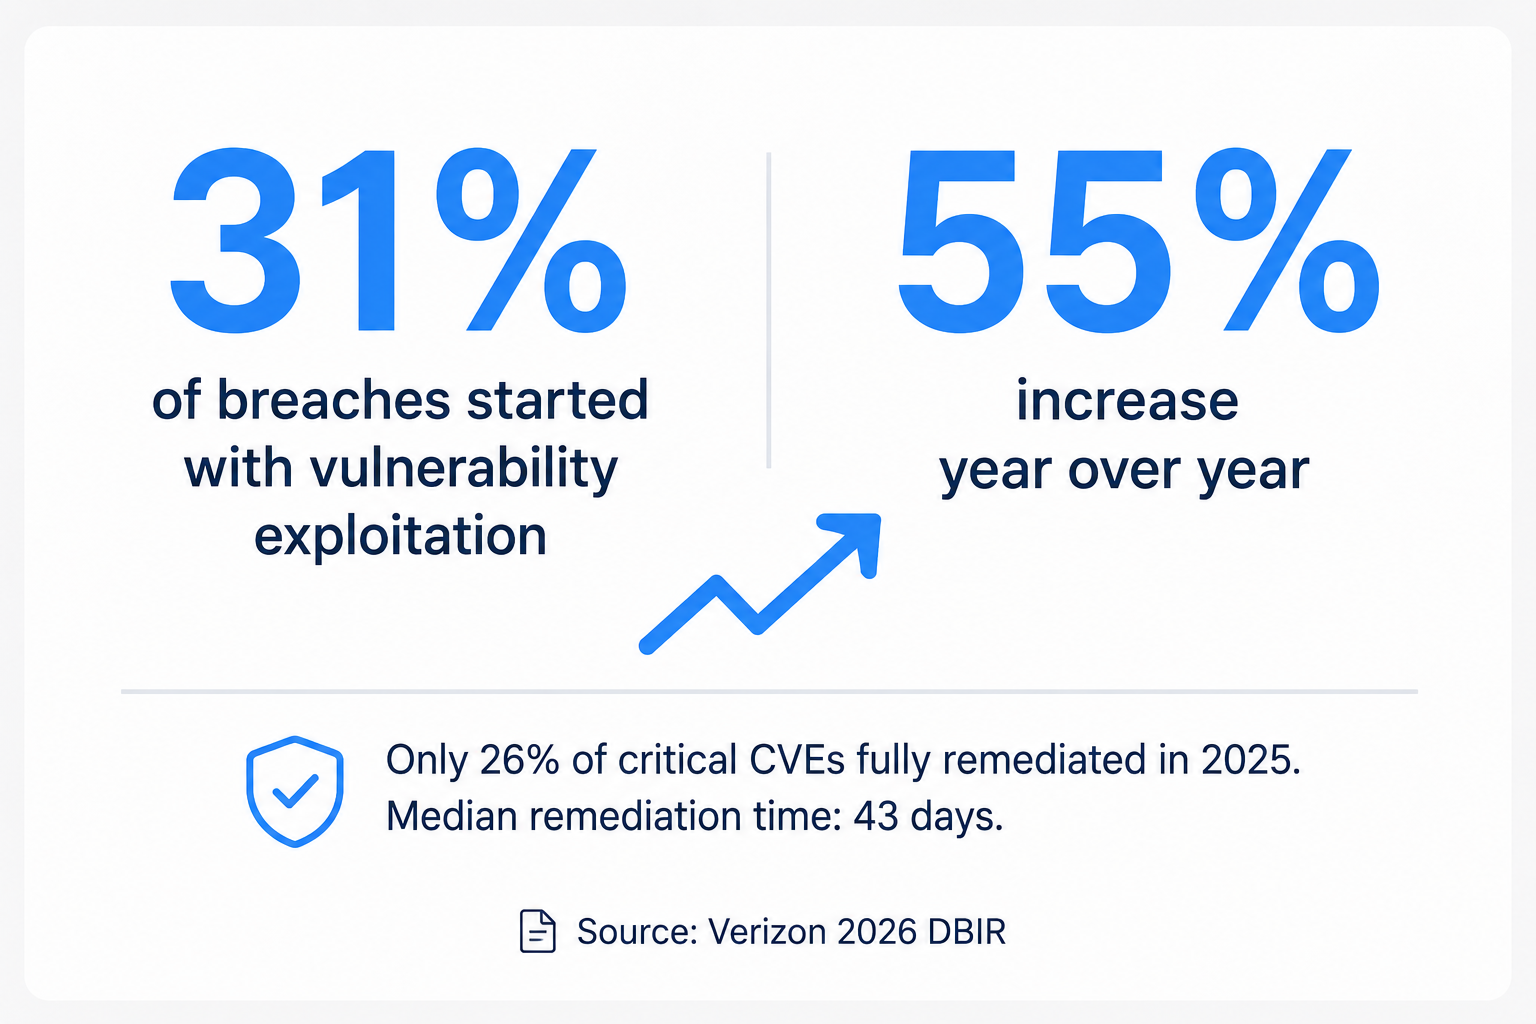
A demora ou a falta de aplicação de patches não é um problema de manutenção de TI. Isso deixa aberta o que se tornou a via de acesso mais comum a uma organização. O Relatório Anual de Investigação sobre Violações de Dados (DBIR) da Verizon de 2026 constatou que a exploração de vulnerabilidades é atualmente o vetor de acesso inicial mais comum para violações, representando 31% dos casos — um aumento em relação aos 20% do ano anterior, o que significa um crescimento de 55% em relação ao ano anterior, e a primeira vez nos 19 anos de história do relatório que a exploração ocupou o primeiro lugar, à frente do uso indevido de credenciais e do phishing.
O mesmo relatório constatou que apenas 26% das vulnerabilidades listadas no KEV da CISA foram totalmente corrigidas em 2025, uma queda em relação aos 38% do ano anterior, enquanto o tempo médio para a resolução completa aumentou de 32 para 43 dias. A correção está perdendo terreno para a exploração.
Esses riscos não ocorrem isoladamente. Uma vulnerabilidade CVE sem correção leva a uma violação de segurança; a violação, por sua vez, gera riscos de não conformidade; e as consequências dessa não conformidade muitas vezes acabam custando mais do que o tempo de inatividade que a equipe estava tentando evitar desde o início.
Exploração de vulnerabilidades conhecidas
O risco mais direto é o mais simples: uma vulnerabilidade CVE é de conhecimento público, existe um patch, e você ainda não o aplicou. Os invasores não precisam de uma vulnerabilidade zero-day quando uma falha conhecida está exposta. Em uma pesquisa realizada em 2019 pelo Ponemon Institute para a ServiceNow, 60% das vítimas de violações afirmaram que a violação se originou de uma vulnerabilidade para a qual havia um patch disponível, mas que não havia sido implantado. Essa pesquisa já é antiga, mas os números de correção do DBIR apresentados acima sugerem que o comportamento subjacente não mudou muito desde então.
No caso de vulnerabilidades de grande repercussão e facilmente exploráveis, o intervalo entre a divulgação e a exploração ativa praticamente se fechou: o código de exploração pode surgir poucas horas após o aviso. Quando chega a janela de manutenção mensal, a vulnerabilidade já pode estar sendo explorada há semanas. O Catálogo de Vulnerabilidades Exploradas da CISA existe justamente porque os invasores se concentram em um conjunto previsível de falhas sem patch e ativamente exploradas.
Isso é mais difícil no kernel e nas bibliotecas principais, onde a correção tradicional exige uma reinicialização do sistema ou dos serviços afetados — e é exatamente por isso que as equipes adiam a aplicação desses patches. O KernelCare da TuxCare aplica correções de CVE do kernel aos kernels Linux suportados sem desligar o host, o que elimina o atraso causado pela reinicialização que mantém esses patches aguardando na fila.
Falhas na conformidade e penalidades financeiras
As estruturas de segurança e conformidade impõem diferentes obrigações ao gerenciamento de vulnerabilidades. O PCI DSS é a mais prescritiva: o Requisito 6.3.3 exige que patches de segurança críticos e de alta gravidade sejam instalados no prazo de um mês após o lançamento, com outros patches aplicáveis dentro de um prazo definido e justificável pela organização. HIPAA e SOC 2 não estabelecem um prazo universal para a aplicação de patches; elas exigem que as organizações demonstrem controles razoáveis e baseados em riscos e, em seguida, sigam efetivamente o processo que documentaram. Na prática, uma vulnerabilidade CVE crítica que permaneça sem correção após o prazo estabelecido pela própria organização é o que gera a constatação de não conformidade na auditoria.
O custo não se resume apenas à multa. Uma auditoria reprovada pode significar a perda de contratos, a suspensão do processamento de pagamentos e tempo de engenharia gasto na correção de falhas sob a pressão de prazos. O Relatório da IBM de 2026 sobre o Custo de uma Violação de Dados estima que o custo médio global de uma violação em um valor recorde de US$ 4,99 milhões, um aumento de 12% em relação ao ano anterior, e esses custos vão muito além da correção técnica, abrangendo detecção e escalonamento, notificação, resposta jurídica e regulatória, além da perda de negócios.
Atenção: Alguns scanners baseados em pacotes relatam um CVE como “corrigido” no momento em que o pacote atualizado é instalado, antes que o serviço afetado seja reiniciado. Em fluxos de trabalho tradicionais de aplicação de patches, um processo em execução pode continuar executando o código vulnerável até que seja reiniciado, recarregado ou corrigido sem reinicialização. O painel mostra verde; a memória pode indicar o contrário. As tecnologias de correção dinâmica compatíveis resolvem isso aplicando correções ao kernel em execução ou ao código de bibliotecas vulneráveis em processos ativos.
Prejuízos operacionais e à reputação
Uma violação em um sistema sem patches raramente fica restrita a um único servidor. O ransomware se espalha lateralmente, a exfiltração de dados ocorre por dias antes de ser detectada, e a recuperação consome a mesma equipe que já estava ocupada demais para aplicar as correções.
Depois, há aquele aspecto que nenhuma planilha consegue capturar: a confiança. Clientes, parceiros e órgãos reguladores leem a mesma divulgação. “Sabíamos da vulnerabilidade, mas ainda não tínhamos aplicado o patch” está entre as frases mais prejudiciais que uma empresa pode ser obrigada a publicar.
Riscos inerentes ao próprio processo de gerenciamento de patches
O outro lado da moeda recebe muito menos atenção: o ato de aplicar patches traz riscos que as abordagens tradicionais não conseguem lidar adequadamente. As organizações se concentram excessivamente nas métricas de cobertura de patches e deixam passar as falhas no nível dos processos que estão por trás delas.
Essa é uma visão mais matizada do risco relacionado ao gerenciamento de patches. Não se trata de “aplicamos os patches?”, mas sim de “quanto nos custou a aplicação dos patches e o que ela danificou sem que percebêssemos?”. Os riscos abaixo são o motivo pelo qual equipes experientes hesitam — e essa hesitação se reconecta diretamente aos riscos de sistemas sem patches mencionados acima.
Patches com falhas ou não testados que prejudicam o ambiente de produção
Um patch é um software, e o software pode causar regressões. Uma atualização do fornecedor pode trazer um novo bug, alterar uma configuração padrão ou entrar em conflito com uma dependência da qual você nem sabia que dependia. Os danos causados por um patch defeituoso podem ser comparáveis à vulnerabilidade que ele deveria corrigir.
É por isso que as equipes realizam testes no ambiente de staging – só que o ambiente de staging raramente reflete exatamente o ambiente de produção, e é nessa diferença que surgem as surpresas. Uma correção que funciona perfeitamente em uma máquina de teste nova pode falhar em um servidor com três anos de desvios de configuração acumulados.
Da linha de frente: Imagine uma atualização de rotina da biblioteca enviada diretamente para o ambiente de produção numa sexta-feira porque “parecia insignificante”. Ela altera uma configuração padrão do TLS, interrompe a validação do certificado em relação à API de um parceiro e deixa o processo de checkout fora do ar por seis horas. O CVE corrigido tinha uma pontuação base CVSS de 5,3. A interrupção causou danos imediatos e mensuráveis; a falha não explorada, nenhum.
Períodos de inatividade, reinicializações e janelas de manutenção
Muitas atualizações do kernel, das bibliotecas principais e dos serviços do sistema tradicionalmente exigem uma reinicialização do sistema ou uma reinicialização dos serviços afetados antes que o novo código entre em vigor. Para uma carga de trabalho 24 horas por dia, 7 dias por semana, essa reinicialização representa um risco. Cada reinicialização é uma possibilidade de um serviço não voltar a funcionar, de uma montagem falhar ou de uma configuração ser carregada incorretamente.
O problema de agendamento agrava ainda mais a situação. As equipes globais não têm horários de folga em comum, e as janelas de manutenção estão cada vez mais reduzidas. Assim, os patches são agrupados, os lotes sofrem atrasos e esse atraso reabre o risco de sistemas sem patches. A aplicação de patches em bibliotecas do espaço do usuário esbarra no mesmo obstáculo: a atualização glibc ou OpenSSL , de maneira convencional, exige a reinicialização dos serviços afetados que estão vinculados a elas.
Essa é a lacuna para a aplicação de patches sem reinicialização foi desenvolvido. Aplicar correções a um kernel em execução ou a uma biblioteca compartilhada sem a necessidade de reinicialização elimina, de uma só vez, o risco de tempo de inatividade e o atraso que ele causa. O LibCare da TuxCare da TuxCare amplia esse modelo para bibliotecas compartilhadas suportadas, incluindo OpenSSL e glibc.
Fadiga de alertas e falha na priorização
Scanners de vulnerabilidades são implacáveis. Um ambiente de médio porte pode revelar milhares de resultados por mês, e apenas uma pequena fração deles chega a ser explorada em algum lugar. Quando tudo é sinalizado como crítico, nada é realmente crítico.
As equipes de segurança acabam se distraindo. Ou se dedicam a investigar descobertas de baixo risco enquanto um CVE genuinamente explorável fica à espera, ou deixam passar o único alerta que realmente importava em meio ao ruído. A solução é priorizar com base na explorabilidade no mundo real, em vez de pontuações brutas do CVSS — e é aí que entram os dados de previsão de exploração.
O que acontece quando os riscos não são abordados?
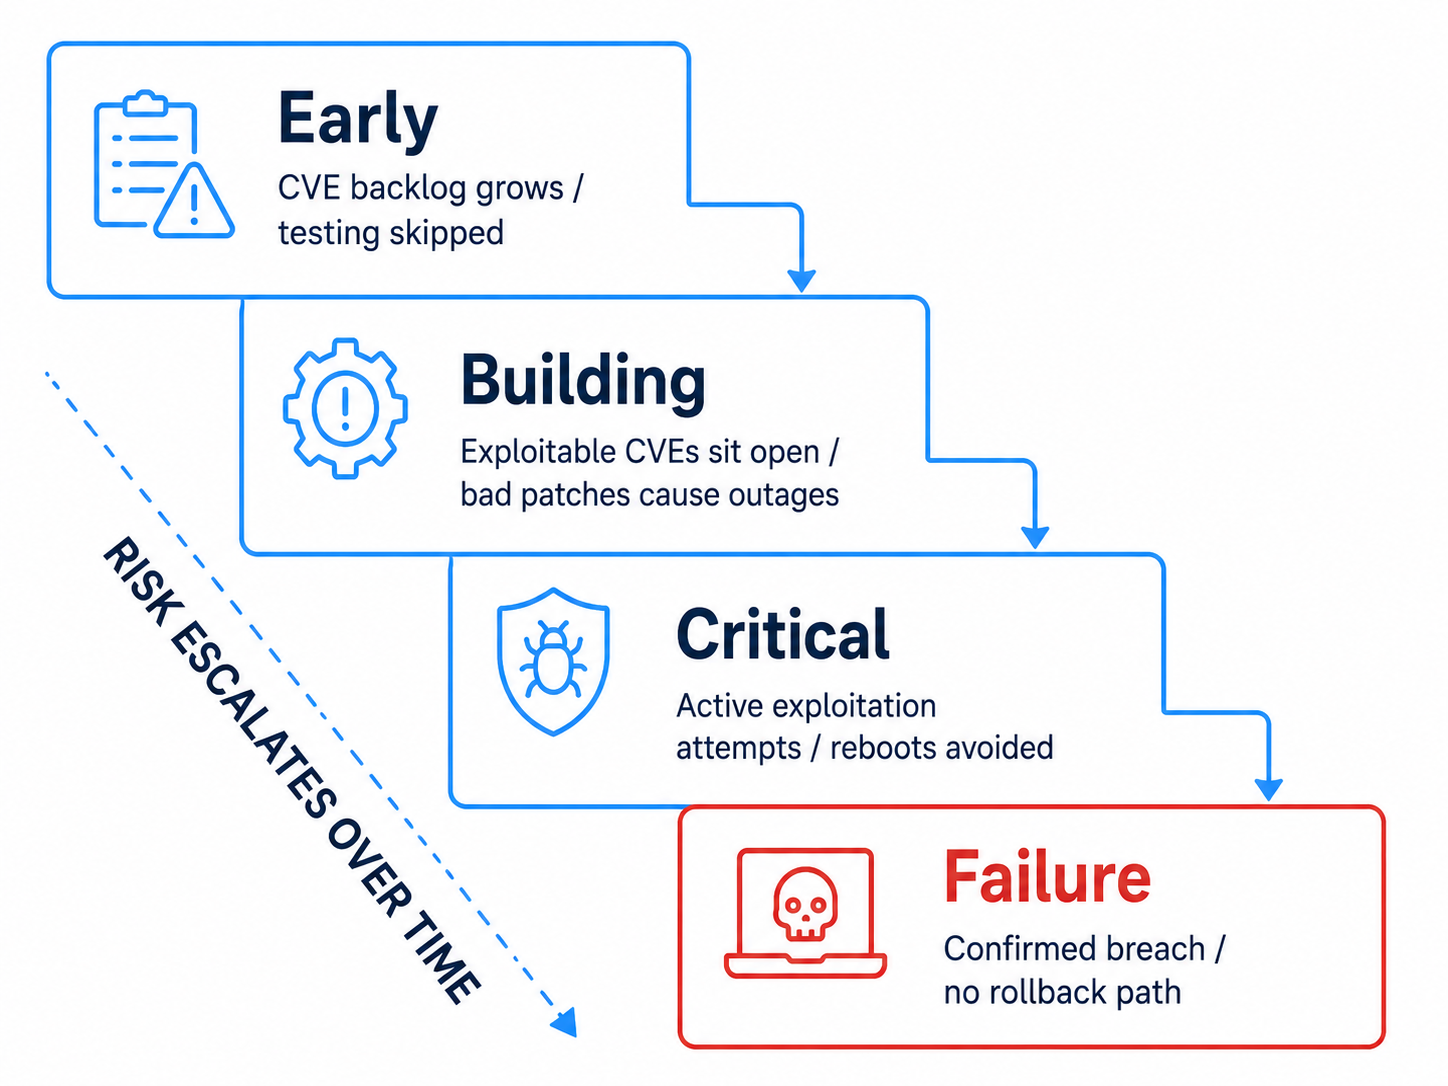
Se ignorarmos ambos os aspectos do risco relacionado ao gerenciamento de patches por tempo suficiente, os modos de falha se acumulam. Os riscos decorrentes de sistemas sem patches e os riscos relacionados aos processos não são problemas distintos — eles se alimentam mutuamente, levando a uma crise que se desenvolve lentamente.
Veja como a situação entre os dois lados se agrava quando nada muda:
| Palco | Lado sem remendo | Lado do processo |
| No início | Aumenta o acúmulo de CVEs adiadas | As equipes deixam de fazer os testes para economizar tempo |
| Construção | Vulnerabilidades CVE exploráveis permanecem expostas por semanas | Problemas na rede causam interrupções ocasionais |
| Crítico | Exploração ativa, tentativas de invasão | Reinicializações evitadas, correções deixam de ser aplicadas |
| Falha | Violação confirmada, risco de não conformidade | Instabilidade na produção, sem caminho de reversão |
O resultado final é uma equipe que se sente insegura e tem medo de aplicar correções — aplicando menos correções porque elas acabam causando problemas, e causando problemas com mais frequência porque os sistemas que acumulam esse acúmulo de tarefas se afastam cada vez mais de um estado em que se sabe que funcionam bem.
Como reduzir os riscos relacionados ao gerenciamento de patches
Gerenciamento eficaz de patches significa lidar com os dois aspectos ao mesmo tempo: a lacuna nas atualizações e as falhas no nível do processo. Corrija um e ignore o outro, e você apenas terá transferido o risco para outro lugar.
Deve funcionar como um sistema, não como uma lista de verificação. As etapas abaixo se complementam. A disciplina nos testes influencia a definição de prioridades, a definição de prioridades influencia a implantação, e a eliminação da necessidade de reinicialização faz com que todo o ciclo seja mais rápido.
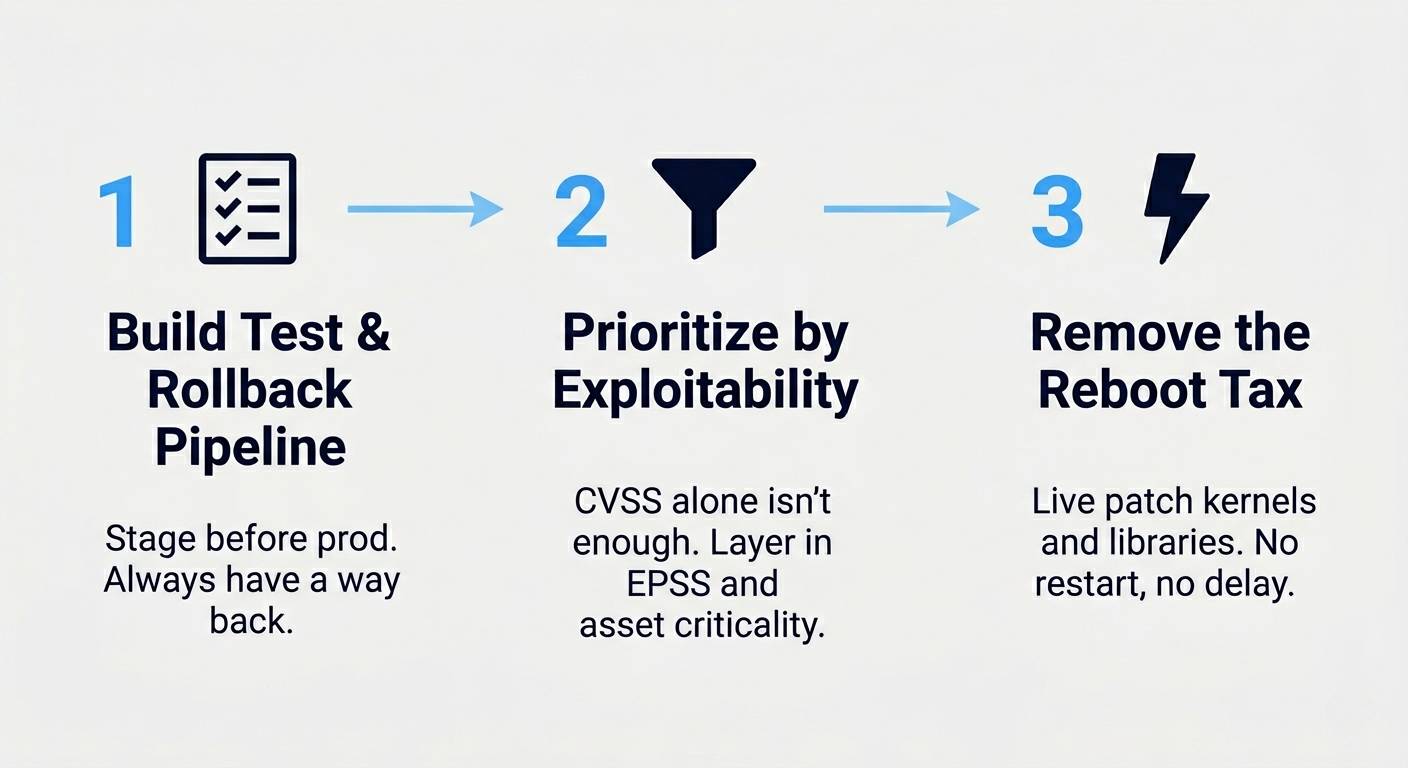
Etapa 1: Criar um pipeline de testes e reversão em ambiente real
Antes que uma correção chegue ao ambiente de produção, é necessário que ela passe por um ambiente representativo e que haja um caminho de retorno testado e confiável. Duas coisas que reduzem o risco de forma mensurável:
- Um ambiente de teste que espelha o ambiente de produção: mesmas versões do sistema operacional, mesma configuração principal, mesmas dependências essenciais. Os sistemas de teste baseados em instantâneos ajudam nesse sentido, tornando os testes repetidos reproduzíveis.
- Uma reversão automatizada: fixação de pacotes, instantâneos do sistema de arquivos ou controle de versão de imagens de contêineres, de modo que a reversão seja feita com um único comando, em vez de um processo minucioso.
Se um patch passar pela fase de teste e você conseguir reverter a aplicação sem problemas, faça a implantação com confiança. Se não for possível reverter a aplicação sem problemas, isso não é automaticamente um motivo para esperar — no caso de um CVE que esteja sendo ativamente explorado, esperar costuma ser a opção mais arriscada. Adicione controles compensatórios, implante primeiro em um grupo canário e documente a decisão antes de prosseguir. Um patch que não pode ser revertido é uma aposta no controle de qualidade do fornecedor, e essa aposta deve ser deliberada.
Etapa 2: Priorize com base na explorabilidade, não no volume
Pare de tratar todas as vulnerabilidades com pontuação CVSS 9,8 da mesma forma. Uma falha de alta gravidade, sem exploit público e sem exposição à rede, tem menor urgência do que uma de gravidade média que esteja sob ataque ativo. Utilize sinais da camada três para filtrar o ruído:
- Status da vulnerabilidade: ela consta no Catálogo KEV da CISA ou apresenta uma pontuação EPSS alta ou em rápido aumento?
- Exposição: o serviço afetado está exposto à Internet ou é apenas interno?
- Criticidade dos ativos: o equipamento contém dados regulamentados ou executa processos essenciais para a receita?
Priorize as vulnerabilidades que apresentam a combinação mais forte desses três fatores. Você ainda vai adiar a aplicação de alguns patches — a diferença é que você está escolhendo quais deles e pode justificar essa escolha.
Etapa 3: Remova a necessidade de reinicialização com a aplicação de patches sem reinicialização
Para sistemas em que o tempo de atividade é essencial, o custo do tempo de inatividade decorrente de reinicializações e reinícios de serviços é uma das principais causas do atraso na aplicação de patches. Ao eliminar essa restrição, uma parte significativa do acúmulo de tarefas é resolvida por si só. A aplicação de patches sem reinicialização aplica correções compatíveis do kernel e das bibliotecas a sistemas em execução sem a necessidade de reinicialização; assim, um patch sem reinicialização disponível pode ser implantado em questão de horas, em vez de se esperar pela próxima janela de manutenção.
Como a IA pode ajudar no gerenciamento de patches
A IA é útil no gerenciamento de patches por um motivo: essa área está sobrecarregada de dados, e correlacionar e classificar grandes volumes deles com rapidez é o que esses sistemas fazem de melhor. Ela não substitui o julgamento humano. Ela reduz o volume de decisões que uma pessoa precisa tomar.
IA e identificação de riscos
Ferramentas assistidas por IA correlacionam feeds do CVE, inventários de ativos e dados de configuração mais rapidamente do que qualquer análise manual. Em vez de um ser humano cruzar as informações de um novo aviso com uma lista de ativos, o sistema sinaliza quais dos seus hosts específicos estão afetados. Com dados de dependências e de tempo de execução suficientemente completos, ele também pode ajudar a identificar exposições indiretas: uma biblioteca vulnerável oculta em vários níveis de profundidade em uma árvore de dependências ou um serviço que, tecnicamente, recebeu o patch, mas ainda está executando o código antigo na memória.
Pense nisso como uma camada automatizada de alerta antecipado que correlaciona, simultaneamente, lançamentos de patches, bancos de dados de vulnerabilidades e feeds de ameaças — não porque um ser humano não fosse capaz de fazer isso, mas porque nenhum ser humano tem capacidade suficiente para lidar com esse volume sem deixar passar nada.
Priorização de riscos com tecnologia de IA
É aqui que a IA mostra seu valor. Modelos treinados com dados de explorações podem estimar quais CVEs têm maior probabilidade de serem exploradas, classificando as descobertas com base no risco provável no mundo real, em vez de apenas na gravidade bruta. Isso combate diretamente o problema da fadiga de alertas.
Você sabia? O EPSS – o Sistema de Pontuação de Previsão de Exploração (Exploit Prediction Scoring System), mantido pela FIRST – estima a probabilidade de que uma atividade de exploração envolvendo um CVE publicado seja observada nos próximos 30 dias. Uma pesquisa realizada pelo Cyentia Institute e pela FIRST constatou que apenas cerca de 6% dos CVEs publicados já foram observados sendo explorados em ambiente real, enquanto milhares recebem pontuações CVSS básicas na faixa crítica todos os anos. A gravidade, por si só, costuma levar as equipes a escolherem inicialmente as correções erradas.
Plataformas mais avançadas podem combinar a previsão de vulnerabilidades com o contexto organizacional que uma classificação genérica de gravidade ignora — configuração do sistema, exposição, se controles compensatórios já reduzem o risco e o impacto nos negócios do sistema afetado —, desde que os dados estejam disponíveis e corretamente integrados. O resultado é uma lista priorizada que reflete o seu ambiente, em vez de um comunicado genérico de um fornecedor.
Relatórios
A IA também reduz a carga administrativa relacionada à geração de relatórios. Resumos de conformidade gerados automaticamente, resumos do status de patches e evidências prontas para auditoria reduzem o trabalho manual que geralmente recai sobre quem estiver menos ocupado. O resultado final ainda precisa de uma verificação humana, mas a elaboração da primeira versão exige muito menos esforço.
Um registro detalhado das iniciativas e dos resultados do gerenciamento de patches oferece às equipes o contexto necessário para lidar com problemas recorrentes, e é exatamente o que a liderança precisa para justificar o orçamento de segurança. A IA pode produzir esse registro de forma mais consistente do que uma pessoa que o redija às 23h — embora o resultado ainda precise ser validado para verificar se há omissões ou erros próprios.
Como usar a IA no gerenciamento de patches
Comece aos poucos. A IA no gerenciamento de patches funciona melhor como um filtro e um assistente, e não como um robô autônomo de aplicação de patches solto no ambiente de produção. As equipes que obtêm valor com ela a aplicam às partes do fluxo de trabalho que apresentam alto volume e são regidas por regras claras e repetíveis.
Um caminho sensato para a adoção envolve usá-lo primeiro para triagem. Deixe que ele classifique e agrupe os resultados e, em seguida, peça a um profissional para aprovar a lista de prioridades. Além disso, é necessário automatizar classes de patches de baixo risco e bem testadas, com reversão comprovada, bem como atualizações de rotina no espaço do usuário — e não kernels de produção logo no primeiro dia. Mantenha um profissional a par de tudo o que for irreversível. Kernels de produção, mecanismos de banco de dados, qualquer coisa que não permita uma reversão limpa.
Antes de escolher uma ferramenta, você também precisa ter uma base sólida estabelecida. Um sistema de IA precisa de informações abrangentes sobre o seu ambiente para fazer recomendações precisas: um inventário completo de ativos, configurações atuais do sistema, dependências documentadas e janelas de manutenção definidas. Se você fornecer apenas uma visão parcial, receberá recomendações que parecem confiáveis, mas que se baseiam nessa visão parcial.
Análise da realidade: A expressão “baseado em IA” na página de marketing de uma ferramenta de correção de vulnerabilidades geralmente significa apenas um modelo de priorização de CVEs e nada mais. Isso é útil, mas não é autonomia. Pergunte ao fornecedor exatamente quais decisões o modelo toma e quais ele encaminha para um ser humano – é nessa fronteira que o marketing tende a ultrapassar o produto.
As melhores ferramentas para gerenciar os riscos relacionados ao gerenciamento de patches
As ferramentas se dividem em dois grupos: soluções pontuais que realizam uma única tarefa (verificação, implantação ou correção dinâmica) e plataformas que integram o fluxo de trabalho de ponta a ponta. A profundidade da integração é mais importante do que o número de recursos. Um verificador que não se conecta ao seu caminho de implantação apenas gera mais alertas para serem ignorados.
A comparação a seguir utiliza quatro critérios: adequação ao ambiente principal, se a ferramenta pode aplicar correções sem a necessidade de reinicialização do sistema ou reinício do serviço, cobertura de sistemas operacionais e modelo de licenciamento. Os recursos e os preços estão sujeitos a alterações; portanto, verifique a documentação atual de cada fornecedor antes de tomar uma decisão.
| Ferramenta | Ideal para | aplicação de patches sem reinicialização | Modelo |
| TuxCare | Frotas Linux, sistemas em fim de vida útil, disponibilidade 24 horas por dia, 7 dias por semana | Sim (kernel + bibliotecas) | Assinatura por host |
| Automox | Frotas com sistemas operacionais mistos, equipes que priorizam a nuvem | Não | SaaS por terminal |
| ManageEngine Patch Manager Plus | Ampla cobertura de aplicativos de terceiros, seja no local ou na nuvem | Não | Licença por níveis |
TuxCare
O diferencial da TuxCare nessa comparação é a aplicação de patches sem tempo de inatividade. O KernelCare aplicava correções em tempo real em kernels Linux compatíveis em hosts em execução, O LibCare aplicava patches em tempo real em bibliotecas compartilhadas, como glibc e OpenSSL, sem reiniciar os serviços vinculados a elas, e Suporte de Ciclo de Vida Ilimitado garante que distribuições e ambientes de execução em fim de vida continuem recebendo correções de CVE mesmo após o fornecedor original interromper o fornecimento de atualizações de segurança para essas versões. A TuxCare oferece cobertura para uma ampla gama de distribuições Linux corporativas, incluindo RHEL, CentOS, AlmaLinux, Rocky Linux, CloudLinux, Debian, Ubuntu, Amazon Linux e Oracle Linux – mais de 70 versões de distribuições no total.
Essa combinação aborda os dois lados do risco relacionado ao gerenciamento de patches. Para correções com suporte, a exigência de reinicialização ou reinício do serviço — que causa atrasos — é eliminada, e a lacuna dos sistemas sem suporte — os equipamentos que não podem ser reiniciados nem atualizados e que o processo tradicional de aplicação de patches deixa de lado — continua coberta. Ela é ideal para equipes que operam o Linux em grande escala, organizações com cargas de trabalho regidas por SLAs de tempo de atividade e ambientes que precisam manter os sistemas em funcionamento além do período de suporte do fornecedor.
Automox
O Automox é uma plataforma de terminais nativa da nuvem que gerencia a aplicação de patches no Windows, macOS e Linux a partir de um único console, além de oferecer um catálogo com várias centenas de aplicativos de terceiros. Sua vantagem é o alcance: baseada em agente, multiplataforma e projetada para frotas distribuídas sem infraestrutura local.
É uma excelente opção para equipes que priorizam a nuvem e organizações menores que desejam um único painel de controle para terminais de tipos diversos. No momento da publicação, a Automox não menciona a aplicação de patches no kernel do Linux sem reinicialização em sua documentação do produto; portanto, o tempo de inatividade causado pela reinicialização ainda se aplica às atualizações essenciais do Linux — mas, para a manutenção geral dos terminais em um ambiente misto, a solução é bem conceituada.
ManageEngine Patch Manager Plus
O ManageEngine Patch Manager Plus é compatível com terminais Windows, macOS e Linux, além de mais de 1.100 aplicativos de terceiros, e está disponível como instalação local ou serviço em nuvem. Seu principal ponto forte é a amplitude desse catálogo de aplicativos, razão pela qual ele é mais frequentemente utilizado em ambientes com predominância de Windows que contam com uma ampla variedade de softwares de terceiros.
Segue o modelo tradicional: digitalizar, programar, testar, implantar, reiniciar. Os riscos relacionados aos processos abordados anteriormente continuam válidos em sua totalidade. Assim como em qualquer plataforma de implantação automatizada, controles fracos de teste e aprovação podem permitir que uma atualização problemática chegue ao ambiente de produção dentro do prazo; portanto, combine-a com uma disciplina sólida de testes e reversão.
Melhores práticas para implantação
As ferramentas reduzem o risco. A disciplina na implantação é o que garante a sua eficácia. As práticas abaixo diferenciam um programa de correções que reduz o risco daquele que apenas gera atividade.
- Faça implementações em fases. Implemente em um grupo canário, fique atento a regressões e, em seguida, expanda. Nunca faça a implantação em toda a frota de uma só vez.
- Aplique as correções de acordo com o nível de vulnerabilidade, e não com base no calendário. Os CVEs listados no KEV têm prioridade; as atualizações de rotina seguem o cronograma normal.
- Confirme se a correção realmente entrou em vigor. Para códigos já carregados por um processo em execução ou pelo kernel, instalar o pacote não é suficiente — o componente afetado precisa ser reiniciado, o sistema reiniciado ou corrigido sem reinicialização.
- Mantenha um registro de auditoria. Registre o que foi corrigido, quando e por quem – para fins de conformidade e para a análise pós-incidente que você espera nunca precisar realizar.
- Separe o que é urgente do que é rotineiro. Aplique correções em tempo real nas vulnerabilidades (CVEs) que não podem esperar, para que o restante do programa possa manter um ritmo adequado.
Dica profissional: Em sistemas da família RHEL, o comando `needs-restarting -r` (incluído no pacote dnf-utils) indica se as atualizações instaladas sugerem que é necessária uma reinicialização. Trate isso como um sinal, e não como prova de correção: ele reflete pacotes atualizados e processos em execução, não o status do CVE. Quando um CVE do kernel é coberto por um patch carregado com sucesso sem necessidade de reinicialização, não é necessária reinicialização para essa correção específica, embora o comando ainda possa sinalizar outras atualizações que exijam reinicialização.
Se sua frota for grande e o tempo de atividade for importante, priorize a aplicação de patches sem reinicialização e implemente o restante em fases. Se você tiver muitos sistemas Windows e a reinicialização atender confortavelmente aos seus requisitos de segurança e disponibilidade, a implantação em fases padrão, com reversão testada, pode ser tudo o que você precisa.
Proteja seus sistemas com o gerenciamento de patches da TuxCare
O risco relacionado ao gerenciamento de patches não é resolvido com a aplicação mais rigorosa de patches. Ele é resolvido eliminando os motivos que levam as equipes a adiar a aplicação — as reinicializações, o tempo de inatividade, o medo de que uma atualização defeituosa prejudique a produção — e mantendo a cobertura nos sistemas que as ferramentas tradicionais deixam de lado.
Essa é a lacuna que a TuxCare preenche. A aplicação de patches em tempo real no kernel e nas bibliotecas significa que as correções disponíveis para os sistemas suportados podem ser aplicadas sem a necessidade de reinicialização. O Suporte de Ciclo de Vida Ilimitado mantém as distribuições e os ambientes de execução em fim de vida (EOL) atualizados com patches muito tempo depois que o fornecedor interrompe o suporte. O resultado é um número menor de vulnerabilidades em aberto e menos interrupções causadas pela aplicação de patches – reduzindo o risco em ambas as etapas do processo.
A escolha entre manter a segurança e permanecer conectado é exatamente o dilema que a TuxCare foi criada para eliminar. Fale conosco sobre o seu ambiente.
Perguntas frequentes
Exploração de uma vulnerabilidade conhecida e sem correção. Muitas violações envolvendo uma falha conhecida ocorrem depois que uma correção já está disponível, o que torna a falha operacional, e não técnica. No DBIR 2026 da Verizon, a exploração de vulnerabilidades representou 31% das violações e foi classificada como o vetor de acesso inicial mais comum, tornando as vulnerabilidades conhecidas e não corrigidas uma das vias de ataque mais previsíveis em ambientes corporativos.
Sim. Um patch com defeito ou não testado pode prejudicar o ambiente de produção, alterar uma configuração padrão ou introduzir um novo bug. Os patches também podem exigir reinicializações do sistema ou dos serviços, o que acarreta o risco de que os serviços não voltem a funcionar corretamente; além disso, implantações apressadas, sem um plano de reversão, podem causar interrupções mais graves do que o CVE que foram corrigidas.
Tão rápido quanto seu processo permitir com segurança – idealmente, em questão de horas a alguns dias para CVEs que estão sendo explorados ativamente. O requisito 6.3.3 do PCI DSS estabelece um prazo máximo de um mês para patches críticos e de alta gravidade, e o código de exploração para falhas de grande repercussão geralmente surge poucas horas após a divulgação. Ciclos mensais costumam ser lentos demais para vulnerabilidades que estão sendo exploradas ativamente ou que estão diretamente expostas, independentemente de sua pontuação CVSS básica.
Eles deixam de receber correções de segurança dos fornecedores e se tornam uma fonte de exposição contínua. As distribuições e ambientes de execução em fim de vida útil (EOL) continuam funcionando, mas acumulam vulnerabilidades sem correção, a menos que a organização migre, aplique retroativamente suas próprias correções ou obtenha suporte estendido. Serviços como o Endless Lifecycle Support da TuxCare continuam fornecendo patches para esses sistemas sem exigir uma migração imediata.
Isso elimina a etapa de inatividade. A aplicação de patches sem reinicialização aplica correções compatíveis do kernel e das bibliotecas a sistemas em execução sem a necessidade de reinicialização; assim, uma correção disponível pode ser implantada em questão de horas, em vez de se esperar por uma janela de manutenção. Isso elimina uma das principais fontes de atraso e reduz o tempo em que os sistemas permanecem expostos.