Soporte técnico
 Documentación
 Inicio de sesión
 Contáctenos


Ir directamente al resumen generado por IA de esta entrada del blog 


Principales conclusiones
- El aprovechamiento de vulnerabilidades sin parchear es actualmente la forma más habitual en que se producen las brechas de seguridad, pero la propia aplicación de parches conlleva riesgos derivados del tiempo de inactividad, los fallos en las actualizaciones y las lagunas en la reversión de cambios, que la mayoría de los equipos subestiman.
- Muchas brechas de seguridad relacionadas con una vulnerabilidad conocida se producen cuando ya existía una solución disponible. El fallo es de carácter operativo, no técnico.
- Las puntuaciones genéricas de gravedad (puntuaciones CVSS básicas, utilizadas sin tener en cuenta el contexto de la amenaza ni el entorno) no son una buena guía para establecer prioridades; la posibilidad de explotación y la exposición de los activos son factores más importantes a la hora de decidir qué corregir primero.
- La aplicación de parches sin necesidad de reiniciar elimina una de las principales causas de retraso en la aplicación de parches —el reinicio del sistema o del servicio—, por lo que las correcciones compatibles pueden implementarse en cuestión de horas, en lugar de tener que esperar a la siguiente ventana de mantenimiento.
La mayoría de los equipos saben que deberían aplicar los parches más rápido. Lo que realmente les frena no es la pereza, sino el miedo a que el parche provoque algún fallo a las 2 de la madrugada en un equipo que ya nadie entiende del todo. Así que la actualización se queda en la cola. Esa vacilación constituye el centro del riesgo de la gestión de parches, y es la pregunta que la mayoría de los equipos intentan responder: ¿cómo se cierran las vulnerabilidades conocidas sin que el propio parche se convierta en el incidente?
El riesgo asociado a la gestión de parches se presenta en dos sentidos. Por un lado, existe el peligro de dejar los sistemas sin parches; por otro, están los riesgos que conlleva el propio proceso de aplicación de parches: actualizaciones fallidas, tiempos de inactividad y lagunas en la aplicación de parches. Este artículo analiza ambos tipos de riesgos, identifica sus causas, muestra qué ocurre cuando se ignoran y explica los pasos prácticos y las herramientas que permiten reducir el riesgo en cada uno de estos ámbitos.
Comprender los riesgos de la gestión tradicional de parches
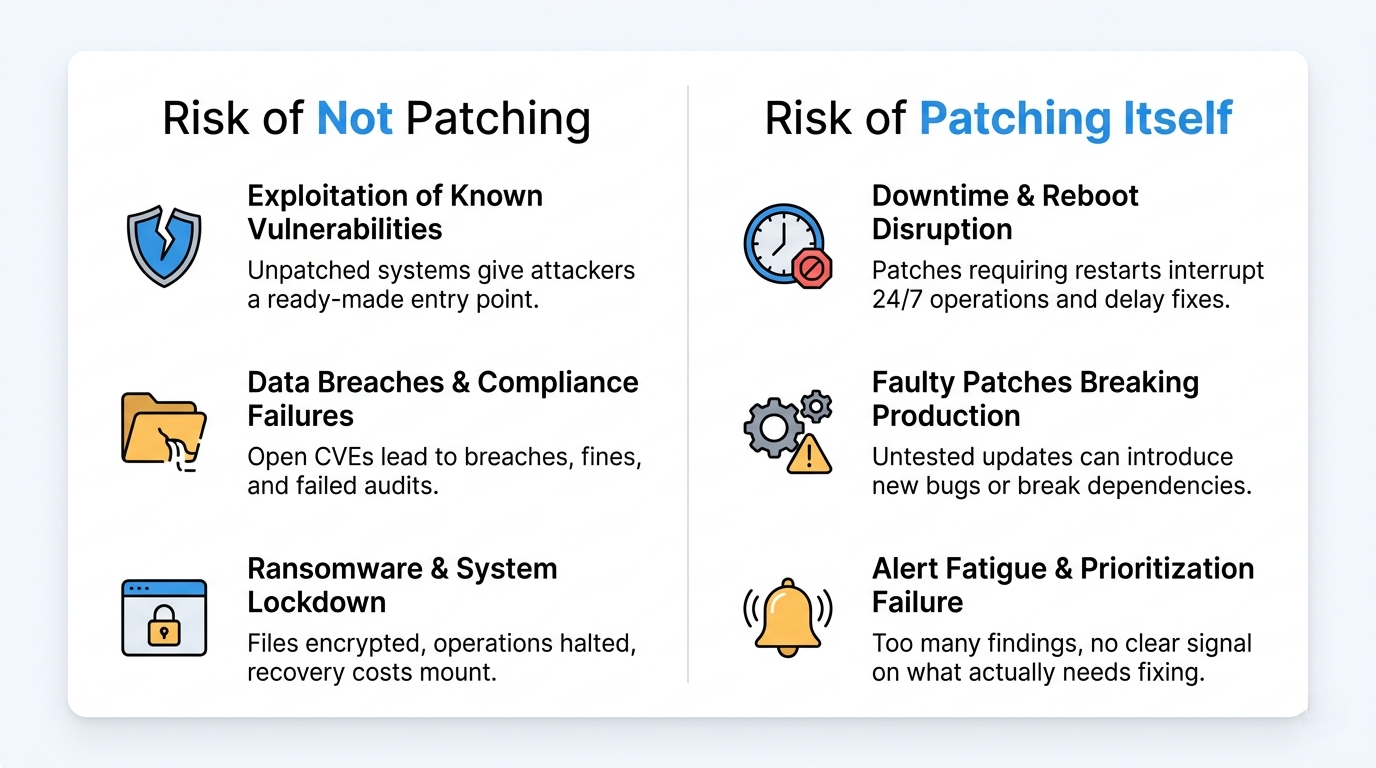
La gestión tradicional de parches sigue un ciclo habitual: buscar las actualizaciones pendientes, programar una franja horaria, comprobar si hay tiempo, implementarlas, reiniciar el sistema y confirmar. En teoría, funciona. En la práctica, entraña riesgos en cada paso.
El modelo parte de la base de que se pueden desconectar los sistemas durante las ventanas de mantenimiento programadas. Sin embargo, la infraestructura real rara vez se adapta a ello. Las ventanas de mantenimiento se reducen, las cargas de trabajo que funcionan las 24 horas del día, los 7 días de la semana no se pueden reiniciar y el entorno de pruebas nunca coincide del todo con el de producción. El resultado es una acumulación de parches que «ya se harán más adelante», que es precisamente la situación que aprovechan los atacantes.
El enfoque convencional adolece de tres deficiencias estructurales:
- Depende de si hay que reiniciar el sistema. Las actualizaciones tradicionales del núcleo suelen requerir un reinicio para que se ejecute el nuevo código, y las actualizaciones de las bibliotecas principales requieren que se reinicien los servicios afectados. En cualquier caso, se produce un tiempo de inactividad, lo que supone un retraso.
- Se rige por el calendario, no por las amenazas. Al «Patch Tuesday» y a los periodos mensuales no les importa que un CVE haya sido objeto de explotación activa un jueves.
- Considera que la cobertura es el objetivo. Alcanzar un 98 % de parches queda bien en un panel de control, mientras que el 2 % restante concentra una parte desproporcionada del riesgo.
Una visión realista: Una tasa de cumplimiento de parches del 98 % no es un indicador de seguridad. Es un indicador de cobertura. Los sistemas que conforman ese 2 % restante rara vez son aleatorios. Son los equipos antiguos, los servidores que no se pueden reiniciar, los entornos de ejecución sin soporte técnico… precisamente los sistemas que se convierten en objetivos atractivos una vez que quedan expuestos y se sabe que son vulnerables.
Riesgos de no aplicar los parches (o de hacerlo con demasiado retraso)
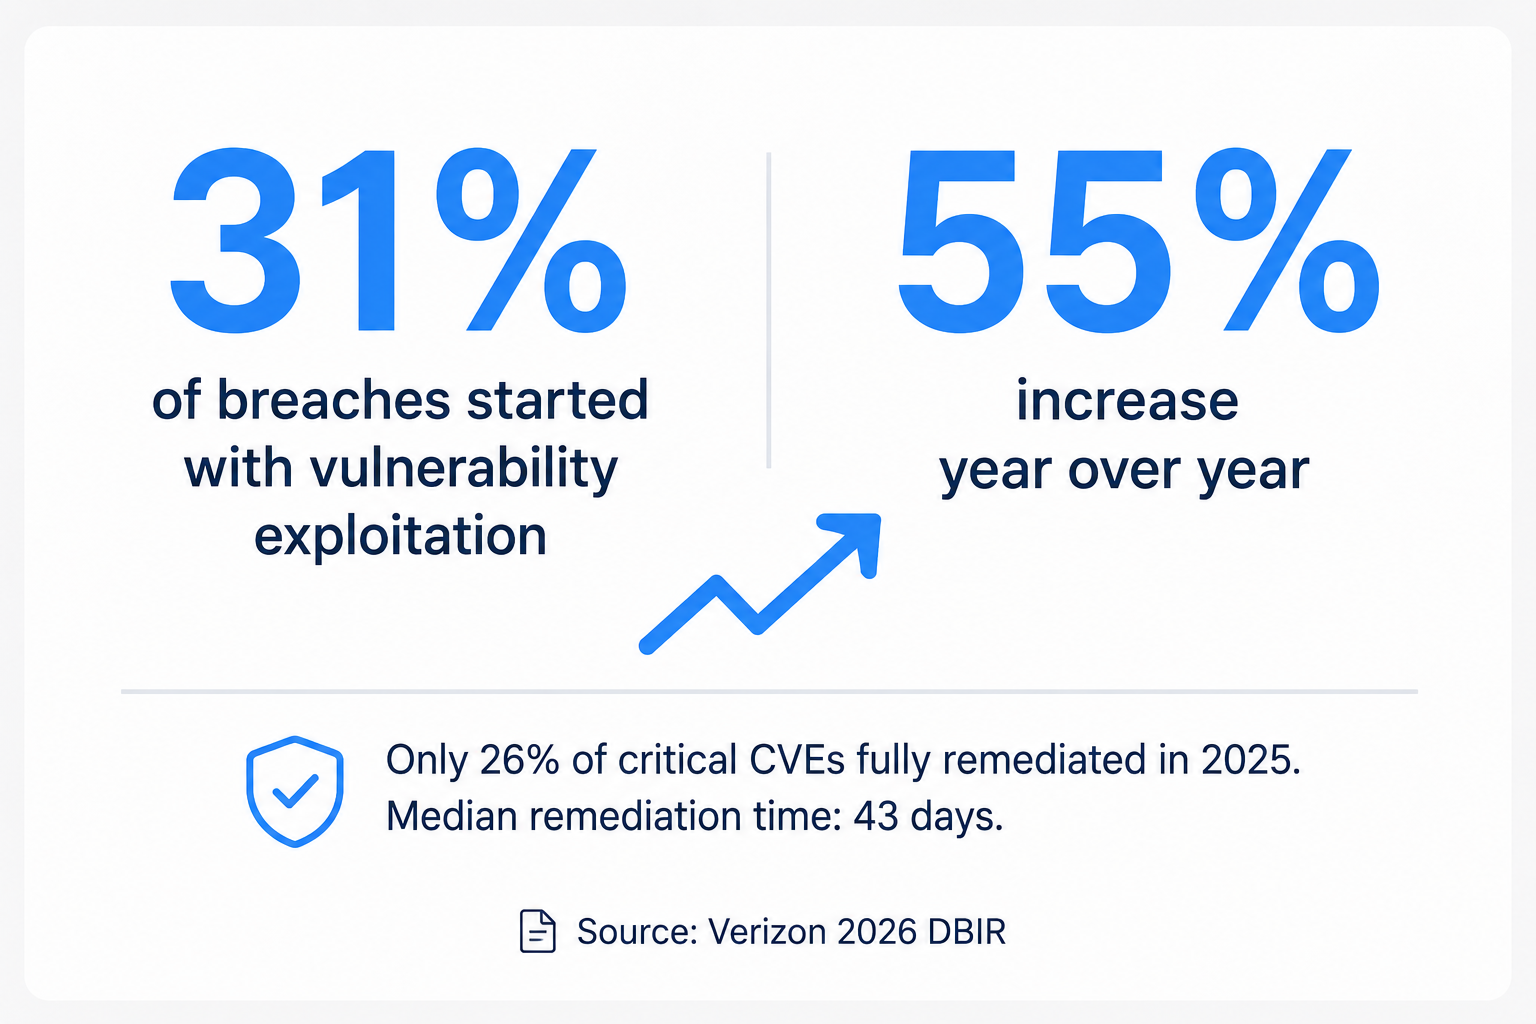
El retraso o la falta de aplicación de parches no es un simple problema de mantenimiento informático. Deja abierta la que se ha convertido en la vía de acceso más habitual a una organización. El informe DBIR de Verizon de 2026 reveló que la explotación de vulnerabilidades es ahora el vector de acceso inicial más habitual para las brechas de seguridad, representando el 31 % de los casos —frente al 20 % del año anterior, lo que supone un aumento interanual del 55 %— y es la primera vez en los 19 años de historia del informe que la explotación ocupa el primer puesto, por delante del uso indebido de credenciales y del phishing.
El mismo informe reveló que solo el 26 % de las vulnerabilidades incluidas en la lista KEV de la CISA se corrigieron por completo en 2025, lo que supone un descenso respecto al 38 % del año anterior, mientras que el tiempo medio hasta su resolución total aumentó de 32 a 43 días. La corrección de vulnerabilidades está perdiendo terreno frente a su explotación.
Estos riesgos no se dan de forma aislada. Una vulnerabilidad CVE sin parchear da lugar a una filtración de datos; la filtración conlleva un riesgo de incumplimiento normativo, y las consecuencias de dicho incumplimiento suelen acabar costando más que el tiempo de inactividad que el equipo intentaba evitar en un principio.
Aprovechamiento de vulnerabilidades conocidas
El riesgo más directo es también el más sencillo: una vulnerabilidad CVE es pública, existe un parche y aún no lo has aplicado. Los atacantes no necesitan un «zero-day» cuando hay una vulnerabilidad conocida sin proteger. En una encuesta realizada en 2019 por el Ponemon Institute para ServiceNow, el 60 % de las víctimas de filtraciones afirmó que su incidente se debía a una vulnerabilidad para la que existía un parche, pero que no se había implementado. Esa encuesta es antigua, pero las cifras de corrección del DBIR mencionadas anteriormente sugieren que el comportamiento subyacente no ha cambiado mucho desde entonces.
En el caso de las vulnerabilidades de gran repercusión y que pueden convertirse fácilmente en armas, el margen de tiempo entre su divulgación y su explotación activa prácticamente se ha reducido a cero: el código de explotación puede aparecer a las pocas horas de publicarse el aviso. Para cuando llega la ventana de mantenimiento mensual, es posible que la vulnerabilidad lleve semanas siendo utilizada con fines maliciosos. El Catálogo de vulnerabilidades explotadas de la CISA existe precisamente porque los atacantes se centran en un conjunto predecible de fallos sin parchear y que están siendo explotados activamente.
Esto resulta más complicado en el núcleo y las bibliotecas principales, donde la corrección tradicional requiere un reinicio del sistema o de los servicios afectados, y esa es precisamente la razón por la que los equipos posponen la aplicación de esos parches. KernelCare de TuxCare aplica correcciones CVE del núcleo a los núcleos de Linux compatibles sin necesidad de apagar el servidor, lo que elimina el retraso provocado por el reinicio que mantiene estos parches a la espera en la cola.
Incumplimientos normativos y sanciones económicas
Los marcos de seguridad y cumplimiento establecen diferentes obligaciones en materia de gestión de vulnerabilidades. La norma PCI DSS es el más prescriptivo: el requisito 6.3.3 exige que los parches de seguridad críticos y de alta gravedad se instalen en el plazo de un mes desde su publicación, mientras que los demás parches aplicables deben instalarse en el plazo que la organización defina y pueda justificar. HIPAA y SOC 2 no establecen un plazo universal para la aplicación de parches; exigen a las organizaciones que demuestren que cuentan con controles razonables y basados en el riesgo y que, a continuación, sigan efectivamente el proceso que han documentado. En la práctica, lo que da lugar a un hallazgo de auditoría es que un CVE crítico permanezca sin resolver más allá del plazo que la propia organización haya establecido.
El coste no se limita únicamente a la multa. Una auditoría fallida puede suponer la pérdida de contratos, la suspensión del procesamiento de pagos y el tiempo de trabajo de los ingenieros dedicado a subsanar los problemas bajo la presión de los plazos. El informe de IBM de 2026 sobre el coste de una filtración de datos sitúa el coste medio global de una filtración en una cifra récord de 4,99 millones de dólares, lo que supone un aumento del 12 % respecto al año anterior, y esos costes van mucho más allá de la limpieza técnica, abarcando la detección y la escalación, la notificación, la respuesta legal y normativa, y la pérdida de negocio.
Atención: Algunos escáneres basados en paquetes indican que un CVE se ha «solucionado» en el momento en que se instala el paquete actualizado, antes de que se reinicie el servicio afectado. En los flujos de trabajo tradicionales de aplicación de parches, un proceso en ejecución puede seguir ejecutando el código vulnerable hasta que se reinicie, se vuelva a cargar o se aplique un parche sin necesidad de reiniciar el sistema. El panel de control muestra un estado verde, pero la memoria puede indicar lo contrario. Las tecnologías de aplicación de parches en tiempo real compatibles resuelven este problema aplicando correcciones al núcleo en ejecución o al código de las bibliotecas vulnerables en los procesos activos.
Daños operativos y de reputación
Una brecha de seguridad en un sistema sin parches rara vez se limita a un solo servidor. El ransomware se propaga lateralmente, la exfiltración de datos se prolonga durante días antes de ser detectada y la recuperación absorbe al mismo equipo que ya estaba demasiado ocupado para aplicar los parches.
Luego está ese aspecto que ninguna hoja de cálculo puede reflejar: la confianza. Los clientes, los socios y las autoridades reguladoras leen todos la misma información. «Conocíamos la vulnerabilidad, pero aún no la habíamos corregido» es una de las frases más perjudiciales que una empresa puede verse obligada a publicar.
Riesgos inherentes al propio proceso de gestión de parches
La otra cara de la moneda recibe mucha menos atención: la aplicación de parches conlleva un riesgo que los enfoques tradicionales no gestionan adecuadamente. Las organizaciones se obsesionan con las métricas de cobertura de parches y pasan por alto los fallos a nivel de procesos que se esconden tras ellas.
Esta es una visión más matizada del riesgo que conlleva la gestión de parches. No se trata de «¿hemos aplicado los parches?», sino de «¿cuánto nos ha costado la aplicación de parches y qué ha dejado de funcionar sin que nos diéramos cuenta?». Los riesgos que se enumeran a continuación son la razón por la que los equipos con experiencia se muestran reticentes, y esa reticencia nos lleva de nuevo a los riesgos de los sistemas sin parches mencionados anteriormente.
Parches defectuosos o sin probar que afectan al entorno de producción
Un parche es un programa, y los programas pueden provocar regresiones. Una actualización del proveedor puede introducir un nuevo error, modificar un valor predeterminado o entrar en conflicto con una dependencia de la que no sabías que dependías. El daño causado por un parche defectuoso puede ser tan grave como la vulnerabilidad que se pretendía corregir.
Por eso los equipos realizan pruebas en el entorno de staging, salvo que este rara vez refleja exactamente el entorno de producción, y es precisamente en esa diferencia donde surgen las sorpresas. Un parche que funciona correctamente en un equipo de pruebas nuevo puede fallar en un servidor con tres años de desviaciones de configuración acumuladas.
Desde la primera línea: Imaginemos una actualización rutinaria de la biblioteca implementada directamente en el entorno de producción un viernes porque «parecía menor». Cambia un valor predeterminado de TLS, impide la validación del certificado frente a la API de un socio y deja fuera de servicio el proceso de pago durante seis horas. El CVE que corregía tenía una puntuación base CVSS de 5,3. La interrupción del servicio causó un daño inmediato y cuantificable; la vulnerabilidad no explotada, ninguno.
Tiempos de inactividad, reinicios y ventanas de mantenimiento
Muchas actualizaciones del núcleo, de las bibliotecas principales y de los servicios del sistema suelen requerir un reinicio del sistema o de los servicios afectados para que el nuevo código entre en vigor. En el caso de una carga de trabajo que funciona las 24 horas del día, los 7 días de la semana, ese reinicio supone un riesgo. Cada reinicio conlleva la posibilidad de que un servicio no vuelva a funcionar, de que falle un montaje o de que una configuración se cargue incorrectamente.
El problema de la planificación agrava aún más la situación. Los equipos internacionales no comparten horarios fuera del horario laboral, y las ventanas de mantenimiento no dejan de reducirse. Así pues, los parches se agrupan, los lotes se retrasan y ese retraso vuelve a poner de manifiesto el riesgo que supone un sistema sin parches. La aplicación de parches a las bibliotecas del espacio de usuario se topa con el mismo obstáculo: la actualización de glibc o OpenSSL suele requerir el reinicio de los servicios afectados que están enlazados a ellas.
Esta es la diferencia para lo que está diseñado . Aplicar correcciones a un kernel en ejecución o a una biblioteca compartida sin necesidad de reiniciar elimina de un solo golpe el riesgo de tiempo de inactividad y el retraso que este provoca. LibCare de TuxCare de TuxCare amplía ese modelo a las bibliotecas compartidas compatibles, incluidas OpenSSL y glibc.
Fatiga por alertas y falta de priorización
Los escáneres de vulnerabilidades son implacables. Un entorno de tamaño medio puede detectar miles de hallazgos al mes, y solo una pequeña parte de ellos llega a ser explotada en algún lugar. Cuando todo se marca como crítico, nada lo es.
Los equipos de seguridad dejan de prestar atención. O bien se dedican a investigar hallazgos de bajo riesgo mientras hay un CVE realmente explotable pendiente, o bien pierden de vista la única alerta que importaba entre todo ese ruido. La solución consiste en establecer prioridades en función de la explotabilidad real, en lugar de basarse únicamente en las puntuaciones CVSS, y ahí es donde entran en juego los datos de predicción de exploits.
¿Qué ocurre cuando no se abordan los riesgos?
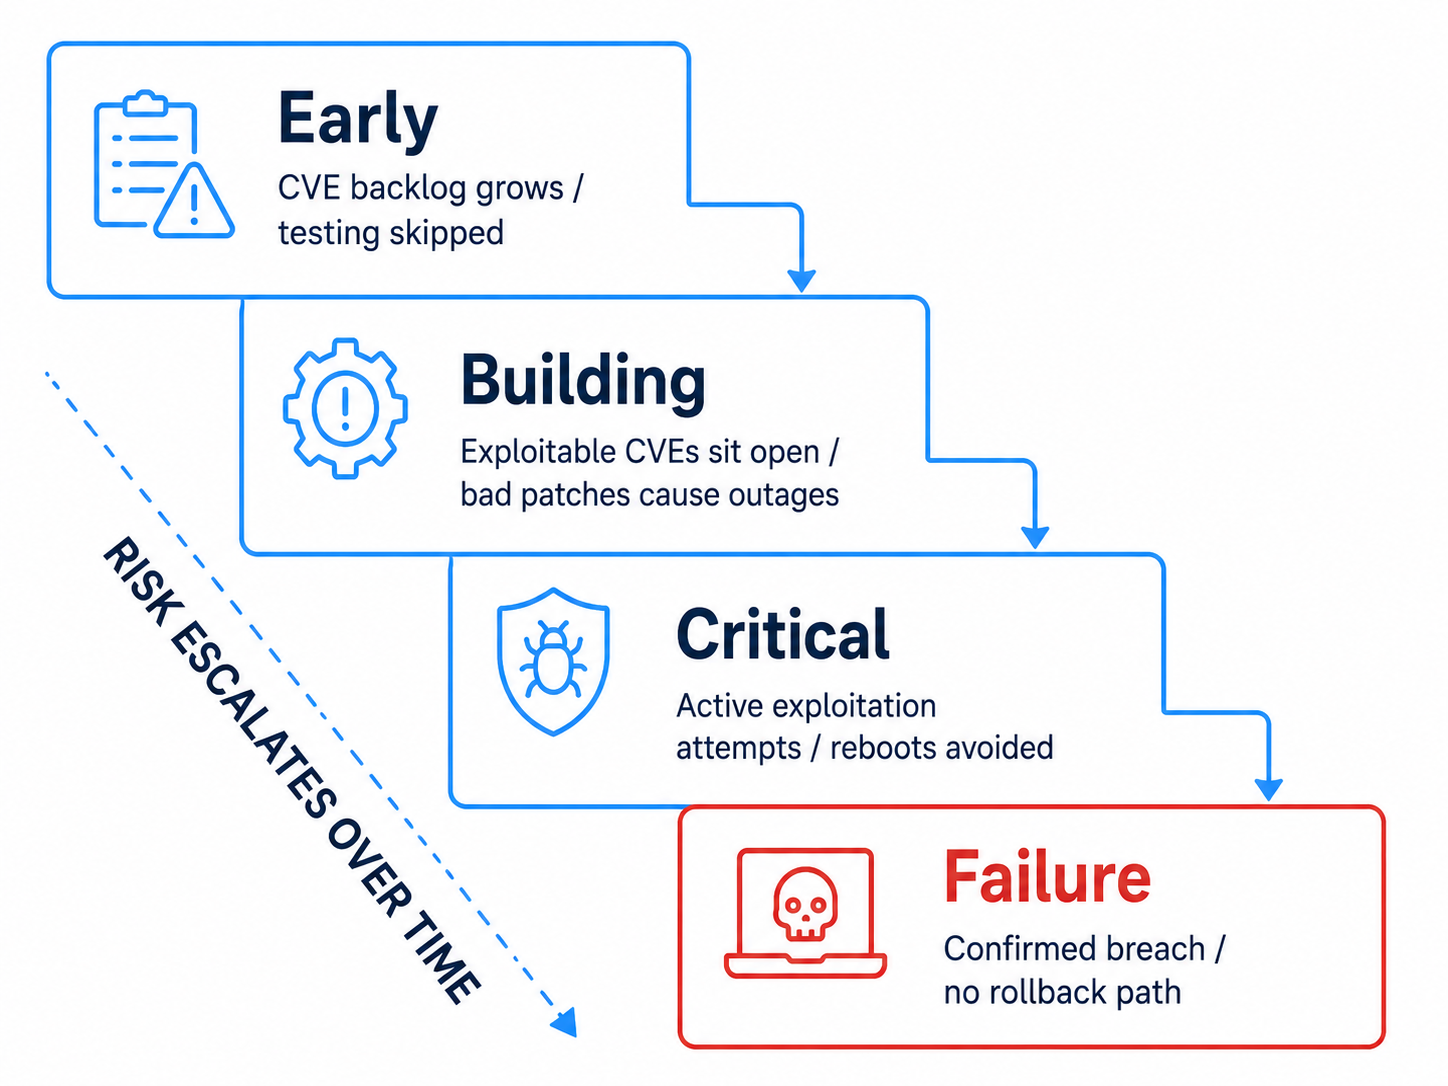
Si se ignoran ambos aspectos del riesgo relacionado con la gestión de parches durante el tiempo suficiente, los modos de fallo se acumulan. Los riesgos derivados de los sistemas sin parches y los riesgos relacionados con los procesos no son problemas independientes, sino que se alimentan mutuamente hasta provocar una crisis que se va gestando poco a poco.
Así es como se recrudecen las tensiones entre ambas partes cuando nada cambia:
| Escenario | Lado sin parche | Lado del proceso |
| Temprano | Aumenta el número de CVE pendientes | Los equipos se saltan las pruebas para ahorrar tiempo |
| Edificio | Las vulnerabilidades CVE explotables permanecen sin solucionar durante semanas | Los tramos en mal estado provocan cortes ocasionales del servicio |
| Crítica | Explotación activa, intentos de intrusión | Se evitan los reinicios, las correcciones dejan de aplicarse |
| Fracaso | Infracción confirmada, riesgo de incumplimiento normativo | Inestabilidad en la producción, sin posibilidad de revertir los cambios |
El resultado final es un equipo que se siente inseguro y tiene miedo de aplicar parches: aplica menos parches porque estos siguen causando fallos, y los fallos se producen con mayor frecuencia porque los sistemas que acumulan ese trabajo pendiente se alejan cada vez más de un estado en el que se sabe que funcionan correctamente.
Cómo reducir los riesgos relacionados con la gestión de parches
Una gestión eficaz de los parches implica abordar ambos aspectos a la vez: el déficit de parches y los fallos a nivel de procesos. Si se soluciona uno y se ignora el otro, simplemente se ha trasladado el riesgo a otra parte.
Debe funcionar como un sistema, no como una lista de comprobación. Los pasos que se indican a continuación se complementan entre sí. La disciplina en las pruebas favorece el establecimiento de prioridades, el establecimiento de prioridades favorece la implementación, y eliminar la necesidad de reiniciar hace que todo el ciclo se ejecute más rápido.
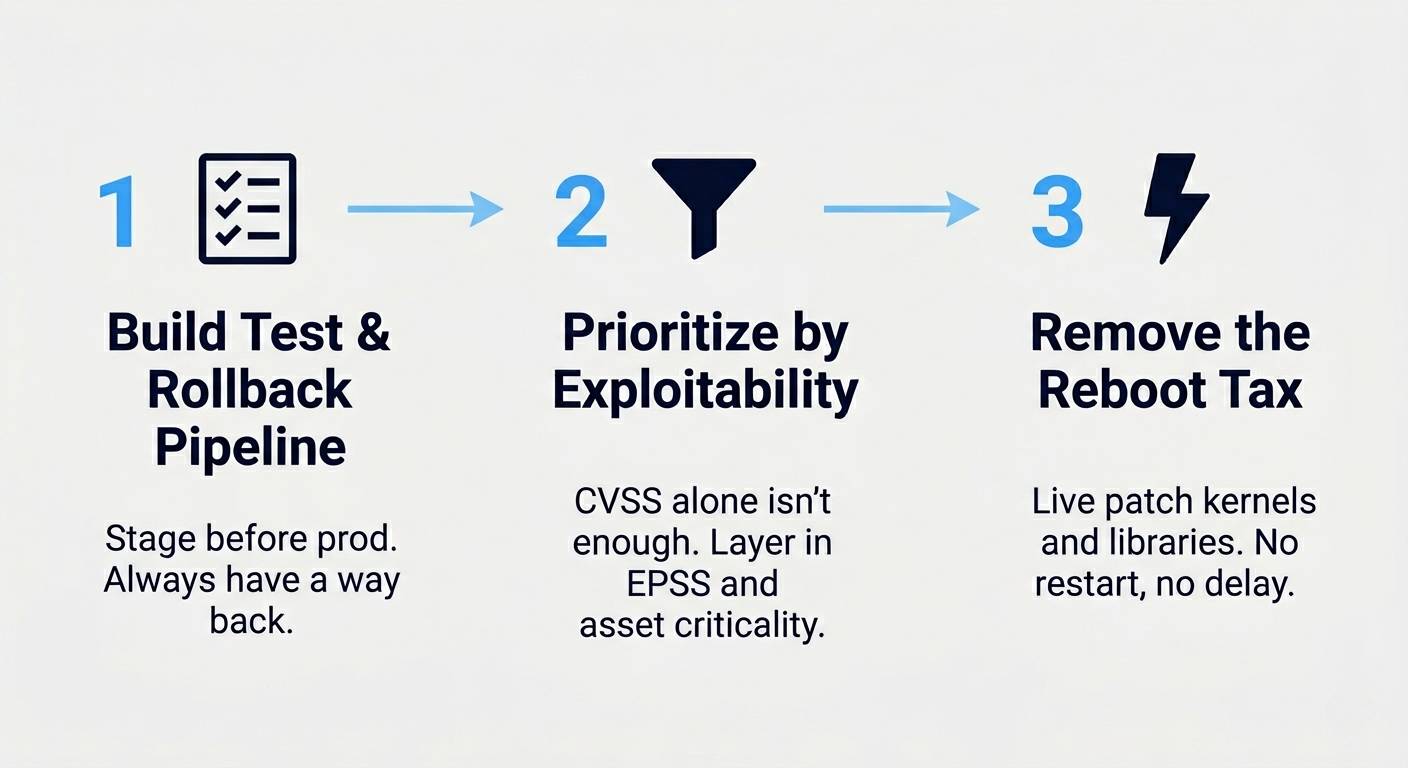
Paso 1: Crear un proceso de pruebas y reversión real
Antes de que un parche llegue al entorno de producción, debe pasar por un entorno representativo y contar con una vía de retorno probada y fiable. Dos aspectos que reducen el riesgo de forma cuantificable:
- Un entorno de pruebas que refleja el de producción: mismas versiones de sistema operativo, misma configuración principal, mismas dependencias clave. Los sistemas de pruebas basados en instantáneas resultan útiles en este sentido, ya que permiten que las pruebas repetidas sean reproducibles.
- Una reversión automatizada: fijación de paquetes, instantáneas del sistema de archivos o control de versiones de imágenes de contenedores, de modo que la reversión se realice con un solo comando, en lugar de ser un proceso forense.
Si un parche supera la fase de pruebas y puedes revertirlo sin problemas, impleméntalo con confianza. Si no puedes revertirlo sin problemas, eso no es automáticamente motivo para esperar: en el caso de un CVE que se esté explotando activamente, esperar suele ser la opción más arriesgada. Añade controles compensatorios, impleméntalo primero en un grupo canario y documenta la decisión antes de continuar. Un parche que no se puede revertir es una apuesta por el control de calidad del proveedor, y debe ser una decisión deliberada.
Paso 2: Priorizar según la explotabilidad, no según el volumen
Deja de tratar todos los CVSS 9,8 como si fueran iguales. Una vulnerabilidad de gravedad alta sin exploit público y sin exposición a la red tiene menor urgencia que una de gravedad media que esté siendo objeto de un ataque activo. Utiliza señales de la capa tres para filtrar el ruido:
- Estado de la vulnerabilidad: ¿figura en el catálogo KEV de la CISA o tiene una puntuación EPSS alta o en rápido aumento?
- Exposición: ¿El servicio afectado está expuesto a Internet o es de uso exclusivamente interno?
- Importancia crítica del activo: ¿Contiene el equipo datos regulados o ejecuta procesos críticos para los ingresos?
Da prioridad a las vulnerabilidades que presenten la combinación más grave de los tres factores. Seguirás posponiendo la aplicación de algunos parches, pero la diferencia es que eres tú quien elige cuáles y puedes justificar esa elección.
Paso 3: Eliminar la necesidad de reiniciar el sistema mediante la aplicación de parches sin reinicio
En el caso de los sistemas en los que el tiempo de actividad es fundamental, el coste que supone el tiempo de inactividad derivado de los reinicios y las reiniciaciones de servicios es una de las principales causas del retraso en la aplicación de parches. Si se elimina esa limitación, una parte significativa de la lista de tareas pendientes se resuelve por sí sola. La aplicación de parches sin reinicio aplica las correcciones compatibles del núcleo y las bibliotecas a los sistemas en funcionamiento sin necesidad de reiniciarlos, por lo que un parche sin reinicio disponible puede implementarse en cuestión de horas, en lugar de tener que esperar a la siguiente ventana de mantenimiento.
Cómo puede ayudar la IA en la gestión de parches
La inteligencia artificial resulta útil en la gestión de parches por una razón: este ámbito se ve desbordado por los datos, y estos sistemas se caracterizan precisamente por su capacidad para correlacionar y clasificar grandes volúmenes de datos con rapidez. No sustituye al criterio humano, sino que reduce el número de decisiones que debe tomar una persona.
IA e identificación de riesgos
Las herramientas asistidas por IA correlacionan las fuentes de CVE, los inventarios de activos y los datos de configuración más rápido que cualquier revisión manual. En lugar de que una persona tenga que cotejar un nuevo aviso con una lista de activos, el sistema señala cuáles de tus hosts específicos se ven afectados. Si se dispone de datos de dependencias y de tiempo de ejecución lo suficientemente completos, también puede ayudar a detectar exposiciones indirectas: una biblioteca vulnerable oculta a varios niveles de profundidad en un árbol de dependencias, o un servicio que, aunque técnicamente haya sido parcheado, sigue ejecutando el código antiguo en memoria.
Piensa en ello como una capa automatizada de alerta temprana que correlaciona simultáneamente los lanzamientos de parches, las bases de datos de vulnerabilidades y las fuentes de información sobre amenazas; no porque un ser humano no pudiera hacerlo, sino porque ningún ser humano tiene la capacidad necesaria para hacerlo a ese volumen sin que se le escape algo.
Priorización de riesgos basada en la inteligencia artificial
Aquí es donde la IA demuestra su utilidad. Los modelos entrenados con datos de vulnerabilidades pueden estimar qué CVE tienen más probabilidades de ser objeto de ataques, clasificando los hallazgos según el riesgo probable en el mundo real, en lugar de según su gravedad pura y simple. Esto aborda directamente el problema de la fatiga por alertas.
¿Sabías que...? El EPSS (Exploit Prediction Scoring System), gestionado por FIRST, calcula la probabilidad de que se observe una actividad de explotación relacionada con un CVE publicado en los próximos 30 días. Una investigación realizada por el Instituto Cyentia y FIRST reveló que solo alrededor del 6 % de los CVE publicados han sido objeto de explotación en la red, mientras que cada año miles de ellos reciben puntuaciones CVSS básicas en el rango «crítico». La gravedad por sí sola suele llevar a los equipos a centrarse primero en las correcciones equivocadas.
Las plataformas más avanzadas pueden combinar la predicción de vulnerabilidades con el contexto organizativo que una clasificación genérica de gravedad pasa por alto —la configuración del sistema, la exposición, si ya existen controles compensatorios que reduzcan el riesgo y el impacto empresarial del sistema afectado—, siempre que se disponga de los datos y estos estén correctamente integrados. El resultado es una lista priorizada que refleja tu entorno, en lugar de un aviso genérico de un proveedor.
Informes
La IA también reduce la carga administrativa relacionada con la elaboración de informes. Los resúmenes de cumplimiento generados automáticamente, los informes resumidos sobre el estado de los parches y las pruebas listas para auditorías reducen el trabajo manual que suele recaer en la persona que tiene menos trabajo. El resultado final sigue necesitando una revisión humana, pero elaborar el primer borrador requiere mucho menos esfuerzo.
Un registro detallado de las medidas de gestión de parches y sus resultados proporciona a los equipos el contexto necesario para abordar los problemas recurrentes, y es lo que necesita la dirección para justificar el presupuesto de seguridad. La inteligencia artificial puede generar ese registro de forma más sistemática que una persona que lo redacte a las 23:00 horas, aunque el resultado aún debe validarse para detectar posibles omisiones y errores propios.
Cómo utilizar la IA en la gestión de parches
Empieza poco a poco. La IA en la gestión de parches funciona mejor como filtro y asistente, no como un robot autónomo de aplicación de parches que se deja suelto en el entorno de producción. Los equipos que sacan partido de ella la aplican a aquellas partes del flujo de trabajo que tienen un gran volumen y se rigen por reglas claras y repetibles.
Una estrategia de adopción sensata consiste en utilizarlo primero para la clasificación inicial. Deja que clasifique y agrupe los resultados y, a continuación, haz que una persona apruebe la lista de prioridades. Además, es necesario automatizar las clases de parches de menor riesgo y bien probadas, con una reversión contrastada, así como las actualizaciones rutinarias del espacio de usuario —no los núcleos de producción desde el primer día—. Mantén a una persona al tanto de cualquier acción irreversible: núcleos de producción, motores de bases de datos, cualquier cosa que no permita una reversión limpia.
Antes de elegir una herramienta, también es necesario contar con una base sólida. Un sistema de IA necesita información exhaustiva sobre tu entorno para ofrecer recomendaciones precisas: un inventario completo de activos, las configuraciones actuales del sistema, las dependencias documentadas y las franjas horarias de mantenimiento definidas. Si le proporcionas una visión parcial, obtendrás recomendaciones que parecen fiables, pero que se basan en una visión parcial.
Una visión realista: La expresión «basado en IA» que aparece en la página de marketing de una herramienta de parches suele referirse únicamente a un modelo de priorización de CVE y nada más. Eso es útil, pero no es autonomía. Pregunta al proveedor exactamente qué decisiones toma el modelo y cuáles remite a un ser humano: esa línea divisoria es donde el marketing tiende a ir por delante del producto.
Las mejores herramientas para gestionar los riesgos relacionados con la gestión de parches
Las herramientas se dividen en dos categorías: soluciones puntuales que realizan una sola tarea (escaneo, implementación o aplicación de parches en tiempo real) y plataformas que integran el flujo de trabajo de principio a fin. La profundidad de la integración es más importante que el número de funciones. Un escáner que no se conecte con tu proceso de implementación solo genera más alertas que acabarás ignorando.
La comparación que figura a continuación se basa en cuatro criterios: compatibilidad con el entorno principal, si la herramienta permite aplicar correcciones sin necesidad de reiniciar el sistema o el servicio, cobertura de sistemas operativos y modelo de licencia. Las prestaciones y los precios pueden variar, por lo que te recomendamos que consultes la documentación actual de cada proveedor antes de tomar una decisión.
| Herramienta | Ideal para | parcheo sin reinicio | Modelo |
| TuxCare | Flotas de Linux, sistemas al final de su ciclo de vida, disponibilidad 24 horas al día, 7 días a la semana | Sí (núcleo + bibliotecas) | Suscripción por servidor |
| Automox | Flotas con sistemas operativos mixtos, equipos que dan prioridad a la nube | No | SaaS por terminal |
| ManageEngine Patch Manager Plus | Amplia cobertura de aplicaciones de terceros, tanto en las propias instalaciones como en la nube | No | Licencia por niveles |
TuxCare
Lo que distingue a TuxCare en esta comparación es la aplicación de parches sin tiempo de inactividad. KernelCare aplicaba parches en tiempo real a los núcleos de Linux compatibles en servidores en funcionamiento, LibCare aplica parches en tiempo real a bibliotecas compartidas como glibc y OpenSSL sin necesidad de reiniciar los servicios vinculados a ellas, y Soporte de ciclo de vida ilimitado garantiza que las distribuciones y los entornos de ejecución fuera de ciclo de vida sigan recibiendo correcciones CVE incluso después de que el proveedor original deje de ofrecer actualizaciones de seguridad para esas versiones. TuxCare ofrece cobertura para una amplia gama de distribuciones de Linux empresarial, entre las que se incluyen RHEL, CentOS, AlmaLinux, Rocky Linux, CloudLinux, Debian, Ubuntu, Amazon Linux y Oracle Linux: más de 70 versiones de distribuciones en total.
Esta combinación aborda ambos aspectos del riesgo asociado a la gestión de parches. En el caso de las correcciones compatibles, se elimina el requisito de reinicio del sistema o del servicio que provoca retrasos, y se sigue cubriendo la brecha de los sistemas no compatibles —esos equipos que no se pueden reiniciar ni actualizar y que el proceso tradicional de aplicación de parches deja de lado—. Es ideal para equipos que utilizan Linux a gran escala, organizaciones con cargas de trabajo regidas por acuerdos de nivel de servicio (SLA) de tiempo de actividad y entornos que deben mantener los sistemas en funcionamiento más allá del plazo de soporte del proveedor.
Automox
Automox es una plataforma de terminales nativa de la nube que gestiona la aplicación de parches en Windows, macOS y Linux desde una única consola, además de contar con un catálogo de varios cientos de aplicaciones de terceros. Su ventaja es su amplio alcance: funciona con agentes, es multiplataforma y está diseñada para entornos distribuidos sin infraestructura local.
Es una opción ideal para equipos que dan prioridad a la nube y para organizaciones más pequeñas que desean disponer de un único panel de control para dispositivos finales mixtos. En el momento de la publicación, Automox no menciona en la documentación de su producto la aplicación de parches sin reinicio del kernel de Linux, por lo que las actualizaciones básicas de Linux siguen implicando un tiempo de inactividad debido al reinicio; sin embargo, goza de buena reputación para el mantenimiento general de los dispositivos finales en un entorno mixto.
ManageEngine Patch Manager Plus
ManageEngine Patch Manager Plus es compatible con terminales de Windows, macOS y Linux, además de con más de 1.100 aplicaciones de terceros, y está disponible como instalación local o como servicio en la nube. Su principal punto fuerte es la amplitud de su catálogo de aplicaciones, razón por la cual suele utilizarse con mayor frecuencia en entornos con predominio de Windows que cuentan con una amplia variedad de software de terceros.
Sigue un enfoque tradicional: escanear, programar, probar, implementar y reiniciar. Los riesgos a nivel de proceso mencionados anteriormente siguen siendo plenamente aplicables. Al igual que con cualquier plataforma de implementación automatizada, unos controles de pruebas y aprobación deficientes pueden permitir que una actualización problemática llegue al entorno de producción según lo previsto, por lo que conviene combinarlo con una disciplina sólida en materia de pruebas y reversión.
Buenas prácticas de implantación
Las herramientas reducen el riesgo. La disciplina en la implementación es lo que garantiza su eficacia. Las prácticas que se indican a continuación distinguen un programa de parches que reduce el riesgo de uno que simplemente genera actividad.
- Realiza los lanzamientos por fases. Impleméntalo primero en un grupo «canario», comprueba si hay regresiones y, a continuación, amplía la implementación. Nunca lo implantes en toda la flota de una sola vez.
- Aplica los parches según el nivel de vulnerabilidad, no según el calendario. Los CVE incluidos en la lista KEV tienen prioridad; las actualizaciones rutinarias se realizan en la ventana habitual.
- Comprueba que la corrección se haya aplicado correctamente. En el caso del código que ya haya sido cargado por un proceso en ejecución o por el núcleo, no basta con instalar el paquete: es necesario reiniciar el componente afectado, reiniciar el sistema o aplicar el parche sin necesidad de reiniciar.
- Mantén un registro de auditoría. Anota qué parches se han aplicado, cuándo y quién los ha aplicado, tanto para cumplir con la normativa como para la revisión posterior al incidente que esperas no tener que realizar nunca.
- Separa lo urgente de lo rutinario. Aplica parches en tiempo real a las vulnerabilidades CVE que no pueden esperar, para que el resto del programa pueda mantener un ritmo razonable.
Consejo profesional: En los sistemas de la familia RHEL, needs-restarting -r (incluido en dnf-utils) indica si las actualizaciones instaladas sugieren que es necesario reiniciar el sistema. Tómalo como una señal más que como una prueba de que el problema se ha solucionado: refleja los paquetes actualizados y los procesos en ejecución, no el estado de los CVE. Cuando un CVE del kernel está cubierto por un parche que se ha cargado correctamente sin necesidad de reiniciar, no se requiere reinicio para esa corrección específica, aunque el comando puede seguir señalando otras actualizaciones que sí lo requieran.
Si tu flota es grande y el tiempo de actividad es importante, prioriza la aplicación de parches sin necesidad de reiniciar y implementa el resto por fases. Si utilizas principalmente Windows y los reinicios cumplen sin problemas tus requisitos de seguridad y disponibilidad, es posible que lo único que necesites sea una implementación por fases estándar con una opción de reversión probada.
Protege tus sistemas con la gestión de parches de TuxCare
El riesgo asociado a la gestión de parches no se resuelve aplicando parches con más rigor. Se resuelve eliminando las causas por las que los equipos se demoran —los reinicios, el tiempo de inactividad, el temor a que una actualización defectuosa afecte al entorno de producción— y manteniendo la cobertura en los sistemas que las herramientas tradicionales dejan de lado.
Esa es la diferencia que TuxCare viene a cubrir. La aplicación de parches en tiempo real al núcleo y a las bibliotecas permite aplicar las correcciones disponibles para los sistemas compatibles sin necesidad de reiniciar el sistema. El soporte de ciclo de vida ilimitado mantiene actualizadas las distribuciones y entornos de ejecución fuera de ciclo de vida mucho después de que el proveedor haya dejado de hacerlo. El resultado es un menor número de vulnerabilidades sin resolver y menos interrupciones del servicio provocadas por la aplicación de parches, lo que reduce el riesgo en ambas fases del proceso.
La disyuntiva entre mantener la seguridad y seguir conectado a Internet es precisamente lo que TuxCare se ha propuesto eliminar. Cuéntanos cómo es tu entorno.
Preguntas frecuentes
Aprovechamiento de una vulnerabilidad conocida y sin parchear. Muchas infracciones relacionadas con un fallo conocido se producen después de que ya se haya publicado una solución, lo que convierte el fallo en operativo más que en técnico. Según el informe DBIR de 2026 de Verizon, el aprovechamiento de vulnerabilidades representó el 31 % de las infracciones y se situó como el vector de acceso inicial más común, lo que convierte a las vulnerabilidades conocidas y sin solucionar en una de las vías de ataque más predecibles en los entornos empresariales.
Sí. Un parche defectuoso o que no se haya probado puede provocar fallos en el entorno de producción, modificar un valor predeterminado o introducir un nuevo error. Los parches también pueden requerir reinicios del sistema o de los servicios, lo que conlleva el riesgo de que estos no se restablezcan correctamente; además, las implementaciones precipitadas sin una vía de reversión pueden provocar interrupciones del servicio peores que el CVE que se pretendía corregir.
Tan rápido como lo permita tu proceso de forma segura; lo ideal sería en un plazo de unas horas a unos días en el caso de las CVE que están siendo explotadas activamente. El requisito 6.3.3 de la norma PCI DSS establece un plazo máximo de un mes para los parches críticos y de alta gravedad, y el código de explotación de fallos de gran repercusión suele aparecer a las pocas horas de su divulgación. Los ciclos mensuales suelen ser demasiado lentos para las vulnerabilidades que están siendo explotadas activamente o que están directamente expuestas, independientemente de su puntuación CVSS base.
Dejan de recibir parches de seguridad de los proveedores y se convierten en una fuente de exposición constante. Las distribuciones y los entornos de ejecución que han llegado al final de su vida útil (EOL) siguen funcionando, pero acumulan vulnerabilidades sin parchear, a menos que la organización migre, adapte sus propios parches o obtenga un soporte ampliado. Servicios como el «Endless Lifecycle Support» de TuxCare siguen proporcionando parches para estos sistemas sin obligar a una migración inmediata.
Elimina la fase de inactividad. La aplicación de parches sin reinicio aplica las correcciones compatibles del núcleo y las bibliotecas a los sistemas en funcionamiento sin necesidad de reiniciarlos, por lo que una corrección disponible puede implementarse en cuestión de horas, en lugar de tener que esperar a una ventana de mantenimiento. Esto elimina una de las principales fuentes de retraso y reduce el tiempo que los sistemas permanecen expuestos.