Technischer Support
 Dokumentation
 Anmeldung
 Kontakt


Gehen Sie direkt zu einer KI-Zusammenfassung dieses Blogbeitrags 


Wichtigste Erkenntnisse
- Die Ausnutzung ungepatchter Sicherheitslücken ist mittlerweile der häufigste Auslöser für Sicherheitsvorfälle, doch das Patchen selbst birgt Risiken durch Ausfallzeiten, fehlgeschlagene Updates und Lücken bei der Rollback-Wiederherstellung, die von den meisten Teams unterschätzt werden.
- Viele Sicherheitsvorfälle, bei denen eine bekannte Schwachstelle ausgenutzt wird, ereignen sich, obwohl bereits ein Patch verfügbar war. Das Versagen ist betrieblicher, nicht technischer Natur.
- Allgemeine Schweregradbewertungen (CVSS-Basiswerte, die ohne Berücksichtigung von Bedrohungen oder Umgebungsfaktoren verwendet werden) eignen sich nur schlecht als Leitfaden für die Priorisierung; die Ausnutzbarkeit und die Gefährdung von Systemen sind für die Entscheidung, was zuerst behoben werden soll, von größerer Bedeutung.
- Durch das Patchen ohne Neustart wird eine der größten Ursachen für Verzögerungen bei der Patch-Bereitstellung beseitigt – nämlich der Neustart des Systems oder der Dienste –, sodass unterstützte Korrekturen bereits innerhalb weniger Stunden bereitgestellt werden können, anstatt auf das nächste Wartungsfenster warten zu müssen.
Die meisten Teams wissen, dass sie Patches schneller installieren sollten. Was sie tatsächlich davon abhält, ist nicht Faulheit. Es ist die Angst, dass der Patch um 2 Uhr morgens auf einem Rechner, den niemand mehr ganz versteht, etwas kaputtmacht. Also bleibt das Update in der Warteschlange. Dieses Zögern ist der Kern des Risikos beim Patch-Management, und es ist die Frage, auf die die meisten Teams eine Antwort suchen: Wie schließt man bekannte Sicherheitslücken, ohne dass der Patch selbst zum Vorfall wird?
Risiken beim Patch-Management bestehen in zweierlei Hinsicht. Zum einen besteht die Gefahr, dass Systeme nicht gepatcht werden, zum anderen die Gefahr, dass der Patch-Prozess selbst Probleme verursacht: fehlgeschlagene Updates, Ausfallzeiten, Lücken bei der Rollback-Sicherheit. Dieser Artikel beleuchtet beide Arten von Risiken, geht ihren Ursachen auf den Grund, zeigt auf, was passiert, wenn sie ignoriert werden, und erläutert die praktischen Schritte und Tools, mit denen sich die Risiken in beiden Bereichen minimieren lassen.
Die Risiken herkömmlicher Patch-Management-Verfahren verstehen
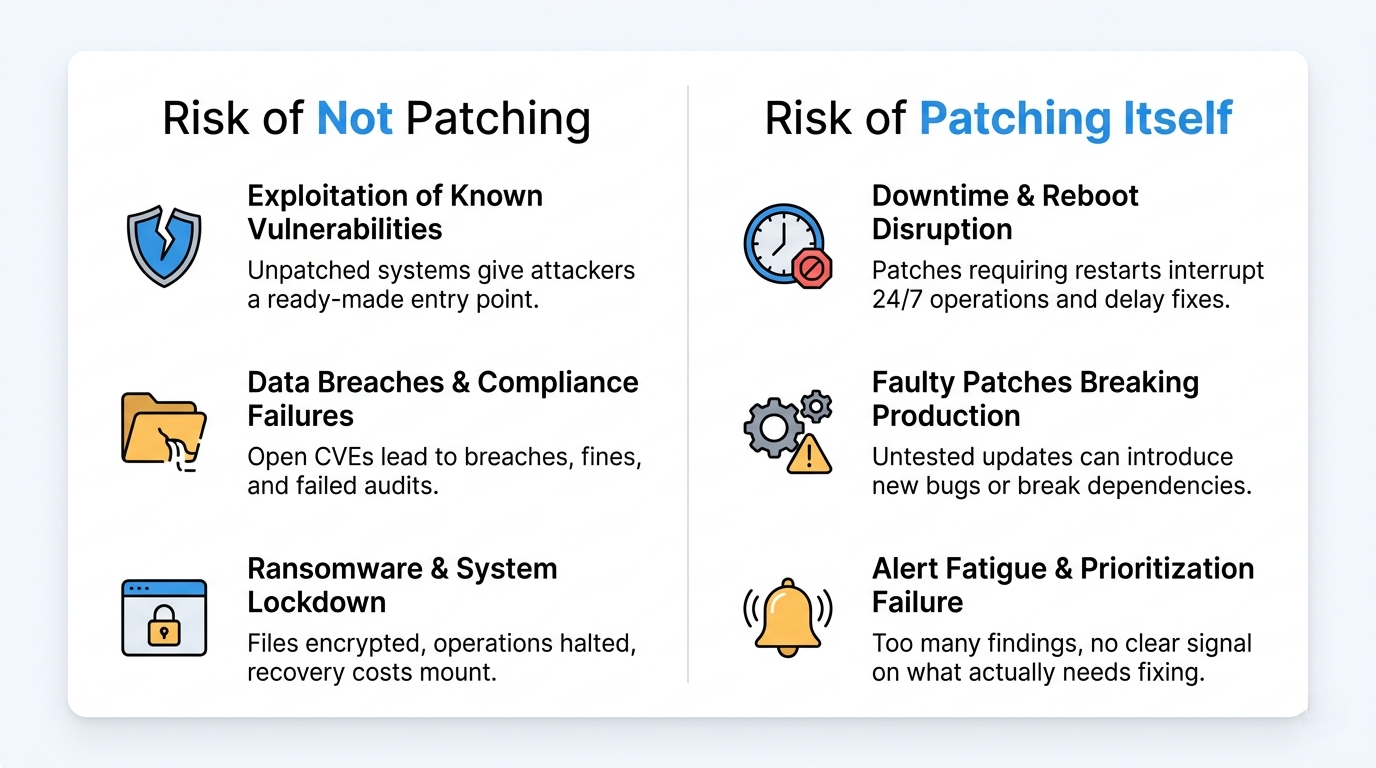
Das herkömmliche Patch-Management folgt einem bekannten Ablauf: Nach fehlenden Updates suchen, ein Zeitfenster festlegen, prüfen, ob genügend Zeit vorhanden ist, die Updates installieren, neu starten, überprüfen. Auf dem Papier funktioniert das. In der Praxis birgt jeder Schritt jedoch Risiken.
Das Modell geht davon aus, dass Sie Systeme während geplanter Wartungsfenster außer Betrieb nehmen können. Die reale Infrastruktur spielt jedoch selten mit. Wartungsfenster werden immer kürzer, 24/7-Workloads lassen sich nicht neu starten, und die Testumgebung entspricht nie ganz der Produktionsumgebung. Das Ergebnis ist ein Rückstau an Patches, die „irgendwann einmal“ installiert werden sollen – genau diese Situation nutzen Angreifer aus.
Dem herkömmlichen Ansatz liegen drei strukturelle Schwächen zugrunde:
- Das hängt vom Neustart ab. Bei herkömmlichen Kernel-Updates ist in der Regel ein Neustart erforderlich, bevor der neue Code ausgeführt wird, und bei Updates der Kernbibliotheken müssen die betroffenen Dienste neu gestartet werden. In beiden Fällen kommt es zu Ausfallzeiten, was Verzögerungen zur Folge hat.
- Das erfolgt nach einem festen Zeitplan und nicht aufgrund von Sicherheitsbedrohungen. „Patch Tuesday“ und die monatlichen Zeitfenster berücksichtigen nicht, dass eine CVE an einem Donnerstag aktiv ausgenutzt wurde.
- Dabei wird die Abdeckung als Ziel angesehen. Eine Abdeckungsrate von 98 % macht sich auf dem Dashboard gut, während die verbleibenden 2 % einen unverhältnismäßig großen Teil des Risikos ausmachen.
Realitätscheck: Eine Patch-Compliance-Rate von 98 % ist kein Sicherheitsindikator. Es handelt sich um einen Abdeckungsindikator. Die Systeme, die diese verbleibenden 2 % ausmachen, sind selten zufällig ausgewählt. Es sind die Altgeräte, die Server, die sich nicht neu starten lassen, die nicht mehr unterstützten Laufzeitumgebungen – genau jene Systeme, die zu attraktiven Zielen werden, sobald sie offengelegt sind und als anfällig bekannt sind.
Risiken, wenn Patches nicht (oder zu spät) installiert werden
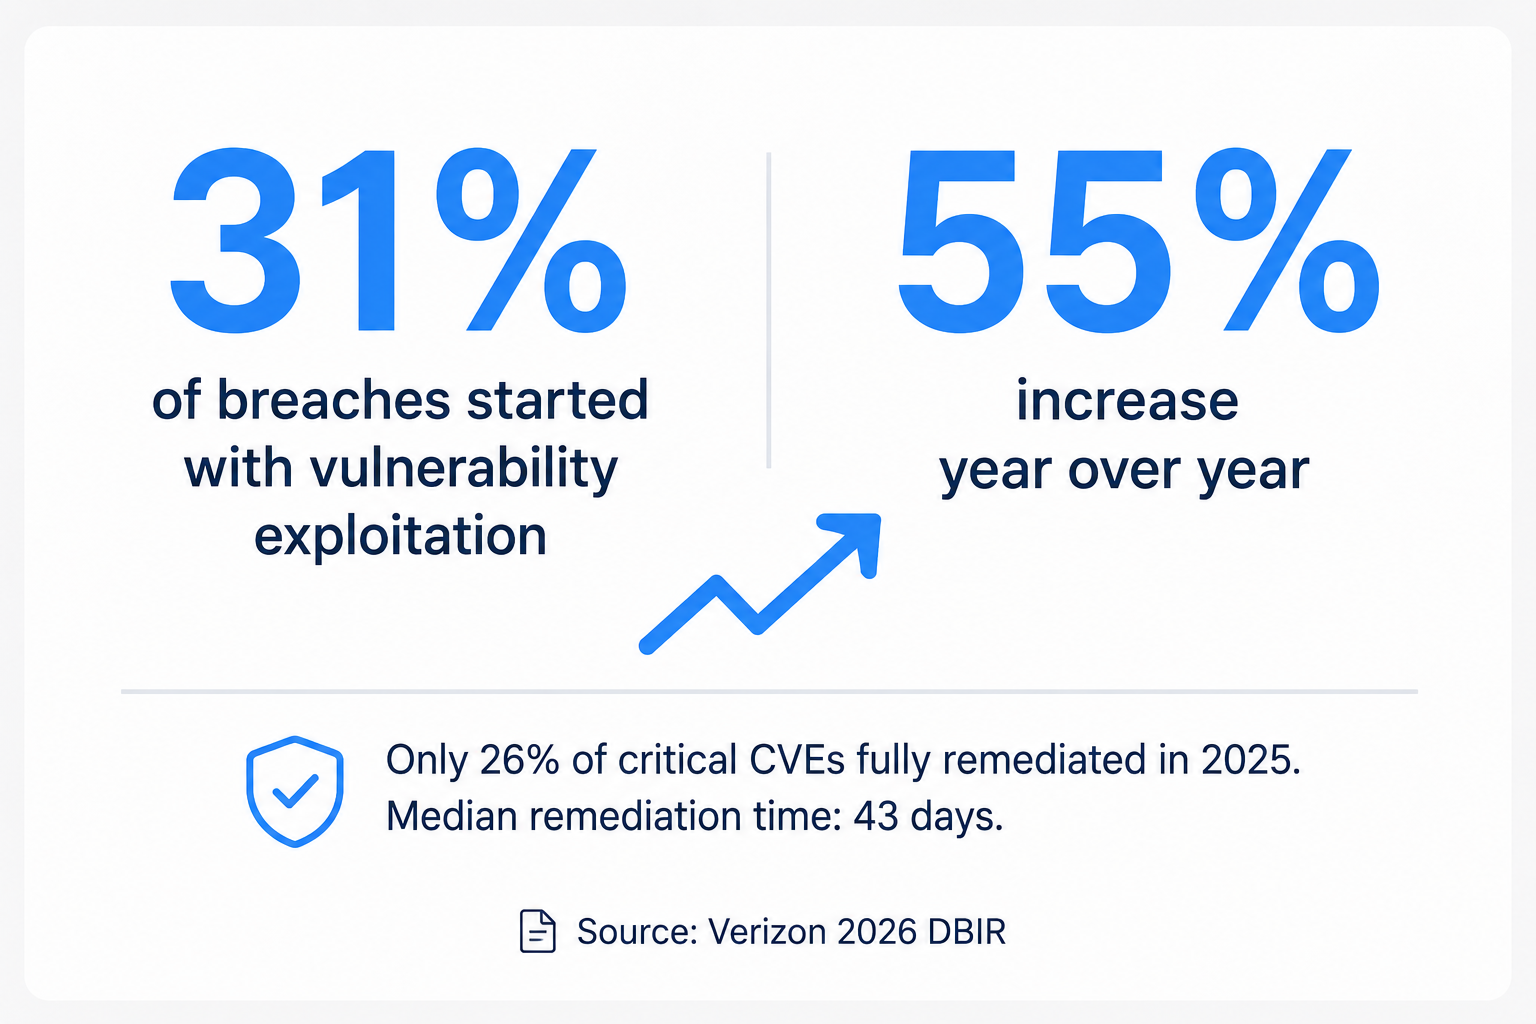
Verspätete oder ausbleibende Patches sind kein Problem der IT-Wartung. Sie lassen den mittlerweile häufigsten Einfallstor in ein Unternehmen offen. Der Verizon DBIR 2026 ergab, dass die Ausnutzung von Schwachstellen mittlerweile der häufigste Erstzugangsweg für Sicherheitsvorfälle ist. Sie machen 31 % der Fälle aus – ein Anstieg von 20 % im Vorjahr, was einem Zuwachs von 55 % im Jahresvergleich entspricht. Damit steht die Ausnutzung von Schwachstellen zum ersten Mal in der 19-jährigen Geschichte des Berichts an erster Stelle, noch vor dem Missbrauch von Zugangsdaten und Phishing.
Demselben Bericht zufolge wurden im Jahr 2025 nur 26 % der in der CISA-KEV-Liste aufgeführten Sicherheitslücken vollständig behoben – ein Rückgang gegenüber den 38 % des Vorjahres –, während die Medianzeit bis zur vollständigen Behebung von 32 auf 43 Tage anstieg. Die Behebung von Sicherheitslücken verliert gegenüber deren Ausnutzung an Boden.
Diese Risiken treten nicht isoliert auf. Eine nicht gepatchte CVE führt zu einer Sicherheitslücke, die wiederum Compliance-Risiken nach sich zieht, und die daraus resultierenden Compliance-Konsequenzen verursachen oft höhere Kosten als die Ausfallzeit, die das Team ursprünglich vermeiden wollte.
Ausnutzung bekannter Sicherheitslücken
Das unmittelbarste Risiko ist auch das einfachste: Eine CVE ist öffentlich bekannt, es gibt einen Patch, und Sie haben ihn noch nicht installiert. Angreifer brauchen keinen Zero-Day, wenn eine bekannte Sicherheitslücke offen vorliegt. In einer vom Ponemon Institute im Jahr 2019 im Auftrag von ServiceNow durchgeführten Umfrage gaben 60 % der Opfer von Datenpannen an, angaben, dass ihr Datenleck auf eine Sicherheitslücke zurückzuführen sei, für die zwar ein Patch verfügbar war, dieser jedoch nicht installiert wurde. Diese Umfrage ist zwar schon etwas älter, doch die oben genannten Zahlen aus dem DBIR zur Behebung von Sicherheitslücken deuten darauf hin, dass sich das zugrunde liegende Verhalten seitdem nicht wesentlich geändert hat.
Bei viel beachteten, leicht ausnutzbaren Sicherheitslücken ist das Zeitfenster zwischen der Bekanntgabe und der aktiven Ausnutzung so gut wie geschlossen: Exploit-Code kann bereits innerhalb weniger Stunden nach der Veröffentlichung der Sicherheitsempfehlung auftauchen. Bis das monatliche Wartungsfenster ansteht, wird die Sicherheitslücke möglicherweise bereits seit Wochen ausgenutzt. Der CISA-Katalog bekannter ausgenutzter Sicherheitslücken existiert genau deshalb, weil sich Angreifer auf eine vorhersehbare Reihe von ungepatchten, aktiv ausgenutzten Schwachstellen konzentrieren.
Am schwierigsten ist dies im Kernel und in den Kernbibliotheken, wo herkömmliche Behebungsmaßnahmen einen Neustart des Systems oder der betroffenen Dienste erfordern – und genau aus diesem Grund schieben die Teams diese Patches auf. KernelCare von TuxCare wendet CVE-Korrekturen für den Kernel auf unterstützte Linux-Kernel an, ohne den Host außer Betrieb zu setzen. Dadurch entfällt die durch den Neustart verursachte Verzögerung, die dazu führt, dass diese Patches in der Warteschlange verbleiben.
Verstöße gegen Vorschriften und Geldstrafen
Sicherheits- und Compliance-Rahmenwerke sehen unterschiedliche Anforderungen an das Schwachstellenmanagement vor. PCI DSS ist am strengsten: Anforderung 6.3.3 schreibt vor, dass kritische und hochgradige Sicherheitspatches innerhalb eines Monats nach ihrer Veröffentlichung installiert werden müssen, während andere relevante Patches innerhalb eines Zeitrahmens installiert werden müssen, den das Unternehmen festlegt und begründen kann. HIPAA und SOC 2 legen keine einheitliche Frist für Patches fest; sie verlangen von den Organisationen, dass sie angemessene, risikobasierte Kontrollmaßnahmen nachweisen und den von ihnen dokumentierten Prozess dann auch tatsächlich befolgen. In der Praxis führt eine kritische CVE, die über den von der Organisation selbst festgelegten Zeitrahmen hinaus unbehoben bleibt, zu einem Beanstandungspunkt im Audit.
Die Kosten beschränken sich nicht nur auf die Geldstrafe. Ein nicht bestandener Audit-Test kann den Verlust von Verträgen, die Aussetzung der Zahlungsabwicklung und den Zeitaufwand von Technikern für die Behebung der Mängel unter Termindruck zur Folge haben. Laut dem „2026 Cost of a Data Breach Report“ von IBM belaufen sich die weltweiten Durchschnittskosten für Datenschutzverletzungen auf einen Rekordwert von 4,99 Millionen US-Dollar, was einem Anstieg von 12 % gegenüber dem Vorjahr entspricht; diese Kosten gehen weit über die technische Behebung hinaus und umfassen auch die Erkennung und Eskalation, die Benachrichtigung, rechtliche und behördliche Maßnahmen sowie entgangene Geschäfte.
Achtung: Einige paketbasierte Scanner melden eine CVE als „behoben“, sobald das aktualisierte Paket installiert ist – noch bevor der betroffene Dienst neu gestartet wird. Bei herkömmlichen Patching-Workflows kann ein laufender Prozess den anfälligen Code so lange weiter ausführen, bis er neu gestartet, neu geladen oder ohne Neustart gepatcht wird. Das Dashboard zeigt „grün“ an, doch der Arbeitsspeicher könnte etwas anderes sagen. Unterstützte Live-Patching-Technologien beheben dieses Problem, indem sie Korrekturen am laufenden Kernel oder am anfälligen Bibliothekscode in aktiven Prozessen vornehmen.
Betriebsstörungen und Reputationsschäden
Ein Sicherheitsverstoß durch ein System ohne Patches bleibt selten auf einen einzigen Server beschränkt. Ransomware breitet sich lateral aus, Datenexfiltrationen laufen tagelang, bevor sie entdeckt werden, und die Wiederherstellung bindet dasselbe Team, das ohnehin schon zu beschäftigt war, um Patches zu installieren.
Dann gibt es noch den Aspekt, den keine Tabellenkalkulation erfassen kann: Vertrauen. Kunden, Partner und Aufsichtsbehörden lesen alle dieselbe Mitteilung. „Wir wussten von der Sicherheitslücke, hatten sie aber noch nicht behoben“ gehört zu den schädlichsten Sätzen, die ein Unternehmen veröffentlichen muss.
Risiken innerhalb des Patch-Management-Prozesses selbst
Die Kehrseite findet weitaus weniger Beachtung: Das Aufspielen von Patches birgt Risiken, mit denen herkömmliche Ansätze nur unzureichend umgehen können. Unternehmen konzentrieren sich fast ausschließlich auf Kennzahlen zur Patch-Abdeckung und übersehen dabei die zugrunde liegenden Mängel auf Prozessebene.
Dies ist die differenziertere Sichtweise auf die Risiken des Patch-Managements. Nicht „Haben wir Patches installiert?“, sondern „Was hat uns das Patchen gekostet, und was hat es unbemerkt kaputtgemacht?“ Die unten aufgeführten Risiken sind der Grund, warum erfahrene Teams zögern – und dieses Zögern führt direkt zurück zu den oben genannten Risiken ungepatchter Systeme.
Fehlerhafte oder ungeprüfte Patches, die den Produktivbetrieb beeinträchtigen
Ein Patch ist Software, und Software kann Regressionen verursachen. Ein Hersteller-Update kann einen neuen Fehler mit sich bringen, eine Standardeinstellung ändern oder zu Konflikten mit einer Abhängigkeit führen, von der Sie gar nicht wussten, dass Sie darauf angewiesen sind. Der Schaden, den ein fehlerhafter Patch anrichtet, kann genauso groß sein wie die Sicherheitslücke, die er eigentlich beheben sollte.
Aus diesem Grund führen Teams Tests in der Staging-Umgebung durch – nur spiegelt die Staging-Umgebung die Produktionsumgebung selten exakt wider, und genau in diesem Unterschied lauern die Überraschungen. Ein Patch, der auf einem brandneuen Testrechner einwandfrei funktioniert, kann auf einem Server mit drei Jahren angesammelter Konfigurationsabweichung fehlschlagen.
Aus der Praxis: Stellen Sie sich ein routinemäßiges Bibliotheks-Update vor, das an einem Freitag direkt in die Produktionsumgebung übertragen wurde, weil es „unbedeutend aussah“. Es ändert eine TLS-Standardeinstellung, unterbricht die Zertifikatsvalidierung gegenüber einer Partner-API und legt den Bezahlvorgang für sechs Stunden lahm. Die behobene CVE wies einen CVSS-Basiswert von 5,3 auf. Der Ausfall verursachte unmittelbaren, messbaren Schaden; die nicht ausgenutzte Schwachstelle hingegen keinen.
Ausfallzeiten, Neustarts und Wartungsfenster
Viele Updates für den Kernel, die Kernbibliotheken und die Systemdienste erfordern üblicherweise einen Systemneustart oder einen Neustart der betroffenen Dienste, bevor der neue Code wirksam wird. Bei einer rund um die Uhr laufenden Arbeitslast stellt dieser Neustart ein Risiko dar. Jeder Neustart birgt das Risiko, dass ein Dienst nicht wieder verfügbar ist, eine Einbindung fehlschlägt oder eine Konfiguration falsch geladen wird.
Das Terminierungsproblem verschlimmert die Situation noch. Globale Teams haben keine gemeinsamen Arbeitszeiten außerhalb der Geschäftszeiten, und die Wartungsfenster werden immer kürzer. Daher werden Patches gebündelt, die Bündel verzögern sich, und durch diese Verzögerung entsteht erneut das Risiko eines ungepatchten Systems. Auch das Patchen von User-Space-Bibliotheken stößt auf dieselbe Hürde: Die Aktualisierung von glibc oder OpenSSL erfordert üblicherweise einen Neustart der betroffenen Dienste, die mit diesen Bibliotheken verknüpft sind.
Das ist die Lücke , für die das Patchen ohne Neustart genau dafür entwickelt wurde. Das Anwenden von Korrekturen auf einen laufenden Kernel oder eine gemeinsam genutzte Bibliothek ohne Neustart beseitigt in einem Schritt das Risiko von Ausfallzeiten und die damit verbundenen Verzögerungen. LibCare von TuxCare erweitert dieses Modell auf unterstützte gemeinsam genutzte Bibliotheken, darunter OpenSSL und glibc.
Alarmmüdigkeit und mangelnde Priorisierung
Schwachstellenscanner sind unerbittlich. In einer mittelgroßen Umgebung können monatlich Tausende von Befunden auftauchen, von denen jedoch nur ein kleiner Bruchteil jemals irgendwo ausgenutzt wird. Wenn alles als kritisch markiert wird, ist nichts mehr kritisch.
Sicherheitsteams schalten ab. Entweder jagen sie Befunden mit geringem Risiko hinterher, während eine tatsächlich ausnutzbare CVE unberücksichtigt bleibt, oder sie übersehen in der Flut von Meldungen genau den einen Alarm, der wirklich wichtig war. Die Lösung besteht darin, die Prioritäten anhand der tatsächlichen Ausnutzbarkeit in der Praxis statt anhand der reinen CVSS-Werte zu setzen – und genau hier kommen Daten zur Ausnutzbarkeitsprognose ins Spiel.
Was passiert, wenn Risiken nicht beachtet werden?
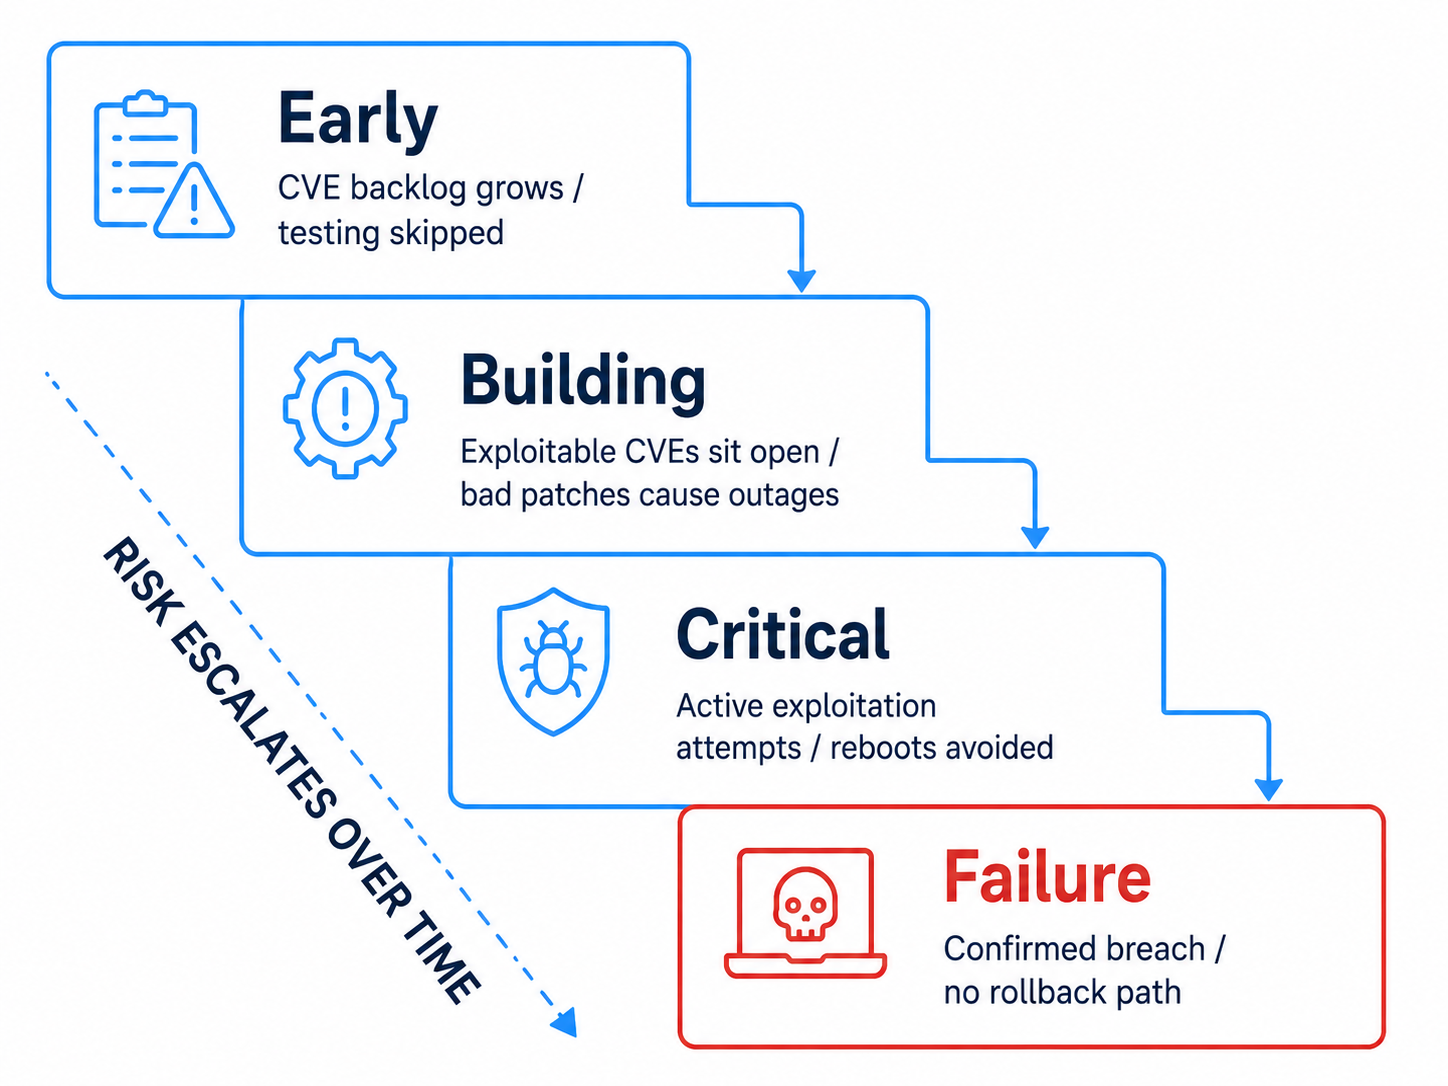
Wenn man die Risiken des Patch-Managements auf beiden Seiten lange genug ignoriert, häufen sich die Fehlerquellen. Die Risiken durch nicht gepatchte Systeme und die Prozessrisiken sind keine voneinander getrennten Probleme – sie verstärken sich gegenseitig und führen zu einer sich langsam anbahnenden Krise.
So eskaliert die Situation zwischen den beiden Seiten, wenn sich nichts ändert:
| Bühne | Seite, auf der kein Pflaster angebracht ist | Prozessseite |
| Früh | Der Rückstand bei den zurückgestellten CVEs wächst | Teams verzichten auf Tests, um Zeit zu sparen |
| Gebäude | Ausnutzbare CVEs bleiben wochenlang ungeschützt | Fehlerhafte Abschnitte führen gelegentlich zu Ausfällen |
| Kritisch | Aktive Ausnutzung, Angriffsversuche | Neustarts werden vermieden, Korrekturen werden nicht mehr übernommen |
| Misserfolg | Bestätigter Sicherheitsverstoß, Compliance-Risiko | Instabilität in der Produktion, kein Rollback-Pfad |
Am Ende steht ein Team, das sowohl unsicher ist als auch Angst vor Patches hat – es führt weniger Patches durch, weil diese immer wieder zu Fehlern führen, und es kommt häufiger zu Fehlern, weil die Systeme, auf denen dieser Rückstand lastet, sich immer weiter von einem bekanntermaßen einwandfreien Zustand entfernen.
So lassen sich Risiken beim Patch-Management minimieren
Ein effektives Patch-Management bedeutet, beide Aspekte gleichzeitig anzugehen: die Lücken bei der Patch-Installation und die Mängel auf Prozessebene. Behebt man das eine und ignoriert das andere, hat man das Risiko lediglich verlagert.
Es sollte als System funktionieren, nicht als Checkliste. Die folgenden Schritte bauen aufeinander auf. Testdisziplin beeinflusst die Priorisierung, die Priorisierung beeinflusst die Bereitstellung, und der Wegfall der Notwendigkeit eines Neustarts beschleunigt den gesamten Kreislauf.
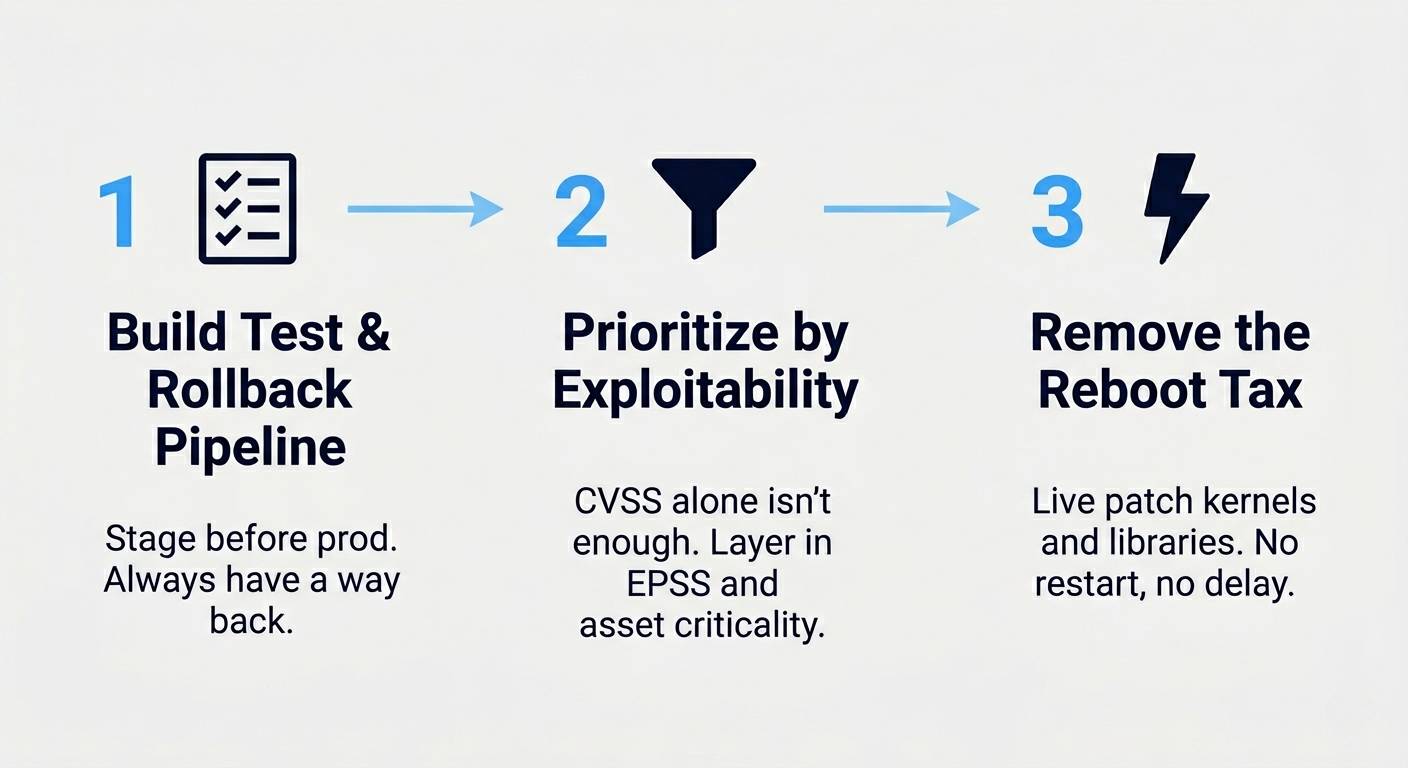
Schritt 1: Aufbau einer Pipeline für Echt-Test- und Rollback-Vorgänge
Bevor ein Patch in die Produktionsumgebung gelangt, muss er einen Weg durch eine repräsentative Umgebung nehmen und über einen getesteten, zuverlässigen Rückweg verfügen. Zwei Faktoren, die das Risiko messbar verringern:
- Eine Staging-Umgebung, die die Produktionsumgebung widerspiegelt: gleiche Betriebssystemversionen, gleiche Hauptkonfiguration, gleiche wichtige Abhängigkeiten. Snapshot-basierte Testsysteme sind hier hilfreich, da sie die Reproduzierbarkeit wiederholter Tests gewährleisten.
- Ein automatisierter Rollback: Paket-Pinning, Dateisystem-Snapshots oder Versionsverwaltung von Container-Images – so lässt sich der Rollback mit einem einzigen Befehl durchführen und ist keine mühsame, forensische Aufgabe.
Wenn ein Patch die Staging-Phase erfolgreich durchläuft und Sie ein sauberes Rollback durchführen können, können Sie ihn getrost bereitstellen. Wenn ein sauberes Rollback nicht möglich ist, ist das nicht automatisch ein Grund zum Abwarten – bei einer aktiv ausgenutzten CVE ist Abwarten oft die riskantere Option. Fügen Sie Ausgleichsmaßnahmen hinzu, stellen Sie den Patch zunächst in einer Canary-Gruppe bereit und dokumentieren Sie die Entscheidung, bevor Sie fortfahren. Ein Patch, den Sie nicht rückgängig machen können, ist ein Vertrauen in die Qualitätssicherung des Anbieters, und diese Entscheidung sollte wohlüberlegt sein.
Schritt 2: Priorisieren Sie nach Ausnutzbarkeit, nicht nach Umfang
Hören Sie auf, jeden CVSS-Wert von 9,8 gleich zu behandeln. Eine Schwachstelle mit hohem Schweregrad, für die es keinen öffentlichen Exploit gibt und die nicht über das Netzwerk zugänglich ist, hat eine geringere Dringlichkeit als eine Schwachstelle mit mittlerem Schweregrad, die aktiv ausgenutzt wird. Nutzen Sie Signale der Schicht 3, um Störsignale herauszufiltern:
- Status des Exploits: Ist er im CISA-KEV-Katalog aufgeführt oder weist er einen hohen oder schnell steigenden EPSS-Wert auf?
- Erreichbarkeit: Ist der betroffene Dienst nach außen gerichtet oder nur intern zugänglich?
- Kritikalität der Anlage: Enthält der Rechner regulierte Daten oder führt er umsatzkritische Abläufe aus?
Priorisieren Sie die Schwachstellen, bei denen alle drei Faktoren am stärksten ausgeprägt sind. Sie werden zwar weiterhin einige Patches zurückstellen – der Unterschied besteht jedoch darin, dass Sie selbst entscheiden, welche das sind, und Ihre Entscheidung begründen können.
Schritt 3: Die Notwendigkeit eines Neustarts durch Patches ohne Neustart beseitigen
Bei Systemen, bei denen die Verfügbarkeit eine entscheidende Rolle spielt, sind die Ausfallkosten durch Neustarts und den Neustart von Diensten einer der Hauptgründe für Verzögerungen bei der Installation von Patches. Beseitigt man diese Einschränkung, löst sich ein erheblicher Teil des Rückstands von selbst auf. Beim „rebootless patching“ werden unterstützte Kernel- und Bibliothekskorrekturen ohne Neustart auf laufende Systeme angewendet, sodass ein verfügbarer „rebootless“-Patch innerhalb weniger Stunden bereitgestellt werden kann, anstatt auf das nächste Wartungsfenster warten zu müssen.
Wie AI bei der Patch-Verwaltung helfen kann
KI ist im Patch-Management aus einem Grund nützlich: Der Bereich wird von Daten überschwemmt, und genau darin liegen die Stärken dieser Systeme – nämlich große Datenmengen schnell zu korrelieren und zu klassifizieren. Sie ersetzt nicht das menschliche Urteilsvermögen. Sie reduziert vielmehr die Anzahl der Entscheidungen, die ein Mensch treffen muss.
AI und Risikoidentifizierung
KI-gestützte Tools korrelieren CVE-Feeds, Bestandslisten und Konfigurationsdaten schneller als jede manuelle Überprüfung. Anstatt dass ein Mitarbeiter eine neue Sicherheitsempfehlung manuell mit einer Bestandsliste abgleicht, kennzeichnet das System, welche Ihrer spezifischen Hosts betroffen sind. Bei ausreichend vollständigen Abhängigkeits- und Laufzeitdaten kann es auch dabei helfen, indirekte Sicherheitslücken aufzudecken: eine anfällige Bibliothek, die mehrere Ebenen tief in einem Abhängigkeitsbaum verborgen ist, oder einen Dienst, der zwar technisch gepatcht wurde, aber im Speicher weiterhin den alten Code ausführt.
Stellen Sie sich das als eine automatisierte Frühwarnebene vor, die Patch-Veröffentlichungen, Schwachstellendatenbanken und Bedrohungsfeeds gleichzeitig miteinander verknüpft – nicht, weil ein Mensch dazu nicht in der Lage wäre, sondern weil kein Mensch über die nötigen Kapazitäten verfügt, dies in diesem Umfang zu tun, ohne dabei etwas zu übersehen.
KI-gestützte Risikopriorisierung
Genau hier kommt die KI ins Spiel. Modelle, die anhand von Exploit-Daten trainiert wurden, können einschätzen, welche CVEs am ehesten für Angriffe missbraucht werden, und bewerten die Ergebnisse nach dem wahrscheinlichen Risiko in der Praxis statt nach der reinen Schwere. Damit wird das Problem der Alarmmüdigkeit direkt angegangen.
Wussten Sie schon: EPSS – das von FIRST betriebene „Exploit Prediction Scoring System“ – schätzt die Wahrscheinlichkeit ein, dass in den nächsten 30 Tagen Exploit-Aktivitäten im Zusammenhang mit einer veröffentlichten CVE beobachtet werden. Untersuchungen des Cyentia Institute und von FIRST ergaben, dass nur etwa 6 % der veröffentlichten CVEs jemals in der Praxis ausgenutzt wurden, während jedes Jahr Tausende von CVEs CVSS-Basiswerte im kritischen Bereich erhalten. Allein der Schweregrad führt Teams regelmäßig dazu, sich zunächst auf die falschen Korrekturen zu konzentrieren.
Fortgeschrittenere Plattformen können die Vorhersage von Exploits mit organisatorischen Kontextinformationen kombinieren, die bei einer generischen Schweregradbewertung unberücksichtigt bleiben – wie Systemkonfiguration, Gefährdung, die Frage, ob kompensierende Kontrollmaßnahmen das Risiko bereits mindern, sowie die geschäftlichen Auswirkungen des betroffenen Systems –, vorausgesetzt, diese Daten sind verfügbar und korrekt integriert. Das Ergebnis ist eine nach Prioritäten geordnete Liste, die Ihre Umgebung widerspiegelt, und nicht die generische Empfehlung eines Anbieters.
Berichterstattung
KI reduziert zudem den Aufwand für die Berichterstellung. Automatisch generierte Compliance-Zusammenfassungen, Übersichten zum Patch-Status und auditfähige Nachweise verringern den manuellen Arbeitsaufwand, der normalerweise demjenigen zufällt, der gerade am wenigsten zu tun hat. Die Ergebnisse müssen zwar weiterhin von einem Menschen überprüft werden, doch die Erstellung des ersten Entwurfs erfordert deutlich weniger Aufwand.
Eine detaillierte Dokumentation der Maßnahmen und Ergebnisse im Bereich Patch-Management liefert den Teams den nötigen Kontext, um wiederkehrende Probleme zu bewältigen, und ist genau das, was die Führungskräfte benötigen, um das Sicherheitsbudget zu rechtfertigen. KI kann diese Dokumentation konsistenter erstellen als eine Person, die sie um 23 Uhr verfasst – auch wenn das Ergebnis dennoch auf Auslassungen und eigene Fehler überprüft werden muss.
Einsatz von AI im Patch-Management
Fangen Sie klein an. KI im Patch-Management funktioniert am besten als Filter und Assistent, nicht als autonomer Patch-Roboter, der ungehindert auf die Produktionsumgebung losgelassen wird. Die Teams, die davon profitieren, setzen sie in den Bereichen des Workflows ein, in denen ein hohes Volumen herrscht und klare, wiederholbare Regeln gelten.
Ein sinnvoller Einführungsweg besteht darin, das System zunächst zur Triage einzusetzen. Lassen Sie es die Ergebnisse bewerten und gruppieren, und lassen Sie anschließend einen Mitarbeiter die Prioritätenliste genehmigen. Darüber hinaus ist es erforderlich, Patch-Klassen mit geringerem Risiko und bewährter Rollback-Funktion sowie routinemäßige Updates im Userspace zu automatisieren – jedoch nicht Produktions-Kernel vom ersten Tag an. Beziehen Sie einen Mitarbeiter in alle irreversiblen Vorgänge mit ein. Dazu gehören Produktions-Kernel, Datenbank-Engines und alles, was sich nicht sauber rückgängig machen lässt.
Bevor Sie sich für ein Tool entscheiden, müssen Sie zunächst die richtigen Grundlagen schaffen. Ein KI-System benötigt umfassende Informationen über Ihre Umgebung, um präzise Empfehlungen aussprechen zu können: ein vollständiges Bestandsverzeichnis der Anlagen, aktuelle Systemkonfigurationen, dokumentierte Abhängigkeiten und festgelegte Wartungsfenster. Wenn Sie dem System nur unvollständige Informationen zur Verfügung stellen, erhalten Sie Empfehlungen, die zwar überzeugend klingen, aber auf unvollständigen Informationen basieren.
Realitätscheck: „KI-gestützt“ bedeutet auf der Marketingseite eines Patch-Tools oft nichts weiter als ein Modell zur Priorisierung von CVEs. Das ist zwar nützlich, aber keine Autonomie. Fragen Sie den Anbieter genau, welche Entscheidungen das Modell trifft und welche es an einen Menschen weiterleitet – an dieser Grenze überholt das Marketing oft das Produkt.
Die besten Tools für das Patch-Management-Risikomanagement
Die Tools lassen sich in zwei Kategorien einteilen: Punktlösungen, die jeweils nur eine Aufgabe erfüllen (Scannen, Bereitstellen oder Live-Patching), und Plattformen, die den gesamten Workflow durchgängig integrieren. Die Tiefe der Integration ist wichtiger als die Anzahl der Funktionen. Ein Scanner, der nicht mit Ihrem Bereitstellungsprozess verbunden ist, erzeugt lediglich weitere Warnmeldungen, die Sie ignorieren müssen.
Der folgende Vergleich stützt sich auf vier Kriterien: Eignung für die primäre Umgebung, die Möglichkeit, Korrekturen ohne Neustart des Systems oder des Dienstes anzuwenden, Betriebssystemunterstützung und Lizenzmodell. Da sich Funktionen und Preise ändern können, sollten Sie vor einer Entscheidung die aktuellen Unterlagen der jeweiligen Anbieter überprüfen.
| Werkzeug | Am besten geeignet für | rebootloses Patchen | Modell |
| TuxCare | Linux-Flotten, EOL-Systeme, Verfügbarkeit rund um die Uhr | Ja (Kernel + Bibliotheken) | Abonnement pro Host |
| Automox | Flotten mit gemischten Betriebssystemen, Cloud-First-Teams | Nein | SaaS pro Endpunkt |
| ManageEngine Patch Manager Plus | Umfassende Unterstützung von Drittanbieter-Apps, vor Ort oder in der Cloud | Nein | Gestaffelte Lizenz |
TuxCare
Das Alleinstellungsmerkmal von TuxCare in diesem Vergleich ist die Bereitstellung von Patches ohne Ausfallzeiten. KernelCare Live-Patches für unterstützte Linux-Kernel auf laufenden Hosts, LibCare Live-Patches für unterstützte Shared Libraries wie glibc und OpenSSL, ohne die damit verknüpften Dienste neu starten zu müssen, und Endless Lifecycle Support sorgt dafür, dass EOL-Distributionen und Laufzeitumgebungen am Ende ihres Lebenszyklus weiterhin CVE-Korrekturen erhalten, nachdem der ursprüngliche Anbieter die Bereitstellung von Sicherheitsupdates für diese Versionen eingestellt hat. TuxCare deckt eine breite Palette von Enterprise-Linux-Distributionen ab, darunter RHEL, CentOS, AlmaLinux, Rocky Linux, CloudLinux, Debian, Ubuntu, Amazon Linux und Oracle Linux – insgesamt mehr als 70 Distributionsversionen.
Diese Kombination deckt beide Aspekte des Patch-Management-Risikos ab. Bei unterstützten Korrekturen entfällt die Notwendigkeit eines Neustarts oder eines Dienstneustarts, die zu Verzögerungen führt, und die Lücke bei nicht unterstützten Systemen – also den Systemen, die weder neu gestartet noch aktualisiert werden können und bei denen herkömmliche Patch-Verfahren versagen – bleibt abgedeckt. Die Lösung eignet sich für Teams, die Linux in großem Maßstab einsetzen, für Unternehmen mit Workloads, die durch SLAs zur Verfügbarkeit geregelt sind, sowie für Umgebungen, in denen Systeme über den Supportzeitraum des Anbieters hinaus in Betrieb bleiben müssen.
Automox
Automox ist eine cloudnative Endpunktplattform, die die Patch-Verwaltung für Windows, macOS und Linux über eine einzige Konsole abwickelt und zudem einen Katalog mit mehreren hundert Anwendungen von Drittanbietern umfasst. Ihr Vorteil liegt in ihrer Reichweite: Sie ist agentenbasiert, plattformübergreifend und speziell für verteilte Geräteflotten ohne lokale Infrastruktur konzipiert.
Die Lösung eignet sich besonders gut für „Cloud-First“-Teams und kleinere Unternehmen, die ein einziges Dashboard für gemischte Endgeräte nutzen möchten. Zum Zeitpunkt der Veröffentlichung wirbt Automox in seiner Produktdokumentation nicht mit Patches für den Linux-Kernel ohne Neustart, sodass bei zentralen Linux-Updates weiterhin Ausfallzeiten aufgrund eines Neustarts anfallen – für die allgemeine Endgeräte-Sicherheit in einer gemischten Infrastruktur genießt die Lösung jedoch hohes Ansehen.
ManageEngine Patch Manager Plus
ManageEngine Patch Manager Plus unterstützt Windows-, macOS- und Linux-Endgeräte sowie mehr als 1.100 Anwendungen von Drittanbietern und ist als lokale Installation oder als Cloud-Dienst verfügbar. Seine herausragende Stärke liegt in der Breite des Anwendungskatalogs, weshalb die Lösung vor allem in Windows-dominierten Umgebungen mit einer Vielzahl von Drittanbietersoftware zum Einsatz kommt.
Der Ablauf ist eher traditionell: Scannen, Planen, Testen, Bereitstellen, Neustart. Die zuvor beschriebenen Risiken auf Prozessebene gelten weiterhin in vollem Umfang. Wie bei jeder automatisierten Bereitstellungsplattform können unzureichende Test- und Freigabekontrollen dazu führen, dass ein problematisches Update termingerecht in die Produktion gelangt. Kombinieren Sie den Einsatz daher daher mit einer soliden Test- und Rollback-Disziplin.
Bewährte Praktiken für den Einsatz
Die Bereitstellung von Tools senkt das Risiko. Erst die konsequente Umsetzung sorgt dafür, dass es auch wirklich funktioniert. Die folgenden Vorgehensweisen unterscheiden ein Patch-Programm, das das Risiko senkt, von einem, das lediglich für Beschäftigung sorgt.
- Führen Sie die Einführung schrittweise durch. Führen Sie die Bereitstellung zunächst in einer Canary-Gruppe durch, achten Sie auf Regressionen und erweitern Sie dann den Umfang. Führen Sie die Bereitstellung niemals auf einen Schlag flottenweit durch.
- Patches sollten nach Ausnutzbarkeitsstufe und nicht nach Kalender terminiert werden. KEV-gelistete CVEs werden vorrangig behandelt; routinemäßige Updates erfolgen im normalen Zeitfenster.
- Überprüfen Sie, ob die Korrektur tatsächlich wirksam geworden ist. Bei Code, der bereits von einem laufenden Prozess oder dem Kernel geladen wurde, reicht die Installation des Pakets nicht aus – die betroffene Komponente muss neu gestartet, das System neu gestartet oder ein Rebootless-Patch angewendet werden.
- Führen Sie ein Prüfprotokoll. Protokollieren Sie, was wann und von wem gepatcht wurde – zur Einhaltung der Vorschriften und für die Nachbetrachtung nach einem Vorfall, von der Sie hoffen, dass sie nie stattfinden wird.
- Trenne Dringendes von Routinemäßigem. Führen Sie bei den CVEs, die keinen Aufschub dulden, Live-Patches durch, damit der Rest des Programms in einem vernünftigen Rhythmus weiterlaufen kann.
Profi-Tipp: Auf Systemen der RHEL-Familie zeigt „needs-restarting -r“ (im Paket „dnf-utils“ enthalten) an, ob installierte Updates einen Neustart empfehlen. Betrachten Sie dies eher als Hinweis denn als Beweis für die Behebung: Der Befehl spiegelt aktualisierte Pakete und laufende Prozesse wider, nicht den CVE-Status. Wenn ein Kernel-CVE durch einen erfolgreich geladenen Patch ohne Neustart abgedeckt ist, ist für diese spezifische Korrektur kein Neustart erforderlich, auch wenn der Befehl möglicherweise noch andere Updates anzeigt, die einen Neustart erfordern.
Wenn Sie über eine große Flotte verfügen und die Verfügbarkeit eine wichtige Rolle spielt, sollten Sie zunächst Patches ohne Neustart einsetzen und den Rest schrittweise einführen. Wenn Sie überwiegend mit Windows arbeiten und Neustarts Ihre Anforderungen an Sicherheit und Verfügbarkeit problemlos erfüllen, reicht möglicherweise eine standardmäßige schrittweise Bereitstellung mit getesteter Rollback-Möglichkeit völlig aus.
Sichern Sie Ihre Systeme mit dem Patch-Management von TuxCare
Das Risiko im Patch-Management lässt sich nicht dadurch beseitigen, dass man noch intensiver Patches installiert. Es lässt sich vielmehr dadurch beseitigen, dass man die Gründe beseitigt, aus denen Teams die Installation hinauszögern – die Neustarts, die Ausfallzeiten, die Angst, dass ein fehlerhaftes Update den Produktivbetrieb lahmlegt – und dass man auch die Systeme abdeckt, die von herkömmlichen Tools vernachlässigt werden.
Das ist die Lücke , die TuxCare schließt. Durch Live-Patches für Kernel und Bibliotheken können verfügbare Korrekturen für unterstützte Systeme ohne Neustart angewendet werden. Der „Endless Lifecycle Support“ sorgt dafür, dass EOL-Distributionen und Laufzeitumgebungen auch lange nach dem Ende des Herstellersupports weiterhin gepatcht werden. Das Ergebnis sind weniger offene Sicherheitslücken und weniger durch Patches verursachte Ausfälle – wodurch das Risiko auf beiden Seiten des Prozesses verringert wird.
Die Entscheidung zwischen Sicherheit und Online-Verfügbarkeit ist genau der Kompromiss, den TuxCare beseitigen soll. Sprechen Sie mit uns über Ihre Umgebung.
FAQs
Ausnutzung einer bekannten, nicht behobenen Sicherheitslücke. Viele Sicherheitsvorfälle, bei denen eine bekannte Schwachstelle ausgenutzt wird, ereignen sich, nachdem bereits ein Patch verfügbar ist, was bedeutet, dass es sich eher um ein operatives als um ein technisches Versagen handelt. Laut dem DBIR 2026 von Verizon entfielen 31 % der Sicherheitsvorfälle auf die Ausnutzung von Sicherheitslücken, die damit den häufigsten Erstzugangsweg darstellten. Damit sind bekannte, nicht behobene Sicherheitslücken einer der am besten vorhersehbaren Angriffspfade in Unternehmensumgebungen.
Ja. Ein fehlerhafter oder ungeprüfter Patch kann den Produktivbetrieb lahmlegen, eine Standardeinstellung ändern oder einen neuen Fehler verursachen. Patches erfordern unter Umständen auch einen Neustart des Systems oder der Dienste, wodurch das Risiko besteht, dass diese nicht ordnungsgemäß wieder hochfahren. Übereilte Bereitstellungen ohne Rollback-Möglichkeit können zudem zu Ausfällen führen, die schwerwiegender sind als die ursprünglich behobene CVE.
So schnell, wie es Ihr Prozess unter Einhaltung der Sicherheitsvorschriften zulässt – idealerweise innerhalb von Stunden bis zu einigen Tagen bei aktiv ausgenutzten CVEs. Die PCI-DSS-Anforderung 6.3.3 legt für Patches kritischer und hochgradiger Schwachstellen eine Frist von einem Monat fest, doch Exploit-Code für viel beachtete Schwachstellen erscheint oft bereits innerhalb weniger Stunden nach der Offenlegung. Monatliche Zyklen sind in der Regel zu langsam für Schwachstellen, die aktiv ausgenutzt werden oder direkt offengelegt sind, unabhängig von ihrem CVSS-Basiswert.
Sie erhalten keine Sicherheitspatches mehr vom Hersteller und werden zu einer Quelle anhaltender Sicherheitsrisiken. EOL-Distributionen und -Laufzeitumgebungen laufen zwar weiter, sammeln jedoch ungepatchte Sicherheitslücken an, es sei denn, das Unternehmen migriert, portiert eigene Korrekturen zurück oder erwirbt erweiterten Support. Dienste wie der „Endless Lifecycle Support“ von TuxCare stellen weiterhin Patches für diese Systeme bereit, ohne eine sofortige Migration zu erzwingen.
Dadurch entfällt der Schritt, bei dem es zu Ausfallzeiten kommt. Beim „Rebootless Patching“ werden unterstützte Kernel- und Bibliothekskorrekturen ohne Neustart auf laufende Systeme angewendet, sodass eine verfügbare Korrektur innerhalb weniger Stunden bereitgestellt werden kann, anstatt auf ein Wartungsfenster warten zu müssen. Dadurch wird eine wesentliche Ursache für Verzögerungen beseitigt und die Zeit verkürzt, in der die Systeme einem Sicherheitsrisiko ausgesetzt sind.