Soporte técnico
 Documentación
 Inicio de sesión
 Contáctenos



Ir directamente al resumen generado por IA de esta entrada del blog 


Principales conclusiones
- Siempre se repiten las mismas causas, lo que significa que se pueden prever y mitigar muchos de los riesgos de tiempo de inactividad.
- La supervisión, la redundancia, las copias de seguridad comprobadas y la aplicación automática de parches reducen tanto la frecuencia con la que se producen las interrupciones del servicio como su gravedad.
- La aplicación de parches se pospone más de lo que la mayoría de los equipos admiten, aunque herramientas como KernelCare aplican las correcciones compatibles del kernel sin necesidad de reiniciar el sistema.
- Elige primero un objetivo realista de tiempo de actividad y, a partir de ahí, diseña tu proceso y tus herramientas de forma inversa.
Cada minuto que tu servidor Linux está inactivo, algo falla en las fases posteriores del proceso. Fallan los procesos de pago, se acumulan las alertas y el buscapersonas de alguien no deja de sonar. La versión resumida de cómo evitar el tiempo de inactividad del servidor: vigila los sistemas que importan, incorpora redundancia, aplica parches según un calendario y mantén reducida la superficie de ataque. A continuación se detallan las causas que realmente se repiten y las soluciones que dan resultado en producción, no las que quedan bien en una diapositiva.
Los reinicios suponen un coste real. Normalmente se programan para horas de menor actividad, e incluso así conllevan riesgos. El reinicio en sí mismo puede durar solo unos minutos, pero la puesta en marcha del servicio, el precalentamiento de la caché, la sincronización de la replicación y las comprobaciones de estado pueden alargar el tiempo necesario mucho más allá de eso. En encuesta de ITIC sobre el coste por hora del tiempo de inactividad en 2024, más del 90 % de las medianas y grandes empresas estiman que el coste de una sola hora de inactividad supera los 300 000 dólares. Lo alentador es que gran parte de ese riesgo se puede evitar, y muchos reinicios relacionados con la aplicación de parches pueden eliminarse por completo.
¿Qué es el tiempo de inactividad del servidor?
El tiempo de inactividad de un servidor es cualquier periodo durante el cual un servidor no puede desempeñar su función, ya sea atender solicitudes, ejecutar cargas de trabajo o, simplemente, estar accesible. Existen dos tipos. El tiempo de inactividad planificado es el periodo de mantenimiento que tú controlas. El tiempo de inactividad no planificado es aquel que te despierta a las 2 de la madrugada. Este segundo tipo es el que más preocupa a la mayoría de los equipos, y con razón.
Parada programada
Un tiempo de inactividad programado se produce cuando los administradores desconectan deliberadamente los sistemas para realizar tareas de mantenimiento, aplicar actualizaciones, actualizar el hardware, migrar cargas de trabajo o realizar cambios en la infraestructura. Por lo general, se programan para períodos de poco tráfico, pero aun así afectan a los usuarios, a los equipos internos y a las operaciones de la empresa.
Paradas imprevistas
Se habla de «tiempo de inactividad no planificado» cuando los servicios dejan de funcionar sin previo aviso. Fallos de hardware, fallos de software, brechas de seguridad, problemas de red, el agotamiento de recursos y los errores operativos son causas habituales. Para la mayoría de las organizaciones, este es el problema más difícil, ya que surge sin previo aviso y suele exigir una investigación y una solución inmediatas.
Nota: Un fallo en el servidor no implica automáticamente un tiempo de inactividad perceptible para el usuario. Si la redundancia y la conmutación por error funcionan correctamente, las solicitudes ni siquiera lo notan. Las interrupciones se producen cuando un fallo no cuenta con una ruta de respaldo, cuando la conmutación por error es demasiado lenta para ser eficaz o cuando el fallo afecta a varios componentes a la vez. La redundancia es solo una parte de la solución, no la solución completa, lo cual conviene recordar a la hora de decidir dónde centrar los esfuerzos de prevención.
¿Qué provoca el tiempo de inactividad de los servidores?
A pesar de todo lo que la infraestructura en la nube, automatización y la supervisión han cambiado, la lista de causas que provocan la caída de los servidores apenas ha variado. Los mismos problemas técnicos y operativos se repiten en muchas de las interrupciones de servicio con las que se encuentran los equipos.
| Causa | Desencadenante habitual | Enfoque en la prevención |
| Fallo de hardware | Fallo del disco duro, la fuente de alimentación o la memoria RAM | Redundancia, supervisión |
| Errores de configuración y errores humanos | Error en la implementación o cambio en las normas | Control de cambios, revisión |
| Vulnerabilidades CVE sin parchear y ataques | Se han aprovechado vulnerabilidades conocidas | Aplicación de parches, refuerzo de la seguridad |
| Inestabilidad del sistema operativo y del software | Fuga de memoria, pánico del núcleo | Actualizaciones, gestión del ciclo de vida, soporte ampliado |
| Fallo de red | DNS, enrutamiento, certificado caducado | Rutas redundantes, alertas de certificados |
| Agotamiento de los recursos | Pico de tráfico, disco lleno, grupo de conexiones al máximo | Planificación de la capacidad, margen de maniobra |
Fallo de hardware
Los discos se estropean, las fuentes de alimentación fallan, la memoria RAM se estropea y los ventiladores dejan de funcionar. El hardware es la causa más evidente y aquella para la que la mayoría de los equipos ya cuentan. El problema es que un solo componente no redundante —un disco o una fuente de alimentación— puede, por sí solo, dejar todo el equipo fuera de servicio.
Errores de configuración y errores humanos
Una regla de cortafuegos mal escrita, un cambio erróneo en el DNS, una implementación que omite una comprobación de estado. El error humano está detrás de una gran parte de las interrupciones del servicio, aunque suele adoptar otra forma para cuando se redacta el informe posterior al incidente. El control de cambios y la revisión por pares detectan muchos de estos errores antes de que lleguen al entorno de producción, y la gestión de parches ayuda por la misma razón, ya que elimina los pasos manuales en los que se cometen los errores.
Vulnerabilidades sin parchear y ciberataques
Sin parchear Las vulnerabilidades de Linux son una puerta abierta. Los atacantes pueden empezar a aprovechar un CVE conocido antes de que muchas organizaciones hayan implementado el parche disponible, y muchos ataques que tienen éxito acaban provocando interrupciones del servicio, con el ransomware y los ataques DDoS como ejemplos evidentes.
Mantenerse al día en la aplicación de parches de seguridad elimina los puntos de entrada más baratos que existen. Además, el daño rara vez se limita a la interrupción del servicio, ya que las consecuencias normativas, la pérdida de clientes y el deterioro de la reputación perduran más allá del propio incidente.
Inestabilidad del sistema operativo y del software
Fugas de memoria, errores críticos del núcleo, procesos fuera de control, conflictos de dependencias. La degradación del software se va acumulando silenciosamente hasta que un servicio se bloquea o el servidor se cuelga. El software al final de su ciclo de vida complica aún más las cosas, ya que dejan de llegar parches de seguridad y correcciones de errores de los desarrolladores originales, y los problemas conocidos permanecen sin resolver a menos que se cuente con otra vía de soporte.
Fallos de red
Interrupciones del DNS, problemas de enrutamiento, certificados caducados, problemas con el proveedor de acceso. Tu servidor puede estar en perfecto estado y, aun así, resultar inaccesible. Estos problemas pasan fácilmente desapercibidos, ya que el servidor parece funcionar correctamente en todos tus paneles de control, mientras que los usuarios no reciben nada.
Atención: Los certificados TLS caducados provocan más interrupciones misteriosas de lo que a nadie le gusta admitir. Configura alertas de caducidad de certificados a 30 y 7 días vista, no la misma mañana en que se produce el fallo.
Sobrecarga de recursos
Cuando la demanda supera los recursos disponibles, el rendimiento se ve mermado hasta que las solicitudes empiezan a fallar, se cierran procesos o el servicio simplemente deja de responder. La infraestructura en la nube se puede configurar para escalar dinámicamente, pero alguien tiene que asegurarse de que la capacidad se ajuste a lo que la aplicación realmente necesita. Los picos de tráfico, las «tormentas de reintentos» de los usuarios que insisten en un servicio degradado y un solo «vecino ruidoso» en un servidor compartido pueden desencadenar una reacción en cadena.
Cuánto cuesta el tiempo de inactividad y qué permite tu SLA
Tu objetivo de tiempo de actividad es, en realidad, un presupuesto para los fallos. A continuación te explicamos qué te ofrece cada nivel.
| Acuerdo de nivel de servicio (SLA) sobre tiempo de actividad | Tiempo de inactividad al año | Tiempo de inactividad al mes |
| 99% | 3,65 días | 7,31 horas |
| 99.9% | 8,77 horas | 43,8 minutos |
| 99.99% | 52,6 minutos | 4,38 minutos |
| 99.999% | 5,26 minutos | 26,3 segundos |
La aplicación de parches conlleva sus propios costes por tiempo de inactividad, y cada vez resulta más caro hacer frente a las interrupciones del servicio. El Análisis Anual de Interrupciones de 2026 de 2026 del Uptime Institute señala que el 57 % de los operadores estiman que su última interrupción importante superó los 100 000 dólares y, por segundo año consecutivo, uno de cada cinco la sitúa por encima del millón de dólares, a pesar de que la frecuencia de interrupciones por centro se redujo por quinto año consecutivo. Un menor número de interrupciones que, sin embargo, cuestan más cada una, es un mal negocio para cualquiera cuyo proceso de aplicación de parches siga dependiendo de programar tiempos de inactividad.
Cómo planificar un descanso sin arrepentirse
Tarde o temprano hay que programar un periodo de inactividad, ya sea para implementar código, realizar cambios de hardware, actualizar la configuración o llevar a cabo una migración de servidores. Las horas de menor actividad son la opción más obvia, pero hay más margen para optimizar el proceso del que la mayoría de los equipos aprovechan.
Empieza por las copias de seguridad. Asegúrate de que sean recientes, de que se hayan probado y de que se pueda acceder a ellas, porque descubrir a mitad de un proceso de reversión que tu copia de seguridad nunca se validó convierte un problema en dos. A continuación, comprueba el espacio libre en disco y la carga actual de recursos antes de empezar, ya que un sistema de archivos casi lleno o un servidor que ya esté luchando por la memoria puede convertir una actualización rutinaria en un incidente. Y prueba primero en el entorno de pruebas, incluso para los cambios pequeños. Especialmente para los cambios pequeños, ya que son los que suelen pasar sin más.
10 estrategias clave para evitar el tiempo de inactividad de los servidores
No hay una única solución que garantice un alto nivel de disponibilidad. Se trata de un conjunto de hábitos y herramientas que funcionan en conjunto. Todo lo que se indica a continuación resiste la carga real de producción, y está ordenado más o menos en el orden en que la mayoría de los equipos deberían adoptarlo.
1. Habilitar la supervisión continua y las alertas tempranas
No se puede prevenir lo que no se ve. La supervisión continua de la CPU, la memoria, el disco, la red y los controles de nivel de servicio es la base sobre la que se sustenta todo lo demás. El objetivo no es tener un sinfín de paneles de control, sino que se activen alertas antes de que nadie ajeno al equipo se dé cuenta.
Establece umbrales para los indicadores adelantados, como un disco que tiende a llenarse o un uso de la memoria que va aumentando progresivamente, y no solo para los fallos graves. Si tus alertas solo se activan cuando algo ya ha dejado de funcionar, lo único que hacen es informar de lo que ya ha ocurrido.
Si te sientes abrumado por el ruido, ajusta los umbrales y clasifica las alertas según su gravedad. Y una vez que superes los unos cientos de servidores, revisa periódicamente el parque informático para asegurarte de que nada haya quedado fuera de la supervisión sin que te hayas dado cuenta, porque un único servidor sin supervisar es un punto ciego que, tarde o temprano, te pasará factura.
Consejo profesional: Presta atención a la tasa de variación, no solo a los valores absolutos. Un disco que se mantiene estable en el 70 % puede ser menos urgente que uno que haya pasado del 40 % al 70 % en una hora, y la tasa de variación permite detectar problemas que un umbral estático pasa por alto.
2. Automatizar la aplicación de parches en los servidores
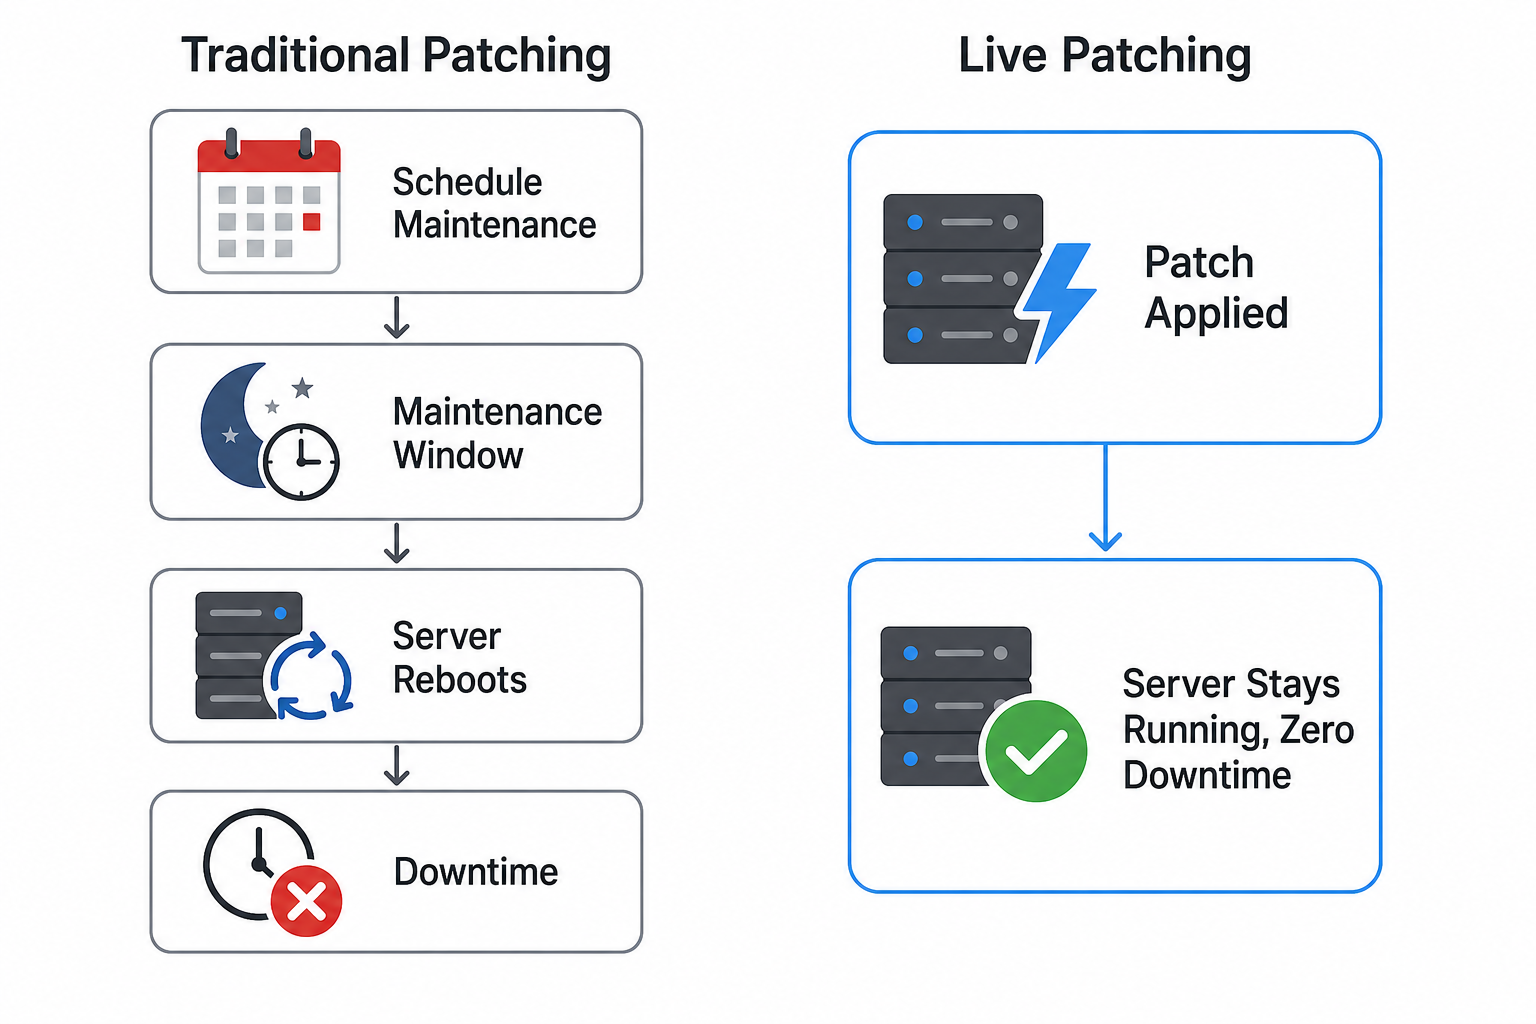
La aplicación manual de parches resulta inmanejable a gran escala, y las actualizaciones del núcleo que requieren un reinicio generan por sí mismas un tiempo de inactividad programado. Esto genera una tensión que la mayoría de los equipos conocen bien: aplicar los parches rápidamente y mantener el servicio disponible pueden empezar a ser objetivos contrapuestos, sobre todo en sistemas en los que es difícil disponer de ventanas de mantenimiento.
Automatización de la implementación de parches permite que las correcciones CVE disponibles lleguen a los sistemas de forma más rápida y uniforme en todo el parque informático. La mayor ventaja es evitar el reinicio siempre que sea posible. La aplicación de parches en tiempo real (también conocida como aplicación de parches sin reinicio) aplica correcciones del kernel a un sistema en funcionamiento sin necesidad de reiniciarlo. KernelCare de TuxCare de TuxCare lo hace para los núcleos de Linux compatibles, mientras que LibCare amplía este mismo concepto a bibliotecas compartidas críticas, como glibc y OpenSSL.
El retraso en la aplicación de parches es un factor importante que contribuye a las interrupciones del servicio, y las cifras han empeorado. Según el DBIR 2026 de Verizon, el aprovechamiento de vulnerabilidades es ahora el vector de acceso inicial más común para las brechas de seguridad, con un 31 %, frente al 20 % del año anterior, y es la primera vez en los 19 años de historia del informe que supera al uso indebido de credenciales. La corrección de vulnerabilidades siguió la tendencia opuesta. Solo el 26 % de las entradas de la lista de vulnerabilidades explotadas conocidas (KEV) de la CISA detectadas en los entornos estudiados por Verizon se corrigieron por completo en 2025, lo que supone un descenso respecto al 38 %, y el tiempo medio hasta la resolución total se alargó de 32 a 43 días. La automatización es la forma de cerrar esa brecha sin que ello afecte al tiempo de actividad.
3. Incorporar redundancia y conmutación por error en la arquitectura
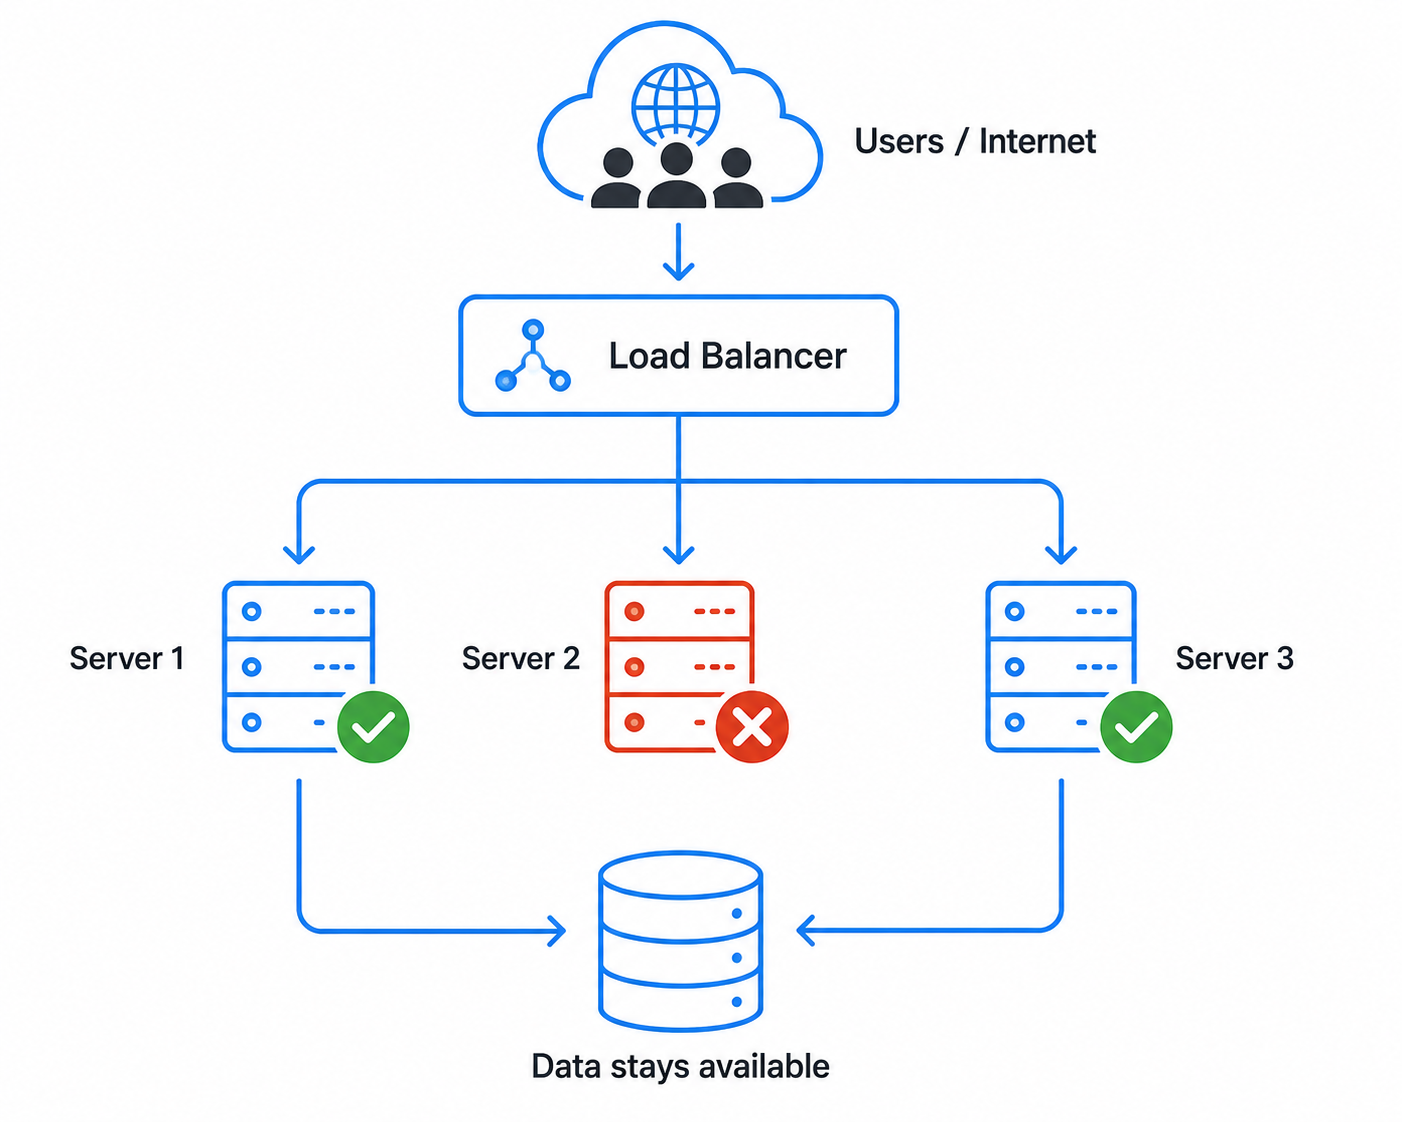
Los puntos únicos de fallo son los que acaban con el tiempo de actividad. La redundancia implica que ningún componente por sí solo —ya sea un servidor, un disco, una fuente de alimentación o una ruta de red— pueda provocar por sí solo la caída de todo el sistema.
Los equilibradores de carga, que distribuyen el tráfico entre varias instancias, las bases de datos replicadas y las implementaciones multizona garantizan la continuidad del servicio cuando falla un componente. Los diseños «activo-activo» pueden reducir las interrupciones provocadas por una conmutación por error, aunque suelen ser más complejos y costosos que los «activo-pasivo», y una configuración «activo-pasivo» bien diseñada también puede realizar la conmutación con gran rapidez.
La elección depende de tu presupuesto para el tiempo de inactividad y de tu objetivo de tiempo de recuperación. Las bases de datos merecen una atención especial, ya que una capa de aplicaciones con tres réplicas en buen estado situadas delante de una base de datos sin réplica sigue estando a solo una mala tarde de sufrir una interrupción del servicio.
4. Realiza copias de seguridad periódicas y comprobadas
Las copias de seguridad no sirven de nada hasta que las restauras. Muchos equipos se dan cuenta de que sus copias de seguridad han estado fallando de forma silenciosa justo en el momento en que las necesitan. Ejecútalas de forma automática y con frecuencia, guarda al menos una copia fuera de las instalaciones o en una cuenta independiente, y prueba las restauraciones de forma periódica. Esta última parte es la que se suele pasar por alto.
El ransomware ataca específicamente a los sistemas de copia de seguridad, por lo que las copias inmutables o aisladas son ahora más importantes que antes.
5. Reforzar la seguridad para evitar interrupciones provocadas por ataques
Una parte significativa de los tiempos de inactividad no planificados se debe a un atacante, ya sea un ataque DDoS, un ransomware o un servicio comprometido que se ha desconectado para su limpieza. Reforzar la seguridad de los servidores reduce la superficie de ataque mediante el principio de privilegios mínimos, reglas de cortafuegos, Fail2Ban y la desactivación de los servicios que nadie utiliza.
Bueno prácticas de seguridad en Linux y la aplicación de los parches más recientes eliminan gran parte de las oportunidades fáciles con las que cuentan los atacantes. Considera la seguridad y el tiempo de actividad como problemas estrechamente relacionados, ya que un servidor comprometido se convierte rápidamente en un incidente de disponibilidad. Las vulnerabilidades de alto impacto en software ampliamente utilizado atraen intentos de explotación rápidamente tras su divulgación, por lo que cualquiera que gestione servidores expuestos al público necesita una forma de actuar con rapidez.
6. Planificar la capacidad del servidor y el margen de recursos
Las interrupciones debidas al agotamiento de los recursos son culpa nuestra. Un sistema de archivos que se llena, un grupo de conexiones que alcanza su límite máximo o la memoria que se agota pueden provocar la caída de un servicio con la misma eficacia que un disco averiado. Realiza un seguimiento de las tendencias de utilización, establece umbrales por carga de trabajo en lugar de recurrir a una cifra universal y mantén un margen suficiente para absorber tanto un pico de tráfico previsto como la pérdida de un nodo.
Planifica con antelación los picos de demanda que ya conoces, como los lanzamientos de productos y los picos estacionales, antes de que se produzcan y no cuando ya estén aquí. Si la capacidad de trabajo está constantemente al límite, se trata más de un problema de planificación que de infraestructura.
7. Realizar auditorías periódicas y comprobaciones de rendimiento
La deriva es silenciosa: las configuraciones cambian, los certificados están a punto de caducar, los paquetes se quedan obsoletos y los pequeños problemas se acumulan hasta que uno de ellos provoca una interrupción del servicio. Las auditorías programadas —es decir, las revisiones de configuración, el análisis de registros y las referencias de rendimiento— detectan estos problemas cuando aún resulta económico solucionarlos.
Fíjate en lo que ha cambiado desde la última auditoría de seguridad, no solo en cómo se presenta la situación actual. El objetivo es detectar aquellos problemas que se van gestando lentamente y que las alertas de umbral no señalarán hasta que las cosas ya vayan mal.
8. Planificar y llevar a cabo el mantenimiento de forma adecuada
Un mantenimiento mal gestionado es lo que hace que una ventana de mantenimiento controlada se convierta en una interrupción más prolongada o en una interrupción no planificada. Elige horas en las que realmente no haya actividad, avisa a las personas que deban estar al corriente y ten preparada la reversión antes de tocar nada.
Organiza las etapas con implementaciones «canario» o «azul-verde», de modo que, si una versión defectuosa sale al mercado, solo afecte a una parte del tráfico en lugar de a todo él, y utiliza comprobaciones de estado para controlar cada paso. El objetivo es que el trabajo planificado resulte rutinario y reversible. Una actualización rutinaria nunca debería convertirse en un incidente.
9. Forma a los equipos y documenta tus manuales de procedimientos
Las herramientas no sirven de nada si la persona de guardia no conoce el sistema. Un manual de procedimientos documentado que explique cómo reiniciar un servicio, dónde está configurada la conmutación por error y quién es responsable de qué convierte un ajetreo a las 2 de la madrugada en una simple lista de comprobación.
Mantén actualizados tus procedimientos operativos estándar (SOP) y realiza simulacros de incidentes para que las medidas adecuadas resulten familiares antes de que alguien las necesite. Los procedimientos documentados y ensayados dejan mucho menos margen para los errores que recurrir a recuerdos vagos bajo presión. Forma a los nuevos ingenieros basándote en esos documentos, en lugar de en el «conocimiento tribal».
10. Probar la conmutación por error y realizar simulacros de recuperación ante desastres
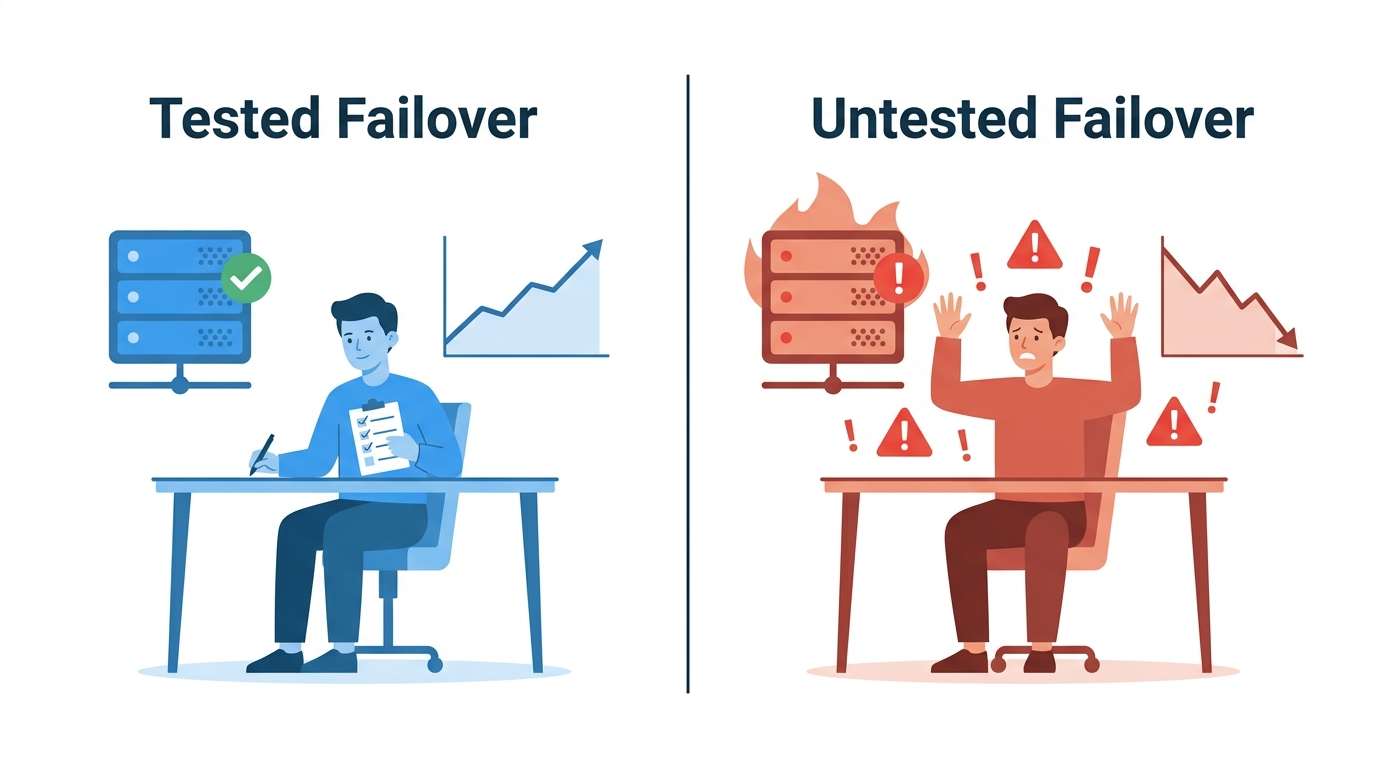
Una conmutación por error sin probar es una mera suposición. La única forma de saber si la redundancia funciona es provocar fallos de forma deliberada. Desactiva un nodo, realiza la conmutación por error de la base de datos, simula una interrupción en la zona y, a continuación, observa qué ocurre realmente. Realiza simulacros de recuperación ante desastres de forma periódica y compara el tiempo de recuperación real con el objetivo fijado.
Si nunca has probado la conmutación por error, da por hecho que no funciona hasta que se demuestre lo contrario. Las pruebas de carga entran en la misma categoría. Un equilibrador de carga distribuye el tráfico, pero aun así es importante saber cómo se comporta el sistema cuando fallan dos nodos en lugar de uno. Realizar pruebas con un clúster en condiciones de degradación te permite saber si la capacidad restante puede absorber la carga o si necesitas más capacidad.
Por qué la aplicación de parches es la solución que los equipos suelen posponer
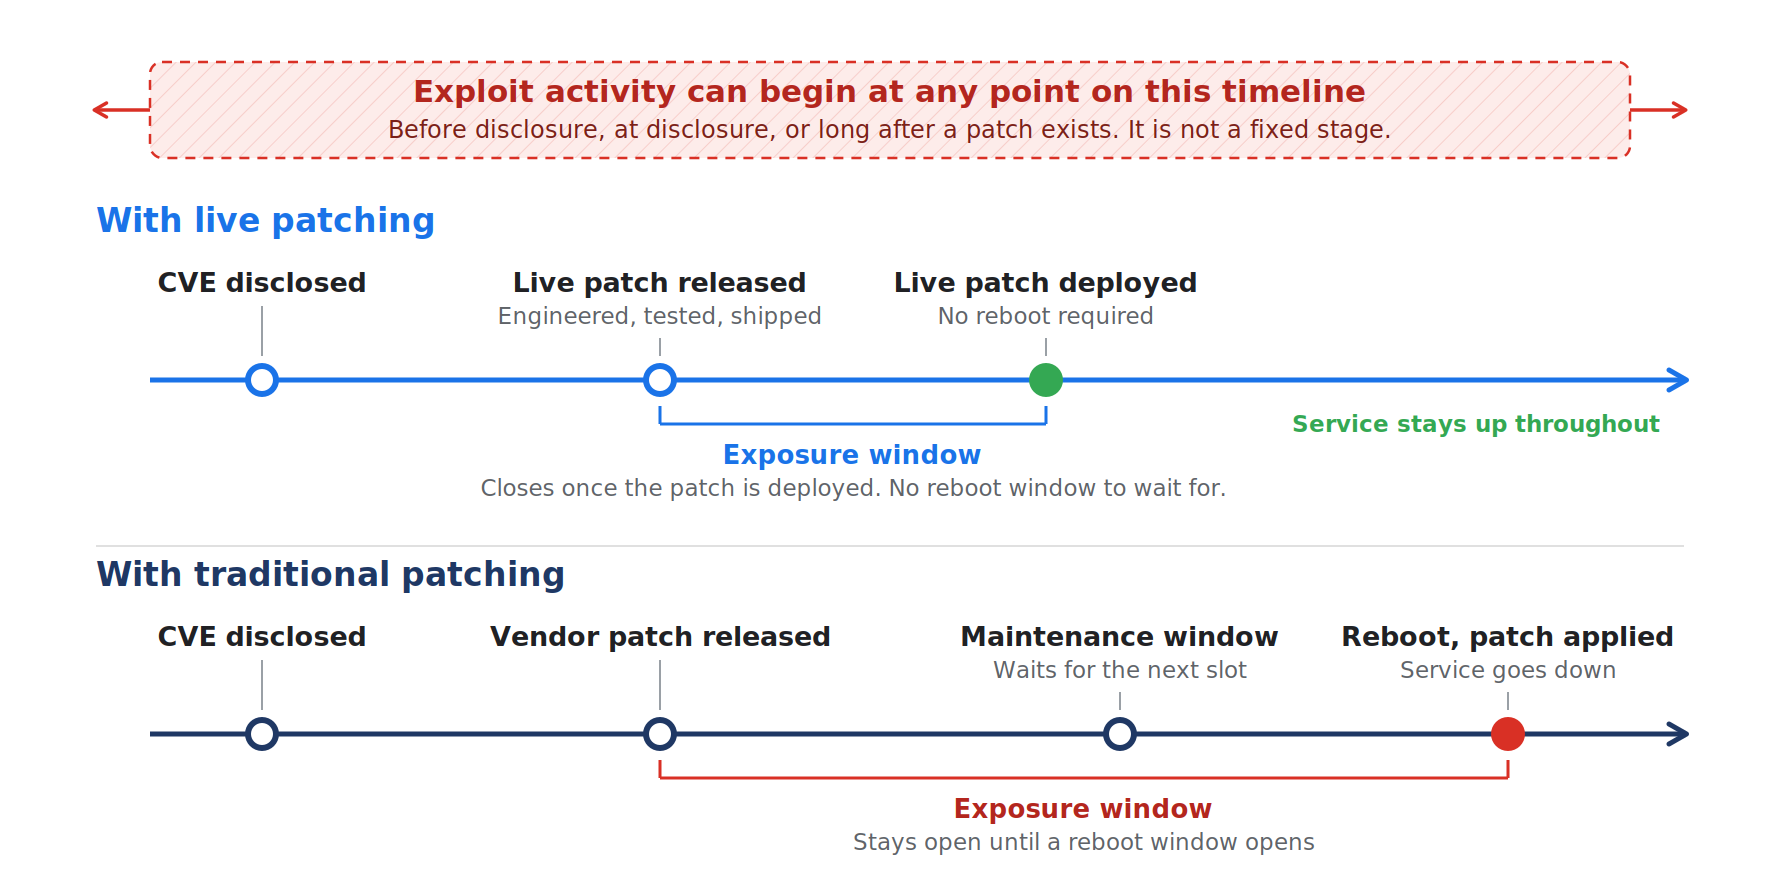
La aplicación de parches es una de las estrategias que los equipos suelen posponer con más frecuencia, y el motivo no es ningún misterio. El ciclo tradicional de aplicar parches al núcleo y reiniciar el sistema provoca precisamente el tiempo de inactividad que todos intentan evitar, por lo que la aplicación de parches se va posponiendo y las vulnerabilidades CVE conocidas permanecen sin resolver. El mismo análisis de 2026 señala que los operadores están desviando progresivamente la inversión hacia la automatización y los sistemas de control para hacer frente a la creciente complejidad, al tiempo que advierte de que una mayor automatización conlleva sus propios tipos de problemas. Ambas afirmaciones son ciertas, y por eso la automatización que merece la pena es aquella que elimina la ventana de mantenimiento en lugar de limitarse a reprogramarla.
La aplicación automática de parches sin necesidad de reiniciar cambia la dinámica de esa disyuntiva. Las correcciones disponibles para el CVE del núcleo pueden aplicarse a sistemas en funcionamiento sin necesidad de reiniciar y sin tener que reservar una ventana de mantenimiento. Los parches se implementan de forma coherente en todo el parque informático, en lugar de servidor por servidor, y el lapso de tiempo entre el lanzamiento de un parche y su implementación puede reducirse de días o semanas a tan solo unas horas. La seguridad de los servidores Linux mejora sin tener que sacrificar el tiempo de actividad para conseguirlo.
Descubre cómo TuxCare te ayuda a evitar los tiempos de inactividad
Para evitar el tiempo de inactividad, es fundamental detectar los problemas a tiempo, incorporar redundancia y subsanar las vulnerabilidades antes de que alguien más las descubra, todo ello sin necesidad de desconectar los sistemas para llevarlo a cabo. Es precisamente en este último punto donde la mayoría de los equipos se quedan atascados.
Las herramientas de aplicación de parches en tiempo real de TuxCare aplican las correcciones de seguridad compatibles sin necesidad de reiniciar el sistema. KernelCare se encarga de los núcleos compatibles. LibCare se encarga de las bibliotecas compartidas críticas. Gracias a la combinación de ambas, las correcciones compatibles con el núcleo y las bibliotecas compartidas críticas pueden aplicarse sin necesidad de una ventana de mantenimiento que requiera un reinicio ni de un reinicio de la aplicación que interrumpa el servicio, lo que significa que tu objetivo de tiempo de actividad y tu nivel de seguridad dejan de ser objetivos contrapuestos.
Si quieres saber cómo se adapta el «live patching» a tu configuración concreta, nuestros expertos en seguridad de Linux estarán encantados de explicártelo.