Suporte Técnico
 Documentação
 Entrar
 Entre em contato conosco



Vá direto para um resumo gerado por IA desta postagem do blog 


Principais conclusões
- Sempre surgem as mesmas poucas causas, o que significa que grande parte do risco de tempo de inatividade pode ser antecipada e mitigada.
- O monitoramento, a redundância, os backups testados e a aplicação automatizada de patches reduzem tanto a frequência com que ocorrem interrupções quanto o impacto causado por elas.
- A aplicação de patches acaba sendo adiada mais do que a maioria das equipes admite, embora ferramentas como KernelCare aplicam correções compatíveis ao kernel sem a necessidade de reinicialização.
- Primeiro, defina uma meta realista de tempo de atividade e, a partir daí, desenvolva seu processo e suas ferramentas de forma retroativa.
A cada minuto, seu servidor Linux fica fora do ar, algo a jusante deixa de funcionar. As transações de checkout falham, os alertas se acumulam e o pager de alguém não para de tocar. A versão resumida de como evitar o tempo de inatividade do servidor: monitore os sistemas que importam, implemente redundância, aplique patches em um cronograma regular e mantenha a superfície de ataque reduzida. A seguir, apresentamos as causas que realmente se repetem e as soluções que se mostram eficazes em produção, não aquelas que ficam bem em um slide.
As reinicializações custam dinheiro de verdade. Elas geralmente são agendadas para horários fora do pico e, mesmo assim, apresentam riscos. A reinicialização em si pode levar apenas alguns minutos, mas a inicialização do serviço, o aquecimento do cache, a atualização da replicação e as verificações de integridade podem prolongar o tempo necessário muito além disso. Na Pesquisa de 2024 da ITIC sobre o Custo por Hora do Tempo de Inatividade, mais de 90% das empresas de médio e grande porte estimam o custo de uma única hora de inatividade em mais de US$ 300.000. O lado encorajador é que grande parte desse risco é evitável, e muitas reinicializações relacionadas a patches podem ser totalmente eliminadas.
O que é tempo de inatividade do servidor?
O tempo de inatividade do servidor é qualquer período em que um servidor não consegue desempenhar suas funções, seja atender a solicitações, executar cargas de trabalho ou simplesmente estar acessível. Existem dois tipos. O tempo de inatividade planejado é a janela de manutenção que você controla. O tempo de inatividade não planejado é aquele que te acorda às 2 da manhã. É com o segundo tipo que a maioria das equipes se preocupa, e com razão.
Interrupção programada
A interrupção planejada ocorre quando os administradores desativam deliberadamente os sistemas para realizar manutenção, aplicar atualizações, atualizar o hardware, migrar cargas de trabalho ou fazer alterações na infraestrutura. Geralmente, é programada para períodos de baixo tráfego, mas ainda assim afeta os usuários, as equipes internas e as operações comerciais.
Paradas não planejadas
O tempo de inatividade não planejado ocorre quando os serviços deixam de funcionar sem aviso prévio. Falhas de hardware, travamentos de software, violações de segurança, problemas de rede, esgotamento de recursos e erros operacionais são causas comuns. Para a maioria das organizações, esse é o problema mais difícil, pois surge sem aviso prévio e geralmente exige investigação e correção imediatas.
Observação: Uma falha no servidor não significa automaticamente um tempo de inatividade perceptível para o usuário. Se a redundância e o failover funcionarem corretamente, as solicitações nem perceberão. As interrupções ocorrem quando uma falha não tem um caminho de backup, quando o failover é lento demais para fazer diferença ou quando o problema afeta vários componentes ao mesmo tempo. A redundância é apenas uma parte da solução, e não a solução completa, o que vale a pena lembrar ao decidir onde concentrar seus esforços de prevenção.
O que causa a indisponibilidade do servidor?
Apesar de tudo o que a infraestrutura em nuvem, automação e monitoramento tenham mudado, a lista de fatores que causam a queda dos servidores praticamente não mudou. Os mesmos problemas técnicos e operacionais se repetem em grande parte das interrupções que as equipes realmente enfrentam.
| Causa | Gatilho comum | Foco na Prevenção |
| Falha de hardware | O disco, a fonte de alimentação ou a memória RAM param de funcionar | Redundância, monitoramento |
| Configuração incorreta e erro humano | Implantação incorreta ou alteração de regra | Controle de mudanças, revisão |
| Vulnerabilidades CVE sem correção e ataques | Vulnerabilidades conhecidas exploradas | Aplicação de patches, fortalecimento da segurança |
| Instabilidade do sistema operacional e do software | Vazamento de memória, kernel panic | Atualizações, gerenciamento do ciclo de vida, suporte estendido |
| Falha na rede | DNS, roteamento, certificado expirado | Caminhos redundantes, alertas de certificado |
| Esgotamento dos recursos | Pico de tráfego, disco cheio, pool de conexões esgotado | Planejamento de capacidade, margem de segurança |
Falha de hardware
Os discos falham, as fontes de alimentação dão problema, a memória RAM apresenta defeito, os ventiladores param de funcionar. O hardware é a causa mais visível e aquela para a qual a maioria das equipes já se prepara. O problema é que um único componente não redundante — um disco ou uma fonte de alimentação — ainda pode, por si só, deixar todo o equipamento fora de operação.
Configuração incorreta e erro humano
Uma regra de firewall digitada incorretamente, uma alteração incorreta no DNS, uma implantação que ignora uma verificação de integridade. O erro humano está por trás de grande parte das interrupções de serviço, geralmente disfarçado de outra causa quando chega a hora de redigir o relatório pós-incidente. O controle de mudanças e a revisão por pares detectam muitos desses erros antes que cheguem à produção, e o gerenciamento de patches ajuda pela mesma razão, pois elimina as etapas manuais nas quais os erros ocorrem.
Vulnerabilidades não corrigidas e ataques cibernéticos
Sem correção As vulnerabilidades do Linux são uma porta aberta. Os invasores podem começar a explorar um CVE conhecido antes que muitas organizações tenham implantado a correção disponível, e muitos ataques bem-sucedidos resultam em tempo de inatividade, com ransomware e DDoS como exemplos óbvios.
Manter-se atualizado sobre correções de vulnerabilidades elimina os pontos de entrada mais fáceis de explorar. Além disso, os danos raramente se limitam à interrupção do serviço, já que os riscos regulatórios, a perda de clientes e os danos à reputação perduram muito além do próprio incidente.
Instabilidade do sistema operacional e do software
Vazamentos de memória, falhas no kernel, processos descontrolados, conflitos de dependência. A deterioração do software se acumula silenciosamente até que um serviço trave ou o host pare de funcionar. O software em fim de vida útil tornam isso ainda mais difícil, pois as correções de segurança e de bugs do desenvolvedor original deixam de ser fornecidas e os problemas conhecidos permanecem sem solução, a menos que haja outro canal de suporte disponível.
Falhas na rede
Interrupções no DNS, problemas de roteamento, certificados vencidos, problemas com o provedor de nível superior. Seu servidor pode estar em perfeitas condições e, mesmo assim, ficar inacessível. Esses problemas são fáceis de passar despercebidos, pois o servidor parece estar funcionando normalmente em todos os painéis de controle que você possui, enquanto os usuários não conseguem acessar nada.
Atenção: Certificados TLS vencidos causam mais interrupções misteriosas do que qualquer um gostaria de admitir. Configure alertas de vencimento de certificados com 30 e 7 dias de antecedência, e não na manhã em que o problema ocorrer.
Sobrecarga de recursos
Quando a demanda excede os recursos disponíveis, o desempenho se deteriora até que as solicitações comecem a falhar, os processos sejam encerrados ou o serviço simplesmente pare de responder. A infraestrutura em nuvem pode ser configurada para se expandir dinamicamente, mas ainda é preciso garantir que a capacidade atenda às necessidades reais da aplicação. Picos de tráfego, enxurradas de tentativas repetidas de usuários que insistem em acessar um serviço com desempenho reduzido e um único “vizinho barulhento” em um servidor compartilhado podem, todos, desencadear uma reação em cadeia.
Quanto custa o tempo de inatividade e o que seu SLA permite
Sua meta de tempo de atividade é, na verdade, um orçamento para falhas. Veja a seguir o que cada nível oferece.
| SLA de disponibilidade | Tempo de inatividade por ano | Tempo de inatividade por mês |
| 99% | 3,65 dias | 7,31 horas |
| 99.9% | 8,77 horas | 43,8 minutos |
| 99.99% | 52,6 minutos | 4,38 minutos |
| 99.999% | 5,26 minutos | 26,3 segundos |
A aplicação de patches acarreta um custo próprio relacionado ao tempo de inatividade, e as interrupções estão ficando cada vez mais caras de se absorver. O relatório do Uptime Institute Análise Anual de Interrupções de 2026 relata que 57% das operadoras estimam que sua mais recente interrupção significativa custou mais de US$ 100.000 e, pelo segundo ano consecutivo, uma em cada cinco estimou esse custo acima de US$ 1 milhão, mesmo com a frequência de interrupções por local tendo caído pelo quinto ano consecutivo. Menos interrupções, mas cada uma custando mais, é um mau negócio para quem ainda depende da reserva de tempo de inatividade para seu processo de aplicação de patches.
Como programar um período de descanso sem se arrepender
Mais cedo ou mais tarde, é preciso programar um período de inatividade, seja para a implantação de código, mudanças de hardware, atualizações de configuração ou migração de servidor. Os horários fora do pico são a escolha óbvia, mas há mais margem para otimizar os processos do que a maioria das equipes aproveita.
Comece pelos backups. Certifique-se de que estejam atualizados, tenham sido testados e estejam realmente acessíveis, pois descobrir no meio de uma reversão que seu backup nunca foi validado transforma um problema em dois. Em seguida, verifique a capacidade disponível em disco e a carga atual sobre os recursos antes de começar, já que um sistema de arquivos quase cheio ou um servidor que já esteja com falta de memória pode transformar uma atualização de rotina em um incidente. E teste primeiro no ambiente de teste, mesmo para pequenas alterações. Especialmente para as pequenas alterações, já que são essas que costumam ser aprovadas sem questionamentos.
10 estratégias essenciais para evitar o tempo de inatividade do servidor
Não existe uma solução única que garanta um alto nível de disponibilidade. Trata-se de um conjunto de hábitos e ferramentas que atuam em conjunto. Todos os itens abaixo resistem à carga real de produção e estão ordenados, de maneira geral, na sequência em que a maioria das equipes deveria adotá-los.
1. Ativar o monitoramento contínuo e os alertas antecipados
Não é possível prevenir o que não se vê. O monitoramento contínuo da CPU, da memória, do disco, da rede e das verificações de nível de serviço é a base sobre a qual tudo o mais se sustenta. O objetivo não é uma infinidade de painéis. São os alertas que são acionados antes que alguém de fora da equipe perceba.
Defina limites para indicadores antecipados, como um disco que está quase cheio ou o uso de memória aumentando gradualmente, e não apenas para falhas graves. Se seus alertas só forem acionados quando algo já estiver fora de serviço, eles estarão apenas relatando o que já aconteceu.
Se você estiver sobrecarregado com ruído, ajuste os limites e organize o tráfego por gravidade. E, assim que ultrapassar algumas centenas de servidores, faça auditorias periódicas no parque de servidores para confirmar que nada tenha saído do monitoramento sem que você perceba, pois um host sem monitoramento é um ponto cego que, mais cedo ou mais tarde, vai te prejudicar.
Dica profissional: Fique atento à taxa de variação, não apenas aos valores absolutos. Um disco que permanece estável em 70% pode ser menos urgente do que um que saltou de 40% para 70% em uma hora, e a taxa de variação detecta problemas que um limite estático não consegue identificar.
2. Automatizar a aplicação de patches nos servidores
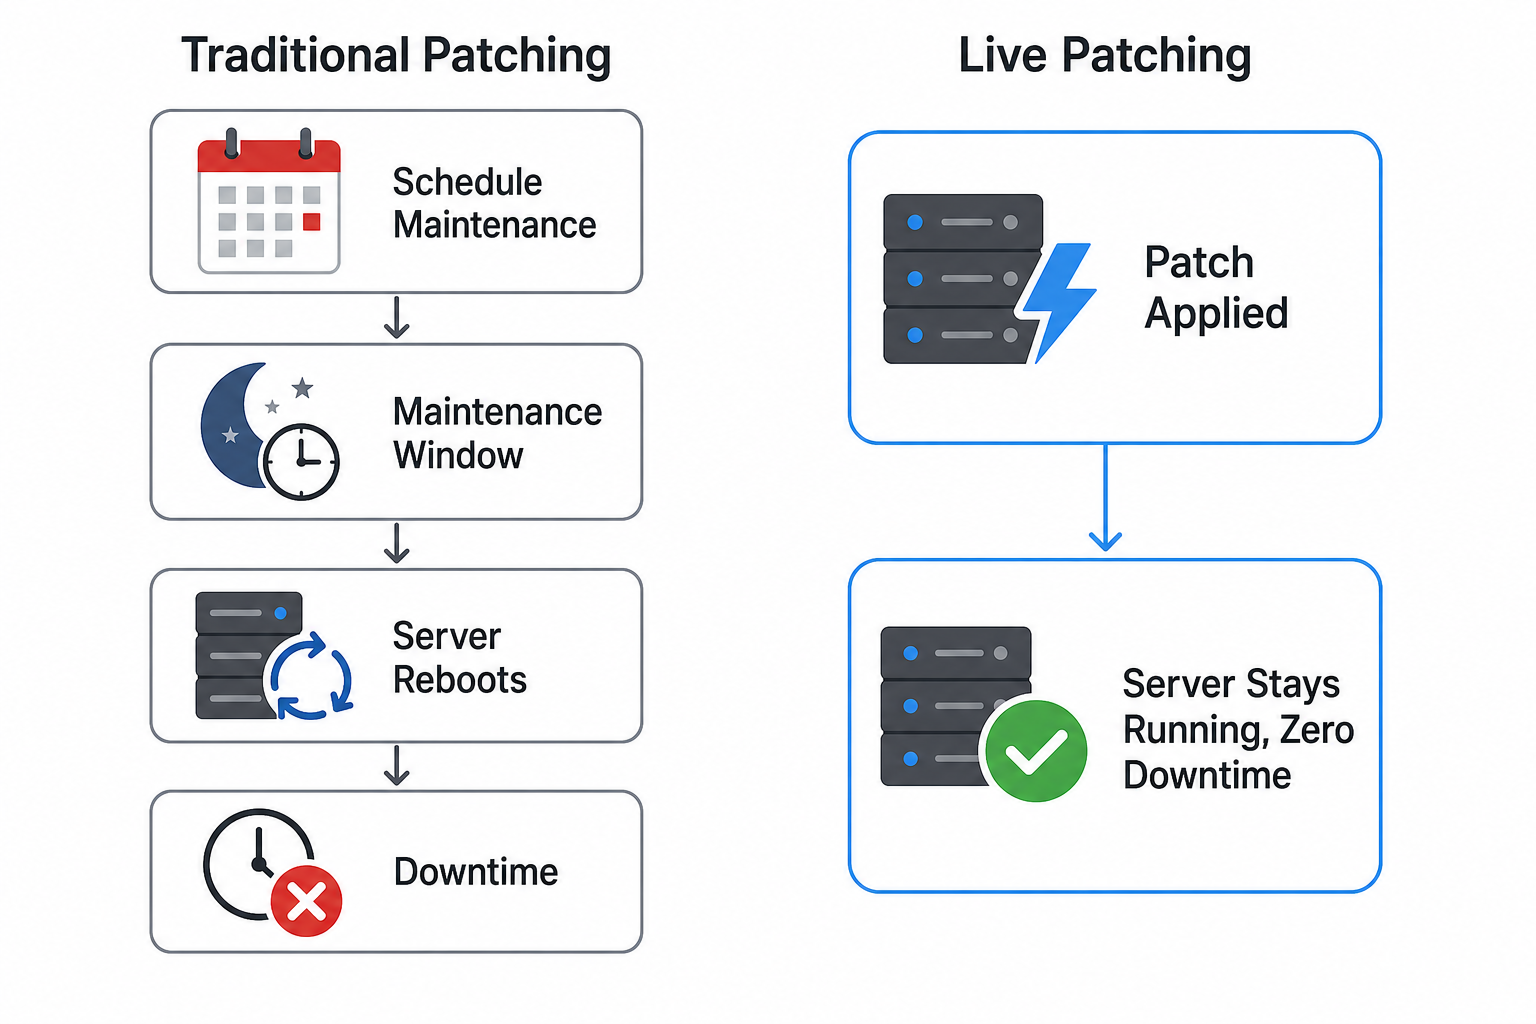
A aplicação manual de patches torna-se difícil de gerenciar em grande escala, e as atualizações do kernel que exigem reinicialização geram, por si só, um tempo de inatividade planejado. Isso cria um conflito que a maioria das equipes conhece bem: aplicar patches rapidamente e manter o serviço disponível podem acabar entrando em conflito, especialmente em sistemas onde é difícil conseguir janelas de manutenção.
Automatização da implantação de patches faz com que as correções CVE disponíveis cheguem aos sistemas de forma mais rápida e consistente em toda a frota. A maior vantagem é eliminar a necessidade de reinicialização sempre que possível. A aplicação de patches em tempo real (também conhecida como aplicação de patches sem reinicialização) aplica correções no kernel a um sistema em execução sem reiniciá-lo. O KernelCare da TuxCare faz isso para kernels Linux compatíveis, enquanto o o LibCare estende o mesmo conceito a bibliotecas compartilhadas críticas, como glibc e OpenSSL.
O atraso na aplicação de patches é um fator significativo para as interrupções de serviço, e os números têm apresentado uma tendência negativa. De acordo com o DBIR 2026 da Verizon, a exploração de vulnerabilidades é agora o vetor de acesso inicial mais comum para violações, com 31%, um aumento em relação aos 20% do ano anterior, e é a primeira vez, nos 19 anos de história do relatório, que ultrapassa o uso indevido de credenciais. A correção seguiu o caminho oposto. Apenas 26% das entradas de Vulnerabilidades Conhecidas como Exploradas (KEV) da CISA encontradas nos ambientes estudados pela Verizon foram totalmente corrigidas em 2025, uma queda em relação aos 38%, e o tempo médio para a resolução completa aumentou de 32 para 43 dias. A automação é a maneira de preencher essa lacuna sem comprometer o tempo de atividade.
3. Incorporar redundância e failover à arquitetura
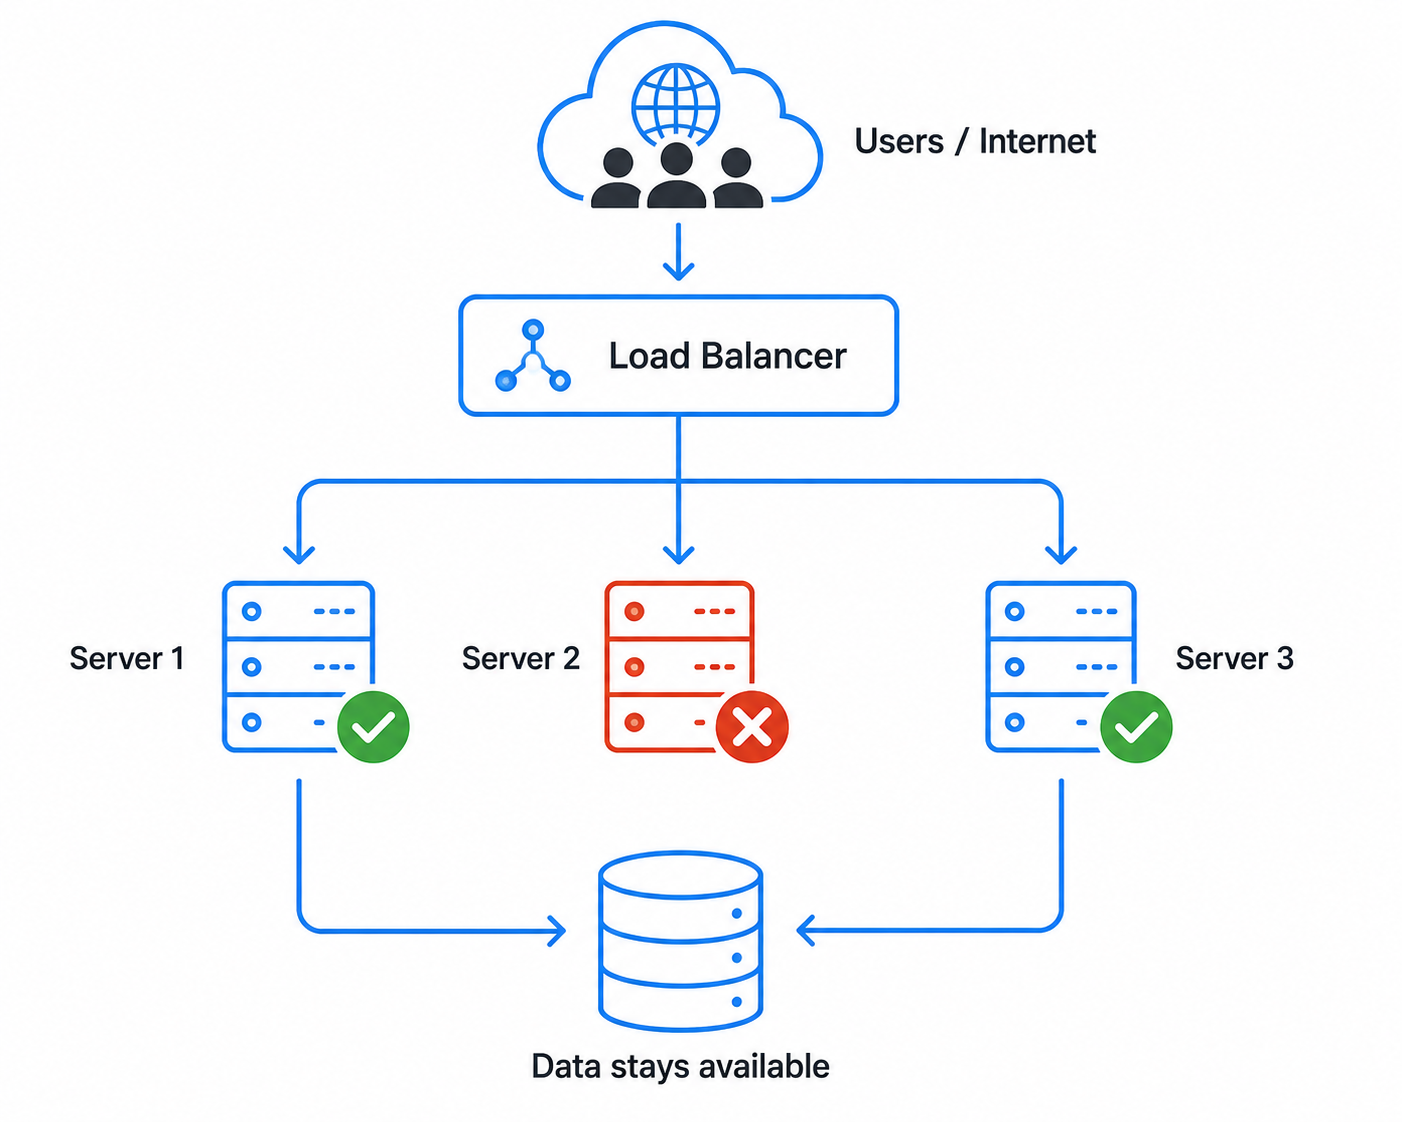
Os pontos únicos de falha são o que acabam com o tempo de atividade. Redundância significa que nenhum componente isolado — seja um servidor, um disco, uma fonte de alimentação ou um caminho de rede — pode, por si só, derrubar todo o sistema.
Os balanceadores de carga, que distribuem o tráfego por várias instâncias, bancos de dados replicados e implantações em múltiplas zonas, garantem a continuidade das operações quando um componente fica fora de serviço. As arquiteturas ativo-ativo podem reduzir a interrupção causada por uma transição de failover, embora tendam a ser mais complexas e mais caras do que as ativo-passivo; além disso, uma configuração ativo-passivo bem projetada também pode realizar a transição muito rapidamente.
A escolha depende do seu orçamento para tempo de inatividade e da meta de tempo de recuperação. Os bancos de dados merecem atenção especial, pois uma camada de aplicativos com três réplicas em bom estado conectadas a um banco de dados sem réplica ainda está a apenas uma tarde ruim de uma interrupção no serviço.
4. Faça backups regulares e testados
Backups são inúteis até que você faça uma restauração a partir de um deles. Muitas equipes só descobrem que seus backups vêm falhando silenciosamente no momento em que precisam deles. Execute-os automaticamente e com frequência, mantenha pelo menos uma cópia fora do local ou em uma conta separada e teste as restaurações de acordo com um cronograma. Essa última parte é a que costuma ser ignorada.
O ransomware tem como alvo específico os sistemas de backup; por isso, cópias imutáveis ou isoladas (air-gapped) são mais importantes do que antes.
5. Fortalecer a segurança para evitar interrupções causadas por ataques
Uma parcela significativa das paradas não planejadas tem origem em um invasor, seja um ataque DDoS, um ransomware ou um serviço comprometido que foi retirado do ar para limpeza. O fortalecimento de seus hosts reduz a superfície de ataque por meio do princípio do privilégio mínimo, regras de firewall, Fail2Ban e desativação de serviços que ninguém está usando.
Bom práticas de segurança do Linux e os patches atualizados, em conjunto, eliminam grande parte das oportunidades fáceis com as quais os invasores contam. Trate a segurança e o tempo de atividade como problemas intimamente ligados, pois um servidor comprometido se transforma rapidamente em um incidente de disponibilidade. Vulnerabilidades de alto impacto em softwares amplamente expostos atraem tentativas de exploração logo após a divulgação; portanto, qualquer pessoa que opere servidores voltados para o público precisa de uma maneira de agir rapidamente.
6. Planejar a capacidade do servidor e a margem de recursos
As interrupções causadas pelo esgotamento de recursos são autoinfligidas. Um sistema de arquivos que fica cheio, um pool de conexões que atinge o limite ou a memória que se esgota podem derrubar um serviço com a mesma eficácia que um disco com falha. Acompanhe as tendências de utilização, defina limites por carga de trabalho em vez de recorrer a um único valor universal e mantenha margem suficiente para absorver tanto um pico de tráfego esperado quanto a perda de um nó.
Planeje-se para os picos que você já conhece, como lançamentos de produtos e picos sazonais, antes que eles ocorram, e não durante. Se a capacidade de trabalho estiver constantemente sobrecarregada, isso é mais um problema de planejamento do que de infraestrutura.
7. Realizar auditorias de rotina e verificações de desempenho
A deriva é silenciosa — as configurações mudam, os certificados se aproximam do vencimento, os pacotes ficam desatualizados e pequenos problemas se acumulam até que um deles resulte em uma interrupção no serviço. As auditorias programadas, ou seja, revisões de configuração, análise de logs e linhas de base de desempenho, identificam esses problemas enquanto ainda são baratos de corrigir.
Veja o que mudou desde a última auditoria de segurança, e não apenas como está a situação atual. O objetivo é identificar os problemas que se desenvolvem gradualmente e que os alertas de limite não sinalizam até que as coisas já estejam dando errado.
8. Planeje e execute a manutenção de forma adequada
Uma manutenção mal conduzida é o que transforma uma janela de manutenção controlada em uma interrupção mais longa ou mesmo em uma interrupção não planejada. Escolha horários realmente tranquilos, informe as pessoas que precisam saber e tenha a reversão pronta antes de mexer em qualquer coisa.
Implemente mudanças em etapas com lançamentos “canário” ou “azul-verde”, de modo que uma versão com falha atinja apenas uma fração do seu tráfego, em vez de todo ele, e utilize verificações de integridade para controlar cada etapa. O objetivo é tornar o trabalho planejado rotineiro e reversível. Uma atualização de rotina nunca deve se transformar em um incidente.
9. Treine as equipes e documente seus manuais operacionais
As ferramentas não servem de nada se a pessoa de plantão não conhecer o sistema. Um manual de procedimentos documentado, que explique como reiniciar um serviço, onde a transição para o modo de failover está configurada e quem é responsável por cada tarefa, transforma uma correria às 2 da manhã em uma simples lista de verificação.
Mantenha seus procedimentos operacionais padrão, ou SOPs, atualizados e realize simulações de incidentes para que as ações corretas se tornem familiares antes que alguém precise recorrer a elas. Procedimentos documentados e ensaiados deixam muito menos margem para erros do que recorrer a lembranças vagas sob pressão. Treine novos engenheiros com base nesses documentos, em vez de se basear no “conhecimento tribal”.
10. Testar o failover e realizar exercícios de recuperação de desastres
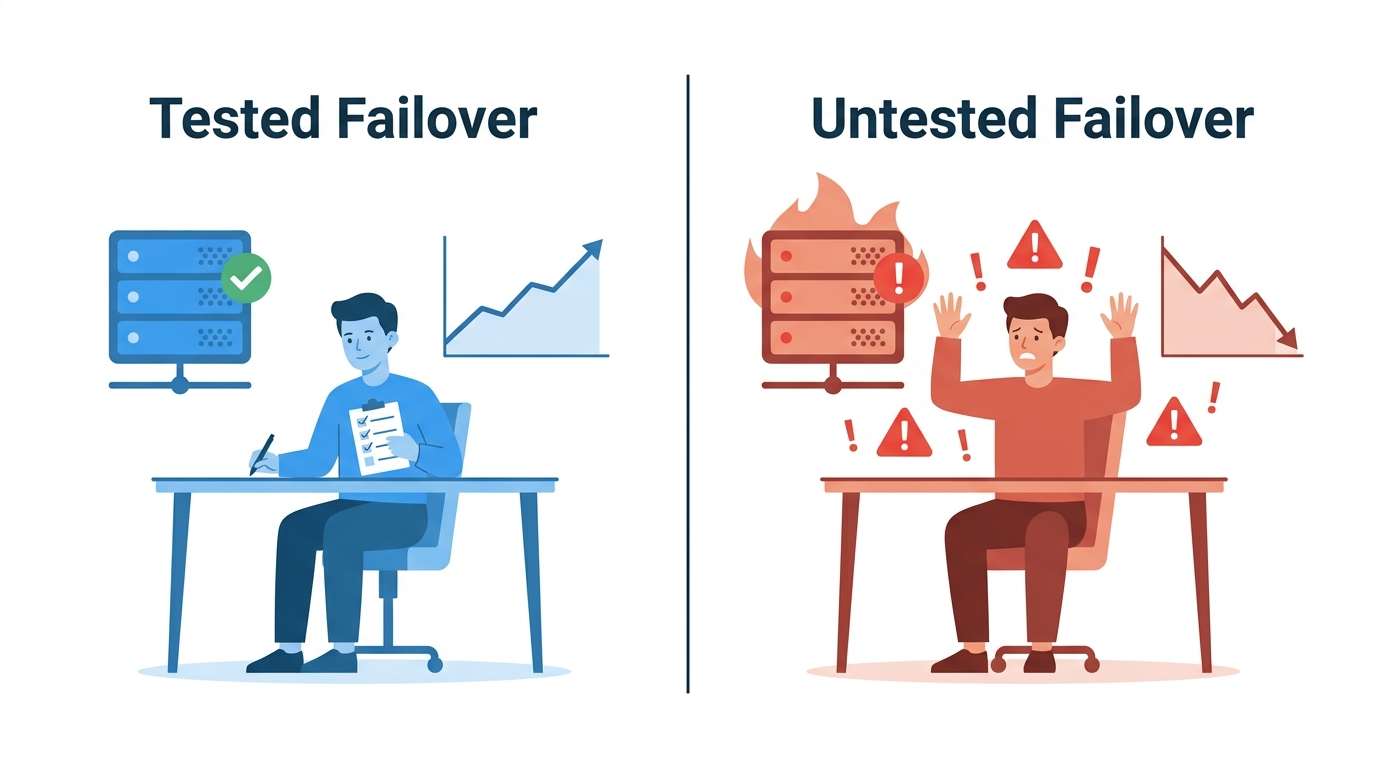
Um failover não testado é uma suposição. A única maneira de saber se sua redundância funciona é causar falhas deliberadamente. Desative um nó, execute o failover do banco de dados, simule uma interrupção na zona e, em seguida, observe o que realmente acontece. Realize simulados de recuperação de desastres (DR) em intervalos regulares e avalie o tempo real de recuperação em relação à sua meta.
Se você nunca testou o failover, presuma que ele não funciona até que se prove o contrário. Os testes de carga se enquadram nessa mesma categoria. Um balanceador de carga distribui o tráfego, mas você ainda precisa saber como o sistema se comporta quando dois nós ficam fora de serviço, em vez de apenas um. Testar em um cluster com capacidade reduzida permite saber se a capacidade restante é suficiente para absorver a carga ou se é necessário aumentar essa capacidade.
Por que a aplicação de patches é a solução que as equipes deixam para depois
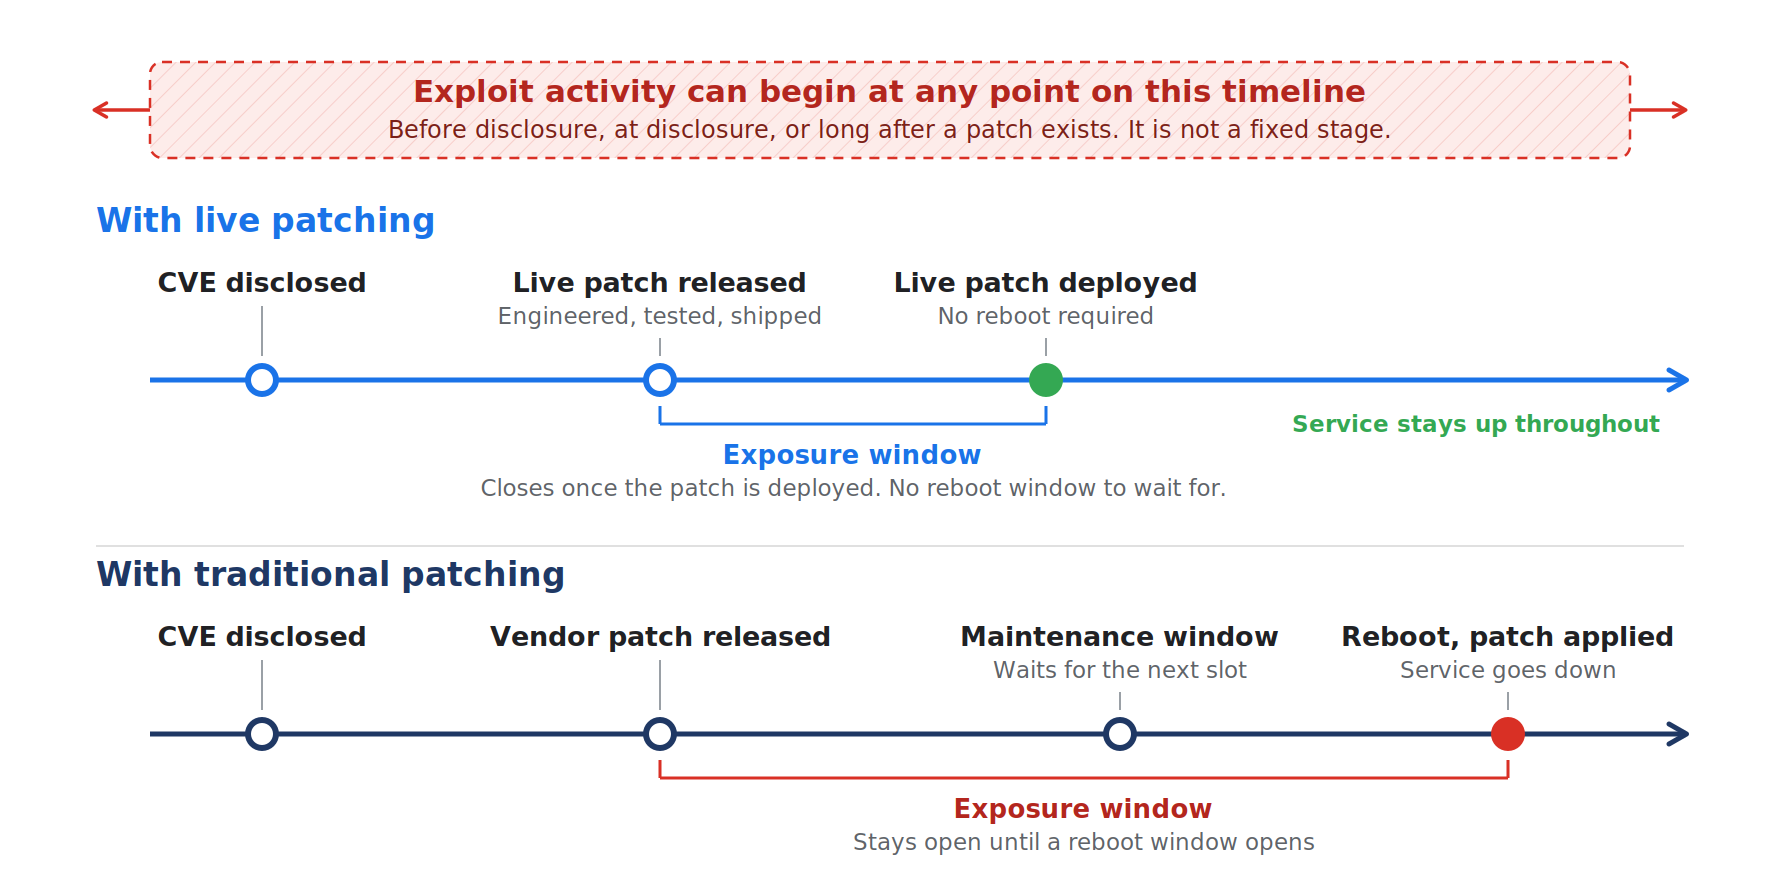
A aplicação de patches é uma das estratégias que as equipes mais costumam adiar, e o motivo não é nenhum mistério. O ciclo tradicional de aplicação de patches no kernel e reinicialização gera exatamente o tempo de inatividade que todos tentam evitar; por isso, a aplicação de patches é adiada e as vulnerabilidades CVE conhecidas permanecem em aberto. A mesma análise de 2026 observa que as operadoras estão transferindo cada vez mais seus investimentos para a automação e os sistemas de controle a fim de lidar com a crescente complexidade, ao mesmo tempo em que alerta que uma maior automação traz seus próprios tipos de problemas. Ambas as partes dessa afirmação são verdadeiras, e é por isso que a automação que vale a pena adotar é aquela que elimina a janela de manutenção, em vez de simplesmente reprogramá-la.
A aplicação automatizada de patches, sem necessidade de reinicialização, altera a dinâmica desse equilíbrio. Correções disponíveis para o CVE-s do kernel suportados pelo kernel podem ser aplicadas a sistemas em execução sem a necessidade de reinicialização e sem a necessidade de reservar um intervalo de manutenção. As correções são implementadas de forma consistente em toda a frota, em vez de servidor por servidor, e o intervalo entre o lançamento de uma correção e sua implantação pode ser reduzido de dias ou semanas para apenas algumas horas. A segurança dos servidores Linux melhora sem que seja necessário sacrificar o tempo de atividade para alcançar esse resultado.
Veja como a TuxCare ajuda a evitar tempo de inatividade
Prevenir o tempo de inatividade significa identificar problemas antecipadamente, incorporar redundância e corrigir vulnerabilidades antes que alguém as descubra, tudo isso sem precisar desligar os sistemas para realizar essas tarefas. É justamente nessa última parte que a maioria das equipes encontra dificuldades.
As ferramentas de aplicação de patches em tempo real da TuxCare aplicam correções de segurança compatíveis sem a necessidade de reinicialização. O KernelCare lida com os kernels compatíveis. O LibCare abrange bibliotecas compartilhadas críticas. Juntas, as correções compatíveis para o kernel e para bibliotecas compartilhadas críticas podem ser aplicadas sem a necessidade de uma janela de manutenção que exija reinicialização ou de uma reinicialização disruptiva dos aplicativos, o que significa que sua meta de tempo de atividade e sua postura de segurança deixam de entrar em conflito.
Se você quiser saber como a aplicação de patches em tempo real se adapta à sua configuração específica, nossos especialistas em segurança do Linux terão prazer em discutir o assunto com você.