Technischer Support
 Dokumentation
 Anmeldung
 Kontakt



Gehen Sie direkt zu einer KI-Zusammenfassung dieses Blogbeitrags 


Wichtigste Erkenntnisse
- Es sind immer wieder dieselben wenigen Ursachen, die auftreten, was bedeutet, dass ein Großteil des Ausfallrisikos vorhersehbar ist und gemindert werden kann.
- Überwachung, Redundanz, geprüfte Backups und automatisierte Patches tragen dazu bei, die Häufigkeit von Ausfällen zu verringern und deren Auswirkungen zu mindern.
- Das Installieren von Patches wird häufiger aufgeschoben, als die meisten Teams zugeben, obwohl es Tools wie KernelCare unterstützte Kernel-Korrekturen ohne Neustart anwenden.
- Legen Sie zunächst ein realistisches Verfügbarkeitsziel fest und entwickeln Sie dann ausgehend davon Ihren Prozess und Ihre Werkzeuge.
Jede Minute läuft Ihr Linux-Server ausfällt, geht etwas in den nachgelagerten Systemen kaputt. Checkouts schlagen fehl, Warnmeldungen häufen sich und der Pager von irgendjemandem hört nicht mehr auf zu piepen. Die Kurzfassung, wie man Serverausfälle verhindert: Behalten Sie die wichtigen Systeme im Auge, bauen Sie Redundanzen ein, installieren Sie Patches nach einem festen Zeitplan und halten Sie die Angriffsfläche klein. Im Folgenden finden Sie die Ursachen, die tatsächlich immer wieder auftreten, und die Lösungen, die sich in der Produktion bewähren – nicht diejenigen, die auf einer Folie gut aussehen.
Neustarts kosten echtes Geld. Sie werden in der Regel außerhalb der Spitzenzeiten geplant, und selbst dann bergen sie Risiken. Der Neustart selbst dauert vielleicht nur ein paar Minuten, aber das Hochfahren des Dienstes, das Aufwärmen des Caches, das Nachholen der Replikation und die Zustandsprüfungen können das Zeitfenster deutlich darüber hinaus verlängern. In der ITIC-Umfrage zu den stündlichen Ausfallkosten 2024schätzten über 90 % der mittelständischen und großen Unternehmen die Kosten für eine einzige Stunde Ausfallzeit auf über 300.000 US-Dollar. Erfreulich ist, dass ein Großteil dieses Risikos vermeidbar ist und viele patzbezogene Neustarts komplett entfallen können.
Was ist eine Serverausfallzeit?
Unter Serverausfall versteht man jeden Zeitraum, in dem ein Server seine Aufgaben nicht erfüllen kann – sei es das Bearbeiten von Anfragen, das Ausführen von Workloads oder einfach nur die Erreichbarkeit. Es gibt zwei Arten von Ausfällen. Geplante Ausfälle sind Wartungsfenster, die Sie selbst steuern können. Ungeplante Ausfälle sind diejenigen, die Sie um 2 Uhr morgens aus dem Schlaf reißen. Die zweite Art ist es, die den meisten Teams Sorgen bereitet – und das zu Recht.
Geplante Betriebsunterbrechung
Geplante Ausfallzeiten treten auf, wenn Administratoren Systeme bewusst offline schalten, um Wartungsarbeiten durchzuführen, Updates zu installieren, Hardware-Upgrades durchzuführen, Workloads zu migrieren oder Änderungen an der Infrastruktur vorzunehmen. Sie werden in der Regel für Zeiten mit geringem Datenverkehr eingeplant, wirken sich jedoch dennoch auf Nutzer, interne Teams und den Geschäftsbetrieb aus.
Ungeplante Ausfallzeiten
Von ungeplanten Ausfallzeiten spricht man, wenn Dienste ohne Vorwarnung ausfallen. Hardwareausfälle, Softwareabstürze, Sicherheitsverletzungen, Netzwerkprobleme, Ressourcenerschöpfung und Bedienungsfehler sind häufige Ursachen. Für die meisten Unternehmen stellt dies das größere Problem dar, da es unangekündigt auftritt und in der Regel sofortige Untersuchungen und Abhilfemaßnahmen erfordert.
Hinweis: Ein Serverausfall bedeutet nicht automatisch eine für den Benutzer sichtbare Ausfallzeit. Wenn Redundanz und Failover ihre Aufgabe erfüllen, merken die Nutzer davon nichts. Ausfälle treten dann auf, wenn es für einen Fehler keinen Ausweichpfad gibt, wenn das Failover zu langsam ist, um noch eine Rolle zu spielen, oder wenn der Fehler mehrere Komponenten gleichzeitig betrifft. Redundanz ist nur ein Teil der Lösung und nicht die gesamte Lösung – das sollten Sie bedenken, wenn Sie entscheiden, wo Sie Präventionsmaßnahmen einsetzen möchten.
Was führt zu Serverausfällen?
Trotz all dem, was Cloud-Infrastruktur und Automatisierung und Überwachung verändert haben, hat sich die Liste der Ursachen für Serverausfälle kaum verändert. Bei vielen der Ausfälle, mit denen die Teams tatsächlich konfrontiert sind, treten immer wieder dieselben technischen und betrieblichen Probleme auf.
| Ursache | Häufiger Auslöser | Schwerpunkt Prävention |
| Hardwarefehler | Festplatte, Netzteil oder Arbeitsspeicher fällt aus | Redundanz, Überwachung |
| Fehlerhafte Konfiguration und menschliches Versagen | Fehlerhafte Bereitstellung oder Regeländerung | Änderungskontrolle, Überprüfung |
| Nicht gepatchte CVEs und Angriffe | Bekannte Sicherheitslücken wurden ausgenutzt | Patches, Absicherung |
| Instabilität des Betriebssystems und der Software | Speicherleck, Kernel-Panic | Updates, Lebenszyklusmanagement, erweiterter Support |
| Netzwerkausfall | DNS, Routing, abgelaufenes Zertifikat | Redundante Pfade, Zertifikatswarnungen |
| Erschöpfung der Ressourcen | Verkehrsspitzen, volle Festplatte, maximaler Verbindungspool | Kapazitätsplanung, Spielraum |
Hardwarefehler
Festplatten gehen kaputt, Netzteile fallen aus, Arbeitsspeicher versagen, Lüfter geben den Geist auf. Hardware ist die offensichtlichste Ursache und diejenige, auf die die meisten Teams bereits vorbereitet sind. Der Haken daran ist, dass bereits eine einzige nicht redundante Komponente – eine Festplatte oder eine Stromversorgung – das gesamte System allein außer Betrieb setzen kann.
Fehlerhafte Konfiguration und menschliches Versagen
Eine falsch eingegebene Firewall-Regel, eine fehlerhafte DNS-Änderung, eine Bereitstellung, bei der ein Zustandscheck übersprungen wird. Menschliches Versagen steckt hinter einem Großteil der Ausfälle, wobei es meist bereits ein anderes Gesicht angenommen hat, wenn die Nachanalyse verfasst wird. Durch Änderungskontrolle und Peer-Review werden viele dieser Fehler abgefangen, bevor sie in die Produktion gelangen, und das Patch-Management Automatisierung hilft aus demselben Grund, denn sie eliminiert die manuellen Schritte, bei denen Fehler entstehen.
Nicht behobene Sicherheitslücken und Cyberangriffe
Nicht gepatcht Linux-Sicherheitslücken sind eine offene Tür. Angreifer können eine bekannte CVE ausnutzen, noch bevor viele Unternehmen den verfügbaren Patch installiert haben, und zahlreiche erfolgreiche Angriffe führen zu Ausfallzeiten, wobei Ransomware und DDoS als offensichtliche Beispiele.
Sich über Sicherheitspatches werden die kostengünstigsten Angriffspunkte beseitigt. Der Schaden beschränkt sich zudem selten auf den Ausfall selbst, da regulatorische Risiken, Kundenverluste und Reputationsschäden den Vorfall selbst überdauern.
Instabilität von Betriebssystemen und Software
Speicherlecks, Kernel-Panics, außer Kontrolle geratene Prozesse, Abhängigkeitskonflikte. Softwareverfall schleicht sich unbemerkt ein, bis ein Dienst abstürzt oder der Host sich aufhängt. Software am Ende ihrer Lebensdauer erschwert dies zusätzlich, da keine Sicherheits- und Fehlerbehebungen mehr vom Hersteller bereitgestellt werden und bekannte Probleme ungelöst bleiben, sofern kein alternativer Supportweg vorhanden ist.
Netzwerkausfälle
DNS-Ausfälle, Routing-Probleme, abgelaufene Zertifikate, Probleme bei Upstream-Anbietern. Ihr Server kann in einwandfreiem Zustand sein und dennoch nicht erreichbar sein. Diese Probleme lassen sich leicht übersehen, da der Host auf allen Ihren Dashboards einwandfrei aussieht, während die Nutzer nichts erhalten.
Achtung: Abgelaufene TLS-Zertifikate verursachen mehr unerklärliche Ausfälle, als man zugeben möchte. Richten Sie Benachrichtigungen zum Ablauf von Zertifikaten 30 Tage und 7 Tage im Voraus ein – nicht erst am Morgen, an dem es schon zu einem Ausfall kommt.
Überlastung der Ressourcen
Wenn die Nachfrage die verfügbaren Ressourcen übersteigt, verschlechtert sich die Leistung, bis Anfragen fehlschlagen, Prozesse beendet werden oder der Dienst einfach nicht mehr reagiert. Die Cloud-Infrastruktur kann zwar so konfiguriert werden, dass sie sich dynamisch skaliert, doch muss dennoch jemand sicherstellen, dass die Kapazität dem tatsächlichen Bedarf der Anwendung entspricht. Traffic-Spitzen, Wiederholungsstürme von Nutzern, die einen beeinträchtigten Dienst überlasten, und ein einziger „Noisy Neighbor“ auf einem gemeinsam genutzten Host können allesamt eine Kettenreaktion auslösen.
Was Ausfallzeiten kosten und was Ihr SLA zulässt
Ihr Verfügbarkeitsziel ist im Grunde genommen ein Budget für Ausfälle. Hier erfahren Sie, was Ihnen die einzelnen Stufen bieten.
| SLA zur Verfügbarkeit | Ausfallzeit pro Jahr | Ausfallzeit pro Monat |
| 99% | 3,65 Tage | 7,31 Stunden |
| 99.9% | 8,77 Stunden | 43,8 Minuten |
| 99.99% | 52,6 Minuten | 4,38 Minuten |
| 99.999% | 5,26 Minuten | 26,3 Sekunden |
Patches verursachen ihre eigenen Ausfallkosten, und die Bewältigung von Ausfällen wird immer teurer. Die Jahresanalyse zu Ausfällen 2026 des Uptime Institute, dass 57 % der Betreiber ihren letzten größeren Ausfall auf über 100.000 US-Dollar bezifferten und zum zweiten Mal in Folge jeder Fünfte die Kosten auf über 1 Million US-Dollar schätzte, obwohl die Ausfallhäufigkeit pro Standort das fünfte Jahr in Folge zurückging. Weniger Ausfälle, die jedoch jeweils höhere Kosten verursachen, sind ein schlechtes Geschäft für alle, deren Patch-Prozess nach wie vor auf die Einplanung von Ausfallzeiten angewiesen ist.
Wie man Auszeiten plant, ohne es später zu bereuen
Früher oder später muss man Ausfallzeiten einplanen, sei es für eine Code-Bereitstellung, Hardware-Änderungen, Konfigurationsaktualisierungen oder eine Servermigration. Zeiten außerhalb der Spitzenzeiten sind die naheliegende Wahl, aber es gibt mehr Spielraum für eine straffere Planung, als die meisten Teams nutzen.
Beginnen Sie mit den Backups. Stellen Sie sicher, dass diese aktuell, getestet und tatsächlich erreichbar sind, denn wenn Sie mitten im Rollback feststellen, dass Ihr Backup nie validiert wurde, wird aus einem Problem gleich zwei. Überprüfen Sie dann vor Beginn den freien Speicherplatz auf den Festplatten und die aktuelle Ressourcenauslastung, da ein fast volles Dateisystem oder ein Server, der bereits um Arbeitsspeicher kämpft, ein Routine-Update in einen Vorfall verwandeln kann. Und testen Sie zunächst in der Staging-Umgebung, selbst bei kleinen Änderungen. Gerade bei kleinen Änderungen, da diese oft ohne weitere Prüfung durchgewunken werden.
10 wichtige Strategien zur Vermeidung von Serverausfällen
Es gibt keine einzelne Lösung, die eine hohe Verfügbarkeit gewährleistet. Vielmehr ist es eine Kombination aus Gewohnheiten und Tools, die zusammenwirken. Alle im Folgenden aufgeführten Maßnahmen bewähren sich unter realer Produktionslast und sind in etwa in der Reihenfolge aufgeführt, in der die meisten Teams sie umsetzen sollten.
1. Kontinuierliche Überwachung und frühzeitige Warnmeldungen aktivieren
Was man nicht sieht, kann man auch nicht verhindern. Eine kontinuierliche Überwachung von CPU, Arbeitsspeicher, Festplatte, Netzwerk und Service-Level-Prüfungen bildet die Grundlage, auf der alles andere aufbaut. Das Ziel ist nicht eine Flut von Dashboards, sondern Warnmeldungen, die ausgelöst werden, bevor jemand außerhalb des Teams etwas bemerkt.
Legen Sie Schwellenwerte für Frühindikatoren fest, wie beispielsweise eine Festplatte, die sich dem Füllstand „voll“ nähert, oder eine schleichend steigende Speicherauslastung, und nicht nur für schwerwiegende Ausfälle. Wenn Ihre Warnmeldungen erst dann ausgelöst werden, wenn etwas bereits ausgefallen ist, berichten sie lediglich über bereits Geschehenes.
Wenn Sie in der Flut von Meldungen untergehen, verschärfen Sie die Schwellenwerte und leiten Sie die Meldungen nach Schweregrad weiter. Und sobald Sie die Marke von einigen hundert Servern überschritten haben, überprüfen Sie Ihre Infrastruktur regelmäßig, um sicherzustellen, dass nichts unbemerkt aus der Überwachung herausgefallen ist – denn ein nicht überwachter Host ist ein blinder Fleck, der Ihnen irgendwann zum Verhängnis werden wird.
Profi-Tipp: Achten Sie auf die Änderungsrate, nicht nur auf absolute Werte. Eine Festplatte, deren Auslastung konstant bei 70 % liegt, ist möglicherweise weniger dringlich als eine, deren Auslastung innerhalb einer Stunde von 40 % auf 70 % gesprungen ist, und die Änderungsrate deckt Probleme auf, die ein statischer Schwellenwert übersieht.
2. Automatisierung der Server-Patches
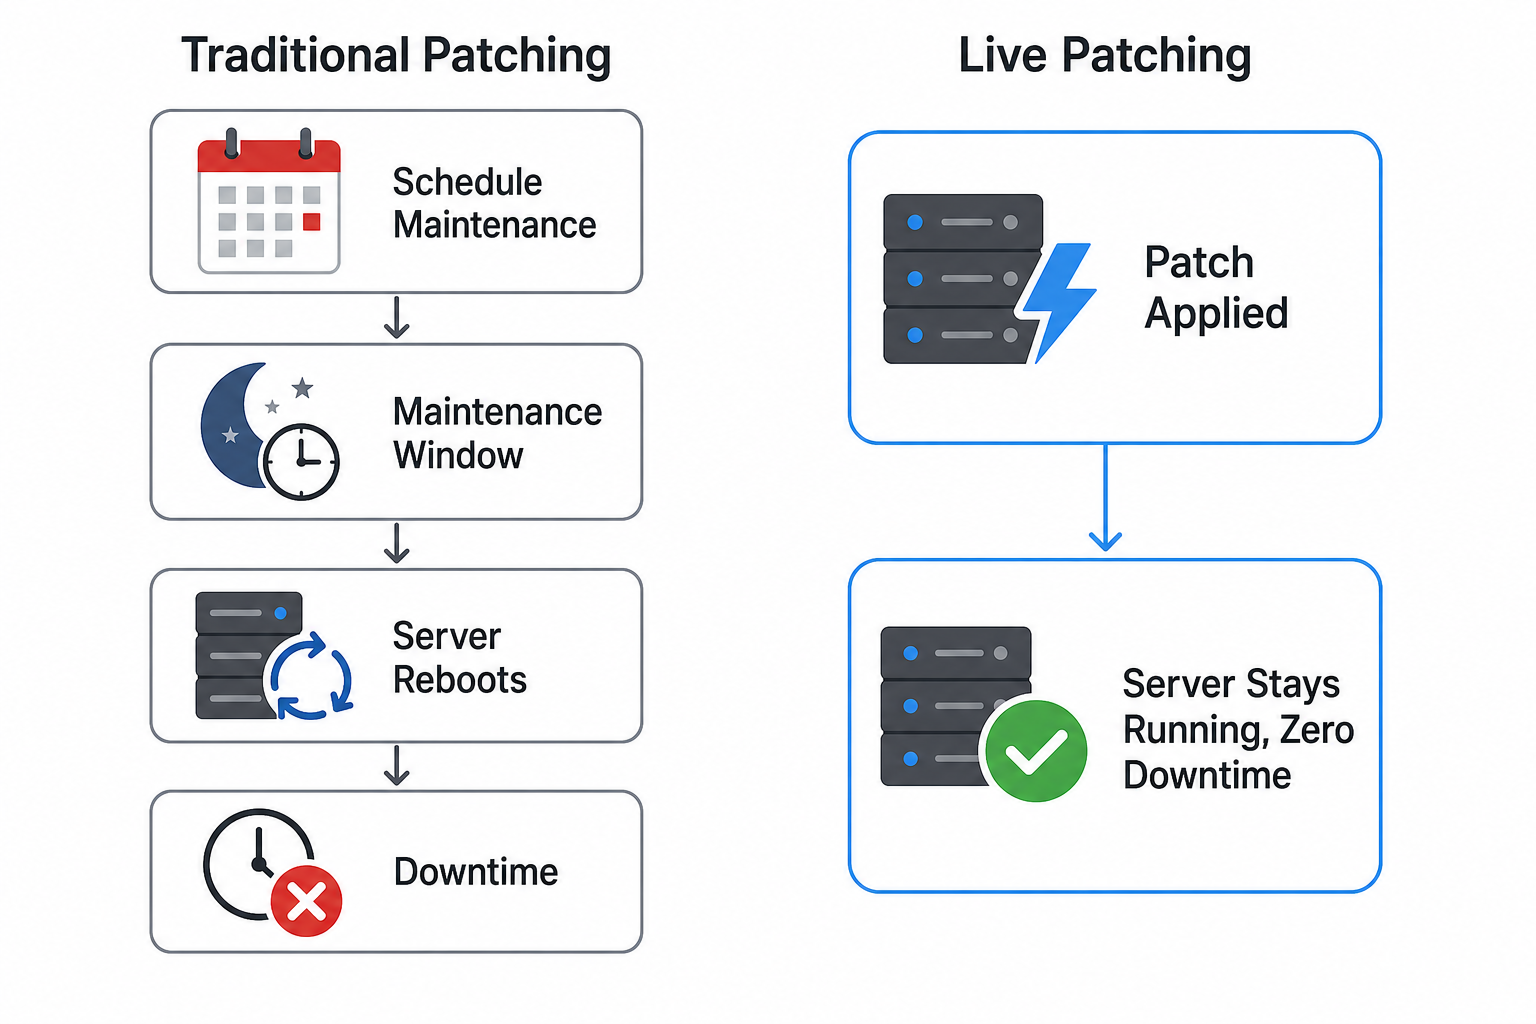
Manuelles Patchen wird bei großem Umfang unüberschaubar, und Kernel-Updates, die einen Neustart erfordern, verursachen ihrerseits geplante Ausfallzeiten. Das führt zu einem Spannungsfeld, das die meisten Teams nur allzu gut kennen: Das schnelle Patchen und die Aufrechterhaltung der Serviceverfügbarkeit können sich gegenseitig ins Gegenteil verkehren, insbesondere bei Systemen, bei denen Wartungsfenster nur schwer zu realisieren sind.
Automatisierung der Patch-Bereitstellung sorgt dafür, dass verfügbare CVE-Korrekturen schneller und einheitlicher auf allen Systemen einer gesamten Infrastruktur bereitgestellt werden. Der größte Vorteil besteht darin, dass ein Neustart – wo immer möglich – entfällt. Live-Patching (auch als „rebootless patching“ bekannt) wendet Kernel-Korrekturen auf ein laufendes System an, ohne es neu zu starten. KernelCare von TuxCare erledigt dies für unterstützte Linux-Kernel, während LibCare dieses Konzept auf kritische gemeinsam genutzte Bibliotheken wie glibc und OpenSSL aus.
Verzögerte Sicherheitspatches tragen maßgeblich zu Ausfällen bei, und die Zahlen entwickeln sich in die falsche Richtung. Laut Verizons DBIR 2026ist die Ausnutzung von Sicherheitslücken mit 31 % mittlerweile der häufigste Erstzugangsweg für Sicherheitsverletzungen – ein Anstieg gegenüber 20 % im Vorjahr und zum ersten Mal in der 19-jährigen Geschichte des Berichts hat dieser Weg den Missbrauch von Zugangsdaten überholt. Bei der Behebung der Schwachstellen ging der Trend in die entgegengesetzte Richtung. Nur 26 % der Einträge zu den „CISA Known Exploited Vulnerabilities“ (KEV), die in den von Verizon untersuchten Umgebungen gefunden wurden, waren im Jahr 2025 vollständig behoben – ein Rückgang von 38 % –, und die mittlere Zeit bis zur vollständigen Behebung verlängerte sich von 32 auf 43 Tage. Durch Automatisierung lässt sich diese Lücke schließen, ohne dass dies zu Lasten der Verfügbarkeit geht.
3. Redundanz und Ausfallsicherung in die Architektur integrieren
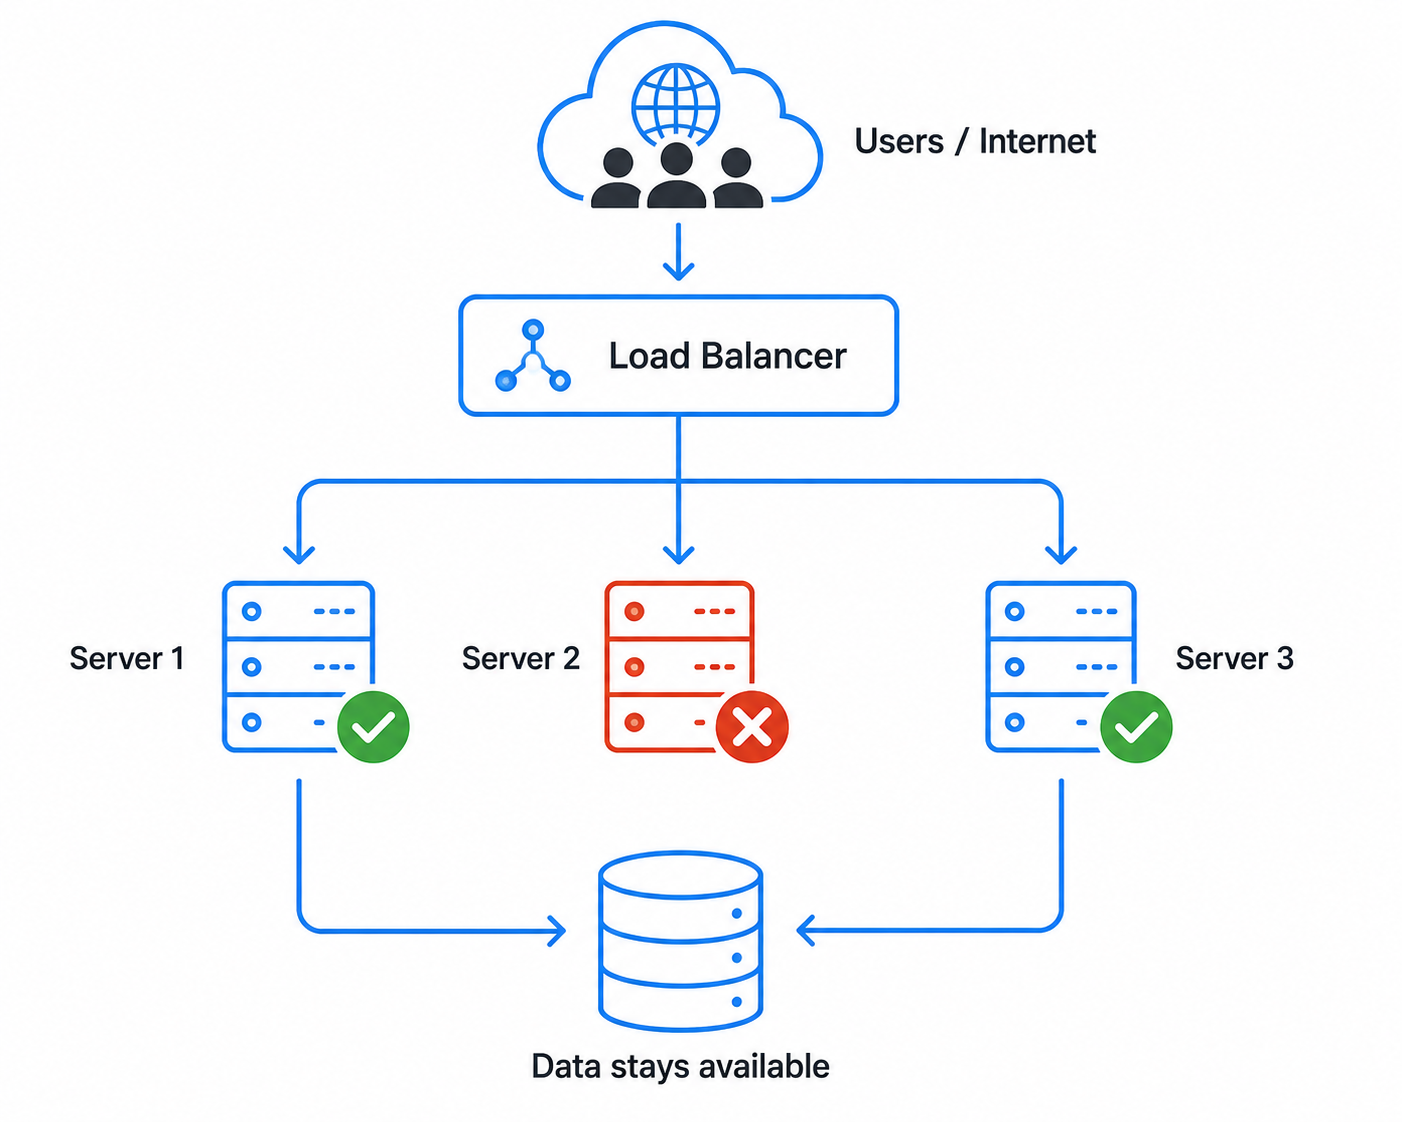
Einzelne Schwachstellen sind der Grund, warum die Verfügbarkeit leidet. Redundanz bedeutet, dass keine einzelne Komponente – sei es ein Server, eine Festplatte, eine Stromversorgung oder ein Netzwerkpfad – das gesamte System im Alleingang lahmlegen kann.
Lastenausgleichssysteme, die den Datenverkehr auf mehrere Instanzen verteilen, replizierte Datenbanken und zonenübergreifende Bereitstellungen sorgen dafür, dass der Betrieb auch dann weiterläuft, wenn eine Komponente ausfällt. Aktiv-Aktiv-Konfigurationen können die durch ein Failover verursachten Unterbrechungen minimieren, sind jedoch in der Regel komplexer und kostspieliger als Aktiv-Passiv-Konfigurationen, und eine gut konzipierte Aktiv-Passiv-Konfiguration kann ebenfalls sehr schnell umschalten.
Welche Variante Sie benötigen, hängt von Ihrem Ausfallzeitbudget und Ihrem angestrebten Wiederherstellungszeitraum ab. Datenbanken verdienen besondere Aufmerksamkeit, denn eine Anwendungsebene mit drei funktionsfähigen Replikaten, die einer nicht replizierten Datenbank vorgeschaltet sind, ist immer noch nur einen einzigen missglückten Nachmittag von einem Ausfall entfernt.
4. Führen Sie regelmäßig bewährte Datensicherungen durch
Sicherungen sind nutzlos, bis man eine Wiederherstellung aus einem Backup durchgeführt hat. Viele Teams stellen erst in dem Moment fest, dass ihre Backups unbemerkt fehlgeschlagen sind, wenn sie sie tatsächlich benötigen. Führen Sie Backups automatisch und regelmäßig durch, bewahren Sie mindestens eine Kopie außerhalb des Standorts oder in einem separaten Konto auf und testen Sie die Wiederherstellung regelmäßig. Gerade dieser letzte Schritt wird oft übersprungen.
Ransomware zielt gezielt auf Backup-Systeme ab, weshalb unveränderliche oder luftisolierte Kopien heute wichtiger sind als früher.
5. Die Sicherheit stärken, um durch Angriffe verursachte Ausfälle zu verhindern
Ein erheblicher Teil der ungeplanten Ausfallzeiten ist auf Angreifer zurückzuführen, sei es durch DDoS-Angriffe, Ransomware oder kompromittierte Dienste, die zur Bereinigung offline genommen werden. Die Absicherung Ihrer Hosts verringert die Angriffsfläche durch das Prinzip der geringsten Berechtigungen, Firewall-Regeln, Fail2Ban und das Deaktivieren von Diensten, die niemand nutzt.
Gut Linux-Sicherheitspraktiken und aktuelle Patches beseitigen gemeinsam viele der einfachen Angriffsmöglichkeiten, auf die Angreifer setzen. Behandeln Sie Sicherheit und Betriebsverfügbarkeit als eng miteinander verbundene Aspekte, denn ein kompromittierter Server führt schnell zu einem Verfügbarkeitsvorfall. Schwerwiegende Sicherheitslücken in weit verbreiteter Software ziehen nach ihrer Offenlegung schnell Exploit-Versuche nach sich, daher benötigt jeder, der öffentlich zugängliche Server betreibt, die Möglichkeit, schnell zu handeln.
6. Serverkapazität und Ressourcenreserven planen
Ausfälle aufgrund von Ressourcenerschöpfung sind selbstverschuldet. Ein volles Dateisystem, ein Verbindungspool, der seine Kapazitätsgrenze erreicht, oder knapp werdender Arbeitsspeicher können einen Dienst genauso effektiv lahmlegen wie eine ausgefallene Festplatte. Verfolgen Sie die Auslastungstrends, legen Sie Schwellenwerte pro Workload fest, anstatt sich auf einen einheitlichen Wert zu verlassen, und halten Sie genügend Spielraum vor, um sowohl erwartete Traffic-Spitzen als auch den Ausfall eines Knotens abzufangen.
Planen Sie bereits im Vorfeld und nicht erst währenddessen für die Ihnen bereits bekannten Spitzenzeiten, wie beispielsweise Produkteinführungen und saisonale Spitzen. Wenn die Kapazitäten ständig überlastet sind, handelt es sich eher um ein Planungsproblem als um ein Infrastrukturproblem.
7. Regelmäßige Audits und Leistungsprüfungen durchführen
Drift ist der stille Übeltäter – Konfigurationen ändern sich, Zertifikate nähern sich ihrem Ablaufdatum, Pakete geraten in Verzug und kleine Probleme häufen sich an, bis eines davon zu einem Ausfall führt. Regelmäßige Audits, also Konfigurationsüberprüfungen, Protokollanalysen und Leistungs-Baselines, decken diese Probleme auf, solange ihre Behebung noch kostengünstig ist.
Sehen Sie sich an, was sich seit der letzten Sicherheitsauditgeändert hat, und nicht nur darauf, wie der aktuelle Zustand aussieht. Es geht darum, die sich langsam entwickelnden Probleme aufzudecken, die von Schwellenwertwarnungen erst dann gemeldet werden, wenn bereits etwas schiefgelaufen ist.
8. Wartungsarbeiten ordnungsgemäß planen und durchführen
Eine schlecht durchgeführte Wartung führt dazu, dass aus einem kontrollierten Wartungsfenster ein längerer oder gar ein ungeplanter Ausfall wird. Wählen Sie Zeiten, in denen wirklich wenig los ist, informieren Sie die zuständigen Personen und halten Sie die Rollback-Maßnahmen bereit, bevor Sie irgendetwas anfassen.
Führen Sie stufenweise Änderungen mit „Canary“- oder „Blue-Green“-Deploys durch, damit bei einer fehlerhaften Version nur ein Bruchteil Ihres Datenverkehrs betroffen ist und nicht der gesamte, und nutzen Sie Zustandsprüfungen, um jeden Schritt zu kontrollieren. Das Ziel ist es, geplante Arbeiten unspektakulär und rückgängig machbar zu gestalten. Ein routinemäßiges Update sollte niemals zu einem Vorfall eskalieren.
9. Schulen Sie Ihre Teams und dokumentieren Sie Ihre Runbooks
Technische Hilfsmittel nützen nichts, wenn der Diensthabende das System nicht kennt. Ein dokumentiertes Runbook, in dem beschrieben ist, wie ein Dienst neu gestartet wird, wo das Failover konfiguriert ist und wer für was zuständig ist, verwandelt eine hektische Situation um 2 Uhr morgens in eine einfache Checkliste.
Halten Sie Ihre Standardarbeitsanweisungen (SOPs) auf dem neuesten Stand und führen Sie Notfallübungen durch, damit die richtigen Maßnahmen vertraut sind, bevor sie einmal benötigt werden. Dokumentierte und einstudierte Abläufe lassen weitaus weniger Raum für Fehler als vage Erinnerungen unter Druck. Schulen Sie neue Ingenieure anhand dieser Dokumente und nicht anhand von „Stammwissen“.
10. Failover testen und Notfallwiederherstellungsübungen durchführen
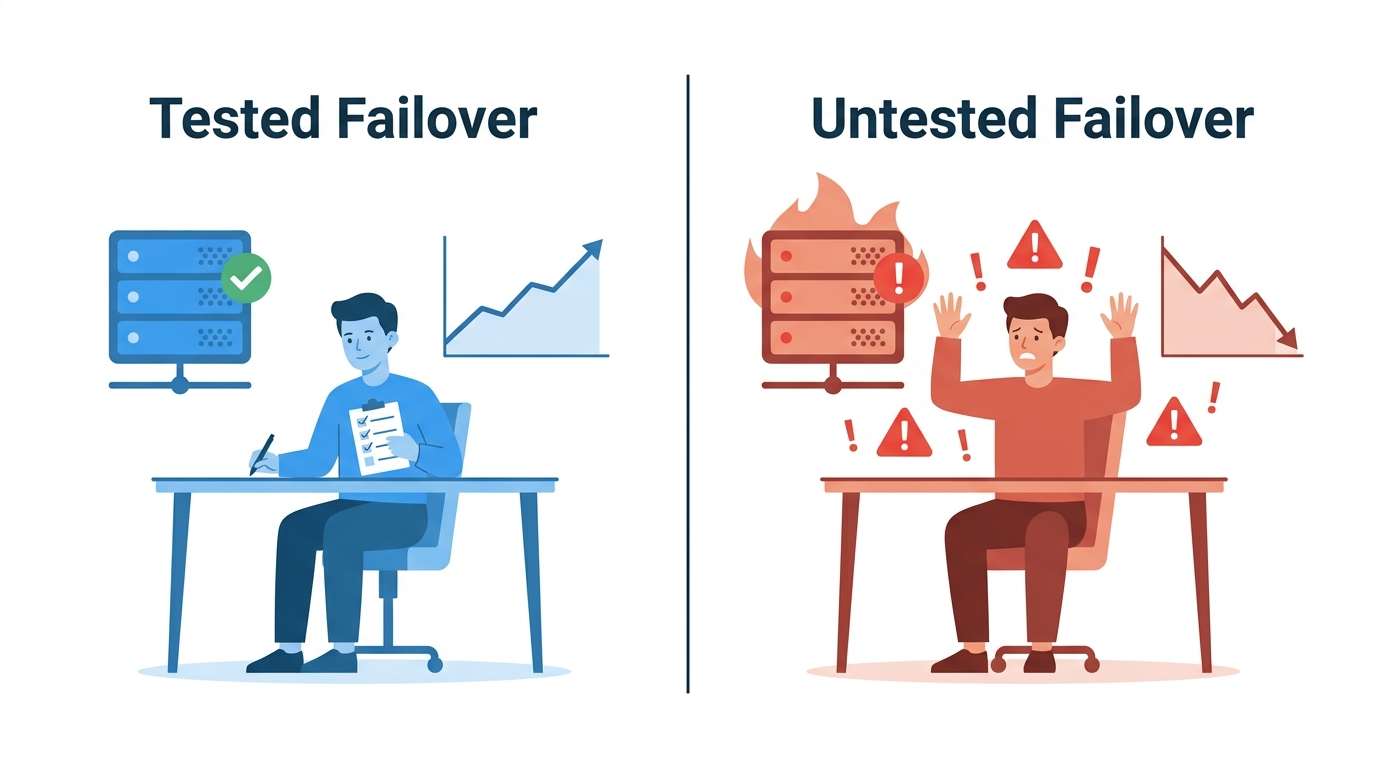
Ein ungetestetes Failover ist reine Spekulation. Die einzige Möglichkeit, festzustellen, ob Ihre Redundanz funktioniert, besteht darin, absichtlich Störungen zu verursachen. Schalten Sie einen Knoten ab, führen Sie ein Failover der Datenbank durch, simulieren Sie einen Zonenausfall und beobachten Sie dann, was tatsächlich passiert. Führen Sie regelmäßig DR-Übungen durch und vergleichen Sie die tatsächliche Wiederherstellungszeit mit Ihrem Zielwert.
Wenn Sie das Failover noch nie getestet haben, gehen Sie davon aus, dass es nicht funktioniert, bis das Gegenteil bewiesen ist. Das gleiche gilt für Lasttests. Ein Load Balancer verteilt den Datenverkehr, aber Sie möchten dennoch wissen, wie sich das System verhält, wenn nicht nur ein Knoten, sondern zwei ausfallen. Durch Tests mit einem Cluster in eingeschränkter Betriebsfähigkeit können Sie feststellen, ob die verbleibende Kapazität die Last auffangen kann oder ob Sie mehr Kapazität benötigen.
Warum das Installieren von Patches die Lösung ist, die Teams immer wieder aufschieben
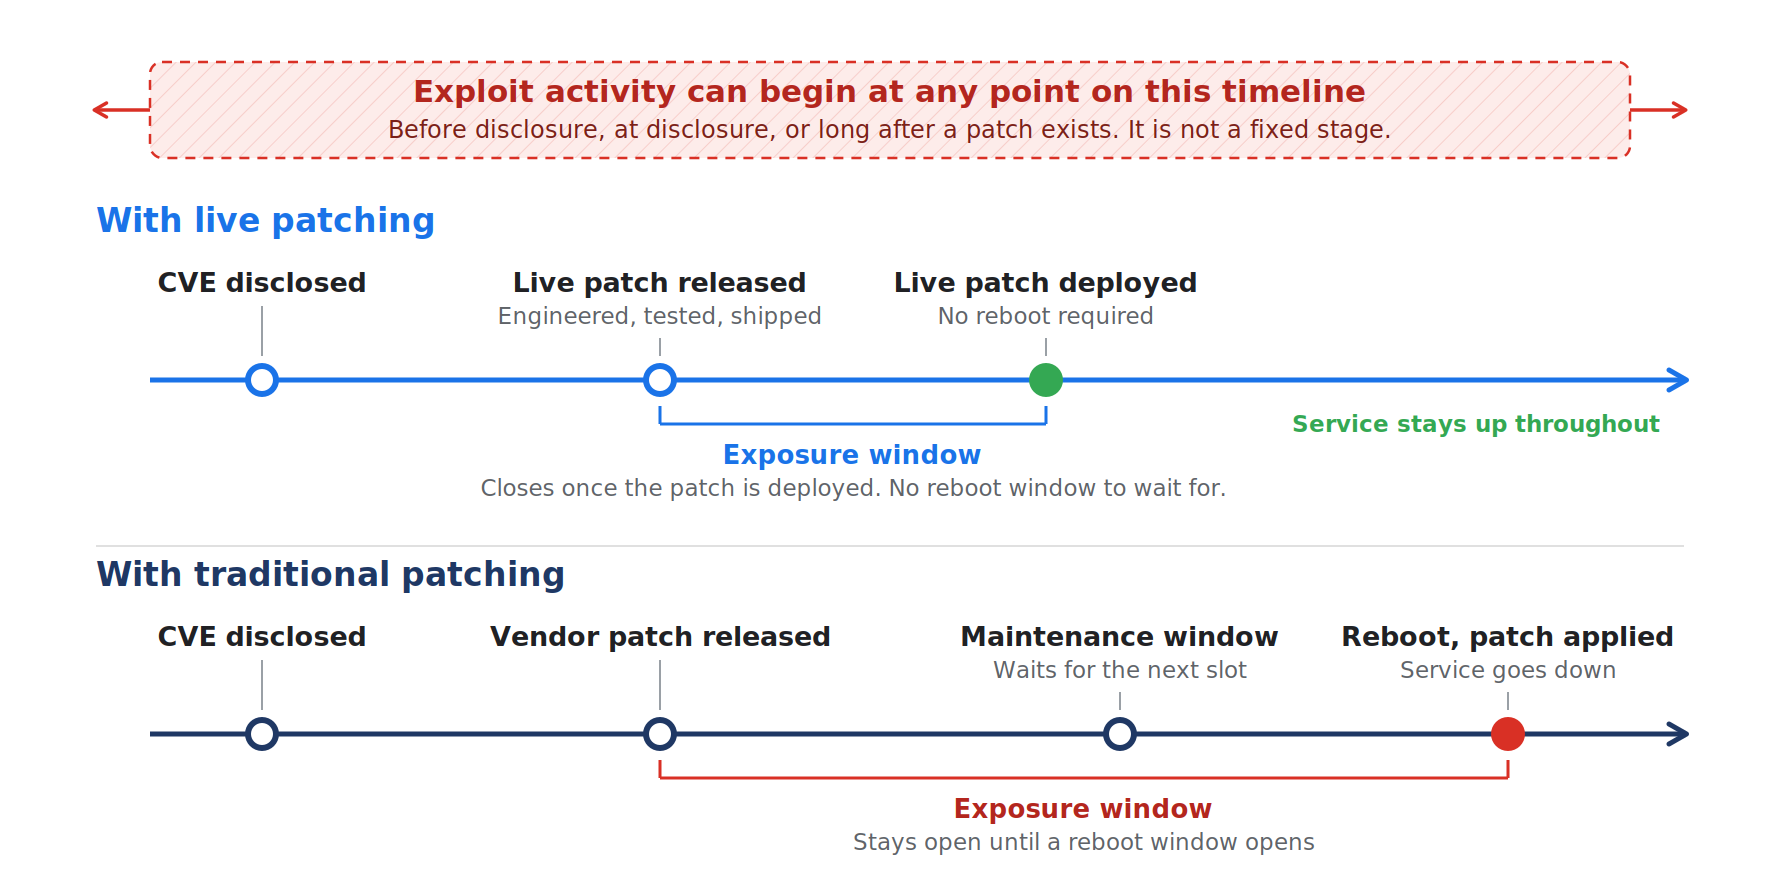
Das Installieren von Patches gehört zu den Maßnahmen, die Teams am häufigsten aufschieben, und der Grund dafür ist kein Geheimnis. Der herkömmliche Zyklus aus Kernel-Patch und Neustart führt genau zu den Ausfallzeiten, die jeder zu vermeiden versucht, sodass Patches aufgeschoben werden und bekannte CVEs offen bleiben. Die gleiche Analyse aus dem Jahr 2026 wird darauf hingewiesen, dass Betreiber ihre Investitionen zunehmend in Automatisierungs- und Steuerungssysteme verlagern, um der steigenden Komplexität gerecht zu werden, wobei gleichzeitig davor gewarnt wird, dass mehr Automatisierung ihre eigenen Probleme mit sich bringt. Beides trifft zu, weshalb sich eine Automatisierung nur dann lohnt, wenn sie das Wartungsfenster vollständig beseitigt, anstatt es lediglich zu verschieben.
Automatisierte, rebootfreie Patches verändern das Verhältnis zwischen Kosten und Nutzen. Verfügbare Korrekturen für unterstützte Kernel-CVEs können ohne Neustart und ohne Planung eines Wartungsfensters auf laufende Systeme angewendet werden. Patches werden einheitlich über die gesamte Serverflotte hinweg bereitgestellt, anstatt Server für Server, und die Zeitspanne zwischen der Veröffentlichung eines Patches und seiner Bereitstellung kann von Tagen oder Wochen auf Stunden verkürzt werden. Die Sicherheit von Linux-Servern verbessert sich, ohne dass dafür die Betriebszeit geopfert werden muss.
Erfahren Sie, wie TuxCare Ihnen hilft, Ausfallzeiten zu vermeiden
Um Ausfallzeiten zu vermeiden, kommt es darauf an, Probleme frühzeitig zu erkennen, Redundanzen einzubauen und Schwachstellen zu schließen, bevor jemand anderes sie entdeckt – und das alles, ohne die Systeme dafür offline nehmen zu müssen. Genau an dieser letzten Stelle kommen die meisten Teams ins Stocken.
Die Live-Patching-Tools von TuxCare installieren unterstützte Sicherheitspatches, ohne dass ein Neustart erforderlich ist. KernelCare kümmert sich um unterstützte Kernel. LibCare deckt kritische gemeinsam genutzte Bibliotheken ab. Durch das Zusammenspiel dieser Tools können unterstützte Korrekturen am Kernel und an kritischen gemeinsam genutzten Bibliotheken ohne ein durch einen Neustart bedingtes Wartungsfenster oder einen störenden Neustart der Anwendungen durchgeführt werden, was bedeutet, dass Ihr Verfügbarkeitsziel und Ihre Sicherheitslage nicht länger im Widerspruch zueinander stehen.
Wenn Sie herausfinden möchten, wie sich Live-Patching in Ihre individuelle Konfiguration einfügt, bieten unsere Linux-Sicherheitsexperten besprechen das gerne mit Ihnen.