Support technique
 Documentation
 Connexion
 Nous contacter



Accédez directement au résumé généré par l'IA de cet article de blog 


Principaux enseignements
- Ce sont toujours les mêmes causes qui reviennent sans cesse, ce qui signifie qu'une grande partie des risques d'indisponibilité peut être anticipée et atténuée.
- La surveillance, la redondance, les sauvegardes testées et l'application automatisée des correctifs permettent toutes de réduire la fréquence des pannes et leur impact.
- L'application des correctifs est souvent reportée, bien plus que la plupart des équipes ne veulent bien l'admettre, même si des outils tels que KernelCare permettent d'appliquer les correctifs pris en charge du noyau sans redémarrage.
- Commencez par définir un objectif réaliste en matière de disponibilité, puis élaborez votre processus et vos outils en partant de cet objectif.
Chaque minute, votre serveur Linux est hors service, quelque chose se brise en aval. Les commandes échouent, les alertes s’accumulent et le bipeur de quelqu’un ne cesse de sonner. En bref, voici comment éviter les temps d’arrêt du serveur : surveillez les systèmes qui comptent, intégrez de la redondance, appliquez les correctifs selon un calendrier et réduisez la surface d’attaque. Vous trouverez ci-dessous les causes qui reviennent réellement et les solutions qui font leurs preuves en production, et non celles qui font bonne impression sur une diapositive.
Les redémarrages ont un coût réel. Ils sont généralement programmés en dehors des heures de pointe, mais même dans ce cas, ils comportent des risques. Le redémarrage en lui-même ne dure peut-être que quelques minutes, mais la mise en service, la mise à jour du cache, la synchronisation de la réplication et les contrôles d’intégrité peuvent prolonger la durée de l’opération bien au-delà. Dans enquête de l’ITIC de 2024 sur le coût horaire des temps d’arrêt, plus de 90 % des moyennes et grandes entreprises estiment le coût d’une seule heure d’indisponibilité à plus de 300 000 dollars. Ce qui est encourageant, c’est qu’une grande partie de ce risque est évitable, et que de nombreux redémarrages liés à l’application de correctifs peuvent être totalement supprimés.
Qu'est-ce qu'une interruption de service du serveur ?
On parle d'« indisponibilité du serveur » pour désigner toute période durant laquelle un serveur ne peut pas remplir sa fonction, qu'il s'agisse de traiter des requêtes, d'exécuter des charges de travail ou simplement d'être accessible. Il en existe deux types. L'indisponibilité planifiée correspond à la fenêtre de maintenance que vous contrôlez. L'indisponibilité imprévue est celle qui vous réveille à 2 heures du matin. C'est ce deuxième type qui inquiète la plupart des équipes, et à juste titre.
Interruption de service prévue
Une interruption planifiée se produit lorsque les administrateurs mettent délibérément les systèmes hors ligne pour effectuer des opérations de maintenance, d'appliquer des mises à jour, mettre à niveau le matériel, migrer des charges de travail ou apporter des modifications à l'infrastructure. Elles sont généralement programmées pendant les périodes de faible trafic, mais elles ont tout de même un impact sur les utilisateurs, les équipes internes et les opérations de l'entreprise.
Arrêt imprévu
On parle d'« interruption imprévue » lorsque les services cessent de fonctionner sans avertissement. Pannes matérielles, plantages logiciels, failles de sécurité, problèmes de réseau, l'épuisement des ressources et les erreurs opérationnelles en sont tous des causes courantes. Pour la plupart des organisations, il s'agit là du problème le plus difficile à gérer, car il survient sans crier gare et nécessite généralement une analyse et une résolution immédiates.
Remarque : Une défaillance du serveur n'entraîne pas automatiquement une interruption de service perceptible par les utilisateurs. Si la redondance et le basculement fonctionnent correctement, les requêtes ne s'en aperçoivent même pas. Les interruptions de service surviennent lorsqu'une défaillance ne dispose d'aucun chemin de secours, lorsque le basculement est trop lent pour être efficace, ou lorsque la défaillance affecte plusieurs composants à la fois. La redondance n'est qu'une partie de la solution, et non la solution dans son ensemble ; il est important de s'en souvenir lorsque vous décidez où concentrer vos efforts de prévention.
Quelles sont les causes des pannes de serveur ?
Malgré tout ce que l'infrastructure cloud et l’automatisation et la surveillance ont évolué, la liste des causes de panne des serveurs n’a pratiquement pas changé. Les mêmes problèmes techniques et opérationnels reviennent sans cesse dans la plupart des pannes auxquelles les équipes sont confrontées.
| Cause | Déclencheur courant | L'accent sur la prévention |
| Panne matérielle | Panne du disque dur, du bloc d'alimentation ou de la mémoire vive | Redondance, surveillance |
| Erreurs de configuration et erreurs humaines | Problème de déploiement ou modification d'une règle | Contrôle des modifications, révision |
| Vulnérabilités CVE non corrigées et attaques | Exploitation de failles de sécurité connues | Application de correctifs, renforcement de la sécurité |
| Instabilité du système d'exploitation et des logiciels | Fuite de mémoire, panique du noyau | Mises à jour, gestion du cycle de vie, support étendu |
| Panne du réseau | DNS, routage, certificat expiré | Chemins redondants, alertes de certificats |
| Épuisement des ressources | Pic de trafic, disque plein, pool de connexions saturé | Planification des capacités, marge de manœuvre |
Panne matérielle
Les disques durs tombent en panne, les blocs d'alimentation lâchent, la mémoire vive (RAM) se détériore, les ventilateurs cessent de fonctionner. Le matériel est la cause la plus visible et celle pour laquelle la plupart des équipes ont déjà prévu des mesures. Le problème, c'est qu'un seul composant non redondant – un disque dur ou une alimentation électrique – peut à lui seul mettre l'ensemble du système hors service.
Erreurs de configuration et erreurs humaines
Une règle de pare-feu mal saisie, une modification DNS incorrecte, un déploiement qui ignore un contrôle d’intégrité. L’erreur humaine est à l’origine d’une grande partie des pannes, même si elle se présente souvent sous une autre forme au moment où l’on rédige le rapport d’analyse rétrospective. Le contrôle des modifications et la révision par les pairs permettent d’en détecter une grande partie avant qu’elles n’atteignent l’environnement de production, et la gestion des correctifs contribue également à cette prévention, car elle supprime les étapes manuelles au cours desquelles les erreurs se produisent.
Vulnérabilités non corrigées et cyberattaques
Non corrigées Les vulnérabilités Linux constituent une porte ouverte. Les pirates peuvent commencer à exploiter une faille CVE connue avant même que de nombreuses entreprises n’aient déployé le correctif disponible, et bon nombre d’attaques réussies entraînent des temps d’arrêt, avec des ransomwares et les attaques DDoS en sont des exemples évidents.
Se tenir informé des la correction des vulnérabilités permet d’éliminer les points d’entrée les plus faciles d’accès. De plus, les conséquences ne se limitent généralement pas à la simple interruption de service, car les risques réglementaires, la perte de clients et l’atteinte à la réputation perdurent bien au-delà de l’incident lui-même.
Instabilité du système d'exploitation et des logiciels
Fuites de mémoire, pannes du noyau, processus hors de contrôle, conflits de dépendances. La dégradation logicielle s'accumule silencieusement jusqu'à ce qu'un service tombe en panne ou que l'hôte se bloque. Les logiciels en fin de vie aggravent encore la situation, car les correctifs de sécurité et les corrections de bogues en amont cessent d’être fournis et les problèmes connus restent en suspens, à moins qu’une autre solution de support ne soit mise en place.
Pannes de réseau
Pannes DNS, problèmes de routage, certificats périmés, incidents chez le fournisseur en amont. Votre serveur peut être en parfait état de fonctionnement et rester pourtant inaccessible. Ces problèmes passent souvent inaperçus, car l'hébergeur semble fonctionner normalement sur tous vos tableaux de bord, alors que les utilisateurs n'y accèdent pas.
Attention : Les certificats TLS périmés sont à l’origine de plus de pannes inexpliquées que l’on ne veut bien l’admettre. Configurez des alertes de fin de validité à 30 jours et à 7 jours de l’échéance, et non le matin même de la panne.
Surcharge des ressources
Lorsque la demande dépasse les ressources disponibles, les performances se dégradent jusqu'à ce que les requêtes commencent à échouer, que des processus soient interrompus ou que le service cesse tout simplement de répondre. L'infrastructure cloud peut être configurée pour s'adapter dynamiquement, mais quelqu'un doit tout de même s'assurer que la capacité correspond aux besoins réels de l'application. Les pics de trafic, les vagues de tentatives répétées d'utilisateurs sollicitant un service dégradé et un seul « voisin bruyant » sur un hébergement mutualisé peuvent tous déclencher un effet domino.
Le coût des temps d'arrêt et ce que prévoit votre SLA
Votre objectif de disponibilité correspond en réalité à une marge de manœuvre en cas de panne. Voici ce que vous offre chaque niveau.
| SLA de disponibilité | Temps d'arrêt annuel | Temps d'indisponibilité par mois |
| 99% | 3,65 jours | 7,31 heures |
| 99.9% | 8,77 heures | 43,8 minutes |
| 99.99% | 52,6 minutes | 4,38 minutes |
| 99.999% | 5,26 minutes | 26,3 secondes |
Les correctifs entraînent eux-mêmes des coûts liés aux temps d’arrêt, et ceux-ci sont de plus en plus onéreux à supporter. L’étude de l’Uptime Institute intitulée analyse annuelle des pannes de 2026 indique que 57 % des opérateurs estiment le coût de leur dernière panne majeure à plus de 100 000 dollars, et que, pour la deuxième année consécutive, un sur cinq l’estime à plus d’un million de dollars, alors même que la fréquence des pannes par site a baissé pour la cinquième année d’affilée. Moins de pannes, mais chacune plus coûteuse : c’est une mauvaise affaire pour quiconque dont le processus de mise à jour dépend encore de la planification de temps d’arrêt.
Comment prévoir des moments de repos sans le regretter
Tôt ou tard, il faut prévoir des périodes d'indisponibilité, que ce soit pour le déploiement d'un code, des changements matériels, des mises à jour de configuration ou une migration de serveur. Les heures creuses s'imposent naturellement, mais il existe davantage de marge de manœuvre pour optimiser ces opérations que la plupart des équipes ne l'exploitent.
Commencez par les sauvegardes. Assurez-vous qu’elles sont récentes, testées et réellement accessibles, car découvrir en plein milieu d’une restauration que votre sauvegarde n’a jamais été validée transforme un problème en deux. Vérifiez ensuite l’espace libre sur disque et la charge actuelle sur les ressources avant de commencer, car un système de fichiers presque plein ou une machine déjà à court de mémoire peut transformer une mise à jour de routine en incident. Et testez d’abord en environnement de préproduction, même pour les petites modifications. Surtout pour les petites modifications, car ce sont celles-là qui sont souvent validées sans vérification.
10 stratégies clés pour éviter les pannes de serveur
Il n'existe pas de solution miracle pour garantir une haute disponibilité. C'est plutôt un ensemble d'habitudes et d'outils qui, combinés, permettent d'y parvenir. Tous les éléments ci-dessous ont fait leurs preuves sous une charge de production réelle, et ils sont classés approximativement dans l'ordre dans lequel la plupart des équipes devraient les adopter.
1. Mettre en place une surveillance continue et un système d'alertes précoces
On ne peut pas prévenir ce qu'on ne voit pas. Une surveillance continue du processeur, de la mémoire, du disque dur, du réseau et des contrôles au niveau des services constitue la base sur laquelle repose tout le reste. L'objectif n'est pas de se retrouver face à une multitude de tableaux de bord, mais de disposer d'alertes qui se déclenchent avant même que quiconque en dehors de l'équipe ne s'en aperçoive.
Définissez des seuils pour les indicateurs avancés, comme un disque qui tend à se remplir ou une utilisation de la mémoire qui augmente progressivement, et pas uniquement en cas de pannes graves. Si vos alertes ne se déclenchent qu’une fois que le système est déjà en panne, elles ne font que rendre compte de ce qui s’est déjà produit.
Si vous êtes submergé par le bruit, resserrez les seuils et organisez le routage en fonction de la gravité. Et dès que vous dépassez quelques centaines de serveurs, effectuez régulièrement un audit de votre parc informatique pour vous assurer qu’aucun élément n’a échappé discrètement à la surveillance, car un hôte non surveillé constitue un angle mort qui finira par vous jouer des tours.
Conseil de pro : Surveillez le taux de variation, pas seulement les valeurs absolues. Un disque dont le taux d’utilisation reste stable à 70 % peut être moins préoccupant qu’un autre qui est passé de 40 % à 70 % en une heure ; le taux de variation permet de détecter des problèmes que un seuil statique ne permet pas de repérer.
2. Automatiser l'application des correctifs sur les serveurs
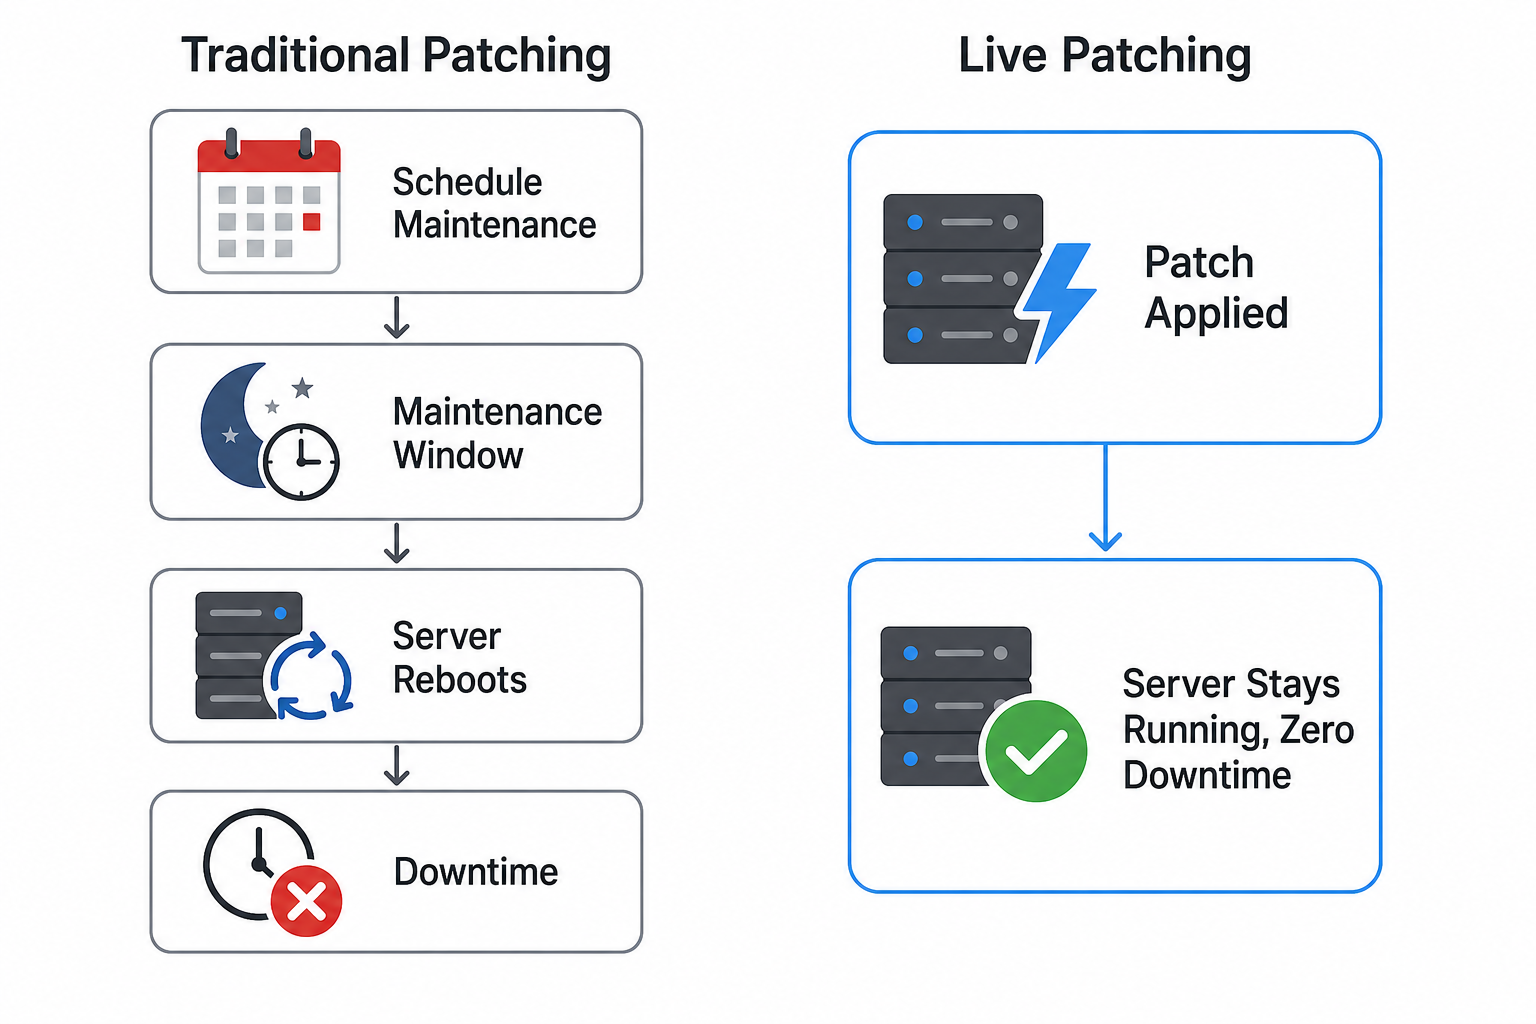
L'application manuelle des correctifs devient ingérable à grande échelle, et les mises à jour du noyau nécessitant un redémarrage entraînent elles-mêmes des temps d'arrêt planifiés. Cela crée un dilemme que la plupart des équipes connaissent bien : appliquer rapidement les correctifs et maintenir la disponibilité du service peuvent se révéler incompatibles, en particulier sur les systèmes où les fenêtres de maintenance sont difficiles à obtenir.
Automatisation du déploiement des correctifs permet d'appliquer les correctifs CVE disponibles plus rapidement et de manière plus cohérente sur l'ensemble d'un parc informatique. Le principal avantage réside dans le fait de pouvoir éviter le redémarrage lorsque cela est possible. L'application de correctifs à chaud (également appelée « application de correctifs sans redémarrage ») applique les correctifs du noyau à un système en cours d’exécution sans le redémarrer. KernelCare de TuxCare de TuxCare le fait pour les noyaux Linux pris en charge, tandis que LibCare étend ce principe aux bibliothèques partagées critiques telles que glibc et OpenSSL.
Le retard dans l'application des correctifs contribue de manière significative aux pannes, et les chiffres ont évolué dans le mauvais sens. Selon rapport DBIR 2026 de Verizon, l’exploitation des vulnérabilités est désormais le vecteur d’accès initial le plus courant pour les violations de données, avec 31 %, contre 20 % l’année précédente. C’est la première fois en 19 ans d’existence du rapport qu’elle dépasse l’usurpation d’identifiants. La situation s’est inversée en matière de correction. Seules 26 % des entrées « Known Exploited Vulnerabilities » (KEV) de la CISA identifiées dans les environnements étudiés par Verizon ont été entièrement corrigées en 2025, contre 38 % auparavant, et le délai médian nécessaire à la résolution complète est passé de 32 à 43 jours. L’automatisation permet de combler cet écart sans compromettre la disponibilité des systèmes.
3. Intégrer la redondance et le basculement dans l'architecture
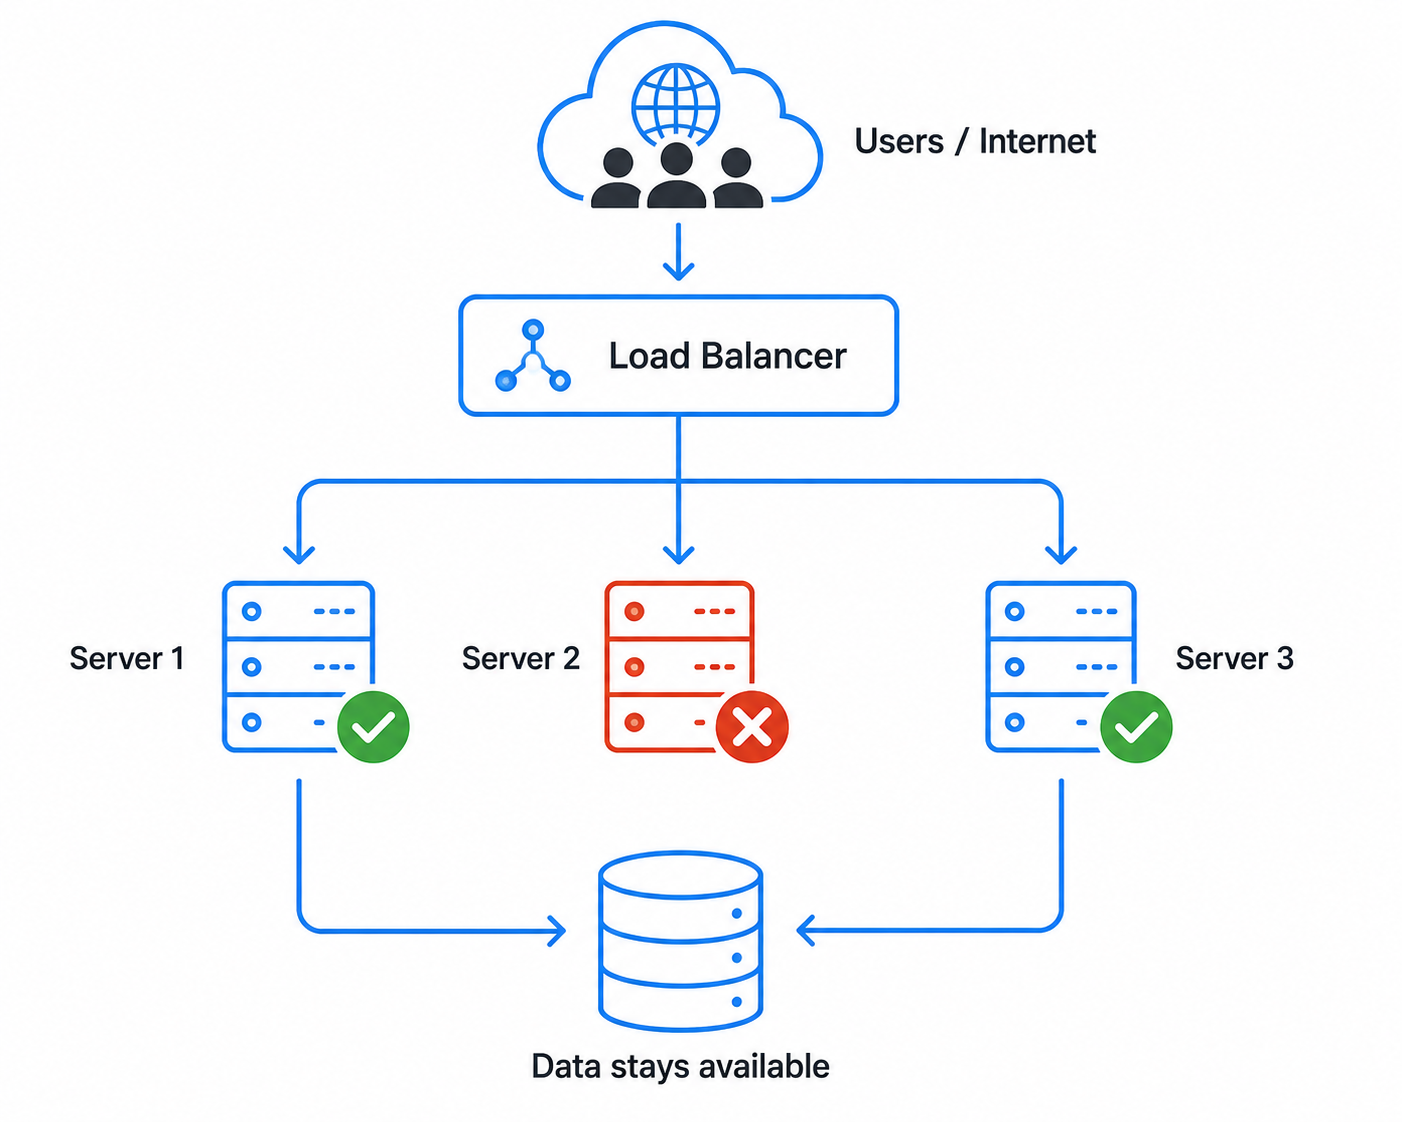
Les points de défaillance uniques sont la cause principale des interruptions de service. La redondance garantit qu'aucun composant, qu'il s'agisse d'un serveur, d'un disque, d'une alimentation électrique ou d'un chemin réseau, ne peut à lui seul provoquer la panne de l'ensemble du système.
Les équilibreurs de charge, qui répartissent le trafic entre plusieurs instances, les bases de données répliquées et les déploiements multizones permettent tous d'assurer la continuité du service lorsqu'un élément tombe en panne. Les architectures « actif-actif » peuvent limiter les perturbations liées à un basculement, même si elles ont tendance à être plus complexes et plus coûteuses que les architectures « actif-passif » ; par ailleurs, une configuration « actif-passif » bien conçue peut également basculer très rapidement.
Le choix dépendra de votre budget en matière de temps d'indisponibilité et de votre objectif en termes de temps de reprise. Les bases de données méritent une attention particulière, car une couche applicative comportant trois répliques opérationnelles placées devant une base de données non répliquée reste exposée à une panne dès qu’un incident survient.
4. Effectuez régulièrement des sauvegardes dont l'efficacité a été vérifiée
Les sauvegardes ne servent à rien tant que vous n'avez pas effectué de restauration à partir de l'une d'entre elles. De nombreuses équipes ne se rendent compte que leurs sauvegardes ont échoué en silence qu'au moment où elles en ont besoin. Exécutez-les automatiquement et régulièrement, conservez au moins une copie hors site ou sur un compte distinct, et testez les restaurations selon un calendrier défini. C'est justement cette dernière étape qui est souvent négligée.
Les ransomwares ciblent spécifiquement les systèmes de sauvegarde ; c'est pourquoi les copies immuables ou isolées physiquement revêtent désormais une importance bien plus grande qu'auparavant.
5. Renforcer la sécurité pour prévenir les pannes dues à des attaques
Une part non négligeable des temps d'arrêt imprévus est imputable à un attaquant, qu'il s'agisse d'une attaque DDoS, d'un rançongiciel ou d'un service compromis mis hors ligne à des fins de nettoyage. Le renforcement de la sécurité de vos hôtes réduit la surface d'attaque grâce au principe du moindre privilège, à des règles de pare-feu, à Fail2Ban et à la désactivation des services que personne n'utilise.
Bien pratiques de sécurité Linux et l’application des correctifs les plus récents permettent ensemble d’éliminer une grande partie des failles faciles sur lesquelles comptent les attaquants. Considérez la sécurité et la disponibilité comme des enjeux étroitement liés, car un serveur compromis se transforme rapidement en incident de disponibilité. Les vulnérabilités à fort impact dans les logiciels largement utilisés attirent rapidement des tentatives d’exploitation dès leur divulgation ; toute personne exploitant des serveurs accessibles au public doit donc être en mesure de réagir rapidement.
6. Planifier la capacité du serveur et la marge de manœuvre en termes de ressources
Les pannes dues à l'épuisement des ressources sont le fruit de nos propres erreurs. Un système de fichiers saturé, un pool de connexions qui atteint sa limite ou une mémoire qui vient à manquer peuvent mettre un service hors service tout aussi efficacement qu'un disque en panne. Suivez l'évolution de l'utilisation, définissez des seuils par charge de travail plutôt que de vous contenter d'un chiffre universel, et conservez une marge suffisante pour absorber à la fois un pic de trafic prévu et la perte d'un nœud.
Préparez-vous aux pics de trafic que vous connaissez déjà, comme les lancements de produits et les pics saisonniers, avant qu’ils ne surviennent plutôt que pendant. Si la gestion des capacités est constamment sous pression, il s’agit davantage d’un problème de planification que d’un problème d’infrastructure.
7. Effectuer des audits réguliers et des contrôles de performance
La dérive est insidieuse : les configurations changent, les certificats approchent de leur date d'expiration, les paquets prennent du retard et les petits problèmes s'accumulent jusqu'à ce que l'un d'entre eux provoque une panne. Les audits programmés, c'est-à-dire les revues de configuration, l'analyse des journaux et l'établissement de références de performance, permettent de détecter ces problèmes tant qu'ils sont encore peu coûteux à résoudre.
Découvrez ce qui a changé depuis le dernier audit de sécurité, et pas seulement à la situation actuelle. L’objectif est de mettre en évidence les problèmes qui s’accumulent lentement et que les alertes de seuil ne signaleront pas tant que la situation ne se sera pas déjà dégradée.
8. Planifier et organiser correctement l'entretien
Une maintenance mal gérée peut transformer une fenêtre de maintenance contrôlée en une interruption prolongée, voire imprévue. Choisissez des plages horaires véritablement calmes, informez les personnes concernées et préparez la restauration avant de toucher à quoi que ce soit.
Organisez vos changements par étapes à l'aide de déploiements « canary » ou « blue-green », afin qu'une version défectueuse ne touche qu'une fraction de votre trafic plutôt que l'ensemble, et utilisez des contrôles d'intégrité pour valider chaque étape. L'objectif est de rendre les interventions planifiées routinières et réversibles. Une mise à jour de routine ne devrait jamais dégénérer en incident.
9. Formez vos équipes et consignez vos procédures opérationnelles
Les outils ne servent à rien si la personne de garde ne connaît pas le système. Un guide d'intervention documenté, expliquant comment redémarrer un service, où le basculement est configuré et qui est responsable de quoi, transforme une situation d'urgence à 2 heures du matin en une simple liste de contrôle.
Veillez à ce que vos procédures opérationnelles standard (SOP) soient à jour et organisez des exercices de simulation d'incidents afin que les gestes à effectuer deviennent une seconde nature avant que quiconque n'ait à y recourir. Des procédures documentées et répétées laissent bien moins de place à l'erreur que des souvenirs imprécis sous la pression. Formez les nouveaux ingénieurs en vous appuyant sur ces documents plutôt que sur un savoir tacite.
10. Tester le basculement et organiser des exercices de reprise après sinistre
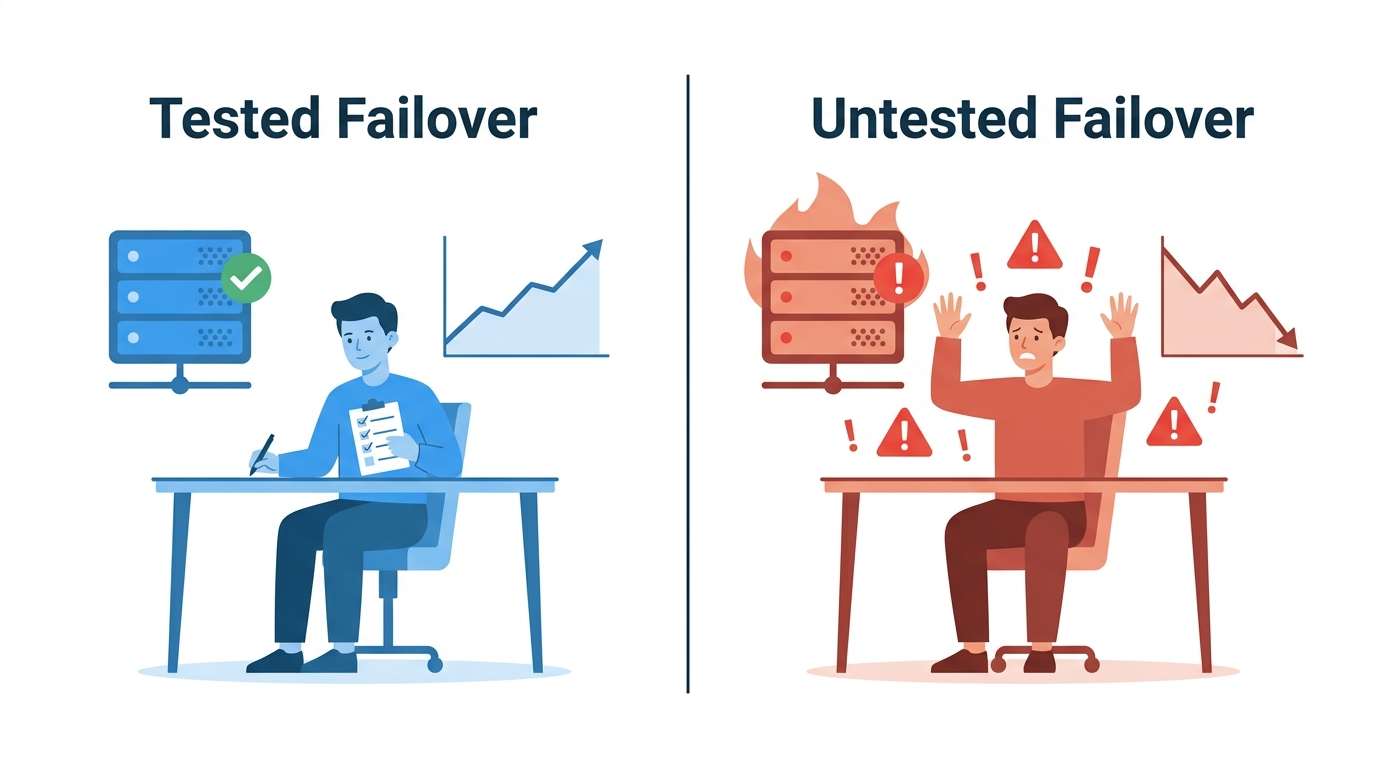
Un basculement non testé n'est qu'une supposition. La seule façon de savoir si votre redondance fonctionne est de provoquer délibérément des pannes. Mettez un nœud hors service, effectuez un basculement de la base de données, simulez une panne de zone, puis observez ce qui se passe réellement. Organisez régulièrement des exercices de reprise après sinistre et comparez le temps de reprise réel à votre objectif.
Si vous n'avez jamais testé le basculement, partez du principe qu'il ne fonctionne pas jusqu'à preuve du contraire. Les tests de charge relèvent de la même catégorie. Un équilibreur de charge répartit le trafic, mais vous souhaitez tout de même savoir comment le système se comporte lorsque deux nœuds tombent en panne au lieu d'un seul. Tester le système sur un cluster en mode dégradé vous permet de déterminer si la capacité restante est suffisante pour absorber la charge ou si vous avez besoin de capacités supplémentaires.
Pourquoi les équipes repoussent-elles l'application des correctifs ?
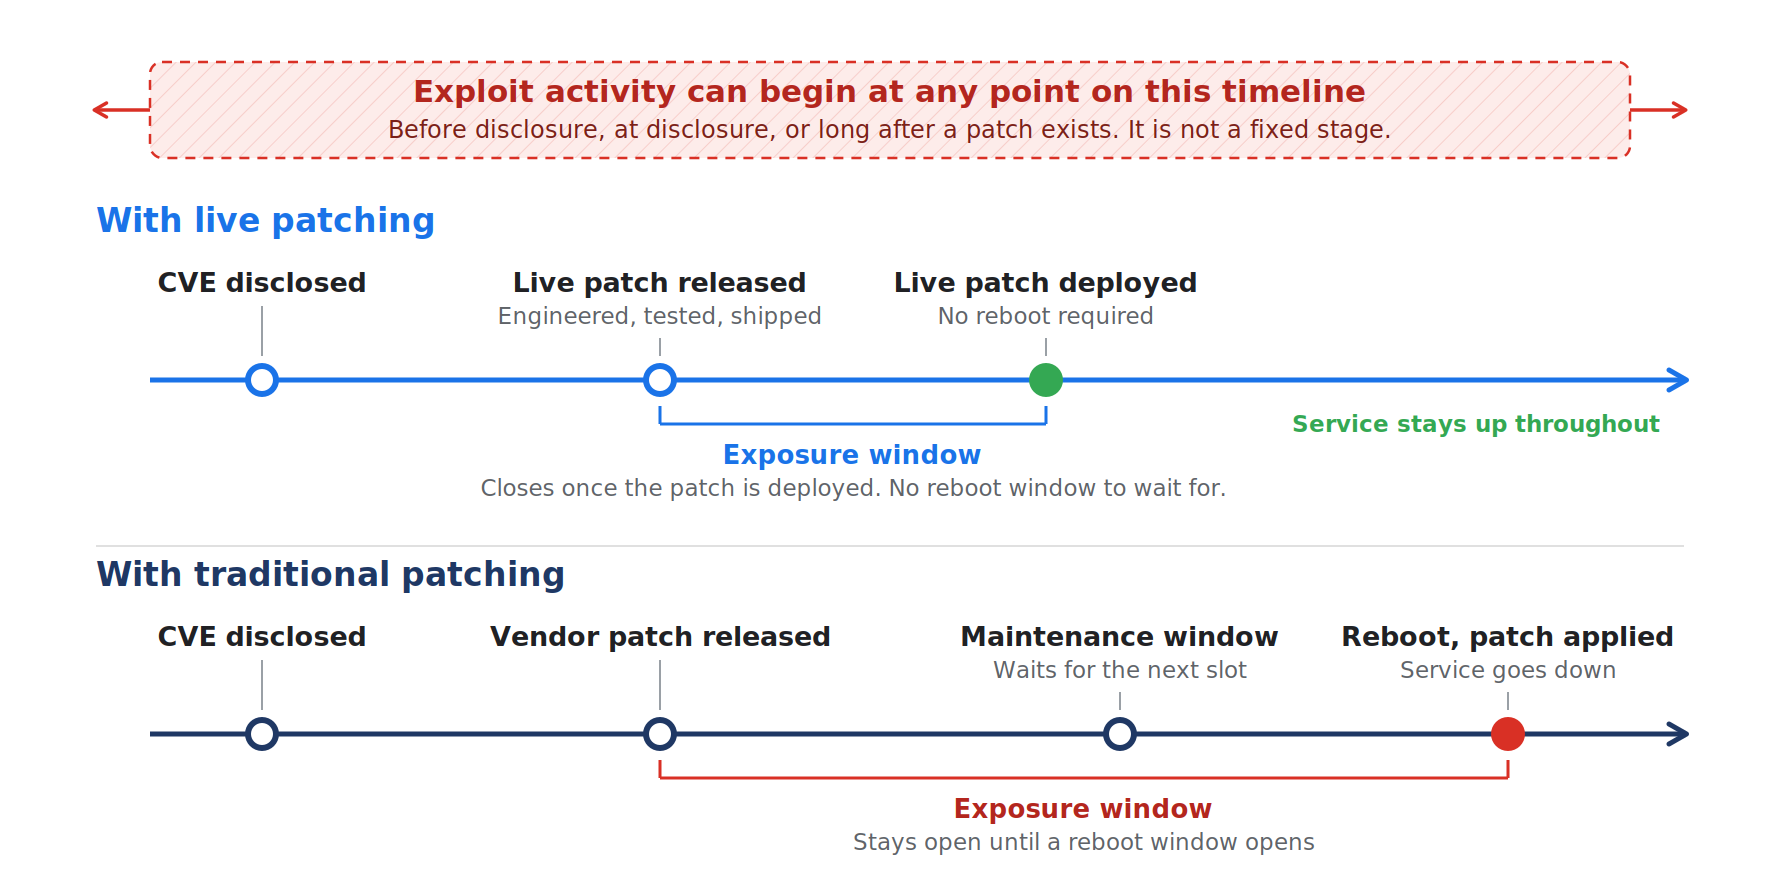
L'application des correctifs est l'une des stratégies que les équipes reportent le plus souvent, et la raison n'est un mystère pour personne. Le cycle traditionnel consistant à appliquer un correctif au noyau puis à redémarrer le système entraîne précisément le temps d'indisponibilité que tout le monde cherche à éviter ; les correctifs sont donc reportés et les vulnérabilités CVE connues restent non corrigées. La même analyse de 2026 souligne que les opérateurs réorientent progressivement leurs investissements vers l’automatisation et les systèmes de contrôle pour faire face à une complexité croissante, tout en avertissant qu’une automatisation accrue engendre ses propres types de problèmes. Ces deux aspects sont vrais, c’est pourquoi l’automatisation qui en vaut la peine est celle qui supprime la fenêtre de maintenance plutôt que de simplement la reprogrammer.
L'application automatisée des correctifs, sans redémarrage, modifie la nature de ce compromis. Correctifs disponibles pour les CVE du noyau du noyau prises en charge peuvent être appliquées à des systèmes en cours d’exécution sans redémarrage et sans qu’il soit nécessaire de réserver une fenêtre de maintenance. Les correctifs sont déployés de manière cohérente sur l’ensemble du parc informatique plutôt que serveur par serveur, et le délai entre la publication d’un correctif et son déploiement peut passer de plusieurs jours ou semaines à quelques heures seulement. La sécurité des serveurs Linux s'améliore sans pour autant sacrifier la disponibilité.
Découvrez comment TuxCare vous aide à éviter les temps d'arrêt
Pour éviter les temps d'arrêt, il faut détecter les problèmes à un stade précoce, mettre en place des redondances et corriger les vulnérabilités avant que quelqu'un d'autre ne les découvre, le tout sans avoir à mettre les systèmes hors ligne. C'est justement sur ce dernier point que la plupart des équipes se heurtent à des difficultés.
Les outils de correction à chaud de TuxCare permettent d'appliquer les correctifs de sécurité pris en charge sans nécessiter de redémarrage. KernelCare prend en charge les noyaux pris en charge. LibCare couvre les bibliothèques partagées critiques. Grâce à ces deux outils, les correctifs pris en charge pour le noyau et les bibliothèques partagées critiques peuvent être appliqués sans nécessiter de fenêtre de maintenance impliquant un redémarrage ni de redémarrage perturbateur des applications, ce qui signifie que votre objectif de disponibilité et votre niveau de sécurité ne s’opposent plus.
Si vous souhaitez découvrir comment le « live patching » s'adapte à votre configuration spécifique, nos experts en sécurité Linux se feront un plaisir d'en discuter avec vous.