Support technique
 Documentation
 Connexion
 Nous contacter



Accédez directement au résumé généré par l'IA de cet article de blog 


Principaux enseignements
- Les indicateurs de rapidité tels que le MTTP, le MTTR et le MTTD indiquent combien de temps un risque réel reste ouvert.
- Les indicateurs de couverture mettent en évidence les actifs que personne ne mesure encore.
- Il faut toujours analyser les indicateurs par paires, car un chiffre pris isolément peut être trompeur et donner une fausse impression.
- Cinq à huit indicateurs liés à de véritables décisions valent mieux que trente indicateurs sans aucune incidence sur les décisions.
Votre outil d’analyse des vulnérabilités indique qu’il existe 4 000 vulnérabilités non corrigées sur l’ensemble du parc informatique. Votre responsable vous pose une question : « La situation s’améliore-t-elle ou empire-t-elle ? » La plupart des équipes ne peuvent pas y répondre clairement, et c’est précisément pour combler ce fossé entre les données que vous collectez et les décisions que vous pouvez réellement justifier que les indicateurs de gestion des vulnérabilités ont été créés. Une poignée d’indicateurs clés de performance (KPI) bien choisis vous indique à quelle vitesse vous appliquez les correctifs, ce qui vous échappe et où les risques s’accumulent insidieusement.
Ce guide vous explique quels indicateurs il convient de suivre, comment les interpréter sans se faire d'illusions et comment les mettre en pratique.
Qu'est-ce que les indicateurs de gestion des vulnérabilités ?
Les indicateurs de gestion des vulnérabilités sont les chiffres qui évaluent l'efficacité avec laquelle votre programme identifie, hiérarchise et corrige les failles de sécurité au fil du temps. Il ne s'agit pas du simple nombre de vulnérabilités détectées. N'importe qui peut obtenir ce chiffre à l'aide d'un scanner. Ces indicateurs mesurent le comportement de votre équipe, c'est-à-dire la rapidité avec laquelle vous détectez les failles, la rapidité avec laquelle vous y remédiez et la part de votre environnement réel que vous examinez réellement.
La raison pour laquelle cela revêt une importance croissante chaque année tient au volume. Le programme CVE a recensé un peu plus de 48 000 enregistrements CVE publiés en 2025, contre un peu plus de 40 000 en 2024. Une analyse indépendante des enregistrements publiés en a dénombré plus de 35 000 pour le seul premier semestre de 2026, ce qui laisse présager que l’année est en passe d’établir un nouveau record, et de loin. Aucune équipe ne corrige toutes les failles. Les indicateurs permettent de déterminer ce qui doit être traité en priorité et d'expliquer pourquoi ce choix était justifié.
La plupart des programmes suivent trois catégories. Les indicateurs de rapidité mesurent la vitesse à laquelle vous détectez une vulnérabilité et la traitez jusqu'à sa correction ; c'est dans ce domaine qu'interviennent les indicateurs MTTD, MTTR et MTTP. Les indicateurs de couverture évaluent la part de votre surface d'attaque que vous analysez réellement et le nombre de correctifs appliqués dans les délais impartis. Les indicateurs de profil de risque décrivent la nature de vos vulnérabilités actives en fonction de leur gravité, de leur exploitabilité et de leur ancienneté.
Une mise en garde. Le nombre total de vulnérabilités détectées est l'indicateur que les dirigeants demandent le plus souvent et auquel les ingénieurs devraient se fier le moins. Il augmente lorsque l'on améliore l'analyse et diminue lorsque l'on cesse de chercher. À lui seul, il mesure l'activité, pas la sécurité.
Comment le suivi des indicateurs de vulnérabilité permet de prendre de meilleures décisions en matière de sécurité
Les indicateurs permettent à un programme de sécurité de passer d'une approche consistant à « faire de son mieux » à une approche où l'on identifie précisément les points faibles. Ce passage de l'intuition à des données concrètes est justement l'essentiel.
La visibilité passe avant tout, car on ne peut pas améliorer un indicateur qu’on ne suit pas. Viennent ensuite les mesures à prendre, car une augmentation du MTTP sur les serveurs exposés à Internet vous indique précisément où concentrer vos efforts. Les résultats viennent en dernier, lorsque vous pouvez démontrer, d’un trimestre à l’autre, que les bugs critiques sont désormais corrigés en quelques jours au lieu de plusieurs semaines.
Suivis de manière cohérente, les indicateurs fournissent une réponse objective permettant de déterminer si le programme s'améliore, en s'appuyant sur des courbes de tendance plutôt que sur des impressions subjectives. Ils classent les tâches en fonction du risque réel plutôt qu'en fonction de la personne qui a signalé le problème le plus bruyamment. Ils émettent des alertes précoces lorsque la correction des vulnérabilités prennent du retard sur un groupe d’actifs spécifique. Enfin, elles facilitent les discussions budgétaires, car la lenteur des mesures correctives a un coût financier que l’on peut chiffrer.
Si vous souhaitez externaliser ou renforcer vos capacités en matière de correction des vulnérabilités, vous pouvez consulter notre analyse comparative des meilleurs prestataires de services de gestion des vulnérabilités.
Indicateurs clés à suivre en matière de gestion des vulnérabilités
Vous n'avez pas besoin de trente indicateurs. Il vous en faut entre cinq et huit qui soient directement liés à une décision. Voici l'ensemble essentiel.
| Métrique | Ce qu'il mesure | Pourquoi est-ce important ? |
| MTTP | Nombre moyen de jours entre la mise à disposition d'un correctif et son activation en production | Indique à quelle vitesse vous comblez les failles connues |
| MTTR | Nombre moyen de jours entre la détection et la résolution complète du problème | Enregistre l'intégralité de la réponse, et pas seulement l'étape de correction |
| MTTD | Nombre moyen de jours entre le moment où une vulnérabilité devient détectable et celui où elle est identifiée | Mette en évidence les lacunes en matière de fréquence et de couverture des analyses |
| Couverture de numérisation | Pourcentage des actifs effectivement analysés | Les actifs non analysés constituent un risque non quantifié |
| Respect du contrat de niveau de service (SLA) en matière de remédiation | Pourcentage de vulnérabilités corrigées dans les délais impartis | Permet de transformer la politique en un élément pouvant faire l'objet d'un audit |
MTTP (Mean Time to Patch)
Il n'existe pas de définition unique du MTTP dans le secteur ; veillez donc à bien définir la vôtre avant de la communiquer. Dans ce guide, le MTTP désigne le délai moyen entre la mise à disposition d'un correctif et sa mise en production. D'autres équipes font courir ce délai à partir de la divulgation ou de la détection. Toutes ces approches sont valables. En revanche, il ne faut pas les mélanger.
Surveillez attentivement le point de départ, car mesurer à partir d'un événement erroné fausse les chiffres et masque l'exposition réelle. Quelle que soit la définition que vous choisissez, veillez à l'appliquer de manière cohérente dans tous les rapports que l'on est susceptible de comparer.
Attention : Un MTTP signalé peut sembler parfait alors que les systèmes qu’il décrit sont toujours exposés. Si votre outil considère l’installation du paquet comme l’étape finale, un correctif du noyau ou d’une bibliothèque partagée peut rester installé mais inactif jusqu’au prochain redémarrage du système ou du service. L’installation et la protection ne coïncident pas toujours, et cet écart peut passer inaperçu sur tout tableau de bord qui considère l’installation comme la ligne d’arrivée.
C'est également là que les les faux positifs s’accumulent, car une vérification de la version sur le disque ne donne aucune indication sur ce qui est réellement chargé.
MTTR (temps moyen de remise en état)
Le MTTR a une portée plus large que le MTTP. Il couvre l'ensemble du cycle de vie, de la détection à la résolution, y compris le triage et la hiérarchisation, les tests et le déploiement. La correction peut prendre la forme d'un correctif, mais elle peut également consister en une modification de configuration ou en la suppression totale du composant concerné.
Utilisez le MTTR pour obtenir une image fidèle de la rapidité de réaction de l'organisation, et le MTTP pour isoler l'étape de correction proprement dite. Si le MTTR est élevé alors que le MTTP est faible, le goulot d'étranglement se situe en amont, au niveau du triage et de la validation, plutôt qu'au niveau du déploiement.
MTTD (Temps moyen de détection)
Le MTTD mesure le délai moyen entre le moment où une vulnérabilité devient détectable dans votre environnement et celui où votre organisation l'identifie. Il s'agit souvent d'un problème de couverture déguisé en problème de rapidité. Si vous effectuez une analyse une fois par semaine, cette cadence à elle seule peut entraîner un retard pouvant aller jusqu'à sept jours, avec une moyenne d'environ la moitié de ce délai pour l'ensemble des vulnérabilités détectées, et ce avant même que quiconque n'ait commis la moindre erreur.
La solution réside généralement dans l'augmentation de la fréquence des analyses et dans une meilleure identification des ressources, plutôt que dans une application plus rapide des correctifs. On ne peut pas corriger ce que l'on n'a pas encore détecté.
Couverture de numérisation
Le taux de couverture des analyses correspond au pourcentage de vos actifs connus qui sont analysés selon le calendrier prévu. C'est l'indicateur qui permet de repérer le serveur « fantôme » que personne n'a mis hors service et le nouveau nœud qui n'a jamais été référencé.
Une couverture inférieure à 100 % signifie que les indicateurs que vous élaborez à partir de ces résultats d'analyse ne décrivent qu'une partie de l'environnement. Si vous analysez 80 % de vos actifs, votre MTTP ne reflète que ces 80 %. Le cinquième restant constitue un angle mort où des vulnérabilités exploitables peuvent passer inaperçues.
Respect du contrat de niveau de service (SLA) en matière de remédiation
Le taux de conformité au SLA correspond au pourcentage de vulnérabilités corrigées dans les délais impartis. Ces délais varient d’une organisation à l’autre, mais on observe généralement que les vulnérabilités de gravité « critique » doivent être corrigées dans un délai de 7 jours et celles de gravité « élevée » dans un délai de 30 jours. Cela permet de transformer votre politique de correctifs, qui n’est plus un simple document, en un élément vérifiable.
Les parties prenantes qui ne relèvent pas du domaine de la sécurité ont tendance à comprendre cela d'emblée, car cela ressemble à un contrat. Lorsqu'un incident survient, il existe une raison précise et justifiable de demander des ressources. Soyez attentifs lorsque les SLA ne sont pas respectés sur des systèmes difficiles à mettre hors ligne, car c'est souvent là que l’application de correctifs sans redémarrage s'avèrent les plus efficaces.
Que se passe-t-il lorsque les mises à jour prennent du retard ?
La lenteur dans l'application des correctifs n'est pas seulement un problème d'hygiène informatique. Elle laisse les failles exploitables exposées plus longtemps, et la marge de manœuvre dont vous disposez pour les corriger ne cesse de se réduire. Les données de VulnCheck pour le premier semestre 2026 indiquent que le délai médian entre la publication d’un CVE et l’attribution du statut KEV est de 80 jours, contre 120 jours en 2025. Les exploitations connues n’augmentent pas proportionnellement au volume de divulgations, puisque le ratio KEV/CVE est tombé à environ 1,4 % sur la même période. Les vulnérabilités qui sont exploitées atteignent simplement ce statut plus rapidement.
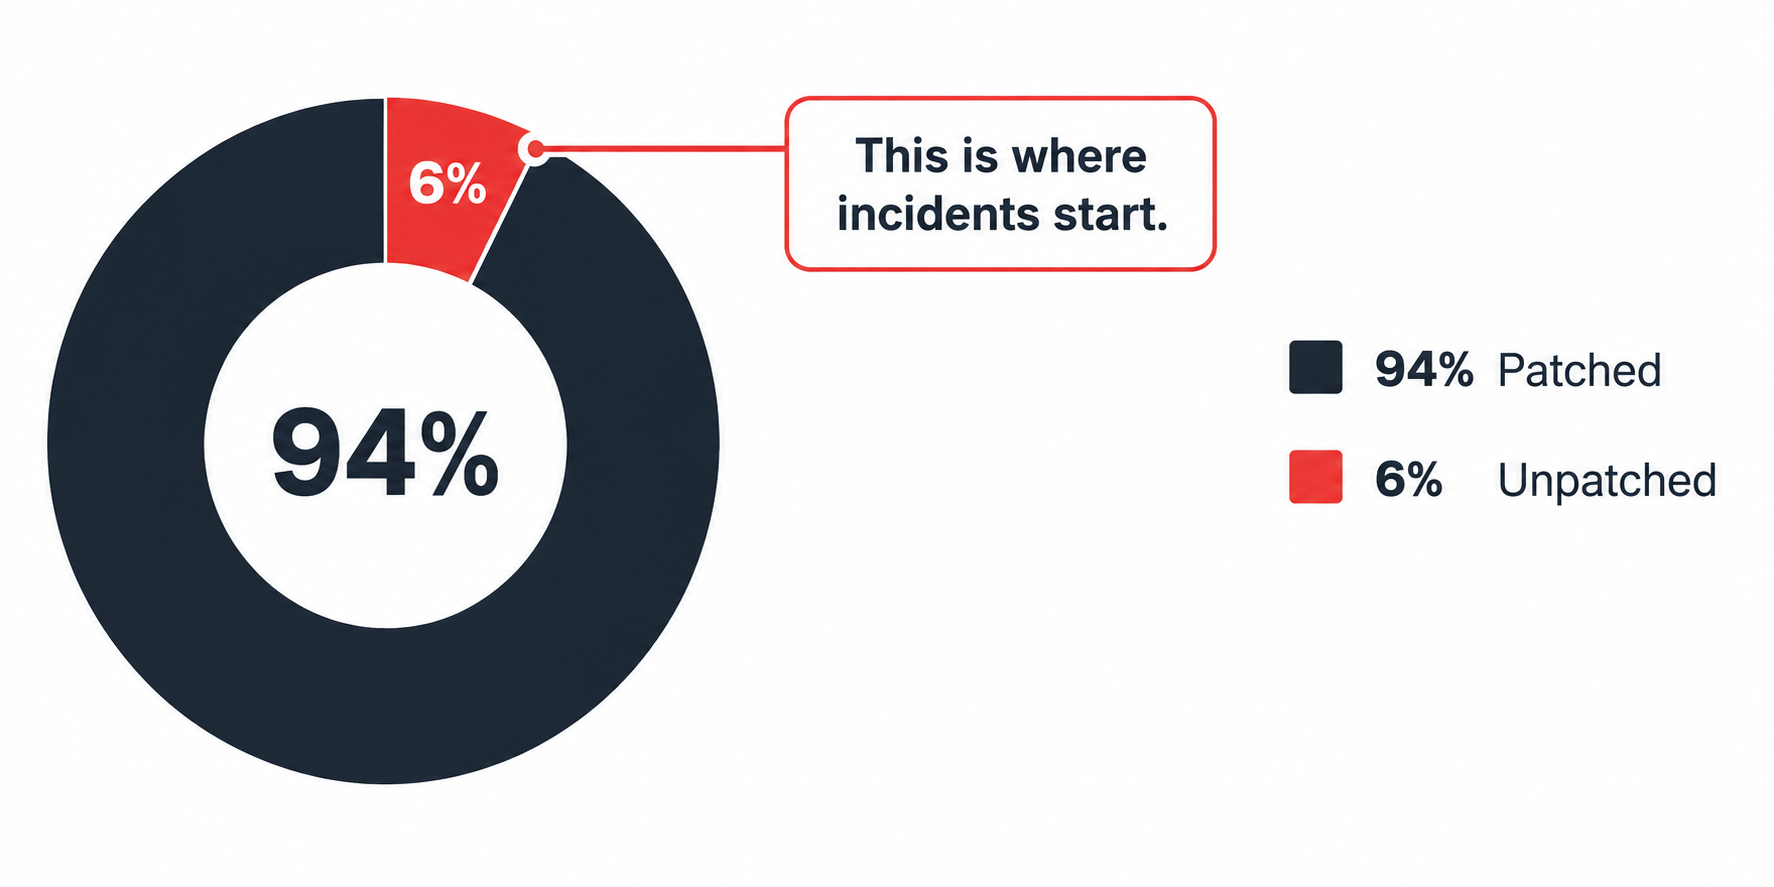
Prenons un exemple courant. Un programme fait état d'un taux de conformité SLA de 94 %, alors qu'une catégorie d'actifs difficile à mettre à jour, comme une couche de bases de données ou un parc d'appareils nécessitant un redémarrage, accumule discrètement la majeure partie des 6 % restants. Le tableau de bord global semble satisfaisant. C'est cette concentration qui représente le risque, et une moyenne ne vous le révélera jamais.
Lorsqu'un problème survient, les conséquences sont rarement à la mesure du retard pris. Un correctif non appliqué sur le mauvais système peut entraîner une fuite de données, des amendes réglementaires ou des semaines de gestion d'incident, ce qui dépasse de loin l'effort que l'application de ce correctif aurait nécessité.
Il existe une variante plus difficile de ce problème, qui concerne les systèmes en fin de leur fin de vie et pour lesquels il n’existe tout simplement pas de correctif fournisseur. Si des machines Linux héritées fonctionnent sous des versions non prises en charge, c’est précisément là que réside la faille Endless Lifecycle Support a été conçu pour combler, en assurant la fourniture continue de correctifs CVE après la fin de la période de support du fournisseur. Le CVE Tracker de TuxCare constitue un point de départ utile, car il recense les CVE connus sur les systèmes d’exploitation, les environnements d’exécution, les bibliothèques et les frameworks en fin de vie ; il vous permet de filtrer les résultats par gravité, produit, composant et statut de correction, et vous avertit dès qu’un statut de correction change.
La correction en temps réel comme moyen de réduire le MTTP
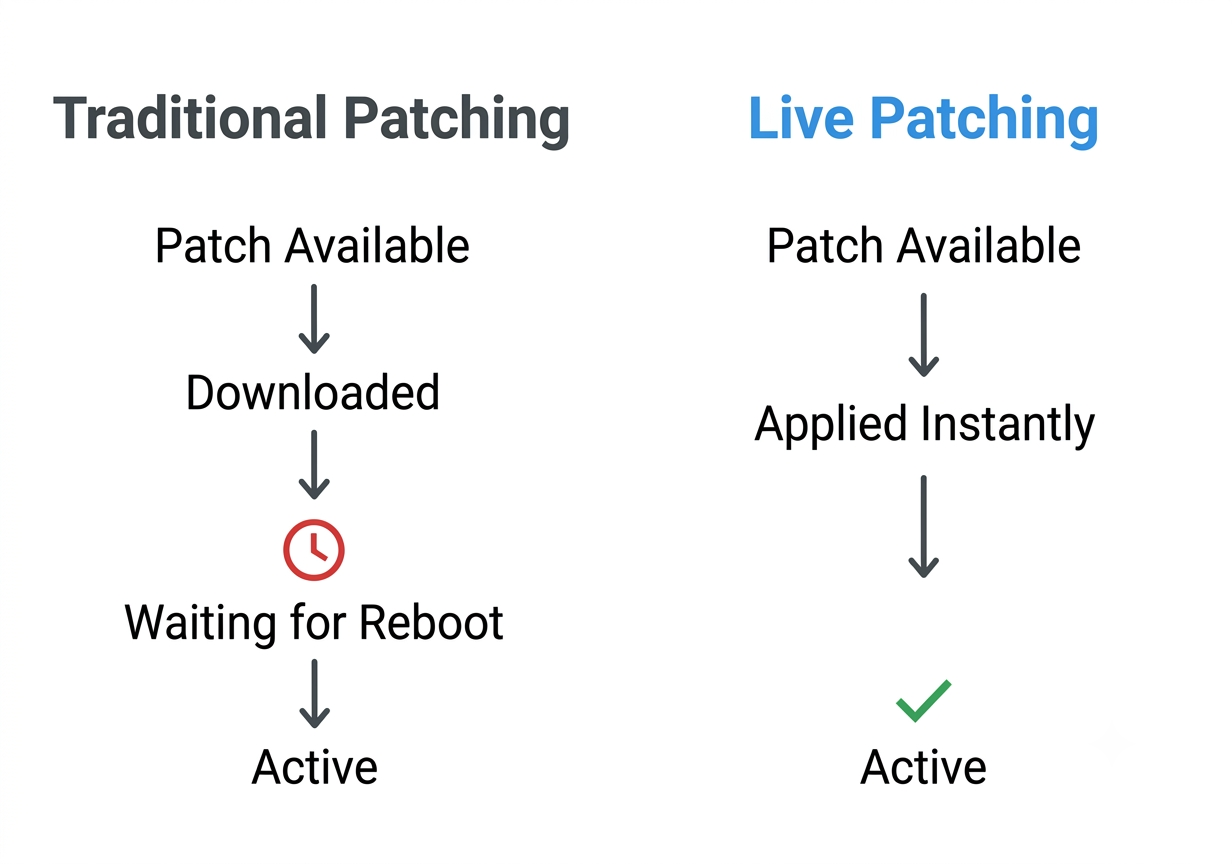
En ce qui concerne plus particulièrement l'application de correctifs au noyau, l'une des principales raisons de l'allongement du MTTP est la nécessité de redémarrer le système. Appliquer un correctif au noyau de manière traditionnelle implique de planifier un temps d’indisponibilité, d’obtenir l’approbation des modifications et de se coordonner avec toutes les équipes gérant une charge de travail sur cet hôte. Les correctifs sont donc mis en attente. Parfois pendant des semaines.
Correction du noyau à chaud permet de contourner cette dépendance en appliquant des correctifs de sécurité à un noyau en cours d’exécution sans redémarrage. L’exposition à une vulnérabilité CVE critique du noyau peut être corrigée en quelques heures au lieu de rester en attente jusqu’à la prochaine fenêtre de maintenance, et le décalage lié aux correctifs installés mais inactifs qui allonge le MTTP disparaît, car le correctif est effectif dès son application.
KernelCare de TuxCare applique des correctifs en temps réel à plus de 70 versions de distributions prêtes à l’emploi, notamment RHEL, AlmaLinux, Rocky Linux, Ubuntu, Debian, Oracle Linux, CloudLinux et Amazon Linux. Pour les équipes gérant des charges de travail 24 h/24 et 7 j/7, pour lesquelles la planification des redémarrages constitue un véritable goulot d’étranglement, il s’agit de l’une des améliorations les plus efficaces en termes de MTTP. LibCare étend cette même approche aux bibliothèques partagées telles que glibc et OpenSSL, qui présentent elles-mêmes de graves vulnérabilités CVE.
Comment interpréter les indicateurs de vulnérabilité
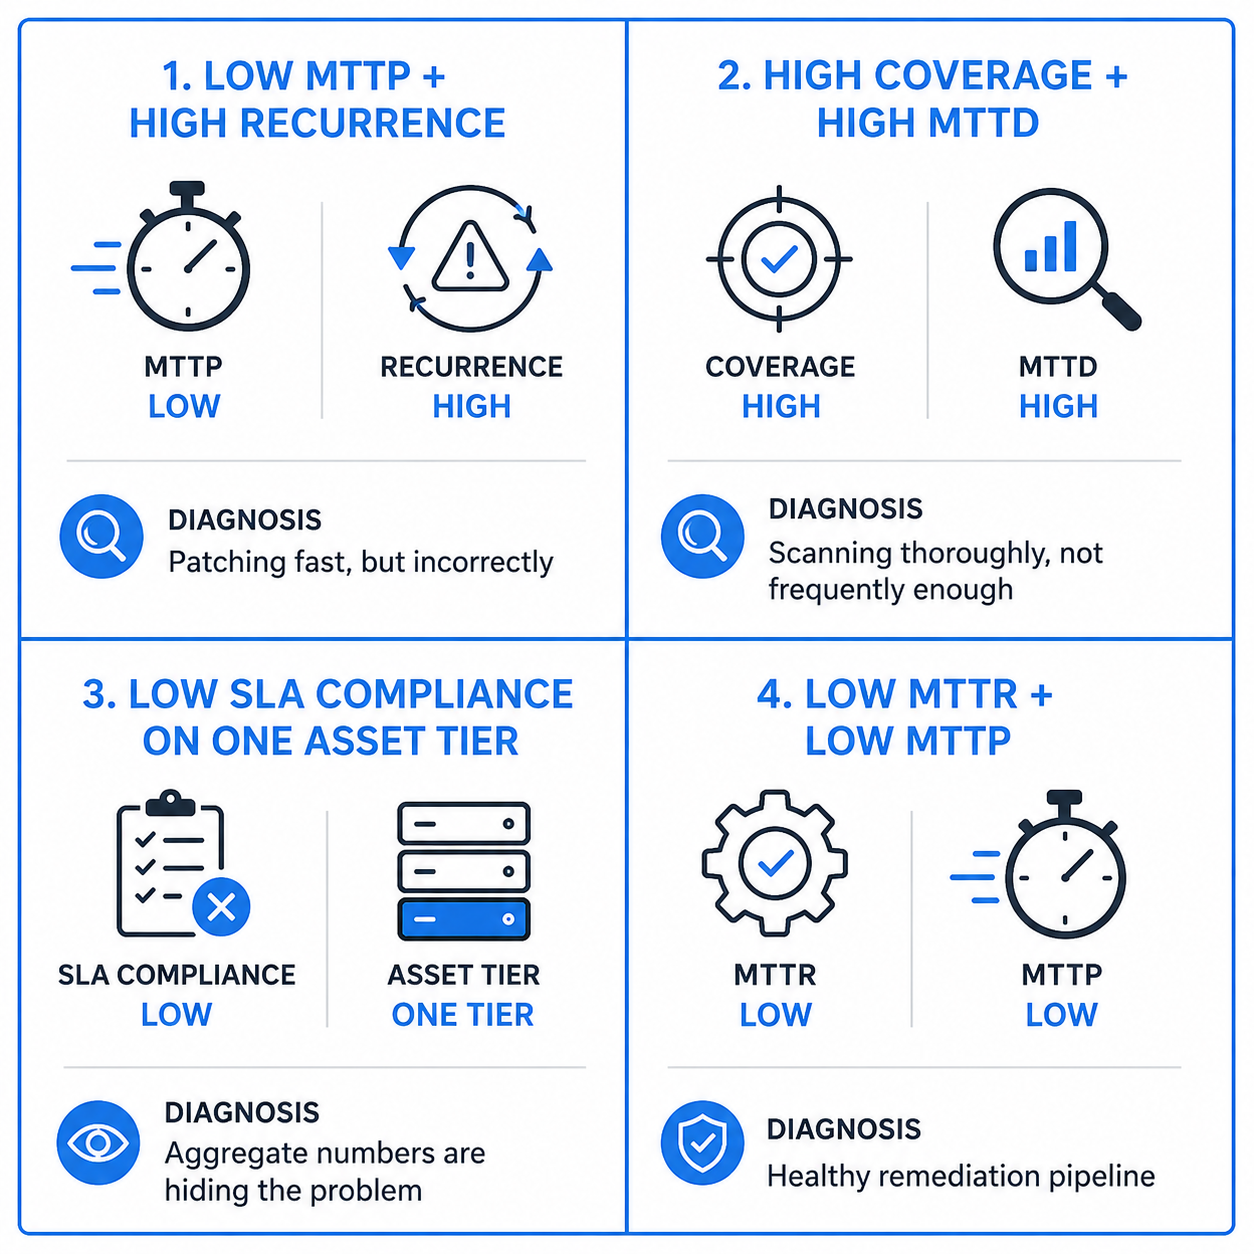
Un chiffre affiché sur un tableau de bord n'est pas une conclusion en soi. C'est un élément qui incite à la réflexion. C'est dans l'interprétation que les indicateurs prennent tout leur sens, généralement en combinant deux d'entre eux pour mettre en évidence ce que chacun d'entre eux, pris isolément, masquerait.
Commencez par examiner les relations plutôt que les chiffres absolus. Un MTTP faible semble excellent jusqu’à ce que vous le compariez au taux de récurrence. Le taux de récurrence correspond à la part des vulnérabilités corrigées qui réapparaissent sur le même actif au cours d’une période donnée ; un taux élevé signifie que les correctifs sont appliqués rapidement mais ne sont pas durables. Une couverture d’analyse élevée associée à un MTTD élevé peut indiquer une fréquence d’analyse insuffisante, ou un autre retard dans le processus de détection, tel que des signatures en retard ou une découverte incomplète des actifs. Un chiffre global de SLA satisfaisant peut masquer une classe d’actifs présentant des retards chroniques ; il convient donc de segmenter les données en fonction de la criticité des actifs et du risque lié aux vulnérabilités avant de crier victoire.
Quelques questions suffisent à transformer ces chiffres en décisions. Le MTTP évolue-t-il dans la bonne direction, ou un seul bon mois a-t-il faussé la moyenne ? Les failles se concentrent-elles sur un groupe d’actifs, un système d’exploitation ou une équipe en particulier ? La rapidité de correction correspond-elle réellement aux indices d’exploitation, ou simplement au score CVSS ? Et quelle part du retard accumulé correspond à une « dette de sécurité » qui a été tacitement acceptée comme permanente ?
Le contexte fait également partie intégrante de votre chaîne d’approvisionnement logicielle. Les vulnérabilités cachées dans les dépendances transitives passent facilement inaperçues, à moins que vos outils ne comprennent l’intégralité du graphe de dépendances, qu’ils résolvent ce graphe directement ou qu’ils utilisent un SBOM. La tolérance au risque dépend également du contexte. Le MTTP acceptable pour un wiki interne n’est pas le même que celui d’un système gérant les dossiers médicaux des patients.
Stratégies d'optimisation de la gestion des vulnérabilités
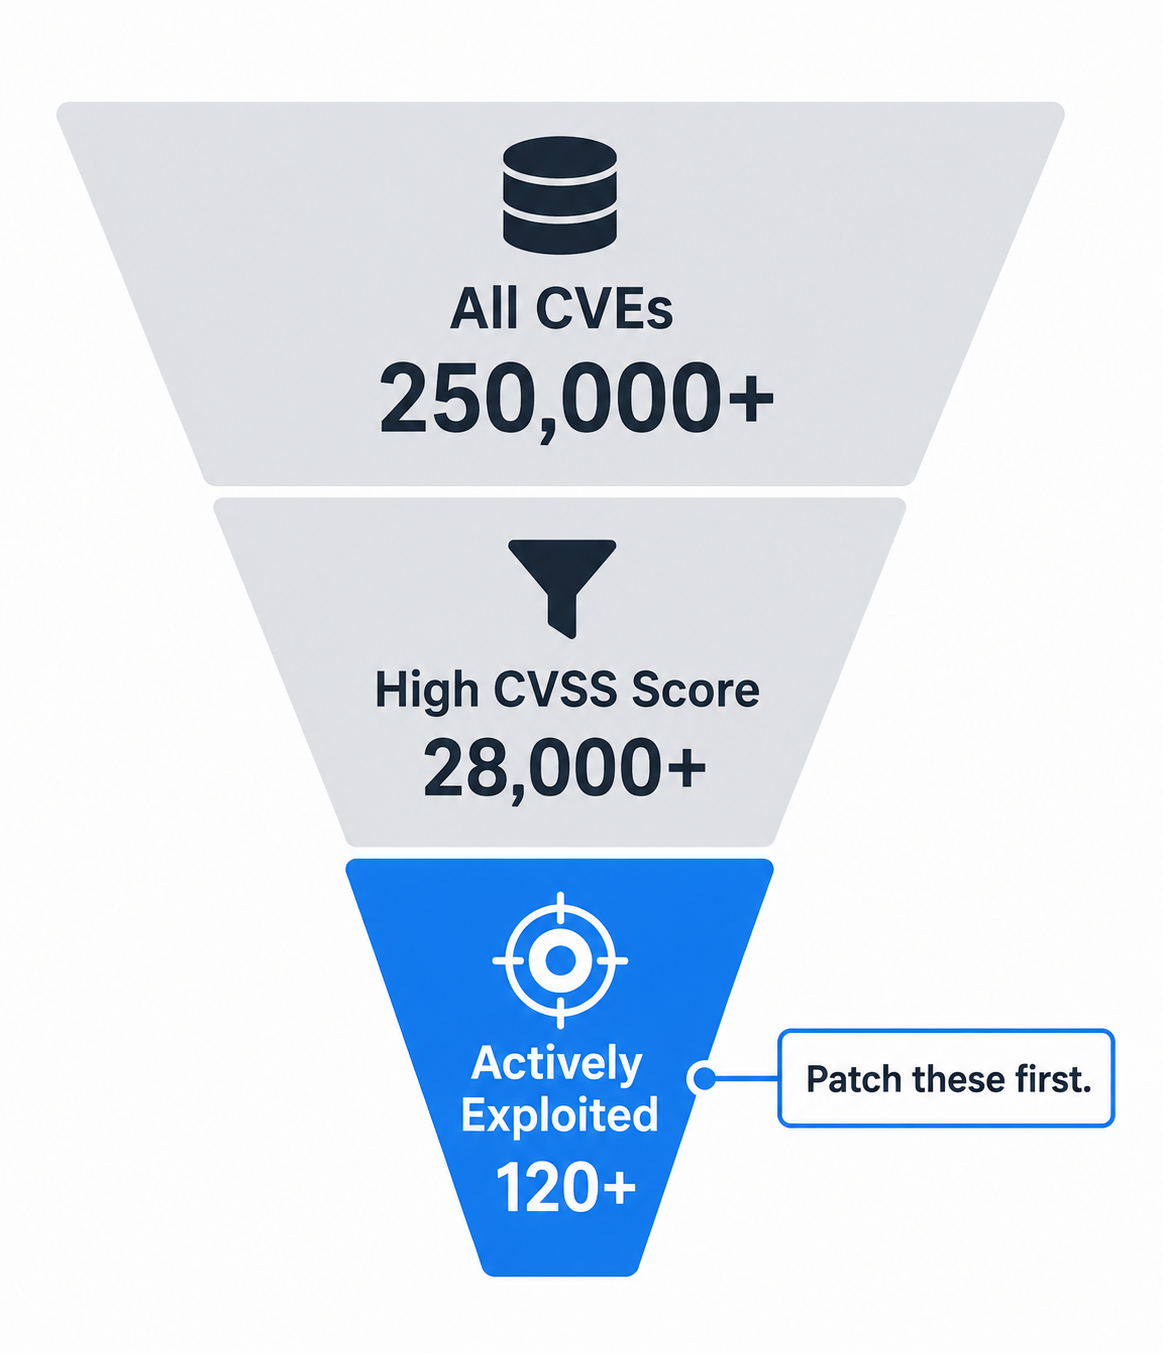
De bons indicateurs vous permettent d'identifier vos points faibles. Ces stratégies vous aideront à gagner en rapidité sans perturber la production ni épuiser votre équipe. Choisissez celle qui correspond à votre indicateur le plus faible et commencez par là.
Hiérarchiser en fonction de l'exploitabilité, et non de la gravité brute
CVSS vous indique le degré de gravité théorique d'une vulnérabilité. Il ne vous indique pas si quelqu'un l'exploite actuellement. Les équipes peuvent se retrouver submergées lorsqu'elles traitent toutes les vulnérabilités critiques avec la même urgence, ce qui rend plus difficile d'identifier celles qui nécessitent réellement une intervention dès ce soir.
Comparez les résultats de votre analyse avec le catalogue des vulnérabilités exploitées connues de la CISA, qui repose spécifiquement sur des preuves attestant qu’une vulnérabilité a été exploitée en conditions réelles. Une faille de gravité moyenne dont l’exploitation est confirmée est plus urgente qu’une faille critique pour laquelle aucune exploitation n’a été signalée. Associez ensuite le CVSS à l’EPSS (Exploit Prediction Scoring System), un modèle d’apprentissage automatique développé par FIRST qui estime la probabilité qu’un CVE publié soit exploité en conditions réelles au cours des 30 prochains jours. Le CVSS décrit la gravité technique, le catalogue KEV recense ce qui a déjà été exploité, et l’EPSS estime ce qui est susceptible d’être exploité prochainement. Ces trois outils répondent à des questions différentes et, ensemble, ils s’avèrent plus efficaces que la seule gravité lorsque vous devez décider ce qui doit être corrigé ce soir et ce qui peut attendre le prochain sprint.
Automatisez les transferts, pas seulement les analyses
Dans de nombreux processus, le MTTR augmente en raison des temps morts entre les différentes étapes. Une analyse se termine, un ticket reste en attente, une validation est en attente. Si les transferts constituent le goulot d'étranglement, l'automatisation de la détection ne suffira pas à elle seule à résoudre le problème.
Intégrer directement les résultats du scanner de sécurité dans le système de gestion des tickets, avec un acheminement en fonction du niveau de gravité et une attribution automatique. Créer automatiquement des demandes de modification pour les correctifs de routine afin que les ingénieurs se contentent de les valider plutôt que de les retranscrire. L’objectif est d’éliminer les lacunes qui font qu’une vulnérabilité reste dans une boîte de réception, car c’est là que les jours s’accumulent sans que l’on s’en rende compte. Les petites lacunes dans les processus se transforment en fenêtres d’exposition importantes plus rapidement que la plupart des équipes ne le pensent.
Associer chaque indicateur à un SLA et à un niveau d'actif
Un indicateur sans objectif n'est qu'une simple curiosité. Fixez des échéances en fonction du niveau de gravité et de la criticité des actifs, puis évaluez le respect de ces échéances plutôt que de vous focaliser sur une moyenne globale.
Définissez concrètement les niveaux de priorité. Les systèmes exposés sur Internet et ceux qui traitent des données sont soumis aux SLA les plus stricts, tandis que les ressources internes de faible valeur bénéficient de SLA plus souples. Cela évite à votre équipe de consacrer autant d'efforts à une passerelle API publique qu'à un environnement de test auquel personne n'accède, et garantit l'exactitude de vos rapports, car les chiffres agrégés ne masquent plus les ressources qui comptent réellement.
Bonnes pratiques pour réduire le MTTP
Réduire le MTTP revient à éliminer les frictions entre la mise en place d’un correctif et sa mise en production. En supprimant la dépendance au redémarrage, on élimine une source majeure de retard partout où cela est possible, ce que permet justement l’application de correctifs à chaud pour les noyaux et les bibliothèques partagées. L’approbation préalable des correctifs à faible risque permet d’exclure totalement les mises à jour de routine de la file d’attente des avis de changement. Le déploiement progressif via un groupe « canari » avant une mise en production à grande échelle vous permet d’agir rapidement sans mettre en jeu l’environnement de production avec un correctif non testé. Il est essentiel de disposer d’un inventaire à jour des actifs, car vous ne pouvez pas corriger rapidement ce dont vous ignorez l’existence. Enfin, établir des priorités en fonction des risques réels signifie que votre réponse la plus rapide est réservée aux vulnérabilités dont on sait qu’elles sont exploitées ou qui sont très susceptibles de l’être.
Choisissez délibérément votre approche par défaut. Si vous pouvez vous accommoder de courtes fenêtres de maintenance, les correctifs classiques assortis de SLA stricts conviennent parfaitement. Si vos charges de travail ne peuvent tolérer aucun temps d'arrêt, la mise à jour à chaud est l'un des moyens les plus efficaces d'atteindre des objectifs MTTP ambitieux sans attendre une fenêtre de maintenance, au même titre que des options telles que les redémarrages progressifs sur un cluster hautement disponible.
Renforcez la gestion des vulnérabilités avec TuxCare
Les indicateurs mettent en évidence le problème. Combler le fossé entre la détection et la protection est la partie la plus difficile, et cela dépend généralement de la rapidité avec laquelle vous pouvez appliquer des correctifs sans perturber la production.
C'est là que réside le problème KernelCare de TuxCare et LibCare comblent, en réduisant le délai entre la mise à disposition d'un correctif de sécurité et son application effective sur un système en fonctionnement. Le support tout au long du cycle de vie comble une autre lacune, à savoir la question de savoir quoi faire lorsque le correctif en amont n'existe plus du tout, en continuant à fournir des correctifs de vulnérabilité après la fin du support du fournisseur.
Si votre indicateur le plus préoccupant est le MTTP sur des systèmes que vous ne pouvez pas redémarrer facilement, c'est exactement là que réside le problème TuxCare a été conçu pour y remédier.
FAQ
Le MTTR est généralement l'indicateur le plus utile, car il rend compte de l'ensemble du processus, de la détection au triage jusqu'à la correction, plutôt que d'une seule étape de celui-ci. Il convient toutefois de le considérer conjointement avec les indicateurs de détection et de couverture. Un MTTR faible n'est pas d'une grande utilité si les vulnérabilités sont détectées trop tardivement ou si une partie importante du parc informatique n'est jamais analysée.
Les indicateurs de gestion des vulnérabilités évaluent l'ensemble du cycle de vie des risques, à savoir la détection, la hiérarchisation et la correction par le biais de correctifs, de modifications de configuration et de suppressions. Les indicateurs de gestion des correctifs ont une portée plus restreinte et se concentrent uniquement sur le déploiement des mises à jour. L'application de correctifs est un outil parmi d'autres dans le cadre de la gestion des vulnérabilités, et non l'ensemble de celle-ci.
Les indicateurs opérationnels tels que le MTTP et la couverture d'analyse sont généralement examinés chaque semaine, et des rapports sur les tendances sont fournis chaque mois ou chaque trimestre à la direction. Il convient de les examiner plus fréquemment en cas d'incidents en cours ou après une mise à jour majeure. La fréquence de ces examens doit correspondre à la vitesse à laquelle les chiffres sous-jacents peuvent réellement évoluer.
Cinq à huit, c'est un bon point de départ. Cela suffit pour couvrir la vitesse, la couverture et la posture face au risque sans se noyer dans des tableaux de bord que personne ne lit. Si un indicateur n'influence jamais une décision, supprimez-le. Chaque chiffre que vous suivez doit déboucher sur une action concrète.