Suporte Técnico
 Documentação
 Entrar
 Entre em contato conosco



Vá direto para um resumo gerado por IA desta postagem do blog 


Principais conclusões
- Métricas de velocidade como MTTP, MTTR e MTTD mostram por quanto tempo um risco real permanece aberto.
- As métricas de cobertura revelam os ativos que ainda ninguém está medindo.
- Analise as métricas em pares, pois um único número pode parecer mais favorável do que realmente é e induzir a erro.
- Cinco a oito métricas vinculadas a decisões reais são melhores do que trinta que não estão vinculadas a nenhuma.
Sua ferramenta de varredura de vulnerabilidades indica que há 4.000 vulnerabilidades abertas em todo o ambiente. Seu gerente faz uma pergunta: estamos melhorando ou piorando? A maioria das equipes não consegue responder a isso com clareza, e a lacuna entre os dados que você coleta e as decisões que você realmente consegue defender é exatamente o que as métricas de gerenciamento de vulnerabilidades existem para preencher. Um conjunto adequado de KPIs indica a rapidez com que você aplica patches, o que está faltando e onde o risco está se acumulando silenciosamente.
Este guia explica quais métricas vale a pena acompanhar, como interpretá-las sem se iludir e como transformá-las em ações concretas.
O que são métricas de gerenciamento de vulnerabilidades?
As métricas de gerenciamento de vulnerabilidades são os números que medem a eficácia com que seu programa identifica, prioriza e corrige falhas de segurança ao longo do tempo. Não se trata da contagem bruta de vulnerabilidades. Qualquer pessoa pode obter esse número a partir de um scanner. Esses números medem o desempenho da sua equipe, ou seja, a rapidez com que vocês detectam e corrigem as falhas, além da abrangência real do seu ambiente que está sendo analisada.
O motivo pelo qual isso se torna cada vez mais importante a cada ano é o volume. O Programa CVE registrou pouco mais de 48.000 registros CVE publicados em 2025, um aumento em relação aos pouco mais de 40.000 em 2024. Uma análise independente dos registros publicados contabilizou mais de 35.000 somente no primeiro semestre de 2026, o que coloca o ano a caminho de bater outro recorde por uma ampla margem. Nenhuma equipe corrige tudo. As métricas são o que determinam o que deve ser priorizado e por que essa decisão foi justificável.
A maioria dos programas monitora três categorias. As métricas de velocidade abrangem a rapidez com que você detecta uma vulnerabilidade e a encaminha para a correção — é nesse contexto que se enquadram o MTTD, o MTTR e o MTTP. As métricas de cobertura abrangem a porcentagem da sua superfície de ataque que você está realmente verificando e quantas correções são concluídas dentro do prazo. As métricas de postura de risco descrevem o perfil das suas vulnerabilidades pendentes por gravidade, explorabilidade e tempo de existência.
Uma observação importante. O total de vulnerabilidades encontradas é a métrica mais solicitada pelos executivos e na qual os engenheiros devem confiar menos. Esse número aumenta quando se aprimora a varredura e diminui quando se interrompe a busca. Por si só, ele mede a atividade, não a segurança.
Como o acompanhamento das métricas de vulnerabilidade leva a melhores decisões de segurança
As métricas fazem com que um programa de segurança passe de simplesmente dar o melhor de si para saber exatamente onde está havendo lentidão. Essa mudança da intuição para as evidências é o ponto principal.
A visibilidade vem em primeiro lugar, pois não é possível melhorar um número que não se monitora. A ação vem em seguida, pois um aumento no MTTP em hosts expostos à Internet indica exatamente onde concentrar os esforços. Os resultados vêm por último, quando é possível demonstrar, trimestre a trimestre, que os bugs críticos agora são resolvidos em dias, em vez de semanas.
Quando monitoradas de forma consistente, as métricas oferecem uma resposta fundamentada sobre se o programa está melhorando, com base em linhas de tendência, e não em impressões subjetivas. Elas classificam o trabalho de acordo com o risco real, e não com base em quem abriu o ticket mais veemente. Elas sinalizam alertas precoces quando a aplicação de correções de vulnerabilidades estão ficando para trás em um grupo específico de ativos. Além disso, facilitam as discussões sobre orçamento, pois a correção demorada tem um custo financeiro que pode ser quantificado.
Se você deseja terceirizar ou fortalecer suas capacidades de correção de vulnerabilidades, confira nossa análise das melhores opções de prestadores de serviços de gerenciamento de vulnerabilidades.
Principais métricas de gerenciamento de vulnerabilidades a serem monitoradas
Você não precisa de trinta métricas. Você precisa das cinco a oito que se relacionam diretamente com uma decisão. Aqui está o conjunto essencial.
| Métrico | O que ele mede | Por que isso é importante |
| MTTP | Média de dias entre a disponibilidade da correção e sua ativação em produção | Mostra com que rapidez você corrige vulnerabilidades conhecidas |
| MTTR | Média de dias entre a detecção e a correção total | Registra toda a resposta, não apenas a etapa de correção |
| MTTD | Média de dias entre o momento em que uma vulnerabilidade se torna detectável e o momento em que é identificada | Revela lacunas na frequência e na cobertura das varreduras |
| Cobertura da digitalização | Porcentagem dos ativos efetivamente verificados | Ativos não verificados representam um risco não quantificado |
| Conformidade com o SLA de correção de falhas | Porcentagem de vulnerabilidades corrigidas dentro do prazo | Transforma a política em algo que você pode auditar |
MTTP (Tempo Médio até a Aplicação do Patch)
Não existe uma definição única do MTTP no setor; portanto, defina a sua antes de apresentá-la. Neste guia, MTTP significa o tempo médio entre o momento em que um patch fica disponível e o momento em que ele passa a estar ativo em produção. Outras equipes começam a contar o tempo a partir da divulgação ou da detecção. Qualquer uma dessas opções é válida. Misturar as duas, porém, não é.
Preste muita atenção ao ponto de partida, pois medir a partir do evento errado exagera o número e oculta a exposição real. Seja qual for a definição escolhida, mantenha-a consistente em todos os relatórios que venham a ser comparados.
Atenção: Um MTTP relatado pode parecer excelente, embora os sistemas que ele descreve ainda estejam expostos. Se suas ferramentas tratam a instalação do pacote como o ponto final, uma correção no kernel ou na biblioteca compartilhada pode permanecer instalada, mas inativa, até a próxima reinicialização do sistema ou do serviço. Instalar e proteger nem sempre ocorrem ao mesmo tempo — e essa lacuna pode passar despercebida em qualquer painel que trate a instalação como a linha de chegada.
É também aqui que ocorrem os falsos positivos se acumulam, já que uma verificação da versão no disco não diz nada sobre o que está realmente carregado.
MTTR (Tempo Médio de Resolução)
O MTTR é mais abrangente do que o MTTP. Ele abrange todo o ciclo de vida, desde a detecção até a resolução, incluindo a triagem, priorização, testes e implantação. A correção pode significar a aplicação de um patch, mas também pode significar uma alteração de configuração ou a remoção total do componente afetado.
Utilize o MTTR para obter um panorama realista da velocidade de resposta da organização e o MTTP para isolar a etapa de aplicação de patches em si. Se o MTTR for alto enquanto o MTTP for baixo, o gargalo está nas etapas anteriores de triagem e aprovação, e não na implantação.
MTTD (Tempo Médio de Detecção)
O MTTD mede o tempo médio entre o momento em que uma vulnerabilidade se torna detectável em seu ambiente e o momento em que sua organização a identifica. Muitas vezes, trata-se de um problema de cobertura disfarçado de problema de velocidade. Realizar varreduras uma vez por semana já pode, por si só, causar um atraso de até sete dias — com média de cerca de metade desse tempo para as descobertas —, mesmo que ninguém tenha cometido nenhum erro.
A solução geralmente está na frequência das varreduras e em uma melhor identificação de ativos, e não na aplicação mais rápida de patches. Não é possível corrigir o que ainda não foi detectado.
Cobertura da digitalização
A cobertura de varredura é a porcentagem dos seus ativos conhecidos que são verificados dentro do cronograma. É a métrica que identifica o servidor oculto que ninguém desativou e o novo nó que nunca foi registrado.
Uma cobertura inferior a 100% significa que as métricas criadas a partir desses resultados de varredura descrevem apenas parte do ambiente. Se você varrer 80% dos seus ativos, seu MTTP descreverá esses 80%. O quinto restante é um ponto cego onde vulnerabilidades exploráveis podem passar despercebidas.
Conformidade com o SLA de correção de falhas
A conformidade com o SLA é a porcentagem de vulnerabilidades resolvidas dentro do prazo estabelecido. Os prazos variam de acordo com a organização, mas um padrão comum é que as vulnerabilidades de gravidade crítica sejam resolvidas em até 7 dias e as de gravidade alta, em até 30. Isso transforma sua política de aplicação de patches de um simples documento em algo passível de auditoria.
As partes interessadas que não atuam na área de segurança tendem a entender isso imediatamente, pois o texto se parece com um contrato. Quando ocorre uma falha, há um motivo específico e justificável para solicitar recursos. Preste atenção quando o SLA não for cumprido em sistemas que são difíceis de tirar do ar, já que é frequentemente nessas situações que a aplicação de patches sem reinicialização mais compensa.
O que acontece quando a aplicação de patches fica atrasada
A demora na aplicação de patches não é apenas uma questão de higiene. Isso deixa vulnerabilidades exploráveis expostas por mais tempo, e o prazo que você tem para corrigi-las fica cada vez mais curto. Os dados do VulnCheck referentes ao primeiro semestre de 2026 indicam que o tempo médio entre a publicação do CVE e o status KEV é de 80 dias, uma queda em relação aos 120 dias registrados em 2025. O número de explorações conhecidas não está aumentando proporcionalmente ao volume de divulgações, já que a proporção entre KEV e CVE caiu para cerca de 1,4% no mesmo período. As vulnerabilidades que realmente são exploradas estão simplesmente atingindo esse status mais rapidamente.
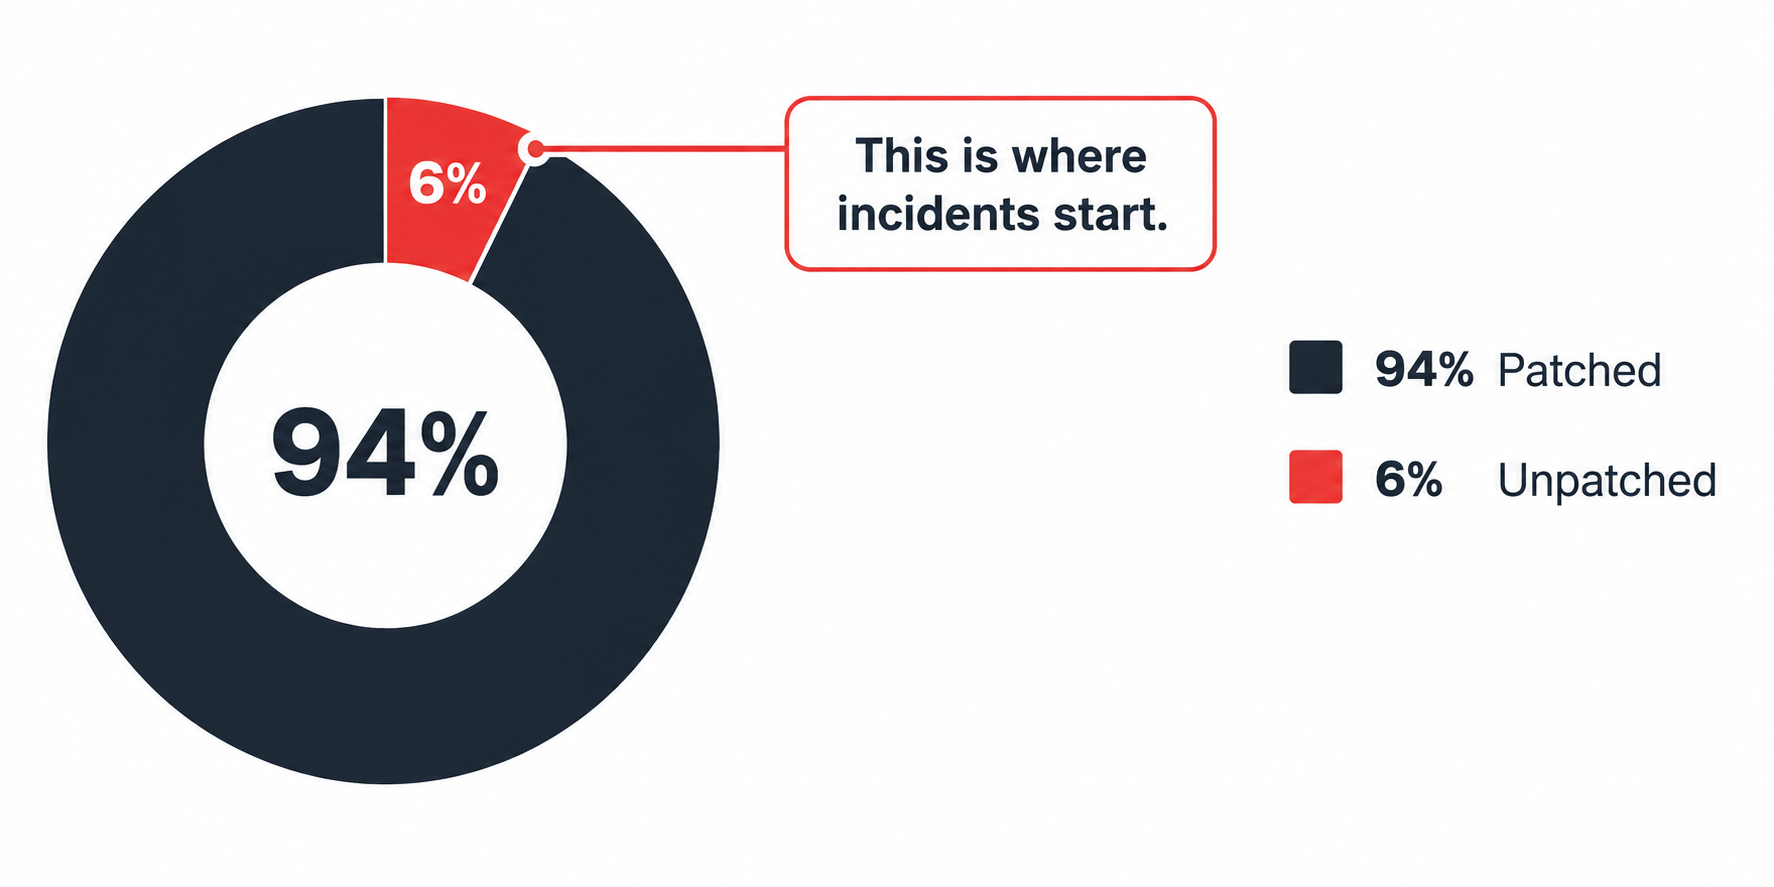
Considere um cenário comum. Um programa relata 94% de conformidade com o SLA, enquanto uma classe de ativos difícil de corrigir — como uma camada de banco de dados ou um parque de dispositivos que precisa ser reiniciado — acumula discretamente a maior parte dos 6% restantes. O painel agregado parece estar em boas condições. É a concentração que representa o risco, e uma média nunca irá mostrar isso a você.
Quando algo dá errado, as consequências raramente são proporcionais ao atraso. A falta de aplicação de um patch no sistema errado pode significar uma violação de dados, multas regulatórias ou semanas de trabalho de resposta a incidentes que superam em muito qualquer esforço que a aplicação do patch teria exigido.
Existe uma variante mais difícil desse problema, que envolve sistemas no fim de vida útil , nos quais simplesmente não existe patch do fornecedor. Se máquinas Linux legadas estiverem rodando versões sem suporte, essa é exatamente a lacuna o Suporte de Ciclo de Vida Ilimitado foi criado para preencher, garantindo o fornecimento contínuo de patches para CVEs mesmo após o encerramento do período de suporte do fornecedor. O CVE Tracker da TuxCare é um ponto de partida útil, pois mapeia CVEs conhecidos em sistemas operacionais, ambientes de execução, bibliotecas e frameworks em fim de vida, permite filtrar por gravidade, produto, componente e status da correção, e notifica você quando o status de uma correção é alterado.
Correções em tempo real como forma de reduzir o MTTP
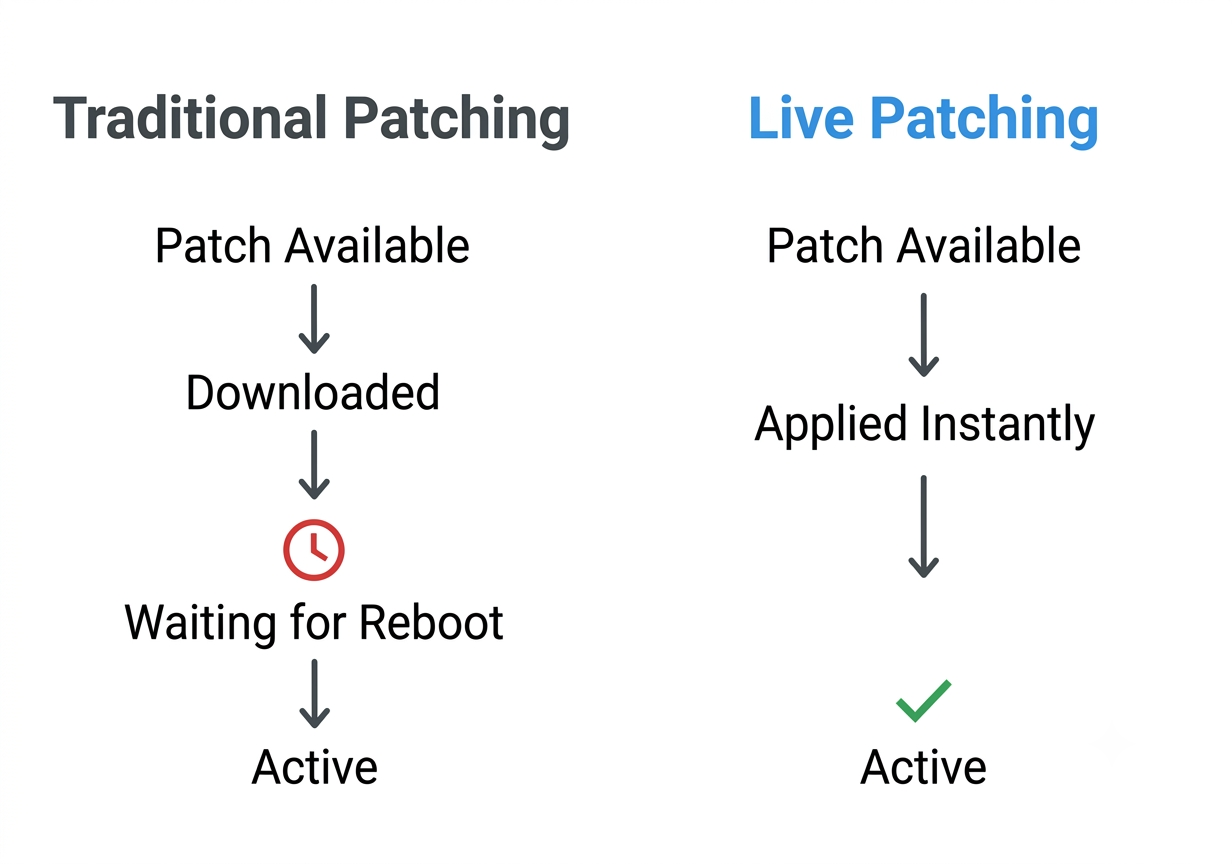
No que diz respeito especificamente à aplicação de patches no kernel, um dos principais motivos para o MTTP disparar é a necessidade de reinicialização. Aplicar patches no kernel da maneira tradicional implica programar um tempo de inatividade, obter aprovação para as alterações e coordenar com todas as equipes responsáveis por uma carga de trabalho naquele servidor. Assim, os patches ficam parados. Às vezes, por semanas.
Aplicação de patches no kernel em tempo real elimina essa dependência ao aplicar correções de segurança a um kernel em execução sem a necessidade de reinicialização. A exposição a uma vulnerabilidade crítica (CVE) no kernel pode ser corrigida em questão de horas, em vez de ficar na fila até a próxima janela de manutenção, e a lacuna entre “instalado, mas inativo” — que aumenta o MTTP — desaparece, pois a correção entra em vigor no momento em que é aplicada.
O KernelCare da TuxCare aplica patches dinâmicos em mais de 70 versões de distribuições prontas para uso, incluindo RHEL, AlmaLinux, Rocky Linux, Ubuntu, Debian, Oracle Linux, CloudLinux e Amazon Linux. Para equipes que executam cargas de trabalho 24 horas por dia, 7 dias por semana, nas quais o agendamento de reinicializações é o verdadeiro gargalo, essa é uma das mudanças de maior impacto disponíveis para o MTTP. O LibCare estende a mesma abordagem a bibliotecas compartilhadas como glibc e OpenSSL, que apresentam sérias vulnerabilidades CVE próprias.
Como interpretar métricas de vulnerabilidade
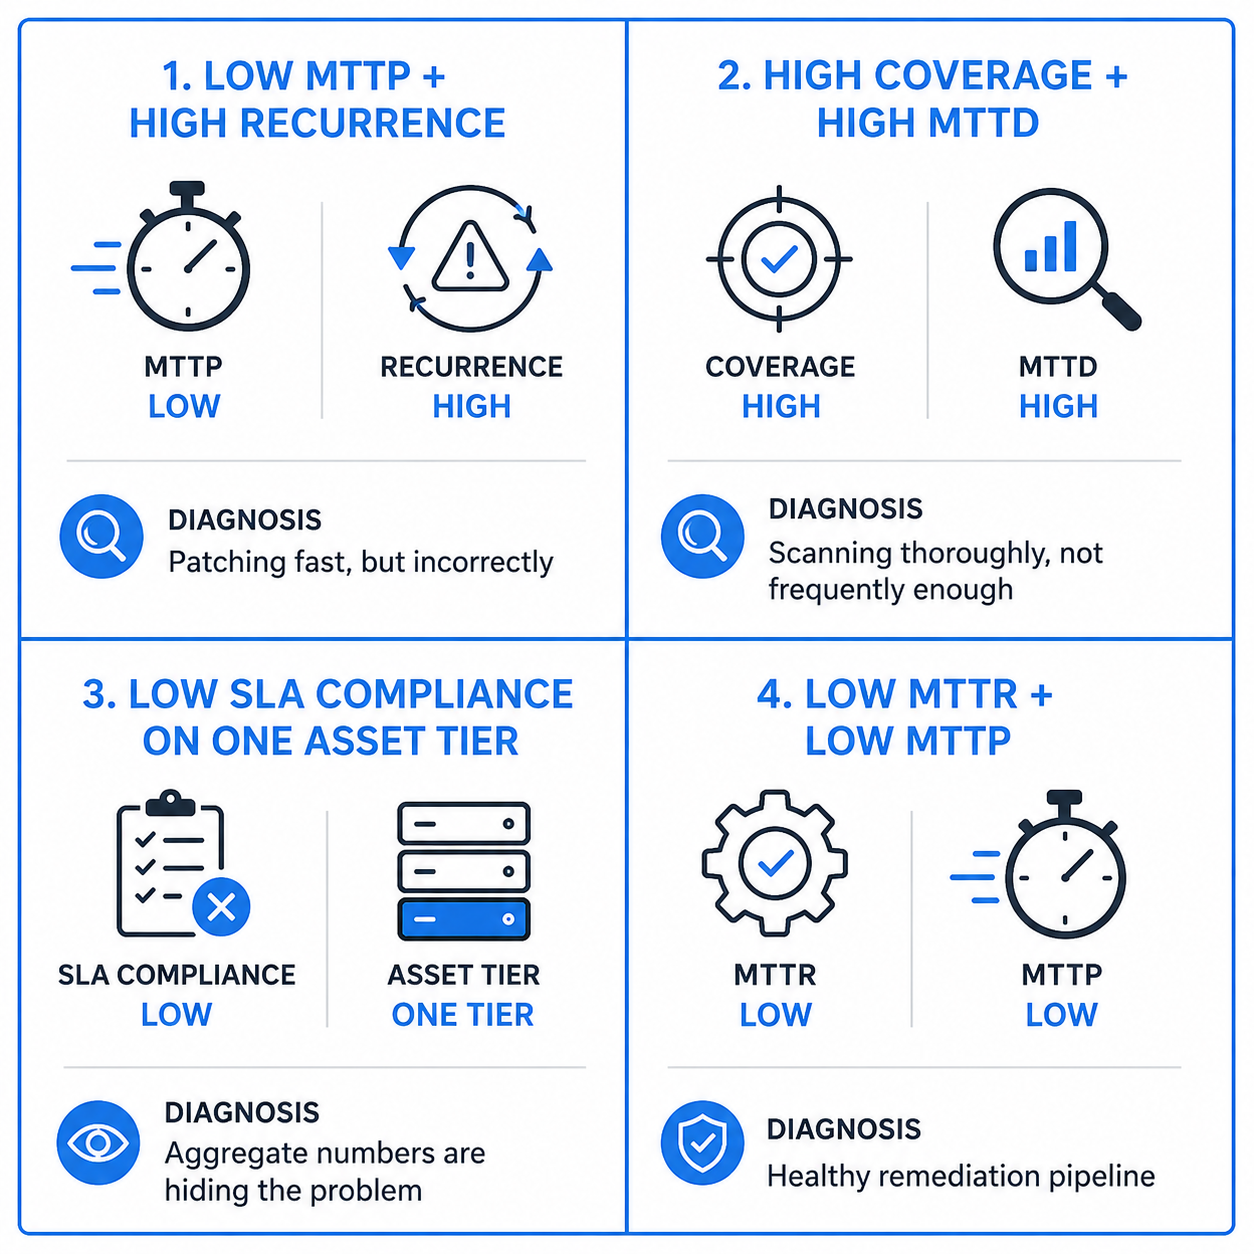
Um número no painel de controle não é uma conclusão. É um indício. É na interpretação que as métricas mostram seu valor, geralmente ao analisar duas delas em conjunto para identificar o que qualquer uma delas, isoladamente, poderia ocultar.
Comece pelas relações, em vez de valores absolutos. Um MTTP baixo parece ótimo até você comparar com a taxa de recorrência. A taxa de recorrência é a proporção de vulnerabilidades corrigidas que reaparecem no mesmo ativo dentro de um intervalo definido, e um valor alto significa que as correções estão sendo aplicadas rapidamente, mas não estão se mantendo. Uma alta cobertura de varredura, aliada a um MTTD alto, pode indicar frequência insuficiente de varredura ou outro atraso no fluxo de detecção, como assinaturas desatualizadas ou descoberta incompleta de ativos. Um número agregado de SLA aparentemente bom pode mascarar uma classe de ativos que apresenta atrasos crônicos; portanto, segmente por criticidade do ativo e risco de vulnerabilidade antes de declarar sucesso.
Algumas perguntas transformam esses números em decisões. O MTTP está evoluindo na direção certa, ou um mês bom distorceu a média? As falhas estão concentradas em um grupo específico de ativos, sistema operacional ou equipe? A velocidade de correção realmente acompanha as evidências de exploração, ou apenas a pontuação CVSS? E qual a parcela do acúmulo de tarefas pendentes que corresponde à dívida de segurança que foi silenciosamente aceita como permanente?
O contexto também está presente na sua cadeia de suprimentos de software. Vulnerabilidades ocultas em dependências transitivas são fáceis de passar despercebidas, a menos que suas ferramentas compreendam o gráfico completo de dependências, seja resolvendo esse gráfico diretamente ou utilizando um SBOM. A tolerância ao risco também depende do contexto. O MTTP aceitável para uma wiki interna não é o mesmo para um sistema que lida com registros de pacientes.
Estratégias de otimização do gerenciamento de vulnerabilidades
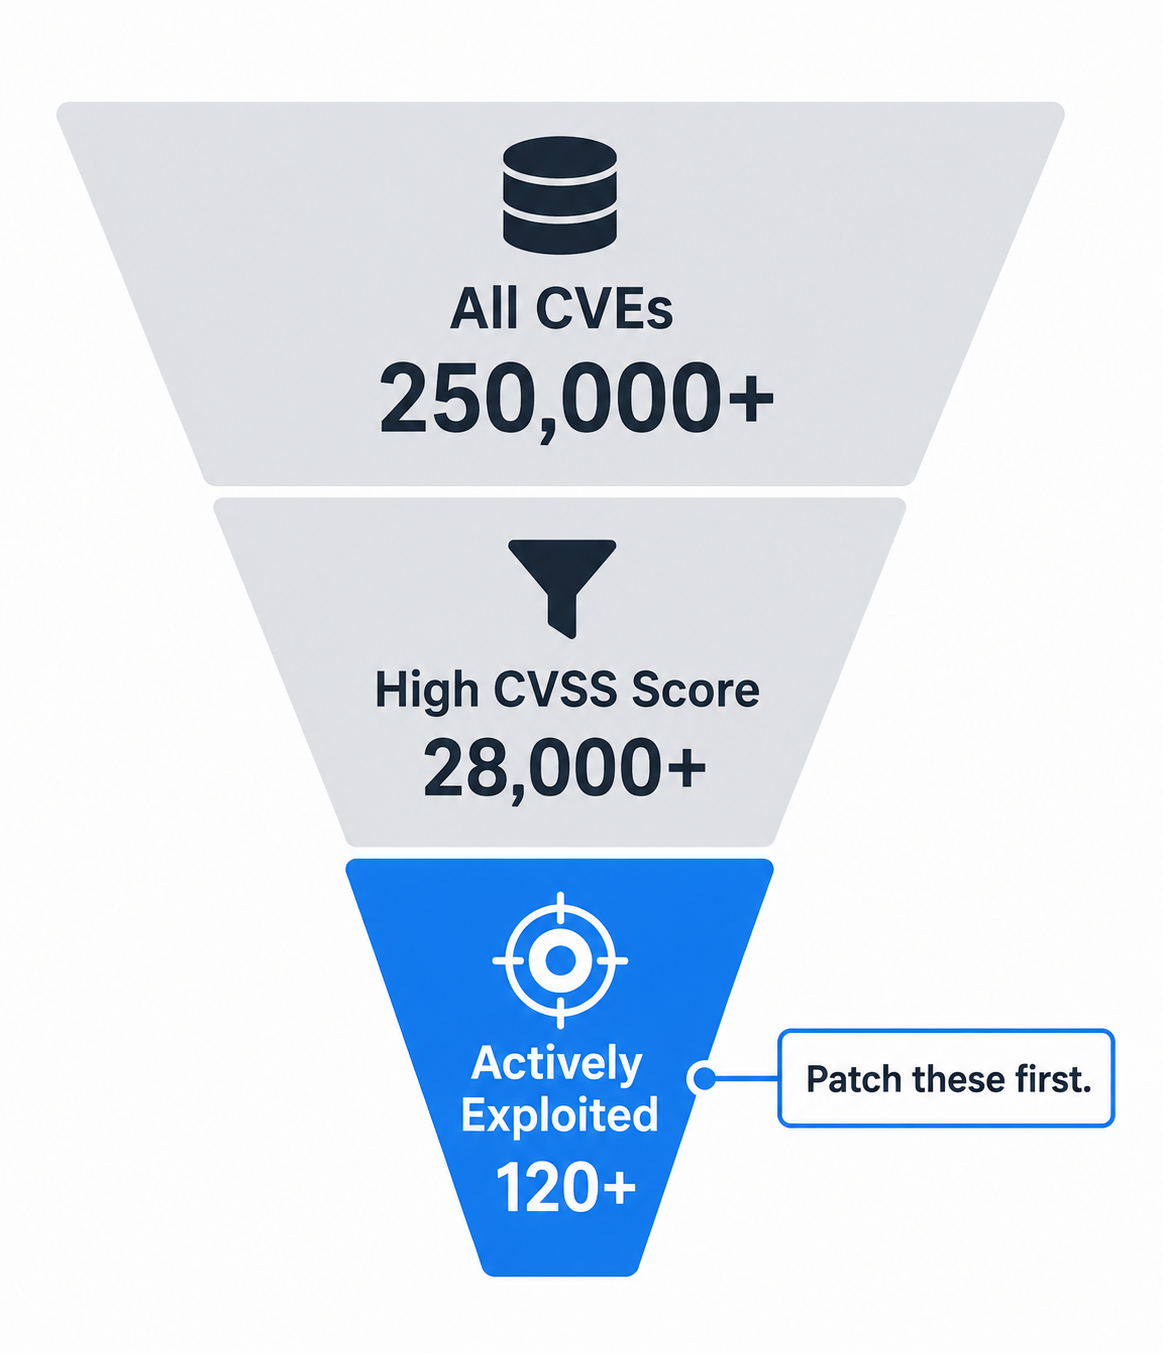
Boas métricas mostram onde você está com lentidão. Essas estratégias são a maneira de você ganhar velocidade sem prejudicar a produção nem esgotar a equipe. Escolha aquela que corresponde à sua pior métrica e comece por aí.
Priorize com base na explorabilidade, e não na gravidade bruta
CVSS indica o quão grave uma vulnerabilidade poderia ser, em teoria. Ele não indica se alguém está explorando essa vulnerabilidade no momento. As equipes podem ficar sobrecarregadas quando tratam todas as vulnerabilidades críticas como igualmente urgentes, o que torna mais difícil identificar quais delas realmente exigem ação ainda hoje à noite.
Compare os resultados do seu scanner com o Catálogo de Vulnerabilidades Exploradas da CISA, que foi criado especificamente com base em evidências de que uma vulnerabilidade já foi explorada na prática. Um bug de gravidade média com exploração confirmada é mais urgente do que um bug crítico sem nenhuma evidência de exploração. Em seguida, combine o CVSS com o EPSS (Exploit Prediction Scoring System), um modelo de aprendizado de máquina da FIRST que estima a probabilidade de um CVE publicado ser explorado na prática nos próximos 30 dias. O CVSS descreve a gravidade técnica, o catálogo KEV registra o que já foi explorado e o EPSS estima o que provavelmente será explorado em seguida. Esses três respondem a perguntas diferentes e, juntos, superam a avaliação da gravidade isoladamente quando você está decidindo o que deve ser corrigido hoje à noite e o que pode esperar até o próximo sprint.
Automatize as transferências, não apenas as digitalizações
Em muitos fluxos de trabalho, o MTTR aumenta devido ao tempo ocioso entre as etapas. Uma verificação é concluída, um ticket fica parado, uma aprovação aguarda. Se as transferências de responsabilidade forem o gargalo, a automação da detecção por si só não resolverá o problema.
Envie os resultados do scanner de código diretamente para o sistema de tickets, com encaminhamento baseado na gravidade e atribuição automática. Crie automaticamente solicitações de alteração para patches de rotina, para que os engenheiros aprovem em vez de terem que transcrever. O objetivo é eliminar as lacunas em que uma vulnerabilidade fica parada na caixa de entrada, pois é lá que os dias se acumulam silenciosamente. Pequenas lacunas nos processos se transformam em grandes janelas de exposição mais rapidamente do que a maioria das equipes imagina.
Vincule cada métrica a um SLA e a um nível de ativo
Uma métrica sem meta é irrelevante. Defina prazos com base na gravidade e na importância dos ativos e, em seguida, avalie o cumprimento desses prazos, em vez de buscar uma média geral.
Defina os níveis de forma concreta. Os sistemas voltados para a Internet e os que lidam com dados recebem os SLAs mais rigorosos, enquanto os ativos internos de baixo valor recebem SLAs mais flexíveis. Isso evita que sua equipe dedique o mesmo esforço a um gateway de API público e a uma máquina de teste que ninguém acessa, além de tornar seus relatórios mais transparentes, pois os números agregados deixam de ocultar os ativos que realmente importam.
Melhores práticas para reduzir o MTTP
Reduzir o MTTP significa eliminar o atrito entre a existência do patch e sua entrada em produção. Eliminar a dependência da reinicialização remove uma importante fonte de atraso sempre que possível, e é isso que a aplicação de patches em tempo real para kernels e bibliotecas compartilhadas oferece. A aprovação prévia de patches de baixo risco mantém as atualizações de rotina totalmente fora da fila de avisos de mudança. Realizar implementações em fase de teste por meio de um grupo “canário” antes de uma implantação em grande escala permite que você aja rapidamente sem arriscar a produção com um patch não testado. Manter um inventário atualizado de ativos é importante, pois não é possível aplicar patches rapidamente no que você nem sabia que possuía. E priorizar com base no risco real significa que sua resposta mais rápida será direcionada às vulnerabilidades que se sabe que estão sendo exploradas ou que têm alta probabilidade de serem exploradas.
Decida deliberadamente qual será sua abordagem padrão. Se você puder tolerar janelas curtas de manutenção, a aplicação convencional de patches com SLAs rigorosos funciona bem. Se suas cargas de trabalho não puderem suportar tempo de inatividade, a aplicação de patches em tempo real é uma das formas mais eficazes de atingir metas agressivas de MTTP sem esperar por uma janela de manutenção, juntamente com opções como reinicializações contínuas em um cluster de alta disponibilidade.
Fortaleça o gerenciamento de vulnerabilidades com a TuxCare
As métricas mostram o problema. Preencher a lacuna entre a detecção e a proteção é a parte mais difícil, e isso geralmente se resume à rapidez com que você consegue aplicar patches sem interromper a produção.
Essa é a lacuna KernelCare da TuxCare e o LibCare preenchem, reduzindo o tempo entre a disponibilização de uma correção de segurança e a ativação dessa correção em um sistema em execução. O Suporte de Ciclo de Vida Ilimitado aborda uma lacuna diferente, que é o que fazer quando a correção do desenvolvedor original já não existe mais, continuando a fornecer patches para vulnerabilidades após o término do suporte do fornecedor.
Se a sua pior métrica for o MTTP em sistemas que não podem ser reiniciados facilmente, esse é exatamente o problema A TuxCare foi desenvolvido para resolver.
Perguntas frequentes
O MTTR costuma ser o indicador mais útil, pois abrange todo o processo — desde a detecção, passando pela triagem, até a correção —, em vez de se limitar a uma única etapa. No entanto, é importante analisá-lo em conjunto com os indicadores de detecção e cobertura. Um MTTR baixo não adianta muito se as vulnerabilidades estiverem sendo identificadas tardiamente ou se uma parte significativa do ambiente nunca for verificada.
As métricas de gerenciamento de vulnerabilidades medem todo o ciclo de vida do risco, que inclui detecção, priorização e correção por meio de patches, alterações de configuração e remoções. As métricas de gerenciamento de patches têm um escopo mais restrito e se concentram apenas na implantação das atualizações. A aplicação de patches é uma ferramenta dentro do gerenciamento de vulnerabilidades, mas não representa a totalidade desse processo.
Métricas operacionais, como MTTP e cobertura de varredura, costumam ser analisadas semanalmente, com relatórios de tendências mensais ou trimestrais para a liderança. Faça análises com maior frequência durante incidentes ativos ou após um lançamento importante. A frequência deve corresponder à velocidade com que o número subjacente pode realmente mudar.
De cinco a oito é um ponto de partida prático. Isso é suficiente para abranger velocidade, cobertura e postura de risco sem se perder em painéis que ninguém lê. Se uma métrica nunca influencia uma decisão, elimine-a. Cada número que você acompanha deve estar vinculado a uma ação.