Soporte técnico
 Documentación
 Inicio de sesión
 Contáctenos



Ir directamente al resumen generado por IA de esta entrada del blog 


Principales conclusiones
- Los indicadores de velocidad como el MTTP, el MTTR y el MTTD muestran cuánto tiempo permanece abierto un riesgo real.
- Las métricas de cobertura ponen de manifiesto los activos que aún nadie está midiendo.
- Analiza las métricas por pares, ya que una sola cifra puede dar una imagen halagadora y, al mismo tiempo, inducir a error.
- Es mejor tener entre cinco y ocho indicadores vinculados a decisiones reales que treinta que no estén vinculados a ninguna.
Tu herramienta de análisis de vulnerabilidades indica que hay 4.000 vulnerabilidades sin resolver en todo el entorno. Tu responsable te hace una pregunta: «¿Estamos mejorando o empeorando?». La mayoría de los equipos no pueden responder a eso con claridad, y la brecha entre los datos que recopilas y las decisiones que realmente puedes defender es precisamente lo que las métricas de gestión de vulnerabilidades pretenden cerrar. Un puñado de indicadores clave de rendimiento (KPI) adecuados te indican la rapidez con la que aplicas los parches, qué te estás dejando y dónde se está acumulando el riesgo de forma silenciosa.
Esta guía explica qué indicadores merece la pena seguir, cómo interpretarlos sin engañarse a uno mismo y cómo convertirlos en medidas concretas.
¿Qué son las métricas de gestión de vulnerabilidades?
Las métricas de gestión de vulnerabilidades son las cifras que miden la eficacia con la que tu programa detecta, prioriza y corrige las debilidades de seguridad a lo largo del tiempo. No se trata del recuento bruto de vulnerabilidades. Cualquiera puede obtener esa cifra con un escáner. Estas cifras miden el comportamiento de tu equipo, es decir, la rapidez con la que detectáis, la rapidez con la que subsanáis y qué parte de vuestro entorno real estáis analizando.
La razón por la que esto cobra cada año más importancia es el volumen. El Programa CVE registró algo más de 48 000 registros CVE publicados en 2025, frente a los poco más de 40 000 de 2024. Un análisis independiente de los registros publicados contabilizó más de 35 000 solo en el primer semestre de 2026, lo que sitúa al año en camino de batir otro récord por un amplio margen. Ningún equipo corrige todo. Las métricas son las que permiten decidir qué tiene prioridad y por qué esa decisión es justificable.
La mayoría de los programas realizan un seguimiento de tres categorías. Las métricas de velocidad miden la rapidez con la que se detecta una vulnerabilidad y se lleva a cabo su corrección, que es donde entran en juego el MTTD, el MTTR y el MTTP. Las métricas de cobertura miden qué parte de la superficie de ataque se analiza realmente y cuántas correcciones se aplican dentro del plazo establecido. Las métricas de exposición al riesgo describen el perfil de las vulnerabilidades pendientes en función de su gravedad, explotabilidad y antigüedad.
Una advertencia. El número total de vulnerabilidades detectadas es la métrica que más solicitan los directivos y en la que menos deberían confiar los ingenieros. Aumenta cuando se mejora el análisis y disminuye cuando se deja de buscar. Por sí sola, mide la actividad, no la seguridad.
Cómo el seguimiento de los indicadores de vulnerabilidad permite tomar mejores decisiones en materia de seguridad
Las métricas permiten que un programa de seguridad pase de hacer lo mejor que puede a saber exactamente en qué aspectos presenta retrasos. Ese cambio, de la intuición a las pruebas, es la clave.
La visibilidad es lo primero, porque no se puede mejorar una cifra que no se supervisa. A continuación viene la acción, porque un aumento del MTTP en los servidores conectados a Internet te indica exactamente dónde debes centrar tus esfuerzos. Los resultados vienen al final, cuando puedes demostrar, trimestre tras trimestre, que los errores críticos ahora se resuelven en días en lugar de semanas.
Si se realizan un seguimiento constante, las métricas ofrecen una respuesta fundamentada sobre si el programa está mejorando, respaldada por líneas de tendencia en lugar de meras impresiones. Clasifican el trabajo según el riesgo real, en lugar de según quién haya planteado la incidencia con más insistencia. Emiten alertas tempranas cuando la aplicación de parches de vulnerabilidad se está retrasando en un grupo concreto de activos. Además, facilitan las conversaciones sobre el presupuesto, ya que una corrección lenta tiene un coste económico que se puede cuantificar.
Si estás pensando en externalizar o reforzar tus capacidades de corrección de vulnerabilidades, puedes consultar nuestro análisis de las mejores opciones de proveedores de servicios de gestión de vulnerabilidades.
Indicadores clave de gestión de vulnerabilidades que hay que supervisar
No necesitas treinta indicadores. Necesitas entre cinco y ocho que se relacionen directamente con una decisión. Este es el conjunto básico.
| Métrico | Lo que mide | Por qué es importante |
| MTTP | Promedio de días desde la disponibilidad del parche hasta su activación en producción | Muestra la rapidez con la que se cierran las brechas conocidas |
| MTTR | Promedio de días desde la detección hasta la resolución completa | Registra toda la respuesta, no solo el paso de parcheo |
| MTTD | Promedio de días transcurridos desde que una vulnerabilidad se vuelve detectable hasta que se detecta | Pone de manifiesto las deficiencias en la frecuencia y la cobertura de los escáneres |
| Cobertura de escaneo | Porcentaje de activos realmente escaneados | Los activos no analizados suponen un riesgo no cuantificado |
| Cumplimiento del acuerdo de nivel de servicio (SLA) en materia de remediación | Porcentaje de vulnerabilidades corregidas dentro del plazo establecido | Convierte la política en algo que se puede auditar |
MTTP (Tiempo medio hasta el parche)
No existe una definición única del MTTP en el sector, así que aclara cuál es la tuya antes de presentarla. En esta guía, el MTTP se refiere al tiempo medio que transcurre entre el momento en que un parche está disponible y el momento en que dicho parche entra en funcionamiento en el entorno de producción. Otros equipos cuentan el tiempo desde la divulgación o desde la detección. Cualquiera de esas opciones es válida. Mezclarlas, en cambio, no lo es.
Presta mucha atención al punto de partida, ya que si se mide a partir de un evento equivocado se exagera la cifra y se oculta la exposición real. Sea cual sea la definición que elijas, utilízala de forma coherente en todos los informes que se vayan a comparar.
Atención: Una MTTP notificada puede parecer excelente, aunque los sistemas que describe sigan estando expuestos. Si tus herramientas consideran que la instalación del paquete es el punto final, una corrección del núcleo o de una biblioteca compartida puede quedar instalada pero inactiva hasta el siguiente reinicio del sistema o del servicio. La instalación y la protección no siempre se producen al mismo tiempo, y esa brecha puede pasar desapercibida en cualquier panel de control que considere la instalación como la meta.
Aquí es también donde se producen los los falsos positivos se acumulan, ya que una comprobación de la versión en el disco no dice nada sobre lo que realmente está cargado.
MTTR (Tiempo medio de remediación)
El MTTR es más amplio que el MTTP. Abarca todo el ciclo de vida, desde la detección hasta la resolución, incluyendo la clasificación, la priorización, las pruebas y la implementación. La corrección puede consistir en aplicar un parche, pero también puede implicar un cambio de configuración o la eliminación total del componente afectado.
Utiliza el MTTR para obtener una imagen fiel de la velocidad de respuesta de la organización, y el MTTP para aislar la propia fase de aplicación de parches. Si el MTTR es elevado mientras que el MTTP es bajo, el cuello de botella se encuentra en las fases previas de clasificación y aprobación, y no en la de implementación.
MTTD (tiempo medio de detección)
El MTTD mide el tiempo medio que transcurre entre el momento en que una vulnerabilidad pasa a ser detectable en tu entorno y el momento en que tu organización la identifica. A menudo se trata de un problema de cobertura disfrazado de problema de velocidad. Si se realizan análisis una vez a la semana, la cadencia por sí sola puede suponer un retraso de hasta siete días —con una media de aproximadamente la mitad de ese tiempo en el conjunto de los hallazgos— sin que nadie haya cometido ningún error.
La solución suele pasar por aumentar la frecuencia de los análisis y mejorar la detección de activos, más que por aplicar parches más rápidamente. No se puede solucionar lo que aún no se ha detectado.
Cobertura de escaneo
La cobertura de análisis es el porcentaje de tus activos conocidos que se analizan según lo previsto. Es la métrica que detecta el servidor «en la sombra» que nadie ha dado de baja y el nuevo nodo que nunca se ha etiquetado.
Una cobertura inferior al 100 % significa que los indicadores que se obtienen a partir de los resultados de esos análisis describen solo una parte del entorno. Si se analiza el 80 % de los activos, el MTTP describe ese 80 %. La quinta parte restante es un punto ciego en el que pueden pasar desapercibidas vulnerabilidades explotables.
Cumplimiento del acuerdo de nivel de servicio (SLA) en materia de remediación
El cumplimiento del SLA es el porcentaje de vulnerabilidades resueltas dentro del plazo asignado. Los plazos varían según la organización, pero lo habitual es que las vulnerabilidades de gravedad crítica se resuelvan en un plazo de 7 días y las de gravedad alta, en un plazo de 30. De este modo, tu política de aplicación de parches pasa de ser un simple documento a convertirse en algo auditable.
Las partes interesadas ajenas al ámbito de la seguridad suelen entenderlo de inmediato, ya que se lee como un contrato. Cuando se incumple, existe una razón concreta y justificada para solicitar recursos. Presta atención cuando el SLA no se cumpla en sistemas que son difíciles de desconectar, ya que suele ser ahí donde la aplicación de parches sin reinicio resulta más útil.
¿Qué ocurre cuando se acumulan los parches pendientes?
La lentitud a la hora de aplicar parches no es solo una cuestión de buenas prácticas de seguridad. Deja expuestas las vulnerabilidades durante más tiempo, y el margen de tiempo para solucionarlas no deja de reducirse. Los datos de VulnCheck correspondientes al primer semestre de 2026 sitúan la mediana del tiempo transcurrido desde la publicación del CVE hasta que se alcanza el estado KEV en 80 días, frente a los 120 días de 2025. La explotación conocida no está aumentando en proporción al volumen de divulgaciones, ya que la relación KEV/CVE se redujo hasta aproximadamente el 1,4 % durante el mismo periodo. Las vulnerabilidades que sí son explotadas simplemente alcanzan ese estado más rápidamente.
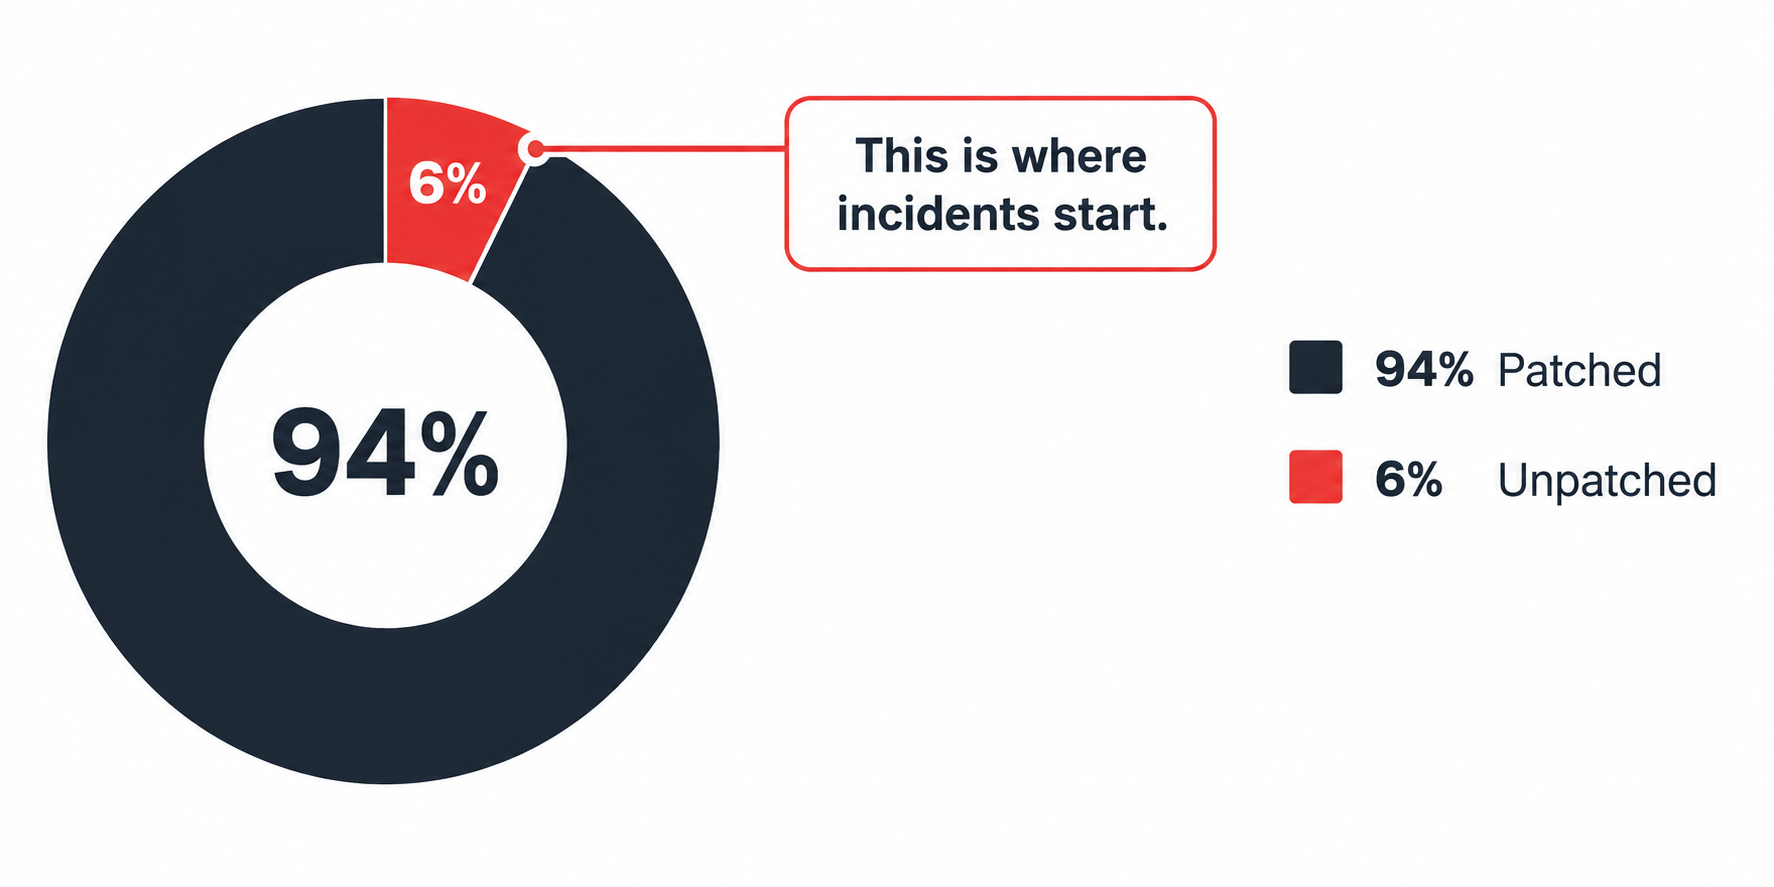
Pensemos en un ejemplo habitual. Un programa indica un cumplimiento del SLA del 94 %, mientras que una clase de activos difícil de actualizar —como un nivel de bases de datos o un parque de dispositivos que necesita reiniciarse— acumula silenciosamente la mayor parte del 6 % restante. El panel de control global parece estar en buen estado. Es precisamente esa concentración la que conlleva el riesgo, y una media nunca te lo mostrará.
Cuando algo sale mal, las consecuencias rara vez son proporcionales al retraso. Un parche que no se haya aplicado en el sistema equivocado puede suponer una filtración de datos, multas reglamentarias o semanas de trabajo de respuesta ante incidentes que eclipsan con creces el esfuerzo que habría supuesto aplicar dicho parche.
Existe una variante más difícil de este problema, que se refiere a sistemas al el final de su ciclo de vida en los que el parche del proveedor simplemente no existe. Si los equipos Linux heredados ejecutan versiones sin soporte, esa es precisamente la laguna Endless Lifecycle Support está diseñado para cubrir, garantizando que sigan llegando parches para CVE una vez que se haya cerrado el plazo de soporte del proveedor. El CVE Tracker de TuxCare es un punto de partida útil, ya que mapea los CVE conocidos en sistemas operativos, entornos de ejecución, bibliotecas y marcos de trabajo que han llegado al final de su vida útil, permite filtrar por gravedad, producto, componente y estado de la corrección, y te notifica cuando cambia el estado de una corrección.
La aplicación de parches en tiempo real como método para reducir el MTTP
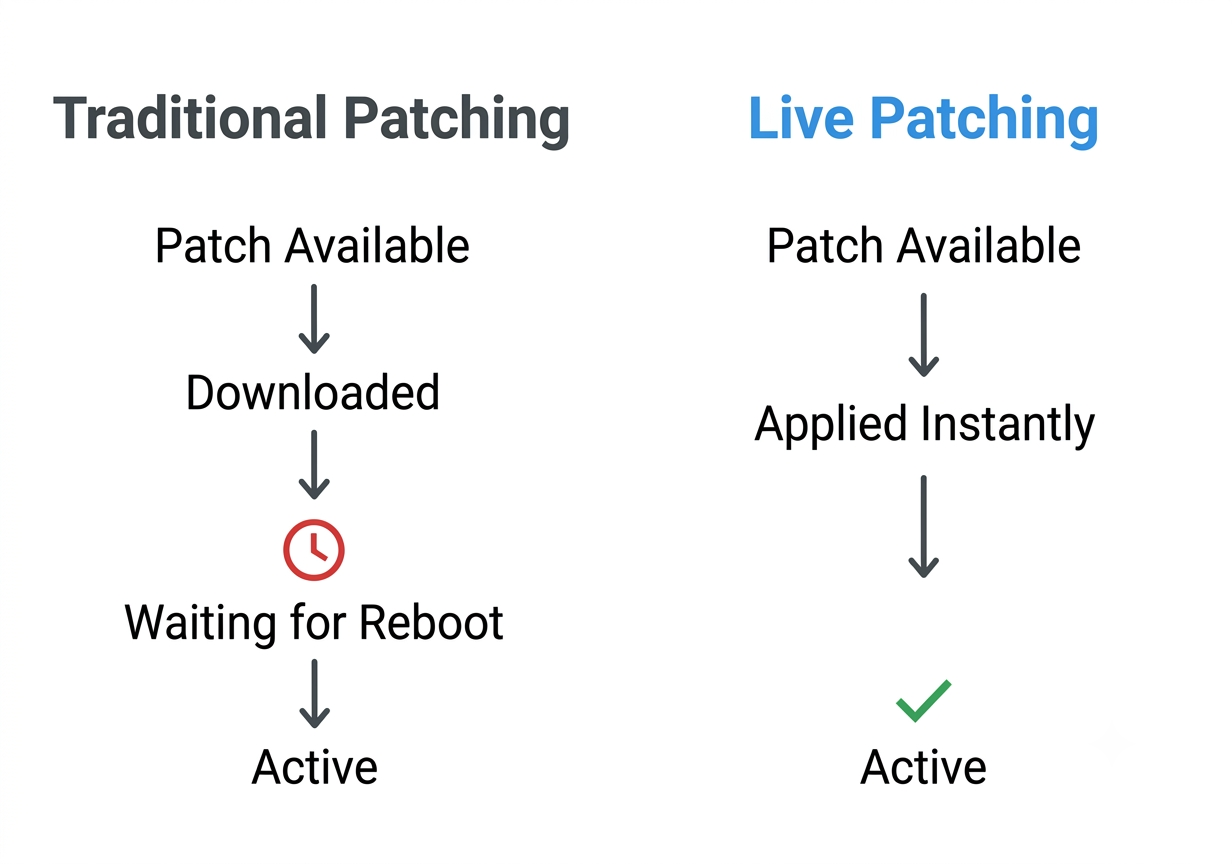
En lo que respecta específicamente a la aplicación de parches al núcleo, una de las principales razones por las que se dispara el MTTP es la necesidad de reiniciar el sistema. Aplicar parches al núcleo de la forma tradicional implica programar un tiempo de inactividad, obtener la aprobación de los cambios y coordinarse con todos los equipos que gestionan una carga de trabajo en ese servidor. Por eso, los parches se quedan a la espera. A veces, durante semanas.
Aplicación de parches al núcleo en tiempo real elimina esa dependencia al aplicar correcciones de seguridad a un kernel en ejecución sin necesidad de reiniciar el sistema. La exposición a una vulnerabilidad crítica del kernel (CVE) puede solucionarse en cuestión de horas, en lugar de tener que esperar en una cola hasta la siguiente ventana de mantenimiento, y desaparece la brecha que supone tener la corrección instalada pero inactiva —y que aumenta el MTTP—, ya que la corrección entra en vigor en el momento en que se aplica.
KernelCare de TuxCare aplica parches en tiempo real a más de 70 versiones de distribuciones sin necesidad de configuración adicional, entre las que se incluyen RHEL, AlmaLinux, Rocky Linux, Ubuntu, Debian, Oracle Linux, CloudLinux y Amazon Linux. Para los equipos que gestionan cargas de trabajo ininterrumpidas, en las que la programación de reinicios supone un verdadero cuello de botella, se trata de uno de los cambios con mayor impacto disponibles para el MTTP. LibCare amplía este mismo enfoque a bibliotecas compartidas como glibc y OpenSSL, que conllevan su propia y grave exposición a vulnerabilidades CVE.
Cómo interpretar las métricas de vulnerabilidad
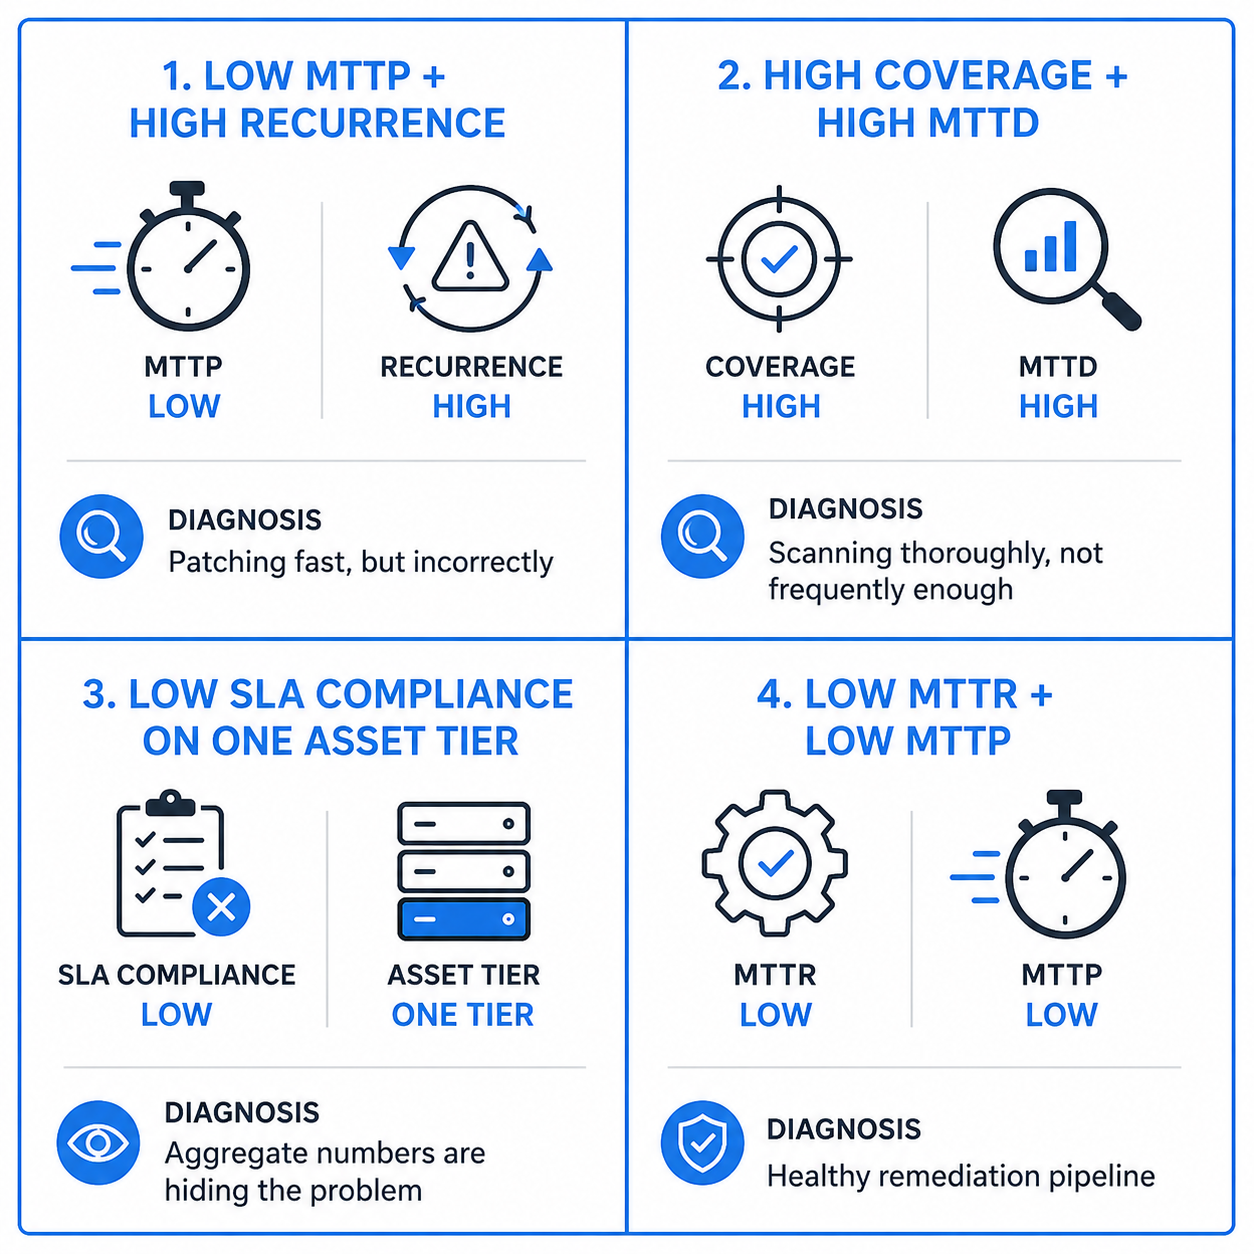
Una cifra en un cuadro de mando no es un resultado. Es una pista. La interpretación es lo que da valor a los indicadores, normalmente al analizar dos de ellos conjuntamente para detectar lo que cualquiera de ellos por sí solo ocultaría.
Empieza por las relaciones en lugar de por los valores absolutos. Un MTTP bajo parece excelente hasta que lo comparas con la tasa de recurrencia. La tasa de recurrencia es el porcentaje de vulnerabilidades corregidas que reaparecen en el mismo activo dentro de un plazo determinado, y una tasa elevada indica que las correcciones se aplican rápidamente pero no son duraderas. Una alta cobertura de análisis junto con un MTTD elevado puede indicar una frecuencia de análisis insuficiente o algún otro retraso en el proceso de detección, como firmas desactualizadas o un descubrimiento incompleto de activos. Una cifra global del SLA sin problemas puede ocultar una clase de activos que sufre retrasos crónicos, por lo que conviene segmentar por criticidad de los activos y riesgo de vulnerabilidad antes de dar por conseguida la victoria.
Unas cuantas preguntas convierten esas cifras en decisiones. ¿El MTTP va por buen camino o simplemente un buen mes ha inflado la media? ¿Los fallos se concentran en un grupo de activos, un sistema operativo o un equipo concretos? ¿La rapidez de corrección se ajusta realmente a las pruebas de explotación o solo a la puntuación CVSS? ¿Y qué parte del volumen de trabajo pendiente corresponde a una deuda de seguridad que se ha aceptado tácitamente como permanente?
El contexto también forma parte de tu cadena de suministro de software. Las vulnerabilidades ocultas en dependencias transitivas son fáciles de pasar por alto a menos que tus herramientas comprendan el gráfico completo de dependencias, tanto si resuelven ese gráfico directamente como si utilizan un SBOM. La tolerancia al riesgo también depende del contexto. El MTTP aceptable para una wiki interna no es el mismo que el de un sistema que gestiona historiales de pacientes.
Estrategias para la optimización de la gestión de vulnerabilidades
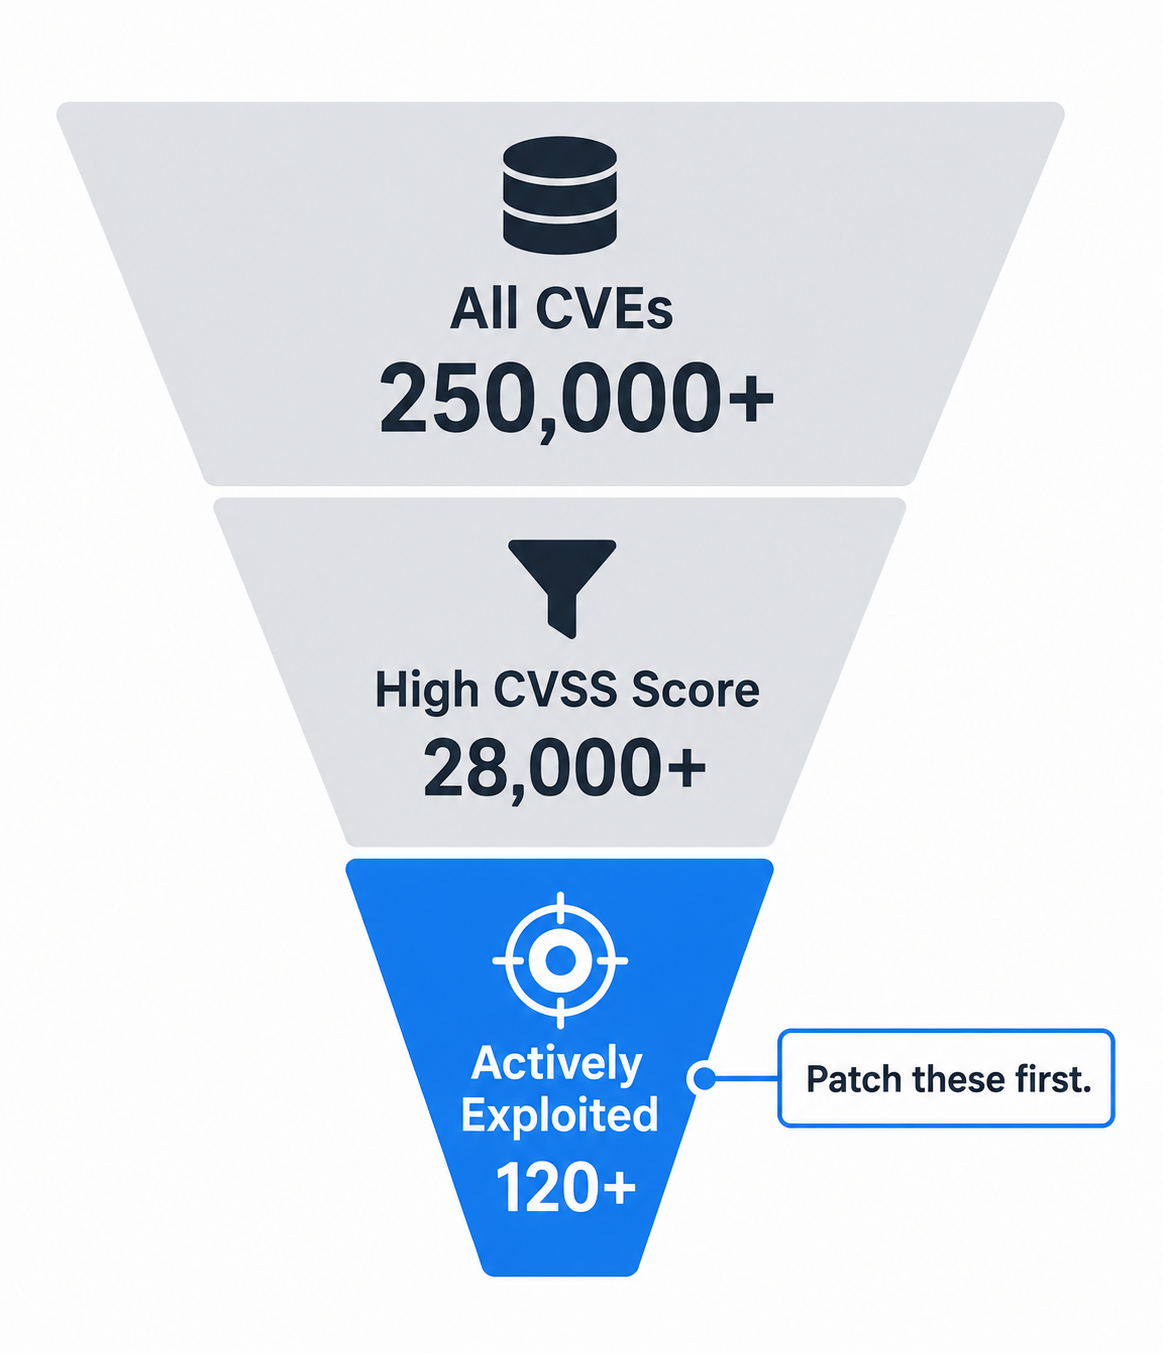
Unas buenas métricas te indican en qué aspectos hay retrasos. Estas estrategias te permiten ganar velocidad sin afectar a la producción ni agotar al equipo. Elige la que se corresponda con tu peor métrica y empieza por ahí.
Priorizar según la explotabilidad, no según la gravedad pura
CVSS indica cuál podría ser, en teoría, la gravedad de una vulnerabilidad. No indica si alguien la está aprovechando en este momento. Los equipos pueden verse desbordados cuando tratan todas las vulnerabilidades críticas con la misma urgencia, lo que dificulta identificar cuáles requieren realmente una intervención inmediata esta misma noche.
Compara los resultados de tu escáner con el Catálogo de vulnerabilidades explotadas de la CISA, que se basa específicamente en pruebas de que una vulnerabilidad ha sido explotada en la red. Un fallo de gravedad media con explotación confirmada es más urgente que un fallo crítico sin nada que lo respalde. A continuación, combina el CVSS con el EPSS (Exploit Prediction Scoring System), un modelo de aprendizaje automático de FIRST que estima la probabilidad de que un CVE publicado sea explotado en la red en los próximos 30 días. El CVSS describe la gravedad técnica, el catálogo KEV registra lo que ya ha sido explotado y el EPSS estima lo que es probable que se explote a continuación. Estos tres elementos responden a preguntas diferentes y, juntos, superan a la gravedad por sí sola a la hora de decidir qué se corrige esta misma noche y qué puede esperar al próximo sprint.
Automatiza los traspasos, no solo los escaneos
En muchos flujos de trabajo, el MTTR aumenta debido al tiempo de inactividad entre los distintos pasos. Se completa un análisis, un ticket queda en espera, se espera una aprobación. Si los traspasos de responsabilidad son el cuello de botella, la automatización de la detección por sí sola no lo solucionará.
Envía los resultados del escáner de cables directamente al sistema de gestión de incidencias, con enrutamiento basado en la gravedad y asignación automática. Crea automáticamente solicitudes de cambio para los parches rutinarios, de modo que los ingenieros solo tengan que aprobarlas en lugar de transcribirlas. El objetivo es eliminar los vacíos en los que una vulnerabilidad permanece en una bandeja de entrada, ya que es ahí donde los días se acumulan silenciosamente. Los pequeños vacíos en los procesos se convierten en grandes ventanas de exposición más rápido de lo que la mayoría de los equipos esperan.
Asociar cada indicador a un SLA y a un nivel de activos
Una métrica sin objetivo es una simple curiosidad. Establece plazos en función de la gravedad y la importancia de los activos, y luego mide el cumplimiento de dichos plazos en lugar de perseguir una media global.
Define los niveles de forma concreta. Los sistemas expuestos a Internet y los que gestionan datos cuentan con los SLA más estrictos, mientras que los activos internos de bajo valor tienen unos más flexibles. Esto evita que tu equipo dedique el mismo esfuerzo a una pasarela de API pública que a un servidor de pruebas al que nadie accede, y garantiza la veracidad de tus informes, ya que las cifras agregadas dejan de ocultar los activos que realmente importan.
Buenas prácticas para reducir el MTTP
Reducir el MTTP se reduce a eliminar las fricciones entre el momento en que el parche existe y el momento en que se aplica. Eliminar la dependencia del reinicio elimina una fuente importante de retraso siempre que sea posible, que es precisamente lo que te ofrece la aplicación de parches en vivo para kernels y bibliotecas compartidas. La aprobación previa de parches de bajo riesgo mantiene las actualizaciones rutinarias completamente fuera de la cola de avisos de cambios. Realizar implementaciones por fases a través de un grupo «canario» antes de un despliegue general te permite actuar con rapidez sin poner en riesgo el entorno de producción con un parche sin probar. Mantener un inventario actualizado de activos es fundamental, ya que no se puede aplicar rápidamente un parche a algo que no se sabía que se poseía. Y priorizar en función del riesgo real significa que la respuesta más rápida se destina a las vulnerabilidades que se sabe que están siendo explotadas o que es muy probable que lo sean.
Decide deliberadamente tu estrategia predeterminada. Si puedes permitirte breves ventanas de mantenimiento, la aplicación convencional de parches con SLA estrictos funciona bien. Si tus cargas de trabajo no pueden soportar tiempos de inactividad, la aplicación de parches en tiempo real es una de las formas más eficaces de alcanzar objetivos ambiciosos de MTTP sin tener que esperar a una ventana de mantenimiento, junto con opciones como los reinicios progresivos en un clúster de alta disponibilidad.
Mejora la gestión de vulnerabilidades con TuxCare
Las métricas te muestran el problema. Lo más complicado es reducir la brecha entre la detección y la protección, y normalmente todo se reduce a la rapidez con la que se pueden aplicar los parches sin interrumpir la producción.
Esa es la diferencia KernelCare de TuxCare y LibCare cubren, al reducir el tiempo que transcurre entre la publicación de una corrección de seguridad y su aplicación en un sistema en funcionamiento. El soporte de ciclo de vida ilimitado aborda otra carencia, a saber, qué hacer cuando la corrección del desarrollador original ya no existe, al seguir proporcionando parches para vulnerabilidades una vez finalizado el soporte del proveedor.
Si tu peor indicador es el MTTP en sistemas que no se pueden reiniciar fácilmente, ese es precisamente el problema TuxCare se ha diseñado para resolverlo.
Preguntas frecuentes
El MTTR suele ser la cifra más útil, ya que refleja el proceso completo, desde la detección hasta la clasificación y la corrección, en lugar de limitarse a una sola fase del mismo. No obstante, hay que analizarlo junto con la detección y la cobertura. Un MTTR bajo no sirve de mucho si las vulnerabilidades se detectan tarde o si una parte importante del entorno nunca se somete a análisis.
Las métricas de gestión de vulnerabilidades miden todo el ciclo de vida del riesgo, es decir, la detección, la priorización y la corrección mediante parches, cambios de configuración y eliminaciones. Las métricas de gestión de parches tienen un alcance más limitado y se centran únicamente en la implementación de las actualizaciones. La aplicación de parches es una herramienta más dentro de la gestión de vulnerabilidades, pero no lo abarca todo.
Las métricas operativas, como el MTTP y la cobertura de análisis, suelen revisarse semanalmente, y se elaboran informes de tendencias mensuales o trimestrales para la dirección. Se deben revisar con mayor frecuencia durante incidentes activos o tras un lanzamiento importante. La periodicidad debe ajustarse a la rapidez con la que puede variar realmente la cifra subyacente.
De cinco a ocho es un punto de partida práctico. Es suficiente para abarcar la velocidad, la cobertura y la exposición al riesgo sin ahogarse en paneles de control que nadie lee. Si una métrica nunca influye en una decisión, elimínala. Cada cifra que se supervise debe traducirse en una acción.