Technischer Support
 Dokumentation
 Anmeldung
 Kontakt



Gehen Sie direkt zu einer KI-Zusammenfassung dieses Blogbeitrags 


Wichtigste Erkenntnisse
- Geschwindigkeitskennzahlen wie MTTP, MTTR und MTTD geben Aufschluss darüber, wie lange ein tatsächliches Risiko besteht.
- Abdeckungskennzahlen decken die Vermögenswerte auf, die bisher noch niemand misst.
- Betrachten Sie Kennzahlen immer im Zusammenhang, denn eine einzelne Zahl kann täuschen und irreführen.
- Fünf bis acht Kennzahlen, die mit konkreten Entscheidungen verknüpft sind, sind besser als dreißig, die mit keiner Entscheidung verknüpft sind.
Ihr Tool zum Scannen von Sicherheitslücken zeigt an, dass es in der gesamten Infrastruktur 4.000 offene Schwachstellen gibt. Ihr Vorgesetzter stellt eine Frage: Wird es besser oder schlechter? Die meisten Teams können diese Frage nicht eindeutig beantworten, und genau diese Lücke zwischen den von Ihnen erfassten Daten und den Entscheidungen, die Sie tatsächlich begründen können, soll durch Kennzahlen zum Schwachstellenmanagement geschlossen werden. Mit den richtigen wenigen KPIs erfahren Sie, wie schnell Sie Patches installieren, was Ihnen entgeht und wo sich Risiken unbemerkt anhäufen.
Dieser Leitfaden erklärt, welche Kennzahlen es wert sind, verfolgt zu werden, wie man sie richtig interpretiert, ohne sich etwas vorzumachen, und wie man sie in konkrete Maßnahmen umsetzt.
Was sind Kennzahlen zum Schwachstellenmanagement?
Kennzahlen zum Schwachstellenmanagement sind die Werte, die messen, wie gut Ihr Programm im Laufe der Zeit Sicherheitslücken aufspürt, priorisiert und behebt. Es geht nicht um die reine Anzahl der Schwachstellen. Diese kann jeder mit einem Scanner ermitteln. Diese Kennzahlen messen das Verhalten Ihres Teams, d. h. wie schnell Sie Schwachstellen erkennen, wie schnell Sie diese beheben und wie viel Ihrer tatsächlichen Umgebung Sie überhaupt überprüfen.
Der Grund, warum dies von Jahr zu Jahr an Bedeutung gewinnt, ist das Volumen. Das CVE-Programm verzeichnete im Jahr 2025 etwas mehr als 48.000 veröffentlichte CVE-Einträge, gegenüber etwas mehr als 40.000 im Jahr 2024. Eine unabhängige Analyse der veröffentlichten Einträge ergab allein im ersten Halbjahr 2026 mehr als 35.000 Einträge, womit das Jahr auf dem besten Weg ist, mit großem Abstand einen neuen Rekord aufzustellen. Kein Team behebt alle Schwachstellen. Anhand von Kennzahlen entscheiden Sie, was Vorrang hat und warum diese Entscheidung vertretbar war.
Die meisten Programme erfassen drei Bereiche. Die Geschwindigkeitskennzahlen geben an, wie schnell Sie eine Schwachstelle erkennen und deren Behebung vorantreiben – hier kommen MTTD, MTTR und MTTP ins Spiel. Die Abdeckungskennzahlen geben an, wie viel Ihrer Angriffsfläche Sie tatsächlich scannen und wie viele Korrekturen innerhalb der vorgegebenen Frist umgesetzt werden. Die Kennzahlen zur Risikosituation beschreiben die Zusammensetzung Ihrer offenen Schwachstellen nach Schweregrad, Ausnutzbarkeit und Alter.
Ein Hinweis zur Vorsicht. Die Gesamtzahl der gefundenen Schwachstellen ist die Kennzahl, die Führungskräfte am häufigsten anfordern und der Ingenieure am wenigsten vertrauen sollten. Sie steigt, wenn man das Scannen verbessert, und sinkt, wenn man aufhört zu suchen. Für sich genommen misst sie die Aktivität, nicht die Sicherheit.
Wie die Erfassung von Schwachstellenkennzahlen zu besseren Sicherheitsentscheidungen führt
Metriken sorgen dafür, dass ein Sicherheitsprogramm nicht mehr nur sein Bestes gibt, sondern genau erkennt, wo es Schwachstellen gibt. Dieser Wechsel vom Bauchgefühl hin zu fundierten Erkenntnissen ist der springende Punkt.
Transparenz steht an erster Stelle, denn man kann keine Kennzahl verbessern, die man nicht erfasst. Dann folgen Maßnahmen, denn ein steigender MTTP-Wert auf Hosts mit Internetanbindung zeigt Ihnen genau, worauf Sie Ihren Fokus richten müssen. Die Ergebnisse kommen zuletzt, wenn Sie Quartal für Quartal nachweisen können, dass kritische Fehler nun innerhalb von Tagen statt Wochen behoben werden.
Bei konsequenter Erfassung liefern Kennzahlen eine fundierte Antwort auf die Frage, ob sich das Programm verbessert – gestützt auf Trendlinien statt auf subjektive Eindrücke. Sie ordnen die Aufgaben nach dem tatsächlichen Risiko ein und nicht danach, wer das lauteste Ticket eingereicht hat. Sie zeigen frühzeitig Warnsignale auf, wenn das Schließen von Sicherheitslücken bei einer bestimmten Asset-Gruppe in Verzug gerät. Und sie erleichtern Budgetgespräche, da langsame Behebungsmaßnahmen mit konkret bezifferbaren Kosten verbunden sind.
Wenn Sie Ihre Behebungsmaßnahmen auslagern oder ausbauen möchten, können Sie sich unsere Übersicht über die besten Anbieter von Schwachstellenmanagement-Dienstleistungen ansehen.
Wichtige Kennzahlen zum Schwachstellenmanagement, die es zu überwachen gilt
Sie brauchen keine dreißig Kennzahlen. Sie brauchen die fünf bis acht, die sich direkt auf eine Entscheidung beziehen. Hier ist der Kernsatz.
| Metrisch | Was es misst | Warum es wichtig ist |
| MTTP | Durchschnittliche Anzahl der Tage von der Verfügbarkeit des Patches bis zur Aktivierung in der Produktion | Zeigt an, wie schnell Sie bekannte Sicherheitslücken schließen |
| MTTR | Durchschnittliche Anzahl der Tage vom Erkennen des Problems bis zur vollständigen Behebung | Erfasst die gesamte Reaktion, nicht nur den Patching-Schritt |
| MTTD | Durchschnittliche Anzahl der Tage vom Zeitpunkt, zu dem eine Sicherheitslücke erkennbar wird, bis zu ihrer Entdeckung | Deckt Lücken bei der Scan-Häufigkeit und der Abdeckung auf |
| Scan-Abdeckung | Prozentualer Anteil der tatsächlich gescannten Vermögenswerte | Nicht gescannte Vermögenswerte stellen ein ungemessenes Risiko dar |
| Einhaltung der SLA-Vorgaben für die Fehlerbehebung | Prozentualer Anteil der innerhalb der Frist behobenen Sicherheitslücken | Macht Richtlinien zu etwas, das Sie prüfen können |
MTTP (Mittlere Zeit bis zum Patch)
Es gibt keine einheitliche branchenweite Definition von MTTP, daher sollten Sie sich vor der Berichterstattung auf eine Definition festlegen. In diesem Leitfaden bezeichnet MTTP die durchschnittliche Zeit zwischen der Verfügbarkeit eines Patches und dessen Inbetriebnahme in der Produktion. Andere Teams beginnen die Zeitmessung erst bei der Offenlegung oder bei der Erkennung. Jede dieser Methoden ist zulässig. Eine Mischung aus beiden ist jedoch nicht zulässig.
Achten Sie genau auf den Ausgangspunkt, denn wenn Sie von einem falschen Ereignis ausgehen, werden die Zahlen geschönt und das tatsächliche Risiko verschleiert. Für welche Definition Sie sich auch entscheiden – wenden Sie sie in allen Berichten einheitlich an, die miteinander verglichen werden sollen.
Achtung: Ein gemeldeter MTTP kann hervorragend aussehen, während die darin beschriebenen Systeme weiterhin ungeschützt sind. Wenn Ihr Tool die Installation des Pakets als Endpunkt betrachtet, kann eine Korrektur für den Kernel oder eine gemeinsam genutzte Bibliothek zwar installiert, aber bis zum nächsten Neustart oder Dienstneustart inaktiv bleiben. „Installiert“ und „geschützt“ finden nicht immer gleichzeitig statt – und diese Lücke kann auf jedem Dashboard unsichtbar bleiben, das die Installation als Ziellinie betrachtet.
Hier treten auch falsche Positive häufen sich an, da eine Versionsprüfung auf der Festplatte nichts darüber aussagt, was tatsächlich geladen ist.
MTTR (Mittlere Zeit bis zur Behebung der Mängel)
MTTR ist umfassender als MTTP. Es deckt den gesamten Lebenszyklus von der Erkennung bis zur Behebung ab, einschließlich Triage und Priorisierung, das Testen und die Bereitstellung. Eine Behebung kann das Installieren eines Patches bedeuten, aber auch eine Konfigurationsänderung oder das vollständige Entfernen der betroffenen Komponente.
Verwenden Sie die MTTR, um ein realistisches Bild der Reaktionsgeschwindigkeit des Unternehmens zu erhalten, und die MTTP, um den Patch-Schritt selbst zu isolieren. Ist die MTTR hoch, während die MTTP niedrig ist, liegt der Engpass eher in der Vorabprüfung und Genehmigung als in der Bereitstellung.
MTTD (Mittlere Zeit bis zum Nachweis)
MTTD misst die durchschnittliche Zeitspanne zwischen dem Zeitpunkt, zu dem eine Schwachstelle in Ihrer Umgebung erkennbar wird, und dem Zeitpunkt, zu dem Ihr Unternehmen sie identifiziert. Oft handelt es sich dabei um ein Abdeckungsproblem, das sich als Geschwindigkeitsproblem tarnt. Bei einem Scan pro Woche kann allein diese Häufigkeit zu einer Verzögerung von bis zu sieben Tagen führen – im Durchschnitt etwa die Hälfte davon –, bevor überhaupt jemand einen Fehler begangen hat.
Die Lösung liegt in der Regel in der Scan-Häufigkeit und einer besseren Erkennung von Systemressourcen und nicht in einer schnelleren Patch-Installation. Was man noch nicht erkannt hat, kann man auch nicht beheben.
Scan-Abdeckung
Die Scan-Abdeckung ist der Prozentsatz Ihrer bekannten Ressourcen, die planmäßig gescannt werden. Diese Kennzahl erfasst sowohl den „Schattenserver“, den niemand außer Betrieb genommen hat, als auch den neuen Knoten, der nie gekennzeichnet wurde.
Eine Abdeckung von unter 100 % bedeutet, dass die Kennzahlen, die Sie aus diesen Scan-Ergebnissen ableiten, nur einen Teil der Umgebung beschreiben. Wenn Sie 80 % Ihrer Ressourcen scannen, beschreibt Ihr MTTP diese 80 %. Das verbleibende Fünftel ist ein toter Winkel, in dem ausnutzbare Schwachstellen unbemerkt bleiben können.
Einhaltung der SLA-Vorgaben für die Fehlerbehebung
Die SLA-Einhaltung ist der Prozentsatz der Schwachstellen, die innerhalb der ihnen zugewiesenen Frist behoben wurden. Die Fristen variieren je nach Organisation, doch üblich ist, dass Schwachstellen mit kritischem Schweregrad innerhalb von 7 Tagen und solche mit hohem Schweregrad innerhalb von 30 Tagen behoben werden. Dadurch wird Ihre Patching-Richtlinie von einem bloßen Dokument zu etwas, das überprüft werden kann.
Akteure außerhalb des Sicherheitsbereichs verstehen dies in der Regel sofort, da es sich wie ein Vertrag liest. Wenn es zu einer Abweichung kommt, gibt es einen konkreten und begründbaren Grund, Ressourcen anzufordern. Achten Sie besonders darauf, wenn SLA-Vorgaben bei Systemen verfehlt werden, die sich nur schwer außer Betrieb nehmen lassen, da genau dort häufig sich das patchen ohne Neustart sich am meisten auszahlt.
Was passiert, wenn man mit den Patches in Verzug gerät?
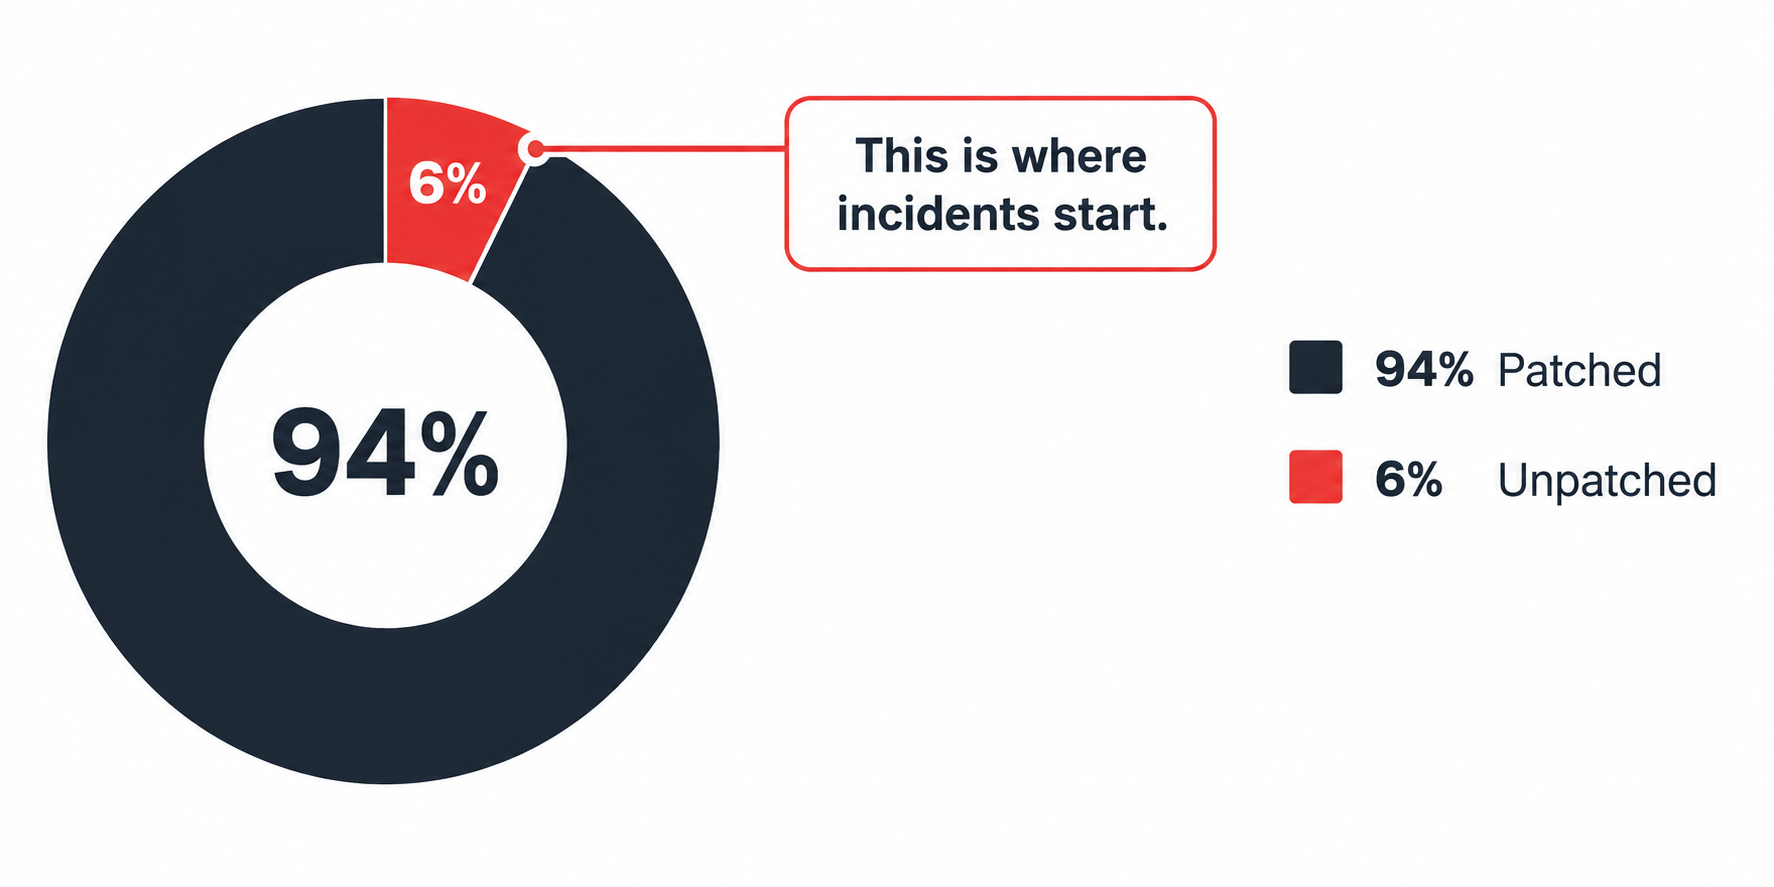
Eine langsame Patch-Verwaltung ist nicht nur ein Problem der IT-Sicherheit. Sie lässt ausnutzbare Schwachstellen länger offen, und das Zeitfenster, in dem Sie diese schließen müssen, wird immer kleiner. Die Daten von VulnCheck für das erste Halbjahr 2026 beläuft sich die Medianzeit von der CVE-Veröffentlichung bis zum KEV-Status auf 80 Tage, gegenüber 120 Tagen im Jahr 2025. Die Anzahl bekannter Ausnutzungen steigt nicht proportional zum Umfang der Offenlegungen, da das KEV-zu-CVE-Verhältnis im gleichen Zeitraum auf etwa 1,4 % gesunken ist. Die Schwachstellen, die tatsächlich ausgenutzt werden, erreichen diesen Status einfach schneller.
Nehmen wir einmal ein bekanntes Szenario: Ein Programm meldet eine SLA-Einhaltung von 94 %, während eine schwer zu patchen Asset-Klasse – beispielsweise eine Datenbankebene oder eine Appliance-Flotte, die einen Neustart benötigt – unbemerkt den Großteil der verbleibenden 6 % ausmacht. Das Gesamtbild im Dashboard sieht gut aus. Doch gerade diese Konzentration birgt das Risiko, und ein Durchschnittswert wird Ihnen das niemals aufzeigen.
Wenn doch einmal etwas schiefgeht, stehen die Folgen selten in einem angemessenen Verhältnis zur Verzögerung. Ein nicht installierter Patch auf dem falschen System kann zu einer Datenpanne, Bußgeldern durch die Aufsichtsbehörden oder wochenlangen Maßnahmen zur Behebung des Vorfalls führen – ein Aufwand, der den Aufwand für die Installation des Patches bei weitem in den Schatten stellt.
Die Risiken, häufige Ursachen und praktische Möglichkeiten, diese Sicherheitslücke zu schließen, werden in unserem Leitfaden zu nicht gepatchten Sicherheitslücken behandelt.
Es gibt eine schwierigere Variante dieses Problems, nämlich Systeme nach dem dem Ende der Lebensdauer , für die es einfach keinen Hersteller-Patch gibt. Wenn ältere Linux-Rechner mit nicht mehr unterstützten Versionen laufen, ist genau das die Lücke Endless Lifecycle Support ausfüllen soll, indem er auch nach Ablauf des Hersteller-Supportzeitraums weiterhin CVE-Patches bereitstellt. Der CVE-Tracker von TuxCare ist ein nützlicher Ausgangspunkt, da er bekannte CVEs über Betriebssysteme, Laufzeitumgebungen, Bibliotheken und Frameworks hinweg abbildet, die Filterung nach Schweregrad, Produkt, Komponente und Behebungsstatus ermöglicht und Sie benachrichtigt, wenn sich der Behebungsstatus ändert.
Live-Patching als Möglichkeit zur Verkürzung der MTTP
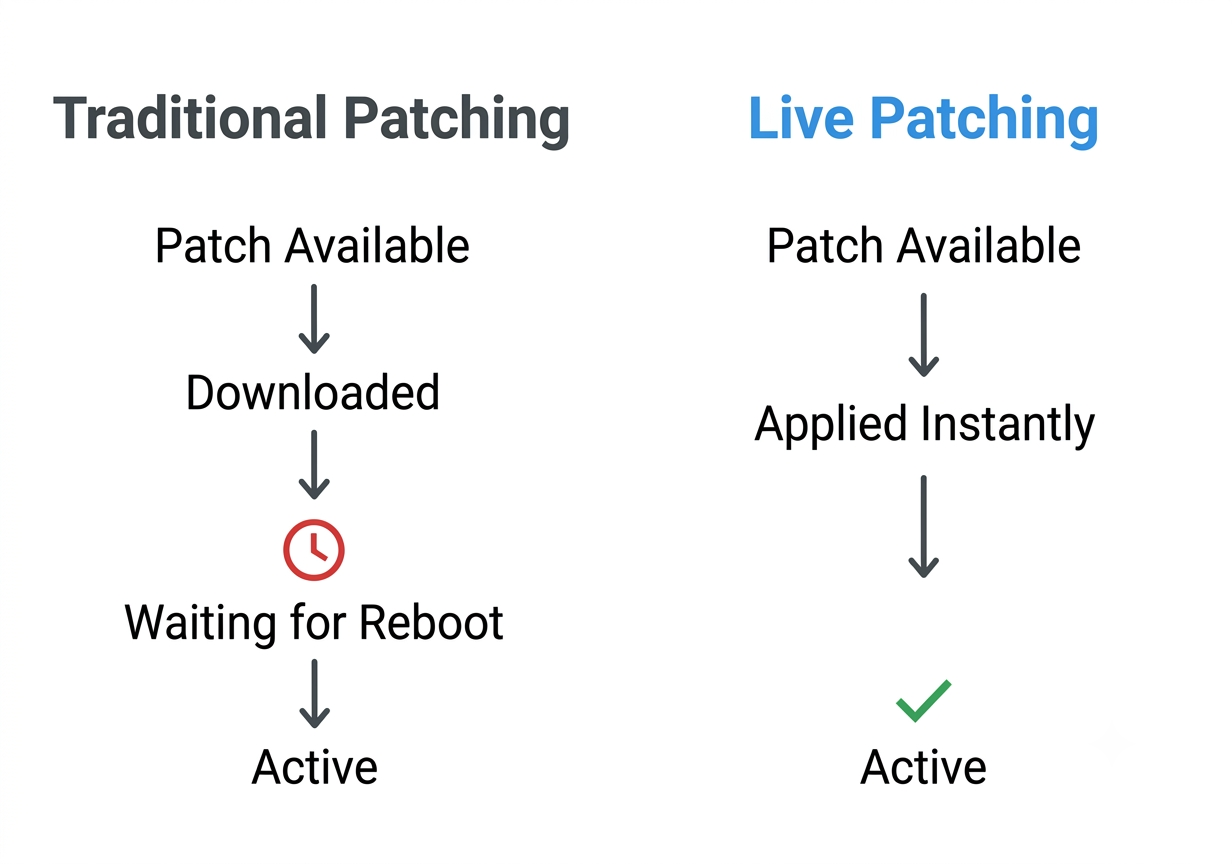
Gerade beim Patchen des Kernels ist die Notwendigkeit eines Neustarts einer der Hauptgründe für den Anstieg der MTTP. Das Patchen eines Kernels auf herkömmliche Weise bedeutet, Ausfallzeiten einzuplanen, die Genehmigung für Änderungen einzuholen und sich mit jedem Team abzustimmen, das für eine Arbeitslast auf diesem Host verantwortlich ist. Daher warten Patches – manchmal wochenlang.
Live-Kernel-Patching hebt diese Abhängigkeit auf, indem Sicherheitspatches auf einen laufenden Kernel angewendet werden, ohne dass ein Neustart erforderlich ist. Eine kritische Kernel-CVE-Sicherheitslücke kann innerhalb weniger Stunden behoben werden, anstatt bis zum nächsten Wartungsfenster in der Warteschlange zu stehen, und die Lücke zwischen „installiert, aber inaktiv“, die die MTTP in die Höhe treibt, verschwindet, da der Patch sofort nach der Anwendung wirksam wird.
KernelCare von TuxCare bietet von Haus aus Live-Patches für mehr als 70 Distributionsversionen, darunter RHEL, AlmaLinux, Rocky Linux, Ubuntu, Debian, Oracle Linux, CloudLinux und Amazon Linux. Für Teams, die Workloads rund um die Uhr ausführen und bei denen die Planung von Neustarts den eigentlichen Engpass darstellt, ist dies eine der wirkungsvollsten Maßnahmen zur Verkürzung der MTTP. LibCare erweitert denselben Ansatz auf gemeinsam genutzte Bibliotheken wie glibc und OpenSSL, die ihre eigenen schwerwiegenden CVE-Sicherheitslücken mit sich bringen.
Wie man Schwachstellenkennzahlen interpretiert
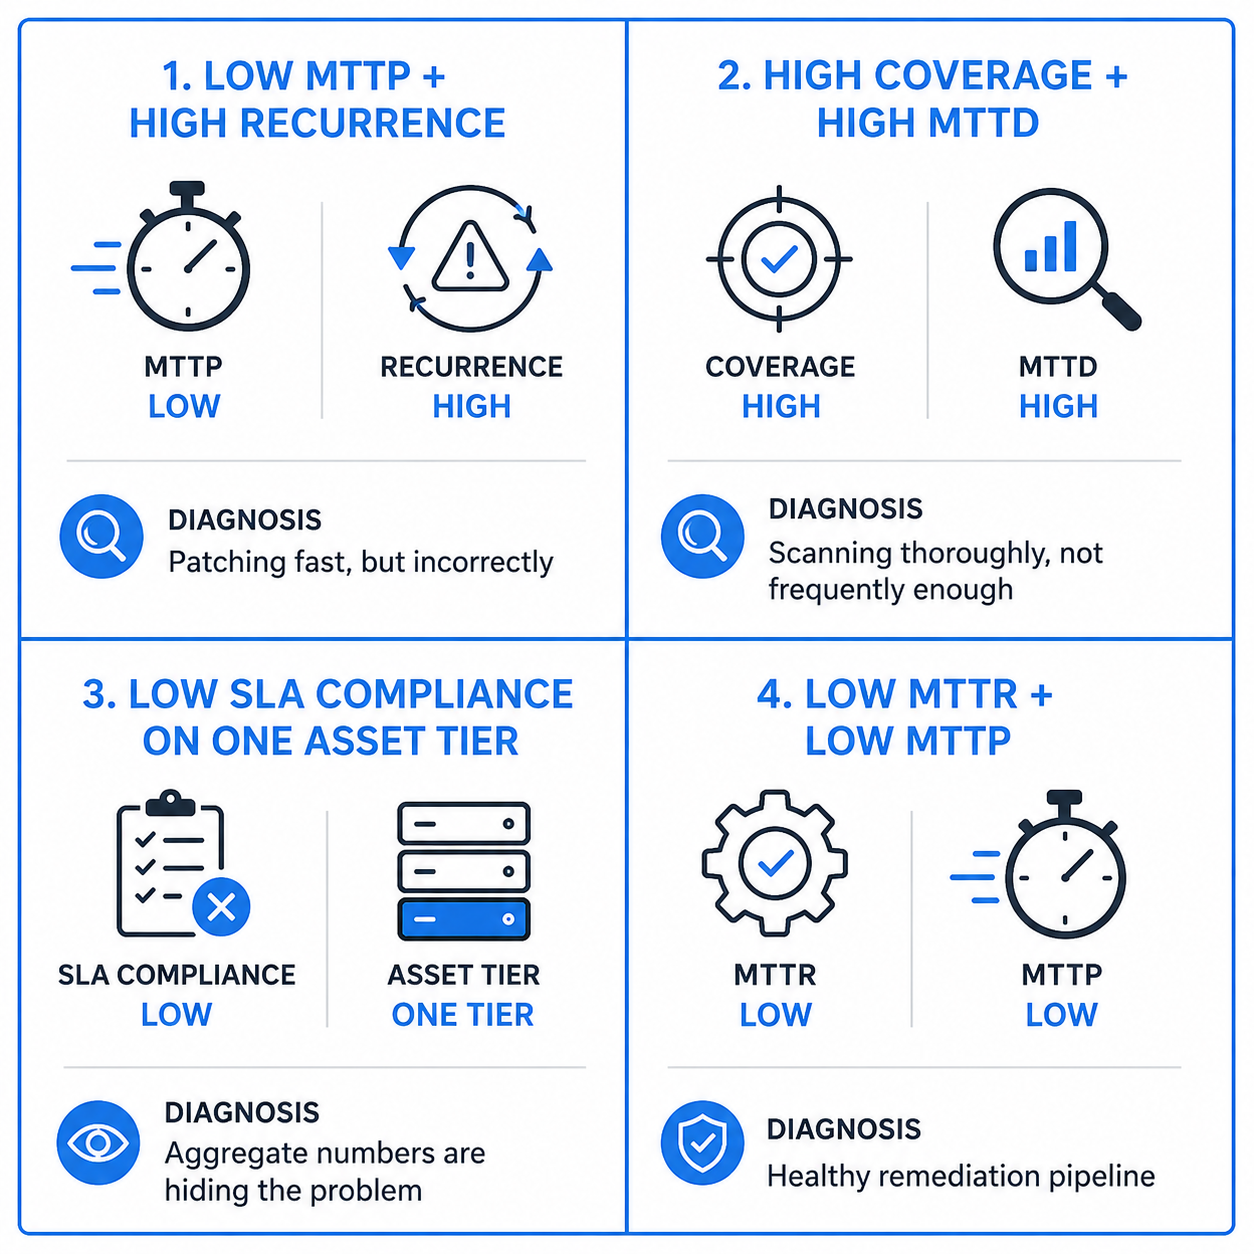
Eine Zahl auf einem Dashboard ist kein Ergebnis. Sie ist ein Anstoß. Erst durch die Interpretation zeigen Kennzahlen ihren Wert – meist dadurch, dass man zwei von ihnen gemeinsam betrachtet, um das zu erkennen, was jede für sich allein verbergen würde.
Beginnen Sie mit Zusammenhängen statt mit absoluten Werten. Ein niedriger MTTP sieht großartig aus, bis man die Rezidivrate daneben setzt. Die Rezidivrate ist der Anteil der behobenen Schwachstellen, die innerhalb eines festgelegten Zeitfensters auf demselben Asset erneut auftreten, und eine hohe Rate bedeutet, dass Korrekturen zwar schnell vorgenommen werden, aber nicht von Dauer sind. Eine hohe Scan-Abdeckung bei gleichzeitig hohem MTTD kann auf eine unzureichende Scan-Häufigkeit hindeuten oder auf eine weitere Verzögerung in der Erkennungskette, wie beispielsweise verspätete Signaturen oder eine unvollständige Asset-Erfassung. Ein einwandfreier aggregierter SLA-Wert kann eine Asset-Klasse verschleiern, bei der es chronisch zu Verzögerungen kommt. Segmentieren Sie daher nach der Kritikalität der Assets und dem Schwachstellenrisiko, bevor Sie einen Erfolg verkünden.
Ein paar Fragen verwandeln diese Zahlen in Entscheidungen. Entwickelt sich der MTTP in die richtige Richtung, oder hat ein einzelner guter Monat den Durchschnitt aufgebläht? Konzentrieren sich die Versäumnisse auf eine bestimmte Anlageklasse, ein bestimmtes Betriebssystem oder ein bestimmtes Team? Entspricht die Geschwindigkeit der Behebung tatsächlich den Hinweisen auf Ausnutzung oder lediglich dem CVSS-Score? Und wie viel des offenen Rückstands besteht aus Sicherheitsschulden, die stillschweigend als dauerhaft hingenommen wurden?
Der Kontext ist auch Teil Ihrer Software-Lieferkette. Sicherheitslücken, die in transitiven Abhängigkeiten , sind leicht zu übersehen, es sei denn, Ihre Tools erfassen den gesamten Abhängigkeitsgraphen – unabhängig davon, ob sie diesen Graphen direkt auflösen oder eine SBOMverwendet. Auch die Risikotoleranz ist kontextabhängig. Die akzeptable MTTP für ein internes Wiki ist nicht dieselbe wie für ein System, das Patientenakten verarbeitet.
Strategien zur Optimierung des Schwachstellenmanagements
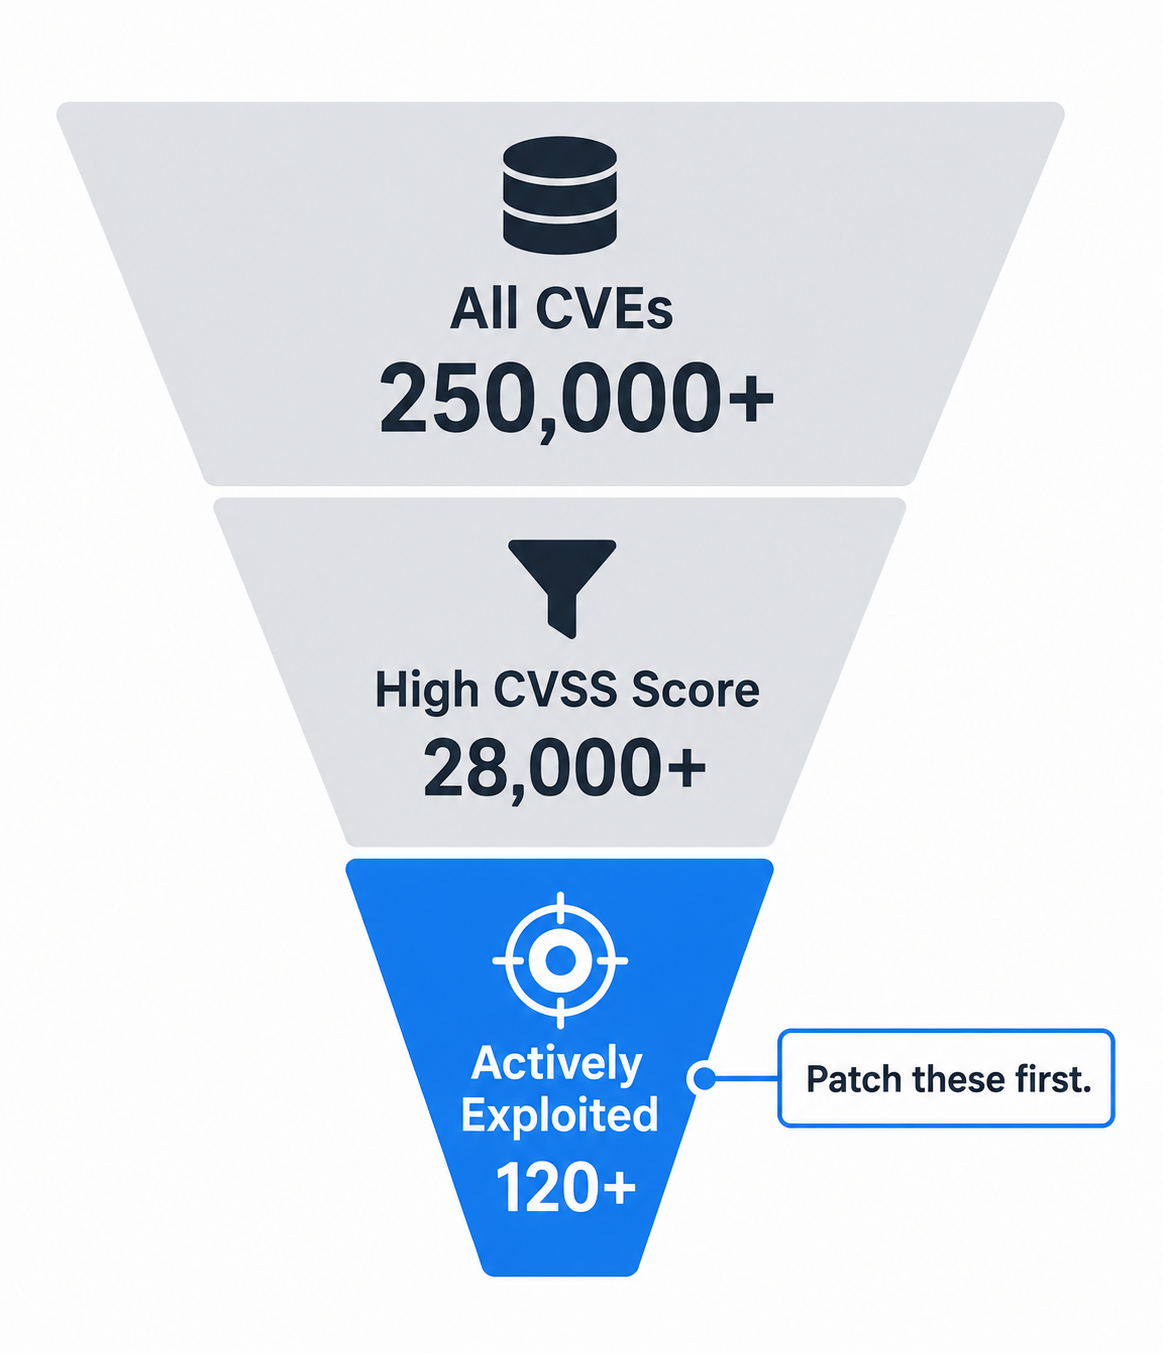
Gute Kennzahlen zeigen Ihnen, wo Sie noch Nachholbedarf haben. Mit diesen Strategien können Sie schneller werden, ohne den Produktivbetrieb zu beeinträchtigen oder das Team zu überlasten. Wählen Sie die Strategie aus, die Ihrer schlechtesten Kennzahl entspricht, und fangen Sie dort an.
Priorisieren Sie nach Ausnutzbarkeit, nicht nach der reinen Schwere
CVSS gibt an, wie schwerwiegend eine Sicherheitslücke theoretisch sein könnte. Es sagt jedoch nichts darüber aus, ob diese derzeit tatsächlich ausgenutzt wird. Teams können sich überfordern, wenn sie jede als „kritisch“ eingestufte Sicherheitslücke als gleich dringlich behandeln, was es erschwert zu erkennen, welche Sicherheitslücken tatsächlich noch heute Abend Maßnahmen erfordern.
Vergleichen Sie die Ausgabe Ihres Scanners mit dem CISA-Katalog bekannter ausgenutzter Sicherheitslückenabgleichen, der speziell auf Nachweisen basiert, dass eine Schwachstelle in der Praxis ausgenutzt wurde. Ein Fehler mittlerer Schwere, dessen Ausnutzung bestätigt ist, ist dringender als ein kritischer Fehler, für den es keine Belege gibt. Kombinieren Sie dann CVSS mit EPSS, dem „Exploit Prediction Scoring System“, einem maschinellen Lernmodell von FIRST, das die Wahrscheinlichkeit abschätzt, mit der eine veröffentlichte CVE in den nächsten 30 Tagen in der Praxis ausgenutzt wird. CVSS beschreibt den technischen Schweregrad, der KEV-Katalog erfasst, was bereits ausgenutzt wurde, und EPSS schätzt ein, was als Nächstes wahrscheinlich ausgenutzt wird. Diese drei Faktoren beantworten unterschiedliche Fragen, und zusammen sind sie aussagekräftiger als der Schweregrad allein, wenn Sie entscheiden, was noch heute Abend gepatcht wird und was bis zum nächsten Sprint warten kann.
Automatisieren Sie die Übergaben, nicht nur die Scans
In vielen Arbeitsabläufen verlängert sich die MTTR aufgrund von Wartezeiten zwischen den einzelnen Schritten. Ein Scan ist abgeschlossen, ein Ticket liegt unbearbeitet vor, eine Genehmigung steht noch aus. Wenn die Übergaben den Engpass darstellen, lässt sich das Problem nicht allein durch die Automatisierung der Erkennung beheben.
Die Ergebnisse des Wire-Scanners werden direkt in das Ticket-System weitergeleitet, mit einer nach Schweregrad gestaffelten Weiterleitung und automatischer Zuweisung. Für routinemäßige Patches werden automatisch Änderungsanträge erstellt, sodass die Techniker diese nur noch genehmigen müssen, anstatt sie manuell zu erfassen. Das Ziel ist es, die Lücken zu schließen, in denen eine Sicherheitslücke im Posteingang verbleibt, denn genau dort vergehen unbemerkt Tage. Kleine Prozesslücken summieren sich schneller zu großen Sicherheitslücken, als die meisten Teams erwarten.
Jede Kennzahl mit einem SLA und einer Asset-Stufe verknüpfen
Eine Kennzahl ohne Ziel ist reine Nebensache. Legen Sie Fristen je nach Schweregrad und Kritikalität der Ressourcen fest und messen Sie dann die Einhaltung dieser Fristen, anstatt einem globalen Durchschnitt hinterherzulaufen.
Definieren Sie die Stufen konkret. Systeme mit Internetanbindung und solche, die Daten verarbeiten, erhalten die strengsten SLAs, während interne Ressourcen mit geringem Wert lockerere SLAs erhalten. Dies verhindert, dass Ihr Team den gleichen Aufwand für ein öffentliches API-Gateway und eine Testumgebung aufwendet, auf die niemand zugreift, und sorgt für eine ehrliche Berichterstattung, da aggregierte Zahlen die Ressourcen, die tatsächlich von Bedeutung sind, nicht länger verschleiern.
Bewährte Verfahren zur Verkürzung der MTTP
Die Verkürzung der MTTP läuft darauf hinaus, Reibungsverluste zwischen der Bereitstellung eines Patches und dessen Inbetriebnahme zu beseitigen. Durch die Beseitigung der Abhängigkeit vom Neustart wird eine wesentliche Verzögerungsquelle beseitigt, wo immer dies möglich ist – genau das bietet Ihnen das Live-Patching für Kernel und gemeinsam genutzte Bibliotheken. Durch die Vorabgenehmigung von Patches mit geringem Risiko werden routinemäßige Updates vollständig aus der Change-Advisory-Warteschlange herausgehalten. Die schrittweise Einführung über eine Canary-Gruppe vor der breiten Bereitstellung ermöglicht es Ihnen, schnell zu handeln, ohne die Produktion einem ungetesteten Patch auszusetzen. Die Pflege eines aktuellen Bestandsverzeichnisses ist wichtig, da Sie Dinge, von denen Sie nicht wussten, dass Sie sie besitzen, nicht schnell patchen können. Und die Priorisierung nach tatsächlichem Risiko bedeutet, dass Sie am schnellsten auf Schwachstellen reagieren, von denen bekannt ist, dass sie ausgenutzt werden oder mit hoher Wahrscheinlichkeit ausgenutzt werden könnten.
Legen Sie Ihre Standardvorgehensweise bewusst fest. Wenn Sie kurze Wartungsfenster in Kauf nehmen können, funktioniert herkömmliches Patching mit strengen SLAs gut. Wenn Ihre Workloads keine Ausfallzeiten verkraften können, ist Live-Patching ist neben Optionen wie rollierenden Neustarts in einem hochverfügbaren Cluster eine der effektivsten Methoden, um ehrgeizige MTTP-Ziele zu erreichen, ohne auf ein Wartungsfenster warten zu müssen.
Stärkung des Schwachstellenmanagements mit TuxCare
Metriken zeigen Ihnen das Problem auf. Die Lücke zwischen Erkennung und Schutz zu schließen, ist der schwierigere Teil, und dabei kommt es in der Regel darauf an, wie schnell Sie Patches installieren können, ohne den Betrieb zu beeinträchtigen.
Das ist die Lücke von TuxCare’s KernelCare und LibCare schließen, indem sie die Verzögerung verkürzen, die zwischen der Verfügbarkeit eines Sicherheitspatches und dessen Aktivierung auf einem laufenden System liegt. „Endless Lifecycle Support“ schließt eine andere Lücke: Was tun, wenn der Upstream-Fix gar nicht mehr existiert? Indem auch nach Ablauf des Herstellersupports weiterhin Patches für Sicherheitslücken bereitgestellt werden.
Wenn Ihre schlechteste Kennzahl die MTTP auf Systemen ist, die sich nicht ohne Weiteres neu starten lassen, dann ist genau das das Problem TuxCare darauf ausgerichtet ist.
FAQs
Die MTTR ist in der Regel die aussagekräftigste Einzelkennzahl, da sie den gesamten Prozess von der Erkennung über die Triage bis hin zur Behebung erfasst und nicht nur einen einzelnen Schritt davon. Betrachten Sie sie jedoch im Zusammenhang mit den Kennzahlen „Erkennung“ und „Abdeckung“. Eine niedrige MTTR nützt wenig, wenn Schwachstellen erst spät entdeckt werden oder wenn ein Großteil der Infrastruktur gar nicht erst gescannt wird.
Kennzahlen zum Schwachstellenmanagement erfassen den gesamten Risikolebenszyklus, d. h. die Erkennung, Priorisierung und Behebung von Schwachstellen durch Patches, Konfigurationsänderungen und Deinstallationen. Kennzahlen zum Patch-Management sind enger gefasst und konzentrieren sich ausschließlich auf die Bereitstellung von Updates. Das Patchen ist nur ein Instrument im Rahmen des Schwachstellenmanagements, nicht das gesamte Management.
Betriebskennzahlen wie MTTP und Scan-Abdeckung werden in der Regel wöchentlich überprüft, wobei für die Führungskräfte monatliche oder vierteljährliche Trendberichte erstellt werden. Bei aktiven Vorfällen oder nach einer größeren Versionseinführung sollten die Überprüfungen häufiger erfolgen. Der Rhythmus sollte sich danach richten, wie schnell sich die zugrunde liegenden Zahlen tatsächlich ändern können.
Fünf bis acht sind ein praktischer Ausgangspunkt. Das reicht aus, um Geschwindigkeit, Reichweite und Risikoposition abzudecken, ohne in Dashboards zu versinken, die niemand liest. Wenn eine Kennzahl niemals eine Entscheidung beeinflusst, streichen Sie sie. Jede Zahl, die Sie erfassen, sollte mit einer Maßnahme verknüpft sein.